Command Palette
Search for a command to run...
MAGIC:为上下文文本到 SQL 生成自我修正指南
MAGIC:为上下文文本到 SQL 生成自我修正指南
Arian Askari Christian Poelitz Xinye Tang
MAGIC 文本到 SQL 自纠错指南生成数据集
摘要
文本到 SQL 中的自我修正是提示大型语言模型(LLM)修改其先前错误生成的 SQL 的过程,通常依赖于人类专家手工制作的自我修正指南,这不仅耗时费力,而且受限于人类识别 LLM 响应中所有潜在错误模式的能力。我们引入了 MAGIC,一种新颖的多智能体方法,可自动创建自我修正指南。MAGIC 使用三个专门的智能体:一个管理器、一个修正智能体和一个反馈智能体。这些智能体协同工作,针对基于 LLM 的方法在训练集上的失败,迭代地生成并完善针对 LLM 错误的自我修正指南,模仿人类过程但无需人工参与。我们的大量实验表明,MAGIC 的指南优于人类专家创建的指南。我们通过实证发现,MAGIC 生成的指南提高了所做修正的可解释性,为分析 LLM 在自我修正中失败和成功的原因提供了见解。所有智能体交互均可在 https://huggingface.co/datasets/microsoft/MAGIC 上公开获取。
一句话总结
来自莱顿大学、微软研究院剑桥分院和微软雷德蒙德分院的研究人员介绍了 MAGIC,一种多 Agent 方法,利用管理者、纠正和反馈 Agent 自动生成并迭代优化用于上下文 text-to-SQL 的自我纠正指南,其表现优于人类专家创建的指南,并提升了 LLM 纠正的可解释性。
核心贡献
- 本文介绍了 MAGIC,一种多 Agent 框架,通过协调管理者、纠正和反馈 Agent 分析 LLM 在训练数据上的失败,自主为 text-to-SQL 生成自我纠正指南。
- 大量实验表明,MAGIC 生成的指南在 text-to-SQL 基准测试上优于人类专家手工编写的自我纠正指南。
- 该方法还表明,自动生成的指南增强了 LLM 自我纠正的可解释性,为分析 SQL 纠正成功与失败背后的因素提供了工具。
引言
Text-to-SQL 翻译依赖于上下文学习,但自我纠正仍然是一个瓶颈:模型经常生成错误的 SQL,必须进行修正,这一过程在实际应用中既昂贵又重要。以往的方法需要手工生成自我纠正指南,既耗时又难以扩展。作者介绍了 MAGIC,一种利用大型语言模型自动生成自我纠正指南的方法,消除了手工劳动。该方法可应用于修正任何 text-to-SQL 方法的错误,提升了当前最优水平,并将指南生成重新定义为该领域中一项独特且有价值的任务。
实验
评估在多种 SQL 生成方法上测试了 MAGIC 的自我纠正指南,显示对零样本 GPT-4、少样本 CoT GPT-4 和多 Agent 基线方法均带来一致的准确率提升。对指南构建过程的分析表明,示例并非直接从反馈中复制,而是由管理者 Agent 从聚合输入中综合生成。此外,将指南应用于 BIRD 数据集中的不同数据库时,整体性能均有所提升,但提升幅度因数据库而异,可能归因于 LLM 能力或数据库难度,这提示了未来可研究难度自适应指南。
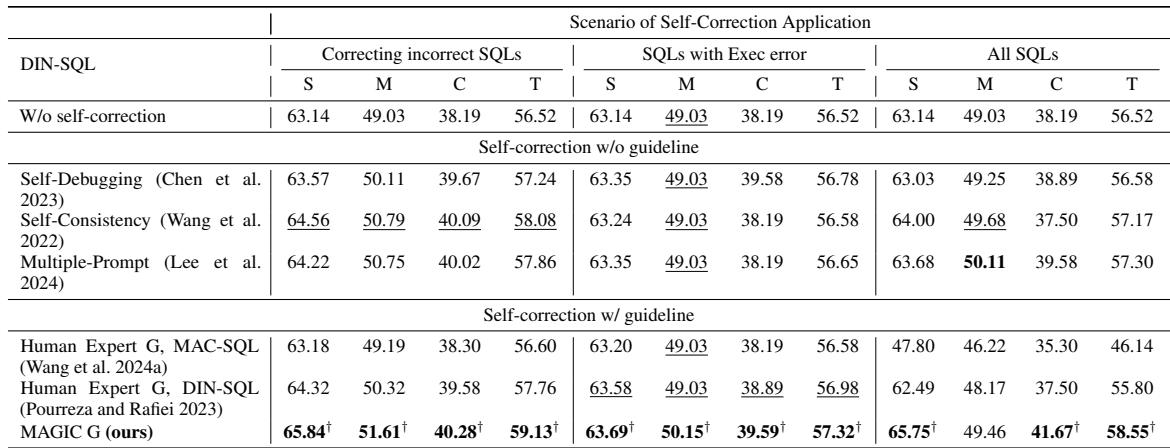
该表在 BIRD 开发集上评估了 text-to-SQL 生成的自我纠正方法,将无纠正基线与多种自我纠正策略进行了比较。结果显示,自我纠正通常能提高执行准确率,而所提出的 MAGIC 方法使用自动生成的指南,相比人类专家指南取得了统计学上显著的提升。包括 Self-Debugging、Self-Consistency 和 Multiple-Prompt 在内的自我纠正方法,在整体和部分难度分层上相比无纠正基线提升了执行准确率。所提出的 MAGIC 指南据报告在统计学上显著优于两个人类专家指南基线,这一点由带 Bonferroni 校正的配对 t 检验所证实。自我纠正带来的改进在不同难度级别上有所不同,某些方法在较难的分层上取得的提升最为一致。
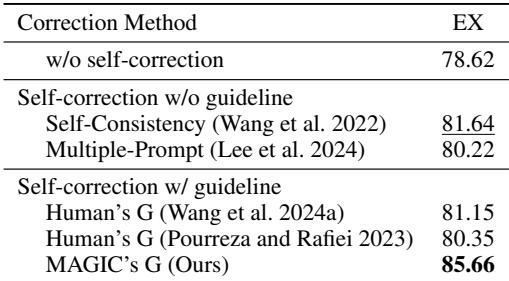
在 SPIDER 开发集上,MAGIC 生成的自我纠正指南在执行准确率上高于两种强基线自我纠正方法(self-consistency 和 multiple-prompt)以及两份专家人工编写的指南。无自我纠正的基线差于所有带纠正的方法,说明带指南的自我纠正能提升 SQL 查询的有效性。MAGIC 的指南优于 self-consistency 和 multiple-prompt 自我纠正基线。MAGIC 的指南在执行准确率上也超过了两位人类专家指南。所有自我纠正方法(无论是否带指南)都超过了无自我纠正的基线。
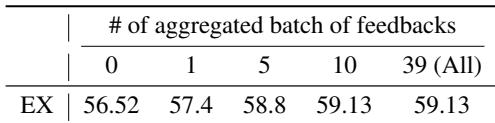
增加聚合反馈批次的数量会提高生成的自我纠正指南的执行准确率,但在某个点之后收益趋于饱和。指南是通过将反馈聚合成新示例而构建的,而非直接复制现有反馈。随着聚合反馈批次数量的增加,执行准确率会提高,但在 10 个批次之后达到平台期。管理者 Agent 聚合多条反馈来构建新示例,而非直接使用反馈原文。
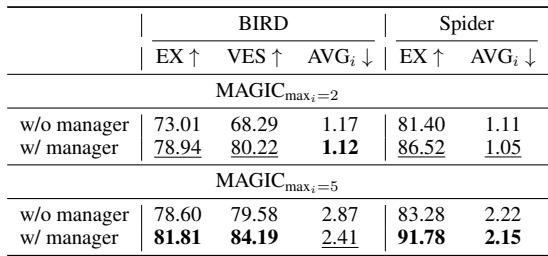
在反馈生成过程中加入管理者 Agent 可以提高执行准确率和有效性分数,同时降低达到停止条件所需的平均迭代次数。允许更大的最大迭代次数会进一步提升准确率和有效性,但代价是平均迭代次数增加。这些趋势在 BIRD 和 Spider 两个基准上保持一致,其中 Spider 的整体得分更高。加入管理者 Agent 可提高执行准确率和有效性,同时降低平均迭代次数。将最大迭代限制从 2 提高到 5 会改善效果,但需要更多平均迭代次数。管理者 Agent 和更大迭代预算带来的相对收益在两个评估基准上保持一致,其中 Spider 的表现优于 BIRD。
MAGIC 的自我纠正指南在不同 SQL 生成方法(包括零样本、少样本和多 Agent 方法)上均持续提高执行准确率。指南并非直接从反馈中复制,而是通过将多条反馈聚合成新示例来构建。虽然所有数据库上都观察到了改进,但收益幅度有所不同,提示可能需要对指南进行数据库特定的适配。应用 MAGIC 指南将零样本 GPT-4 的执行准确率从 40.18 提升到 48.19。带 MAGIC 指南的少样本 CoT GPT-4 从 45.66 提升到 50.38。多 Agent 方法 MAC-SQL 在应用指南后从 59.39 提升到 61.92。指南中的示例没有一条是从反馈中直接复制的;相反,管理者 Agent 聚合反馈来创建新示例。自我纠正提高了所有数据库上的效果,但某些数据库收益更大,可能归因于 LLM 能力或数据库复杂度。
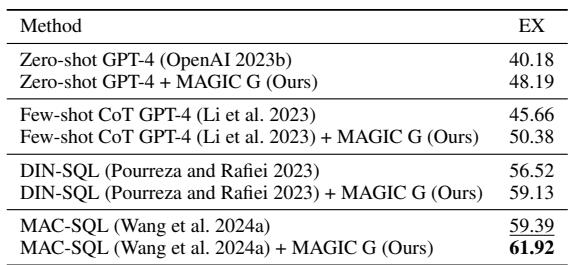
在 BIRD 和 Spider 基准上对 text-to-SQL 生成的实验表明,自我纠正相比无纠正基线持续提高执行准确率,所提出的 MAGIC 方法利用自动聚合的反馈来构建指南,相比人类专家指南取得了统计学上显著的提升。增加聚合反馈批次的数量会提高准确率,但达到一定点后趋于饱和,而加入管理者 Agent 和更大的迭代预算可在减少所需迭代次数的同时提高准确率和有效性。MAGIC 的指南也能泛化到不同的 SQL 生成方法(如零样本、少样本和多 Agent 方法),收益因数据库复杂度而异。