Command Palette
Search for a command to run...
HelpSteer2:用于训练顶尖奖励模型的开源数据集
HelpSteer2:用于训练顶尖奖励模型的开源数据集
Zhilin Wang Yi Dong Olivier Delalleau Jiaqi Zeng Gerald Shen Daniel Egert Jimmy J. Zhang Makesh Narsimhan Sreedhar Oleksii Kuchaiev
Daring-Anteater 指令微调数据集
摘要
高质量的偏好数据集对于训练能够有效引导大型语言模型(LLM)生成符合人类偏好的高质量响应的奖励模型至关重要。随着LLM变得更强且对齐更好,诸如Open Assistant、HH-RLHF和HelpSteer等许可宽松的偏好数据集需要更新以保持其在奖励建模中的有效性。从专有LLM(如GPT-4)中提取偏好数据的方法受到模型提供商施加的商业使用限制。为了改进生成响应和属性标签的质量,我们发布了HelpSteer2,一个许可宽松的偏好数据集(CC-BY-4.0)。利用基于HelpSteer2训练的强大内部基础模型,我们在Reward-Bench的主要数据集上取得了最先进的分数(92.0%),截至2024年6月12日,超越了当前列出的开源和专有模型。值得注意的是,HelpSteer2仅包含一万对响应,比现有偏好数据集(如HH-RLHF)少一个数量级,这使得它在训练奖励模型时非常高效。我们的广泛实验表明,使用HelpSteer2训练的奖励模型能有效对齐LLM。特别地,我们提出了SteerLM 2.0,一种模型对齐方法,可以有效利用我们奖励模型预测的丰富多属性分数。HelpSteer2可在https://huggingface.co/datasets/nvidia/HelpSteer2获取,代码可在https://github.com/NVIDIA/NeMo-Aligner获取。
一句话总结
NVIDIA发布了HelpSteer2,这是一个采用宽松许可(CC-BY-4.0)的偏好数据集,仅包含一万个回复对,并提出了SteerLM 2.0,这是一种利用该数据集丰富的多属性奖励分数来实现模型对齐的方法,在Reward-Bench的主要数据集上达到了最先进的92.0%,超越了现有的开源和专有模型。
核心贡献
-
论文发布了HelpSteer2,这是一个采用CC-BY-4.0许可的偏好数据集,仅包含一万个回复对,标注质量高(Cohen's κ为0.791),并提供了详细的数据收集流程文档,以支持类似的研究工作。
-
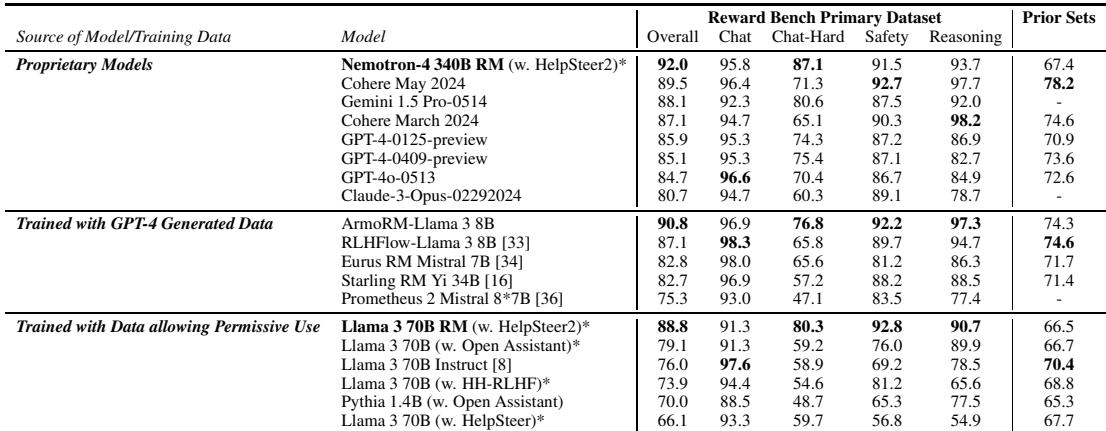
在HelpSteer2上训练的奖励模型截至2024年6月12日在RewardBench主要数据集上达到了最先进的92.0%分数,超越了当时榜单上所有开源和专有模型。
-
论文引入了SteerLM 2.0,这是一种有效利用训练奖励模型的多属性分数预测的对齐方法,并展示了使用该方法对齐Llama 3 70B Base在MT Bench、TruthfulQA、AlpacaEval 2.0 LC和Arena Hard上达到或超越了Llama 3 70B Instruct和GPT-4-0613的性能。
引言
作者们致力于解决大语言模型对齐中对透明、可复用偏好数据日益增长的需求。虽然人类偏好反馈已被证明对训练高性能模型至关重要,但大多数领先系统对其数据仅作模糊披露,而现有公开数据集要么带有严格的许可限制,要么已无法满足最先进对齐方法的需求。为填补这一空白,作者引入了HelpSteer2,这是一个采用CC BY 4.0宽松许可的数据集,包含10,000个高质量偏好对,并提供了详细的收集流程以支持类似工作。作者还提出了SteerLM 2.0,这是一种利用多方面奖励信号帮助模型遵循复杂指令的新型对齐方法。基于Llama 3 70B训练的奖励模型证明,这一紧凑数据集可以使基础模型在主要评估基准上达到或超越Llama 3 70B Instruct和GPT-4 0613的性能。
数据集
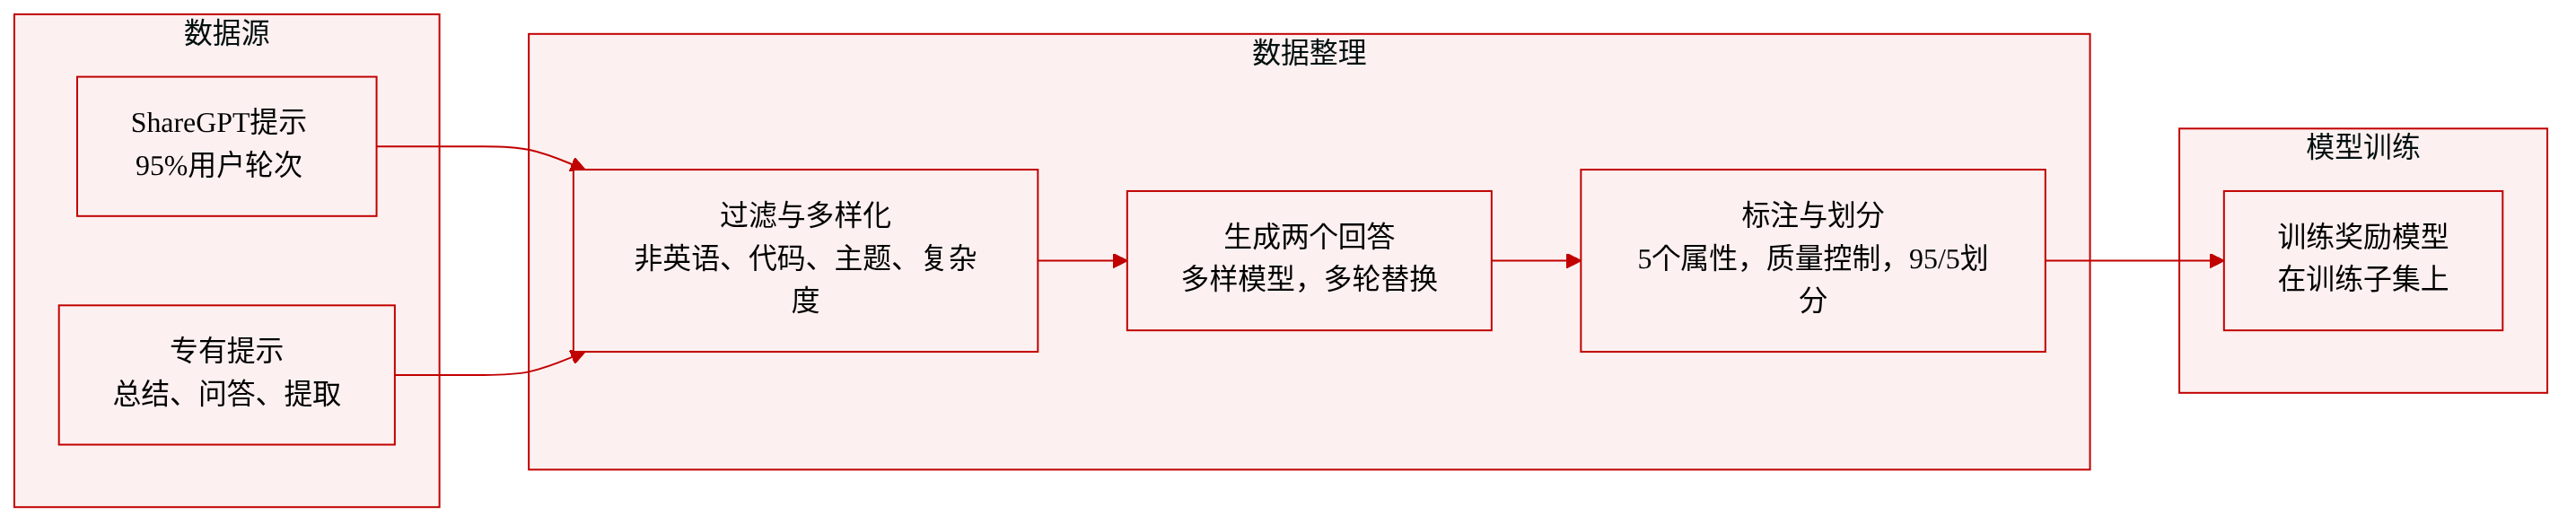
作者构建了HelpSteer2,这是一个专注于多样性和质量的奖励模型训练数据集。以下介绍数据的组成、处理和使用方式。
数据集的组成与来源
- 提示来源:超过95%的提示来自ShareGPT,仅使用用户轮次(助手轮次被去除以避免许可问题)。其余提示为专有数据,面向企业用例,如摘要、封闭问答和信息抽取。
- 回复来源:每个提示对应两个回复,且始终来自两个不同的来源。来源包括内部大语言模型(Nemotron-2、Nemotron-3、Nemotron-4)、Mixtral-8x7B-Instruct-v0.1以及人类标注者。占比为:18.9%来自Nemotron-2(43B),40.4%来自Nemotron-3(其中8B占2.2%,22B占38.2%),26.9%来自Nemotron-4(其中15B占9.5%,340B占17.4%),7.9%来自Mixtral,5.9%来自人类。
各子集的关键细节
- 过滤规则:
- 使用FastText移除非英语提示(标注者为位于美国的英语使用者)。
- 使用简单启发式规则过滤掉包含代码片段的提示(标注者缺乏编程专业知识)。
- 使用BERTopic将提示聚类为约1000个主题,并在各主题间均匀采样。
- 使用Nemotron-2-43B以Likert-5量表评估提示复杂性,然后在各等级间均匀采样,但最高复杂性等级获得双倍权重。
- 多轮提示:约29%的样本为多轮对话(平均2.83轮)。对于这些样本,原始的ShareGPT助手回复被替换为内部22B模型的回复,该模型在Open Assistant和HH-RLHF上进行了微调。
- 回复生成:每个提示由不同模型生成两个回复,有意在模型规模和训练方法(SFT、SteerLM、RLHF、DPO)上进行差异化以增加多样性。部分回复使用随机SteerLM标签来实现风格变化。
标注与处理
- 属性:每个回复在有用性、正确性、连贯性、复杂性和冗长性方面按Likert-5量表进行标注。
- 标注者:约1,000名位于美国的标注者(HelpSteer中为200名)。每个样本至少由3名标注者标注;如果有用性方面分歧超过2分,则增加2名标注者(每个样本平均3.41名)。回复按顺序评分以提高校准度。
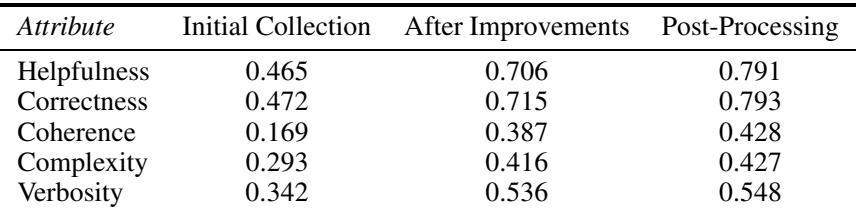
- 质量控制:使用二次加权Cohen's κ衡量标注者间一致性。通过指南澄清和审核者筛选,有用性的一致性从初始的κ=0.465提升到0.706。仅保留标注者间有用性差异≤2分的回复,约10%的样本被移除。最终,约50%的标注被剔除。
- 最终数据集:21,362个高质量样本,包含10,681个提示,每个提示对应两个回复。按95%训练集和5%验证集划分。
在模型中的使用
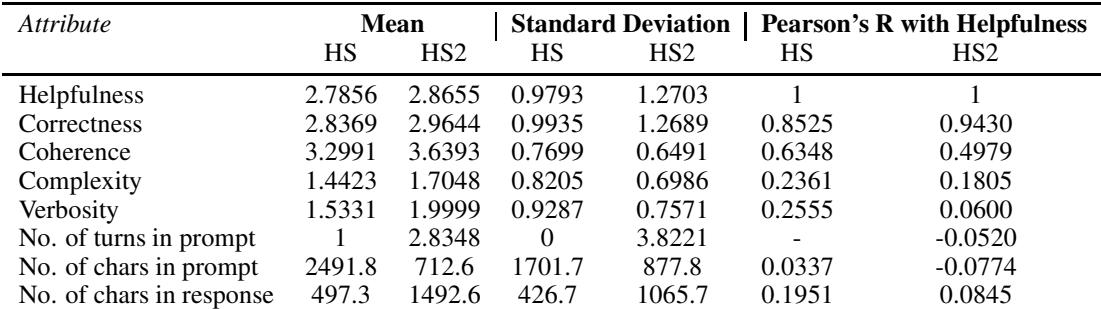
- 作者使用训练子集来训练奖励模型。该数据集旨在改进多轮对话的奖励预测,并强调有用性作为主要信号,正确性作为强预测因子(Pearson's R=0.9430,而HelpSteer中为0.8525)。连贯性现在是较弱的预测因子(0.4979对比0.6348)。提示长度和轮次与有用性呈轻微负相关,而回复长度呈轻微正相关。
与HelpSteer相比,该数据集还表现出更长的回复(平均1492.6字符对比497.3字符)和更短、更具对话性的提示(712字符对比2491字符),反映了从以企业内容为主向基于ShareGPT的提示的转变。
方法
作者提出了HelpSteer2,这是一个多属性标注的偏好数据集,以及基于回归的奖励模型和构建在其上的多种下游对齐方法。完整的流程涵盖数据集收集、奖励模型训练,以及通过监督微调、直接偏好优化、近端策略优化和一种称为SteerLM 2.0的改进属性条件对齐方法来实现语言模型的对齐。
数据集收集流程
在数据集构建过程中,作者主要从ShareGPT(超过95%)获取提示,仅使用用户输入以避免特定模型的许可限制,并补充面向企业用例的专有提示,如摘要、封闭问答和信息抽取。过滤阶段使用FastText移除非英语提示,并使用简单启发式规则过滤掉与编码相关的提示,因为标注者群体由位于美国的英语使用者组成,不具备编程专业知识。为确保多样性,作者使用BERTopic将提示聚类为约1000个主题,并从每个聚类中均匀采样。使用Nemotron-2-43B模型按Likert-5量表对提示复杂性进行评分,然后跨复杂性等级均匀采样,最高复杂性等级获得两倍权重。多轮提示约占样本的29%,助手轮次由在Open Assistant和HH-RLHF对话上微调的内部22B模型生成。
每个提示生成两个回复,而非原始HelpSteer中的四个,以降低标注者的认知负担,且两个回复始终来自不同来源。回复来源涵盖多代内部大语言模型(Nemotron-2 43B、Nemotron-3 8B/22B、Nemotron-4 15B/340B)、Mixtral-8x7B-Instruct和人类标注者。所有内部模型均在宽松许可的数据上使用多种技术进行微调,包括监督微调、SteerLM、基于人类反馈的强化学习和直接偏好优化,与原始HelpSteer数据集相比大幅增加了回复多样性。
在标注方面,每个回复在五个Likert-5属性上评分:有用性、正确性、连贯性、复杂性和冗长性。每个回复至少由三名标注者评分,如果前三名标注者在有用性上的分歧超过2分,则额外招募两名标注者。标注者按顺序对同一提示的两个回复进行评分,通过直接相对比较提供更校准的分数。使用二次加权Cohen's κ衡量标注者间一致性,选择该指标是因为大型标注者群体(约1000名标注者)很难让多个标注者标注相同的样本集,这使得Fleiss' κ或Krippendorff's α等多标注者指标不太适用。通过迭代澄清标注指南,有用性的一致性从初始的0.465提升到0.706。仅保留三名保留标注者中有用性分数差异不超过2分的样本,并通过多个过滤阶段排除约50%的标注,最终得到21,362个样本的数据集(10,681个提示各自配有两个回复)。
奖励模型训练
奖励模型由一个基础模型加一个线性层组成,该线性层将回复结束token处的最终层表示映射为五个标量值,对应HelpSteer2的每个属性。作者在两种基础模型上训练该架构:Llama 3 70B和内部Nemotron-4 340B模型。训练运行两个epoch,全局批大小为128,使用MSE损失,恒定学习率(70B模型为2e-6,340B模型为7e-7),采用AdamW优化器,10个预热步骤。
关键设计选择是使用细粒度属性上的回归而非二元偏好分类。Bradley-Terry风格的偏好奖励模型产生的奖励仅在同一提示内具有可比性,因为可以添加任何与提示相关的偏移量而不改变诱导的偏好排序。这使得跨提示比较变得模糊:一个提示上奖励为4的回复不一定比另一个提示上奖励为2的回复更好。相比之下,SteerLM回归奖励模型为每个属性预测绝对标量评分,实现了跨提示的一致比较,并允许模型将冗长性等属性与整体质量进行区分。这一点尤为重要,因为二元训练的模型可能错误地将较长回复与更高质量关联起来,而显式的冗长性预测可以防止此类混淆。
监督微调
作者首先在Open Assistant数据集(56k对话)上训练SFT模型,训练2400步,恒定学习率2e-6,批大小128。该模型被证明弱于Llama 3 70B Instruct基线,作者将其归因于Open Assistant中回复质量的不一致性。因此,作者使用"Daring Anteater"数据集构建第二个SFT模型,该数据集包含100k对话,平均每个对话有2.88个模型轮次。约93%的数据是合成生成的,将原始生成流程中的OpenAI模型替换为早期对齐版本的Nemotron-4 340B和Mixtral-8x7B-Instruct-v0.1,其余数据来自涵盖推理、数学、编码和基于表格的问答的专业数据集。该模型训练1600步,全局批大小更大,为384,并作为所有后续DPO和PPO实验的起点。
直接偏好优化
对于标准DPO,HelpSteer2训练集被转换为偏好数据集,选择有用性分数较高的回复作为选定回复,分数较低的回复作为拒绝回复,丢弃有用性分数相同的配对。这产生了7,221个偏好对。SFT模型在这些对上训练7个epoch,恒定学习率2e-7,KL惩罚1e-3,权重衰减0.1。
迭代DPO通过从Daring Anteater SFT数据集的20k提示中为每个提示采样10个回复(温度0.7,top-p 0.9),使用Llama 3 70B奖励模型对这些回复进行评分,并从最高和最低goodness分数构建成对偏好数据,进一步改进模型。Goodness分数定义为属性的加权组合:
goodness=0.65⋅helpfulness+0.8⋅correctness+0.45⋅coherence该权重被发现能在RewardBench提示上给出选定和拒绝回复之间的最佳区分度。迭代DPO训练运行3个epoch,KL惩罚1e-3,学习率9e-8。
近端策略优化
对于PPO,SFT模型作为初始策略,Llama 3 70B奖励模型提供奖励信号。奖励是经过归一化的goodness分数,减去HelpSteer2回复的均值并除以标准差,这使奖励尺度保持稳定。PPO训练使用全局批大小128,rollout缓冲区128,恒定学习率1e-7,KL惩罚3e-3,共64步。生成阶段通过NeMo-Aligner与TensorRT-LLM的集成进行优化,以实现高效的rollout。
SteerLM与SteerLM 2.0
SteerLM通过对期望属性值进行条件生成来对齐语言模型。原始的SteerLM方法使用奖励模型标注Daring Anteater SFT数据集,然后执行属性条件监督微调,教会模型在目标属性分数的条件下生成回复。然而,原始的公式并不显式强制生成的回复遵循期望的属性分布。SteerLM 2.0通过迭代训练模型以逼近从奖励模型推导出的最优SteerLM策略来解决这一局限性。
最优条件分布通过贝叶斯规则推导。给定一个从提示x和回复y预测属性值a的概率奖励模型P(a∣x,y),以及来自单独语言模型的无条件回复分布P(y∣x),最优条件分布为:
P(y∣a,x)∝P(a∣x,y)P(y∣x)为了将回归奖励模型转换为概率模型,作者使用Beta分布来估计每个奖励等级的概率。奖励模型输出r经过缩放,Beta分布参数设置为α=24r和β=24−α,其中α+β=24与训练数据的真实分布相匹配。特定属性等级n的概率计算为相邻分箱边界处累积Beta分布值之差。
参数化模型Qθ(y∣a,x)通过最小化KL散度来训练以逼近最优的P(y∣a,x):
θminEa,xDKL(P(y∣a,x)∥Qθ(y∣a,x))展开该目标函数后发现,直接优化需要从难以处理的最优分布中采样。因此,作者使用从初始SteerLM模型Q′(y∣a,x)进行重要性采样,该模型提供更接近目标分布的样本。梯度估计器为:
∇θL≈−i∑(wi′−bi′)∇θlogQθ(yi∣a,x)其中wi′是归一化重要性权重,计算为wi=Q′(yi∣x,a)P(a∣yi,x)P(yi∣x)并归一化使其总和为1,bi′是从Qθ本身推导的基线。基线减法的依据是logQθ在Qθ下的期望梯度为零这一恒等式,这降低了梯度估计中的方差。该估计器对应于归一化权重分布w′和b′之间KL散度的梯度,可以在训练过程中监控以跟踪进度。
SteerLM 2.0以迭代方式进行(n = 2轮)。在每次迭代中,从Daring Anteater SFT数据集的20,000个提示中为每个提示采样10个多样化回复(温度0.7,top-p 0.9),并使用AdamW优化器以恒定学习率1e-7和全局批大小128训练模型2个epoch。
在推理方面,作者专注于生成高质量回复。由于HelpSteer2的回复比HelpSteer中的回复明显更长、更复杂(约为3倍),作者将有用性、正确性和连贯性设置为4,同时将复杂性和冗长性保持在2,这比原始HelpSteer中将所有属性设置为4能产生更好的生成结果。
实验
使用SteerLM方法在紧凑的HelpSteer2数据集上训练的奖励模型取得了最先进的RewardBench分数,其中Llama 3 70B达到88.8%的整体分数,Nemotron-4 340B以92.0%位居榜首,大幅超越了在更大偏好数据集上训练的模型。使用该奖励模型,在Llama 3 70B上使用DPO、PPO和SteerLM的对齐实验产生了达到或超越Llama 3 70B Instruct(使用了100倍数据)的模型,每种方法在不同基准上表现优异:DPO在TruthfulQA和Arena Hard上表现最佳,PPO在AlpacaEval 2.0 LC上表现最佳(但TruthfulQA有所下降),SteerLM在MT-Bench上表现最佳。消融实验表明,无论SFT数据质量如何,奖励模型引导的训练都能持续提升性能,但更高质量的SFT数据(如Daring Anteater)能产生更强的整体结果。
HelpSteer2属性在应用标注改进后,标注者间一致性显著提升,后处理带来了进一步改善。有用性和正确性达到最高的一致性水平,而连贯性和复杂性仍然是最难保持标注一致的属性。有用性和正确性的初始一致性为中等水平,但在后处理后上升到约0.79。连贯性和复杂性在整个过程中一致性最低,即使在改进后也是如此。冗长性的一致性从0.342提升到0.548,表明有适度但持续的增长。
HelpSteer2的回复在所有质量属性上得分更高,也更冗长,反映了更强的生成模型。然而,与有用性的相关性发生了显著变化:连贯性的预测能力下降,而正确性成为更强的预测因子,冗长性和复杂性的影响减弱。连贯性分数大幅提升,但其与有用性的相关性减弱,可能是因为大多数回复现在都是连贯的。正确性成为有用性的近乎完美的预测因子,凸显了其在评估回复质量中日益增长的重要性。冗长性和复杂性与有用性的相关性减弱,表明标注者更关注事实准确性而非风格。HelpSteer2引入了多轮提示,与有用性呈轻微负相关,表明后续回复可能更难生成。
该表比较了多个专有奖励模型在Reward Bench上的表现,显示没有单一模型在所有类别中都排名第一。Nemotron-4 340B RM在主要数据集指标上领先,而Cohere模型在先前集合总体、安全性和推理分数上表现最佳。在所有模型中,聊天和安全性表现普遍较高,但推理表现较低且差异更大。Nemotron-4 340B RM在Reward Bench主要数据集上得分最高。Cohere May 2024在先前集合总体和推理上优于其他模型,而Cohere March 2024取得了最佳安全性分数。GPT-4变体在大多数Reward Bench指标上落后于领先的Cohere和Nemotron模型。
评估结果表明,没有单一对齐方法能在所有基准上占据主导地位,每种技术都在特定领域表现出色。SteerLM取得了最高的MT Bench分数,PPO在AlpacaEval上表现最佳但使TruthfulQA下降,而使用Daring Anteater的迭代DPO在Arena Hard和TruthfulQA上领先。Daring Anteater数据集通常能提升SFT和迭代方法的性能。使用DA的SteerLM取得了最高的MT Bench分数,这归因于其多对一对比学习方法。PPO取得了最佳的AlpacaEval 2.0 LC分数,但显著降低了TruthfulQA性能。使用DA的迭代DPO在Arena Hard上取得最高分数并在TruthfulQA上表现强劲,表明其在知识密集型任务上的有效性。
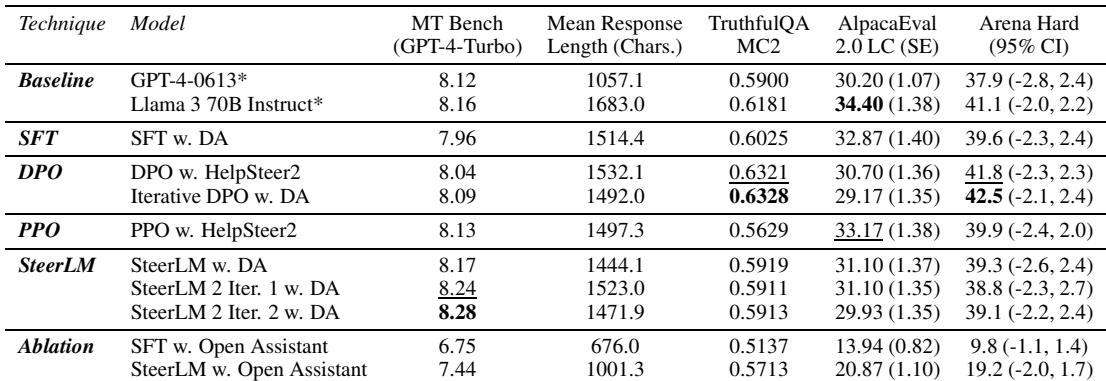
实验表明,标注改进和后处理提高了HelpSteer2属性的标注者间一致性,有用性和正确性达到了最高可靠性,而连贯性和复杂性仍然最难保持标注一致。比较回复集时,HelpSteer2的回复在各属性上得分更高,但与有用性的相关性发生了变化:正确性成为近乎完美的预测因子,连贯性影响力下降,冗长性或复杂性的重要性降低,多轮提示增加了一定难度。对专有奖励模型的基准测试显示没有单一赢家;Nemotron-4 340B RM在主要数据集上领先,而Cohere变体在先前集合、安全性和推理方面表现出色,GPT-4总体落后。对于对齐方法,没有一种技术在所有任务中占主导地位:SteerLM取得了最高的MT Bench分数,PPO在AlpacaEval上表现出色但损害了TruthfulQA,使用Daring Anteater的迭代DPO在Arena Hard和知识密集型基准上表现最佳,表明各评估维度之间存在权衡。