Command Palette
Search for a command to run...
AEGIS:基于 LLM 专家集成的在线自适应 AI 内容安全审核
AEGIS:基于 LLM 专家集成的在线自适应 AI 内容安全审核
Shaona Ghosh Prasoon Varshney Erick Galinkin Christopher Parisien
Nemotron Content Safety Dataset V1 内容安全数据集
摘要
随着大语言模型(LLM)和生成式 AI 的日益普及,与其使用相关的内容安全风险也在增加。我们发现,目前缺乏高质量的内容安全数据集和基准,无法全面覆盖众多关键安全领域。为解决这一问题,我们定义了一个广泛的内容安全风险分类体系,涵盖 13 个关键风险类别和 9 个稀疏风险类别。此外,我们构建了 AEGISSAFETYDATASET,这是一个包含约 26,000 个人机交互实例的新数据集,并附有符合该分类体系的人工标注。我们计划将该数据集发布给社区,以促进进一步研究,并帮助对 LLM 模型进行安全基准测试。为了展示该数据集的有效性,我们对多个基于 LLM 的安全模型进行了指令微调。我们证明,我们的模型(称为 AEGISSAFETYEXPERTS)不仅超越或与最先进的基于 LLM 的安全模型及通用 LLM 性能相当,而且在多种越狱攻击类别下表现出鲁棒性。我们还表明,在 LLM 对齐阶段使用 AEGISSAFETYDATASET 不会对对齐模型在 MT Bench 评分上的表现产生负面影响。此外,我们提出了 AEGIS,这是一种具有强理论保证的无遗憾在线自适应框架的新应用,用于在部署中通过 LLM 内容安全专家集成进行内容审核。
一句话总结
NVIDIA的研究人员提出了AEGIS,这是一个具有理论保证的无遗憾在线自适应框架,部署了一组LLM安全专家(AEGISSAFETYEXPERTS)用于内容审核,该框架在AEGISSAFETYDATASET上训练,这是一个包含26,000条人工标注数据的新数据集,覆盖13个和9个风险类别,其性能超越或媲美最先进的安全模型,在各类越狱攻击类别中展现出鲁棒性,并保持了以MT Bench评分衡量的对齐质量。
核心贡献
- 本文介绍了AEGISSAFETYDATASET,这是一个包含约26,000条人工标注的人类与LLM交互实例的数据集,由涵盖13个关键和9个稀疏风险类别的内容安全分类体系支撑,填补了全面安全基准测试的空白。
- 本文提出了AEGISSAFETYEXPERTS,这是经过指令微调的LLM安全模型,其性能超越或媲美最先进的安全模型和通用LLM,评估表明该模型在包括TAP和GCG在内的越狱攻击类别中具有鲁棒性,同时使用该数据集进行对齐不会降低MT Bench性能。
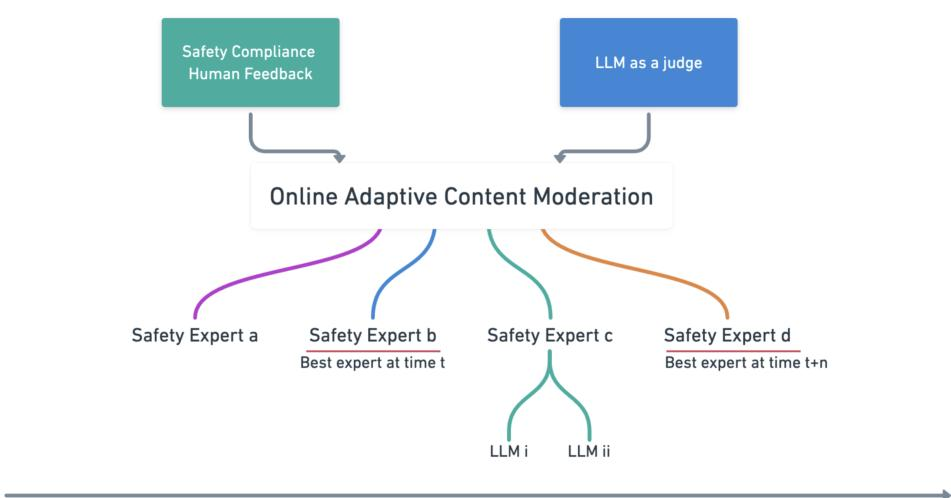
- 本文提出了AEGIS,这是无遗憾在线自适应框架的一种新颖应用,具有理论保证,通过一组LLM安全专家执行内容审核,使系统能够适应来自安全合规团队或第三方评估系统的实时反馈,从而动态地应对数据分布和安全策略的变化。
引言
大型语言模型正在被迅速应用于实际产品中,这使得鲁棒的内容安全审核成为部署的关键环节。现有方法分为两大类:基于对齐的方法,通过RLHF或宪法AI等技术对模型本身进行微调;以及基于审核的系统,依赖具有固定类别头的分类器或闭源API。两者都有显著的缺点。对齐方法资源密集,需要预先指定有害内容,而且仍会使模型容易受到突破。OpenAI Content Moderation和Perspective API等审核分类器难以泛化到自我伤害或非法活动等新兴风险,而Llama Guard等近期基于LLM的方案在分类体系粒度上存在局限,例如无法区分色情内容与对未成年人的性虐待,或无法区分暴力与仇恨,而这些是至关重要的安全区分。对抗性鲁棒性也仍未得到充分解决,现有方法通常只针对狭义的优化攻击进行测试,而非可迁移的攻击。
为了解决这些空白,作者引入了一个以名为AEGIS的模型为核心的多阶段内容安全系统。作者首先构建了一个涵盖13个主要类别和9个子类别的详细安全风险分类体系,并配有定义各类别违规边界的相关策略。随后,作者策划了AEGISSAFETYDATASET,这是一个人工标注的LLM交互数据集,撰写本文时包含约26,000条标注,并在此数据上指令微调了一套LLM内容安全专家模型,针对多个域内和域外安全数据集以及TAP和GCG等对抗性越狱攻击对其进行了基准测试。最后,作者提出了一种无遗憾在线自适应元算法,该算法根据上下文动态加权这些专家模型的预测,使审核系统能够随时间适应不断变化的数据分布、不断演进的安全策略和新颖攻击,同时还能从人工合规团队的反馈中学习。作者计划将数据集、分类体系和模型发布给研究社区。
数据集
AEGISSAFETYDATASET 概述
作者构建了AEGISSAFETYDATASET,以支持整个内容审核工作中使用的安全风险分类体系。数据集的描述如下:
分类体系与来源
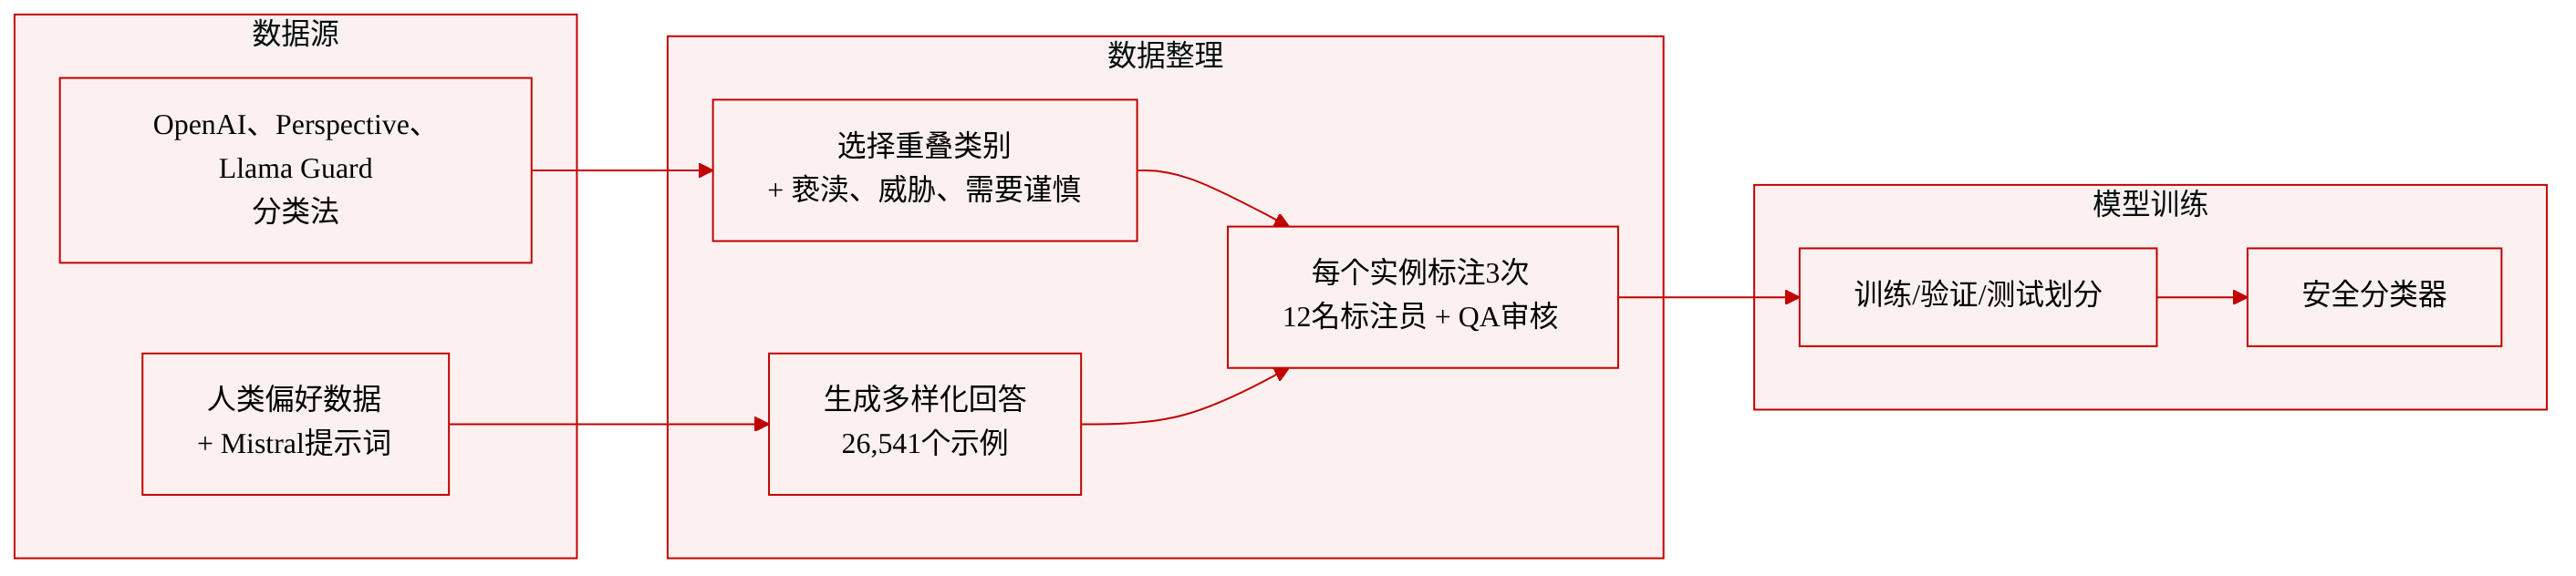
- 该安全分类体系受到OpenAI Content Moderation API、Perspective API和Llama Guard的影响。作者选择了这些分类体系中直接重叠的类别,因为重叠类别代表了最相关的风险领域,并简化了评估。
- 作者还识别了不同分类体系之间的差异。Llama Guard不区分色情(Sexual)与色情未成年(Sexual Minor)类别,也不区分暴力(Violence)与仇恨(Hate)。由于这些更细致的区分对客户需求和明智审核很有价值,作者将它们分开保留。
- 不雅语言(Profanity)和威胁(Threat)类别采用自Perspective API的分类体系。
- 为了不让模糊的实例被自动标记为不安全,作者引入了一个专门的"需要谨慎"(Needs Caution)类别。这允许系统根据解读在防御性回应或宽容、有帮助的回应之间进行选择。
数据集创建与构成
- 作者使用了Hugging Face上关于无害性的人类偏好数据。作者仅提取提示词,并从Mistral LLM获取回应,Mistral在指令遵循方面表现出色,能为审核类别生成高质量回应。
- 为确保多样性,系统提示示例指示Mistral不要生成相似的回应。
- 数据集包含四种格式:仅用户提示词、系统提示词加用户提示词、单轮用户提示词加Mistral回应、以及多轮用户提示词加Mistral回应。
- 共收集了26,541条人类与LLM交互数据示例用于标注,正负类别保持平衡。
标注细节
- 标注由12名标注人员和两名数据质量保证人员组成的团队完成。
- 每个实例至少获得三条标注,总计产生86,736条标注。
- 为确保质量,数据集被分为11个块,每块包含1,000到3,000个样本,质量团队对其中10%到15%的内容进行审计。研究和工程团队每隔几天还会运行自动测试。
- 标注在对话级别进行,而非分别对提示词和回应对进行。标注人员之间的一致性约为74%。
数据的使用方式
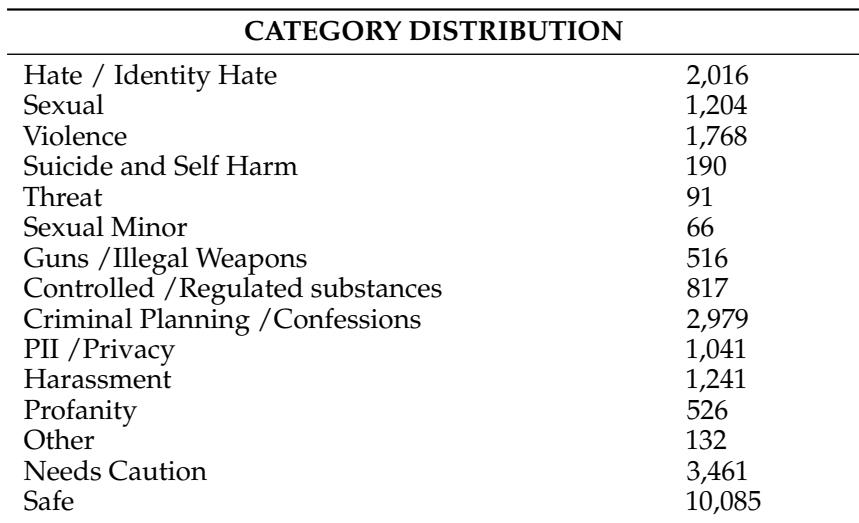
- 作者在表2中展示了标注分布,说明了示例在各安全类别中的分布情况。
- 论文中包含了一个Mistral生成的提示词和回应示例及其对应的标注,例如枪支/非法武器(Guns/Illegal Weapons)和犯罪策划/供述(Criminal Planning/Confessions),展示了数据如何映射到分类体系。
- 该数据集是训练和评估安全分类模型的基础,分类体系指导类别标签,"需要谨慎"(Needs Caution)类别则实现了灵活的审核行为。
方法
作者构建了一个多样化的基于大型语言模型(LLM)的安全专家集成,称为AEGIS SAFETY EXPERTS,用于处理内容审核。该集成优先考虑预训练数据、架构和安全分类体系解读的多样性。基础模型包括Llama Guard(一个7B参数模型)和Nemotron 43B。为了在安全策略执行中创造差异,Llama Guard基础模型以两种不同的配置进行指令微调:防御变体(LLAMAGUARDDEFENSIVE),将"需要谨慎"(Needs Caution)类别映射为"不安全";以及宽容变体(LLAMAGUARDPERMISSIVE),将"需要谨慎"映射为"安全"。此外,还包含了Nemotron模型的防御变体(NEMO43B-DEFENSIVE)。
这些专家模型的训练利用低秩适配器(LoRA)在精选数据集上对模型进行微调。对于Llama Guard基础模型,作者采用秩r=16的LoRA,上下文长度为4096,学习率为10−6,训练3个epoch。Nemotron 43B模型使用NGC NeMo LLM服务定制框架进行适配,秩更高,为r=32,学习率为5×10⁻⁶,训练10个epoch。这种微调使专家模型与特定的安全分类体系和策略指南保持一致。
该系统的核心是一个名为AEGIS的元算法,它应用无遗憾在线学习框架从集成中动态选择最有效的专家模型。该过程被建模为学习算法与环境之间的博弈。在每一轮t中,学习器从专家集合E中选择一个专家It。环境随后揭示一个损失函数,学习器承担所选专家对应的损失lt(It)。目标是最小化T轮上的期望遗憾RT,定义为:
RT=E[t=1∑Tlt(It)−i∈Einft=1∑Tlt(i)]作者实现了指数权重(EW)算法,也称为Hedge算法,来管理这一选择过程。初始时,每个专家模型被赋予权重1。在每一轮中,算法根据与当前权重成比例的分布随机选择一个专家模型。在收到来自预言机(例如人工审核员或LLM裁判)的反馈后,权重会被更新,以降低产生较高损失的专家模型的影响。
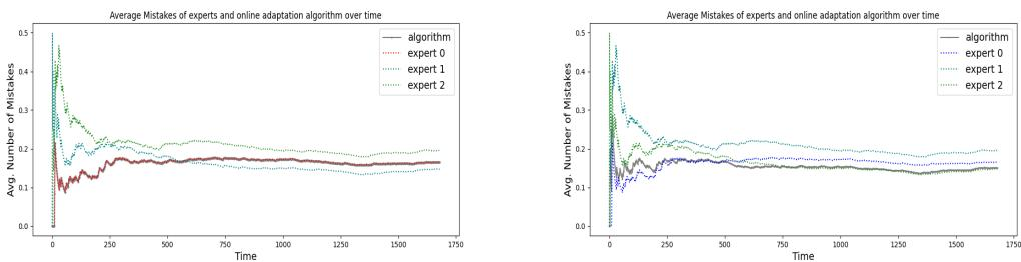
为了在计算可行性与自适应性能之间取得平衡,系统以交替阶段运行。在长度为m的自适应阶段中,算法收集反馈以更新专家权重并识别最佳表现者。随后是长度为p的合规阶段,在此阶段部署当前最佳的专家模型进行审核,同时监控其性能。这一循环使系统能够动态适应实时数据和策略反馈。这种在线自适应的有效性通过性能曲线得以展示,算法随时间收敛到最佳专家模型的性能水平。
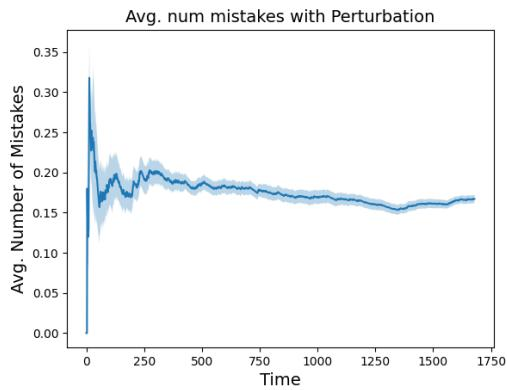
为了增强对对抗性攻击的鲁棒性,并防止算法在性能随时间变化时陷入次优专家模型,作者引入了权重更新的扰动机制。这涉及从Gumbel分布中采样一个值,并在更新步骤中将其添加到权重中,公式如下:
wit+1=witexp(−ηlit(xt))+e−e−(1/η)这种扰动引入了受控的随机性,使学习器能够更频繁地探索其他专家模型。该扰动版本的稳定性和性能在多次试验中得到验证,展示了在时间范围内一致的误差减少。
实验
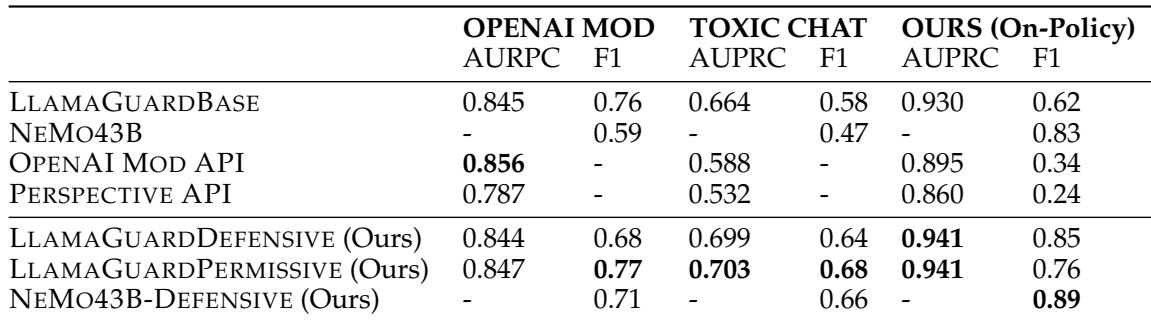
评估将AEGISSAFETYEXPERTS与Llama Guard和OpenAI审核API等基线模型在三个安全基准测试以及SimpleSafetyTests套件上进行比较。仅使用AEGISSAFETYDATASET一半数据进行训练的专家模型,在所有数据集上的AUPRC或F1指标均优于所有基线,而基线模型在分布外数据上表现不佳。除静态评估外,还应用了具有指数权重的无遗憾在线学习框架来集成专家模型,由预言机提供反馈,该自适应算法渐近收敛到表现最佳的专家模型,其中扰动权重版本在专家性能随时间变化时展现出更好的鲁棒性。
AEGIS安全数据集定义了一个内容安全风险分类体系,该体系合并了现有行业分类体系中重叠的类别,同时添加了更细粒度的区分,例如将色情(Sexual)与色情未成年(Sexual Minor)分开,以及将暴力(Violence)与仇恨(Hate)分开。它还整合了Perspective分类体系中的不雅语言(Profanity)和威胁(Threat)等类别。该设计同时优先考虑覆盖面和粒度,以支持细致入微的内容审核。该分类体系基于OpenAI、Perspective和Llama Guard之间重叠的类别构建,以聚焦最相关的风险领域。与Llama Guard不同,该分类体系区分了色情(Sexual)与色情未成年(Sexual Minor)以及暴力(Violence)与仇恨(Hate),以实现更细致的审核。不雅语言(Profanity)和威胁(Threat)类别采用自Perspective的分类体系。
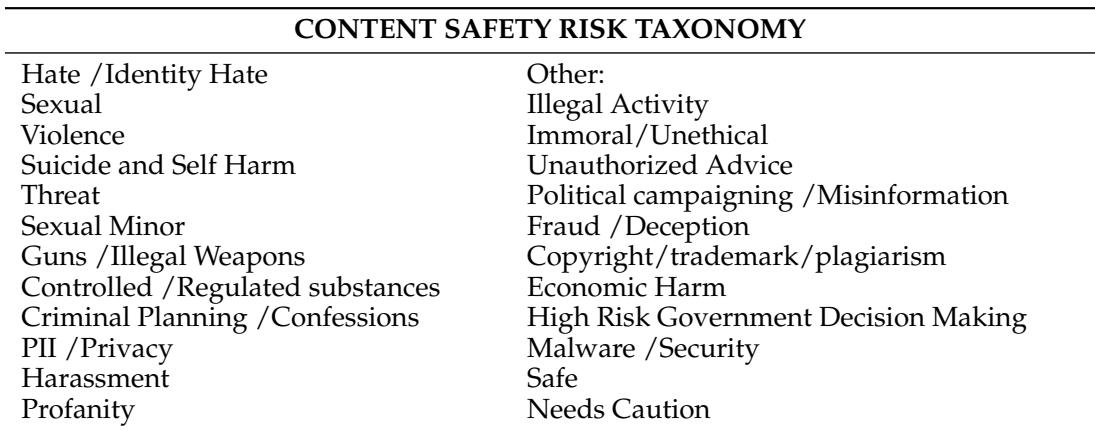
AEGIS安全数据集包含26,541条人类与LLM交互示例,涵盖七个风险类别的标注,分布高度不均衡。仇恨/身份仇恨(Hate/Identity Hate)和暴力(Violence)是最突出的类别,而威胁(Threat)和色情未成年(Sexual Minor)的样本最少。仇恨/身份仇恨(Hate/Identity Hate)获得的标注数量最多,其次是暴力(Violence)。威胁(Threat)和色情未成年(Sexual Minor)的标注数量最少,均不足100条示例。自杀与自我伤害(Suicide and Self Harm)和枪支/非法武器(Guns/Illegal Weapons)出现在中等频率,数量在数百级别。
AEGIS安全专家模型在仅使用AEGIS安全数据集一半数据进行指令微调的情况下,在离策略和在线策略基准测试的AUPRC或F1指标上均优于基础模型。与现有API和基线模型相比,它们还对分布外数据展现出更强的泛化能力,而现有方法在新颖或近分布的安全风险上表现不佳。AEGIS防御变体和宽容变体在在策略测试集上的AUPRC均高于基础Llama Guard,其中防御变体达到0.941的AUPRC。在ToxicChat离策略基准测试上,两个AEGIS变体在AUPRC上均优于Llama Guard基础和OpenAI Mod API。Perspective和OpenAI Mod等现有API在在策略数据集上的F1分数(0.24和0.34)远低于AEGIS变体(0.76和0.85)。
该表比较了SimpleSafetyTests上关键安全风险的准确率,显示所提出的防御和宽容模型取得了最高分数,其中防御LlamaGuard变体达到了完美准确率。所有自有模型均优于Perspective API、LlamaGuard基础和GPT-4等外部基线。尽管训练期间对安全指令长度有限制,防御NEMO模型仍表现出竞争力。所提出的LlamaGuard防御变体达到了完美准确率,是所有被评估模型中最高的。自有模型始终优于外部基线,最小差距超过4个百分点。即使系统提示中的安全指令长度受限,防御NEMO模型仍保持竞争力。
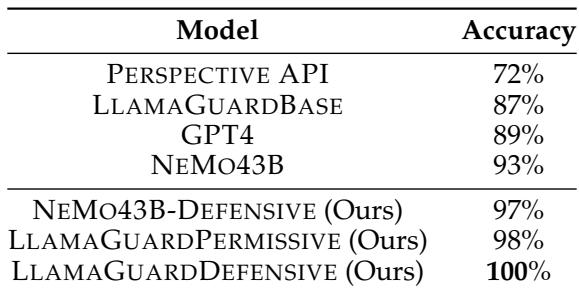
实验结果验证了AEGIS安全分类体系和数据集的有效性,该体系整合并细化了现有行业分类体系中的类别,并表明使用该数据进行指令微调的模型在在策略和离策略基准测试上均显著优于基础模型和外部API。AEGIS变体展现出更强的分布外风险泛化能力,并在关键安全测试中取得更高分数,防御LlamaGuard变体达到完美准确率,而现有API在不均衡数据集上明显落后。总体而言,研究结果证实,量身定制的分类体系和训练方法提供了更有效、更鲁棒的内容审核解决方案。