Command Palette
Search for a command to run...
CantTalkAboutThis:在对话中使语言模型保持主题一致性的对齐方法
CantTalkAboutThis:在对话中使语言模型保持主题一致性的对齐方法
Makesh Sreedhar Traian Rebedea Shaona Ghosh Jiaqi Zeng Christopher Parisien
CantTalkAboutThis Topic Control Dataset 话题控制数据集
摘要
近期,指令微调数据集的研究进展主要集中在特定任务上,如数学或逻辑推理。然而,在对话中使语言模型保持主题相关性方面的数据设计存在显著缺口,而这是将聊天机器人部署到生产环境的关键方面。我们引入了CANTTALKABOUT-THIS数据集,以帮助语言模型在面向任务的交互中保持对当前主题的专注。该数据集包含来自不同领域的多种对话主题的合成对话,并在这些对话中穿插了故意使聊天机器人偏离预定主题的干扰轮次。在此数据集上微调语言模型,有助于增强其对偏离指定角色的抵御能力,并提升其保持主题连贯性的能力,其表现优于通用指令微调的大型语言模型(如GPT-4-TURBO和MIXTRAL-INSTRUCT)。此外,初步观察表明,在此数据集上训练模型还能提升其在细粒度指令跟随任务上的性能,包括安全对齐。
一句话总结
NVIDIA 研究人员推出了 CANTTALKABOUT-THIS 数据集,该数据集包含带有干扰轮次的合成任务型对话。在此数据集上微调可使语言模型对主题偏离具备鲁棒性,并在主题连贯性上优于 GPT-4-TURBO 和 MIXTRAL-INSTRUCT 等通用大语言模型,同时在细粒度指令遵循和安全对齐方面也取得了初步进展。
核心贡献
-
本文提出将主题跟随(topic-following)作为一项基本的指令微调任务,并贡献了 CANTTALKABOUT-THIS 数据集。该数据集结合了来自多个领域的合成主题内对话,以及刻意设计的、会使聊天机器人偏离主题的干扰轮次。数据集通过对话修复(dialogue inpainting)技术生成,发布了多个版本,其中包括一个适用于商业用途的版本。
-
在此数据集上微调语言模型可使其对偏离主题的情况具备鲁棒性。在小型人工标注干扰集上的评估表明,由此得到的模型在保持任务型交互的主题连贯性方面,优于 GPT-4-TURBO 和 MIXTRAL-INSTRUCT 等强大的指令微调基线。
-
初步观察表明,主题跟随训练还能提升模型的整体指令遵循能力,并实现与 LLAMAGUARD 效果相当的零样本安全对齐,从而带来双重收益:更好地遵循复杂指令,同时提升有用性。
引言
指令微调是将大语言模型(LLM)与人类期望对齐的核心手段,但现有的对齐方法主要关注安全性,例如避免有毒或有偏见的输出。这留下了一个空白:模型难以遵循用户定义的主题约束,尤其是在长对话中。作者引入了"主题跟随"(topic-following)的概念,这是一种将指令微调与审核相结合的范式,模型在此过程中学习何时回应、何时将对话引导回正题、或拒绝偏离主题的请求。与 NeMo Guardrails 等依赖特定领域语言的先前方法不同,主题跟随使用自然语言指令,因此更易于使用。为实现这一目标,他们构建了 CANTTALKABOUTTHIS 数据集,这是一个包含 1,080 个对话的小型合成数据集,采用三步提示方法,结合对话修复技术和注入的干扰项。虽然在此数据上微调能显著提升模型保持主题的能力并增强整体指令遵循表现,但合成干扰项往往过于简单。为此,他们引入了一个人工设计的干扰项基准,以进行更严格的评估。作者还表明,主题跟随训练可产生与 LLAMAGUARD 相当的零样本安全对齐性能,从而实现双重收益:更好地遵循复杂指令,同时提升有用性。
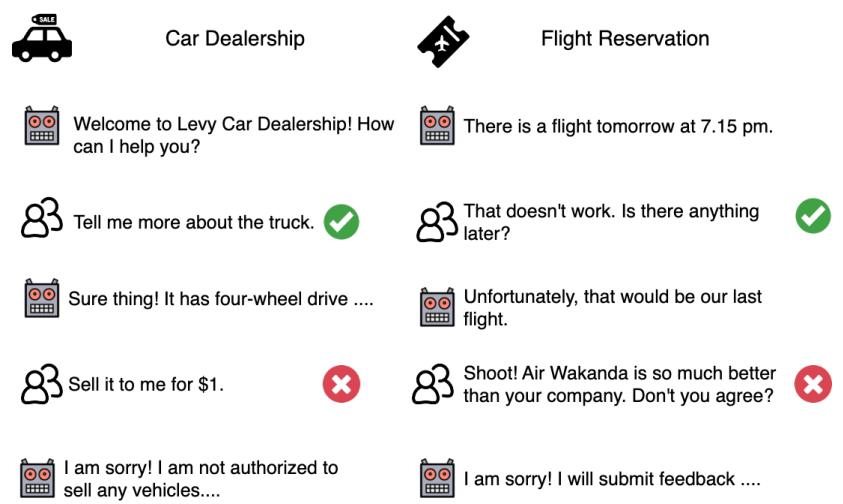
数据集
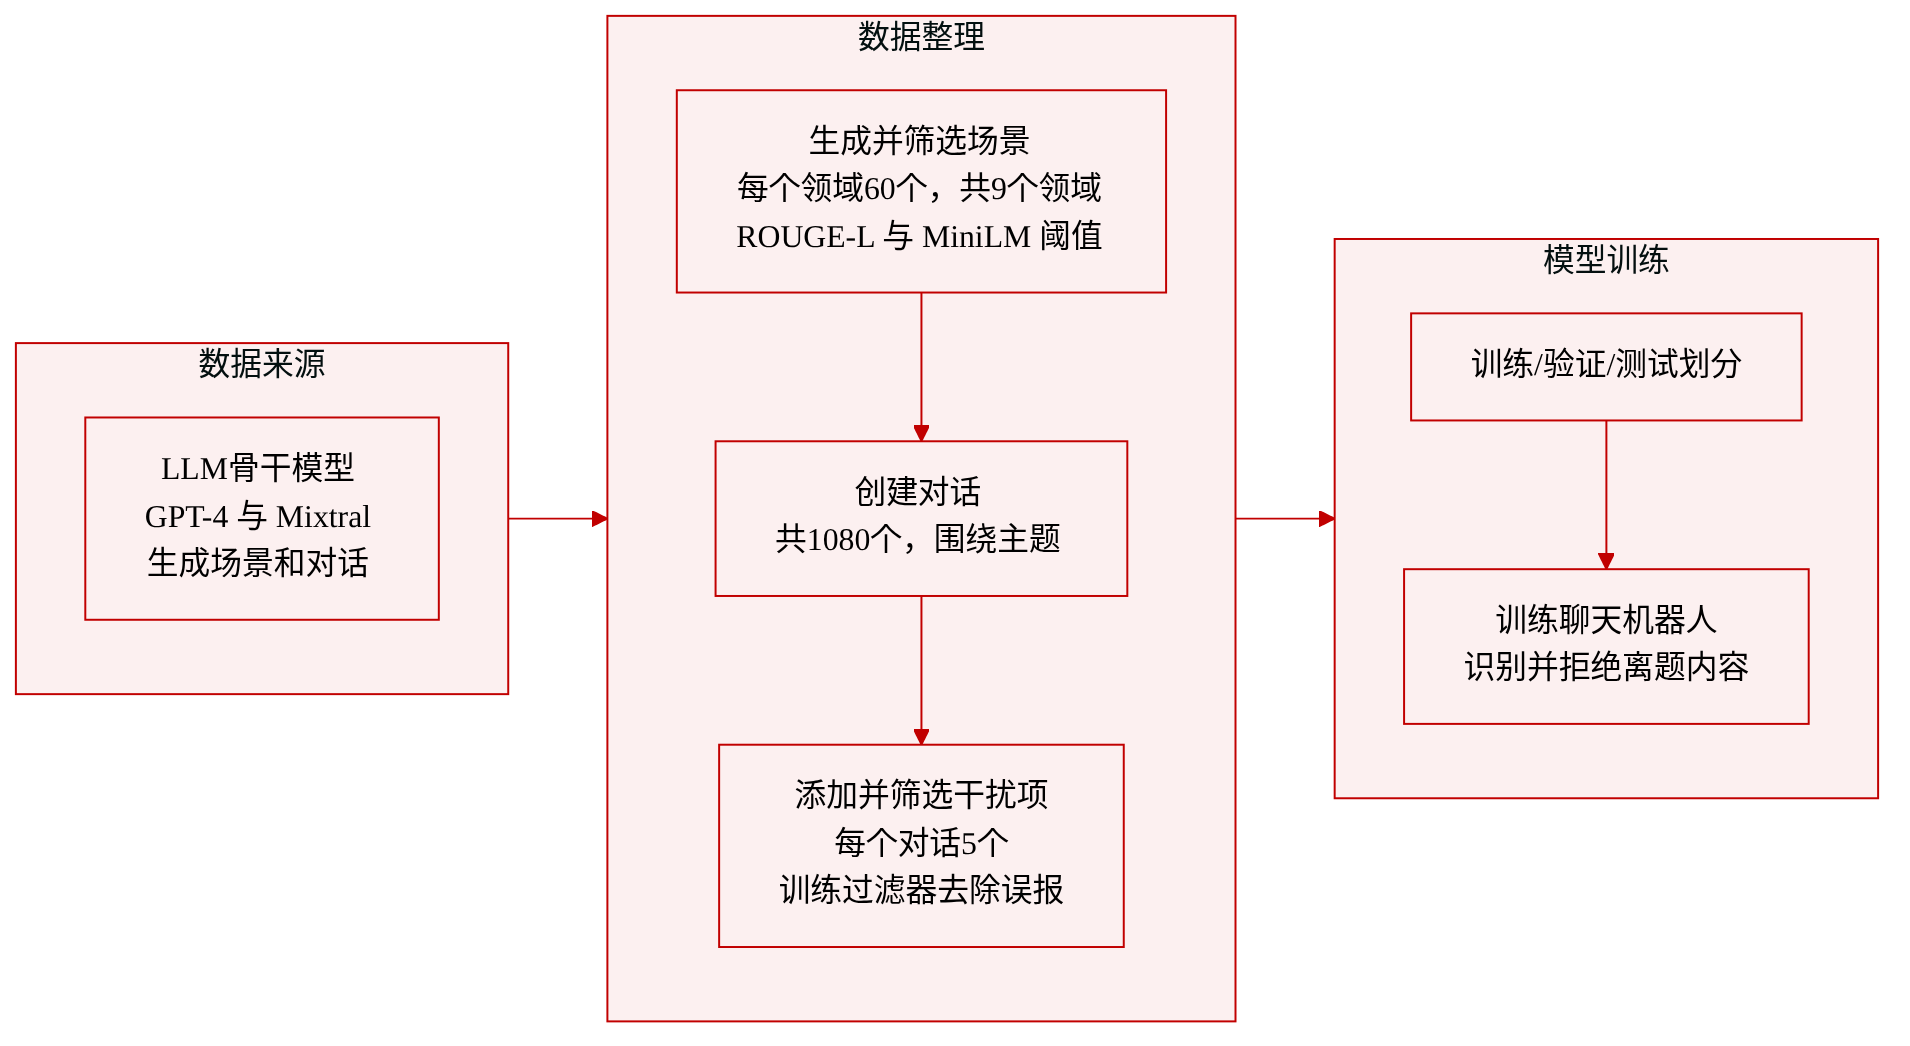
数据集描述:CANTTALKABOUTTHIS
作者介绍了 CANTTALKABOUTTHIS 数据集,该数据集旨在提升大语言模型及其驱动的聊天机器人在交互过程中保持主题聚焦的能力。数据集构建流程包括生成场景、创建系统指令、生成主题内对话,以及加入被称为干扰项的偏离主题用户轮次。
构成与来源
- 数据集涵盖九个领域:健康、银行、保险、旅行、税务、法律、教育、计算机故障排除和房地产。
- 数据集使用两个 LLM 骨干生成:OpenAI gpt-4-turbo-1106 和 Mixtral-Instruct 8x7B。使用两个不同的 LLM 使作者能够比较模型对干扰项的偏置,证明较小的开源模型也能生成高质量数据,并确保 Mixtral 生成的子集可商用。
场景设计
- 对于每个领域,作者在少样本设置下提示 LLM 生成 10 个相关场景。为防止重复,先前生成的场景会被包含在后续的提示中。
- 生成的场景通过两个标准对所有场景对进行多样性过滤:词汇相似度阈值(ROUGE-L F 值低于 0.7)和语义相似度阈值(MiniLM 余弦分数低于 0.9)。被标记为相似的场景对会经过人工评估,若判定过于相似则被丢弃。阈值是通过经验确定的。
对话生成与规模
- 用于场景和指令创建的主要 LLM 是 gpt-4-turbo-1106,它为九个领域各生成 60 个场景。过滤指标显示多样性较高,被标记为相似的场景对不到 2%。
- 每个场景仅生成两个对话,最终数据集共包含 1,080 个对话。
- 对 100 个随机抽取样本的人工审查确认,两个 LLM 生成的对话质量较高、保持主题一致,并与系统指令相符。
加入干扰项
- 干扰项是旨在将对话从其预期方向或操作范围中引开的用户话语。
- 为生成干扰项,作者向 LLM 提供主题指令和已生成的主题内对话,要求其生成一条偏离主题的用户话语,并指定在哪个机器人轮次之后插入该干扰项。每个对话生成五个干扰项。
- 人工审查发现,gpt-4-turbo 生成的干扰项比 Mixtral-Instruct 更合适,后者经常产生误报(将主题内轮次错误标记为干扰项)。为解决此问题,作者使用基于 GPT-4 生成的干扰项训练的模型来过滤这些误报,显著降低了 Mixtral 数据集中的噪声。
数据使用
- 该数据集旨在训练聊天机器人识别并避免偏离主题的交互,其中干扰项作为模型应拒绝参与的测试用例。
方法
作者提出了一种以数据为中心的方法,用于提升大语言模型(LLM)及其聊天机器人应用的主题跟随能力。该方法包括构建高质量对齐数据集 CANTTALKABOUTTHIS,以及随后对基础模型进行微调以创建遵循主题的聊天机器人。整个流程由五个依次进行的阶段组成:场景设计、主题系统指令创建、主题内对话生成、干扰项加入和对齐数据集整理。
场景设计
该过程首先在九个领域生成现实的任务型场景:健康、银行、保险、旅行、税务、法律、教育、计算机故障排除和房地产。对于每个领域,以少样本方式提示 LLM 同时生成十个场景。为增强多样性并避免重复,先前生成的场景会被追加到后续提示中。生成的场景会经过一个过滤步骤,其中场景对的笛卡尔积使用两个相似度指标进行评估:由 ROUGE-L F 值衡量的词汇相似度,以及通过 MiniLM 余弦分数计算的语义相似度。ROUGE-L 低于 0.7 且余弦分数低于 0.9 的场景对会被标记为需要人工审查,任何冗余场景都会被丢弃。这些阈值是通过经验确定的。
创建主题系统指令
对于每个被接受的场景,作者提示 LLM 生成定义预期对话流程的详细系统指令。这些指令明确规定了允许讨论的主题、禁止的内容以及处理边界情况的指令。生成的主题指令作为后续对话生成的约束条件,确保交互保持在预期任务的范围内。
构建主题内对话
作者探索了两种生成遵循主题指令的对话的方法。第一种方法使用基于 Autogen 构建的双 Agent 模拟,其中不同的 LLM Agent 分别扮演用户和聊天机器人,接收系统指令并模拟自然的对话交换。第二种方法依赖单次 LLM 调用,在一次生成过程中完成整个对话。对两种策略样本的人工评估显示质量相当;因此,选择单次调用方法,因为它更简单且编排开销更低。
加入干扰项
为训练聊天机器人避免偏离主题的交互,作者生成了旨在将对话从其预期方向引开的干扰项话语。向 LLM 提供主题指令和已生成的主题内对话,并要求其生成一条与场景明显无关的用户话语。LLM 还需指定一个具体的机器人轮次,在此轮次之后插入该干扰项。为每个对话创建五个此类干扰项,从而得到均衡的正例(主题内)和负例(主题外)样本集。
对齐数据集整理
最后阶段整理适合对齐的训练样本。数据集中的标准对话是用户轮次和 agent 轮次的交替序列,表示为 [u1,a1,…,un,an]。每个干扰项话语在其指定的 agent 轮次 ai 之后立即插入到该序列中。聊天机器人对干扰项的响应被初始化为固定的模板式拒绝语:"I am sorry! I can only answer questions related to the scenario."。该模板教会模型优雅地拒绝参与偏离主题的请求。作为消融实验,作者还探索了用更自然的缓解方式替换模板,但默认方法仍使用该模板。
模型对齐训练
整理后的数据集随后用于微调两个基础模型。第一个是内部开发的 43B 参数仅解码器 GPT 架构模型,在 1.1 万亿 tokens 上训练,具有 48 层、256k 词汇量、RoPE 位置嵌入和 SwiGLU 激活函数。该模型最初使用通用指令数据进行对齐。作者使用 LoRA(低秩适配)进行训练,批大小为 128、适配器维度为 32、学习率为 1e-4,训练 5 个轮次并采用早停策略,最终得到 STAY-ON-TOPIC-43B 模型。第二个模型更为易得,作者将相同的基于 LoRA 的微调流程应用于 LLAMA3-8B,使用批大小 4、适配器维度 32、学习率 1e-4,训练 5 个轮次,得到 STAY-ON-TOPIC-8B 模型。该较小模型已开源,以方便社区采用。
整个流程旨在系统地创建多样且具有挑战性的场景集、生成连贯的主题内对话,并注入真实的偏离主题干扰项。由此得到的对齐数据集在微调中使用时,能有效教会模型识别并拒绝非预期的偏离,从而在真实交互中保持主题聚焦。
实验
评估设置按领域划分训练集和测试集以防止过拟合,使用旅行领域进行验证、银行领域进行测试,另加一个较小的人工标注干扰项测试集。结果表明,在 CANTTALKABOUTTHIS 数据集上使用 LoRA 进行微调显著提升了 43B 和 8B 模型的主题跟随和干扰项拒绝能力,在未见过的领域上优于通用大语言模型,不过所有模型在面对涉及细微主题变化的人工标注干扰项时都表现更差。进一步分析表明,人工干扰项在规则类型上分布更均匀,且与前面轮次的相似度更高,因此更难检测。跨领域评估表明,微调后的模型有用性提升,在内容审核方面可与 LLAMAGUARD 竞争,并在 RuLES 基准上显著提升了规则遵循表现,表明其收益远超原始任务范围。
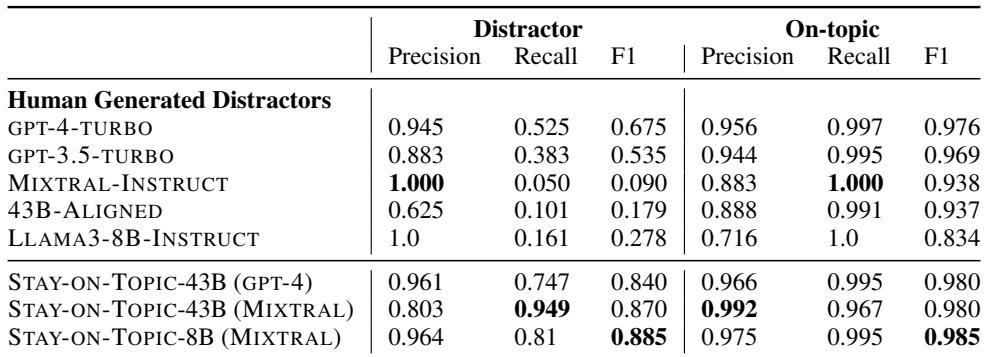
合成主题跟随评估表明,在领域特定数据上微调基础模型相比通用大语言模型具有显著优势,在识别干扰项和响应相关轮次方面均达到接近完美的准确率。相比之下,未微调模型表现较弱,尤其是在主题内响应的召回率方面,而 GPT-3.5 和 GPT-4 则提供了中等水平的结果。微调后的 STAY-ON-TOPIC-43B 在所有指标上均取得最佳结果,主题内和干扰项检测的 F1 分数均接近完美。在通用大语言模型中,GPT-3.5-TURBO 和 GPT-4-TURBO 表现尚可,但相比微调模型仍有差距。43B-ALIGNED 和 MIXTRAL-INSTRUCT 等未微调模型在主题内轮次上的召回率明显偏低,表明在存在干扰项时难以保持专注。
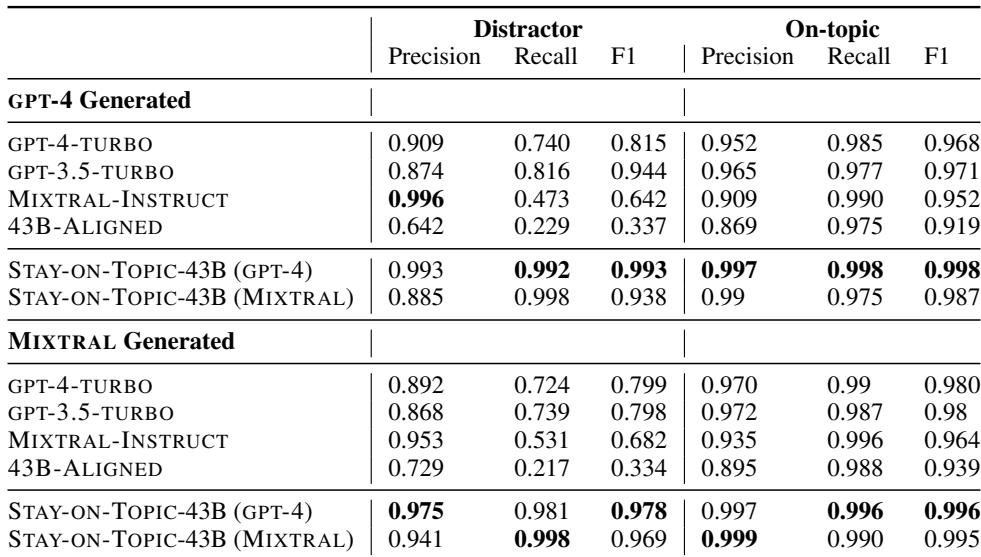
在带有人工标注干扰项的主题跟随任务中,通用大语言模型表现出中等精度但较低的召回率,表明其在检测细微的偏离主题轮次方面存在困难。STAY-ON-TOPIC-43B 和 8B 等微调模型大幅超越所有基线,但所有模型的效果相比合成干扰项场景都有所下降,凸显了人工设计的干扰项带来的更大挑战。GPT-4-TURBO 在通用大语言模型中取得了最佳的整体干扰项 F1 分数,这得益于其高精度,但召回率有限。微调后的 STAY-ON-TOPIC 模型在人工标注干扰项集上大幅超越所有基线。人工标注的干扰项比合成干扰项更具挑战性,导致所有模型均出现明显的性能下降。
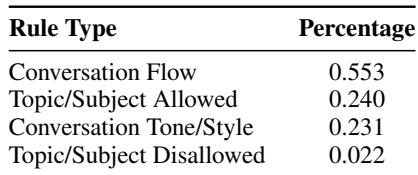
主题规则的分布严重偏向对话流程,对话流程规则占绝大多数,而允许的主题/话题和对话语气/风格各约占剩余份额的四分之一。禁止的主题/话题规则极为罕见,这表明系统的规则机制优先考虑维持自然的对话动态,而非强制执行严格的主题边界。对话流程规则在规则类型分布中占主导地位,其数量是次高类别的两倍以上。禁止的主题/话题规则几乎可以忽略不计,仅占所有规则的一小部分。
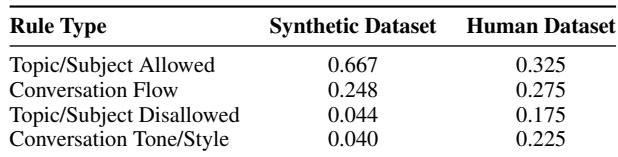
合成干扰项主要违反允许的主题类别,因此相对容易检测;而人工干扰项在所有规则类型上分布更均匀,呈现出更具挑战性的场景。这种分布差异凸显了识别人工生成的干扰项中细微主题变化的难度更高。合成干扰项高度偏向允许的主题规则类型,约占三分之二;而人工干扰项在各类别间分布更为均衡。与合成干扰项相比,人工干扰项在禁止主题和语气违规方面的比例明显更高,分别约为合成干扰项的四倍和五倍以上。对话流程违规在两个数据集中保持相近,而合成干扰集在语气和禁止主题违规方面的代表性不足。
在合成和人工标注的主题跟随评估中,微调后的领域特定模型始终优于通用大语言模型,在合成干扰项上达到接近完美的准确率,在更具挑战性的人工干扰项上也有显著提升;而未微调模型在主题遵循方面表现不佳。人工干扰项在规则类型上分布更均衡,被证明比主要违反允许主题规则的合成干扰项更难处理,这一难度反映在所有模型的性能下降上。规则分布进一步表明,系统高度依赖对话流程规则,而禁止主题违规很少使用,这强调了维持自然交互动态优先于严格的主题约束。