Command Palette
Search for a command to run...
LLMLingua-2:面向高效且忠实任务无关提示压缩的数据蒸馏
LLMLingua-2:面向高效且忠实任务无关提示压缩的数据蒸馏
MeetingBank-LLMCompressed 会议记录压缩训练数据集
摘要
本文聚焦于任务无关的提示压缩,以提升泛化性和效率。鉴于自然语言中存在冗余,现有方法通过基于因果语言模型(如 LLaMa-7B)计算的信息熵,移除标记或词汇单元来压缩提示。挑战在于信息熵可能并非最优的压缩度量:(i) 它仅利用单向上下文,可能无法捕捉提示压缩所需的全部关键信息;(ii) 它与提示压缩的目标不一致。为解决这些问题,我们提出了一种数据蒸馏流程,从大语言模型(LLM)中提取知识,在不丢失关键信息的前提下压缩提示,同时引入了一个抽取式文本压缩数据集。我们将提示压缩形式化为一个标记分类问题,以确保压缩后的提示与原始提示的忠实性,并使用 Transformer 编码器作为基础架构,从完整的双向上下文中捕捉所有必要信息。通过使用较小的模型(如 XLM-RoBERTa-large 和 mBERT)显式学习压缩目标,我们的方法实现了更低的延迟。我们在领域内和领域外数据集上评估了我们的方法,包括 MeetingBank、LongBench、ZeroScrolls、GSM8K 和 BBH。尽管模型规模较小,但相较于强基线,我们的模型表现出显著的性能提升,并在不同 LLM 上展现出强大的泛化能力。此外,与现有提示压缩方法相比,我们的模型速度提升了 3 倍至 6 倍,在压缩比为 2 倍至 5 倍时,端到端延迟加速了 1.6 倍至 2.9 倍。
一句话总结
清华大学和微软的研究人员提出了 LLMLingua-2,一种任务无关的提示压缩方法,将压缩形式化为使用在蒸馏抽取数据集上训练的 Transformer 编码器进行的 token 分类任务,用双向上下文取代基于熵的因果 LLaMa-7B 选择,实现 3x−6x 更快的压缩速度,同时在 Meeting-Bank 和 GSM8K 等基准测试中保持忠实、可泛化的性能。
核心贡献
- 论文引入了一种数据蒸馏流程,从 LLM(GPT-4)中获取知识来压缩提示而不丢失必要信息,并公开发布了一个基于 MeetingBank 源文本及其压缩版本构建的抽取式文本压缩数据集。
- 论文将提示压缩形式化为 token 分类任务,其中每个 token 被标记为保留或丢弃,使用 Transformer 编码器从完整双向上下文中捕获必要信息,同时依赖 XLM-RoBERTa-large 和 mBERT 等小型模型来实现更低延迟并保证压缩提示对原始内容的忠实性。
- 结果表明,在域内和域外基准测试中,相对于强基线取得了显著的性能提升,在从 GPT-3.5-Turbo 到 Mistral-7B 的各种 LLM 上具有稳健的泛化能力,压缩速度比现有方法快 3 到 6 倍,在 2 到 5 倍压缩比下端到端延迟加速 1.6 到 2.9 倍。
引言
思维链提示和检索增强生成等技术的最新进展已使 LLM 提示达到数万个 token,导致计算成本更高、延迟增加和信息感知能力下降。提示压缩解决了这些问题,但现有的任务感知方法依赖任务特定特征而牺牲了泛化能力,而使用因果小语言模型信息熵的任务无关方法面临两个主要挑战:熵指标与压缩目标不一致,以及单向上下文无法捕获所有必要信息。此外,当前的压缩数据集要么是抽象式的,存在幻觉内容风险,要么是抽取式的且缺乏下游任务的细节。
作者通过首先提出一种数据蒸馏流程来解决这些问题,该流程利用 GPT-4 从 MeetingBank 创建新的抽取式压缩数据集,保留关键信息。然后他们将提示压缩重新形式化为 token 分类任务,由 Transformer 编码器预测每个 token 是否应被保留,有效利用完整双向上下文并保证对原始内容的忠实性。他们的模型在域内和域外基准测试中相对于强基线取得了显著的性能提升,同时比现有压缩方法快 3 到 6 倍,在 2 到 5 倍压缩比下实现 1.6 到 2.9 倍的端到端延迟改进。
数据集
数据集概述
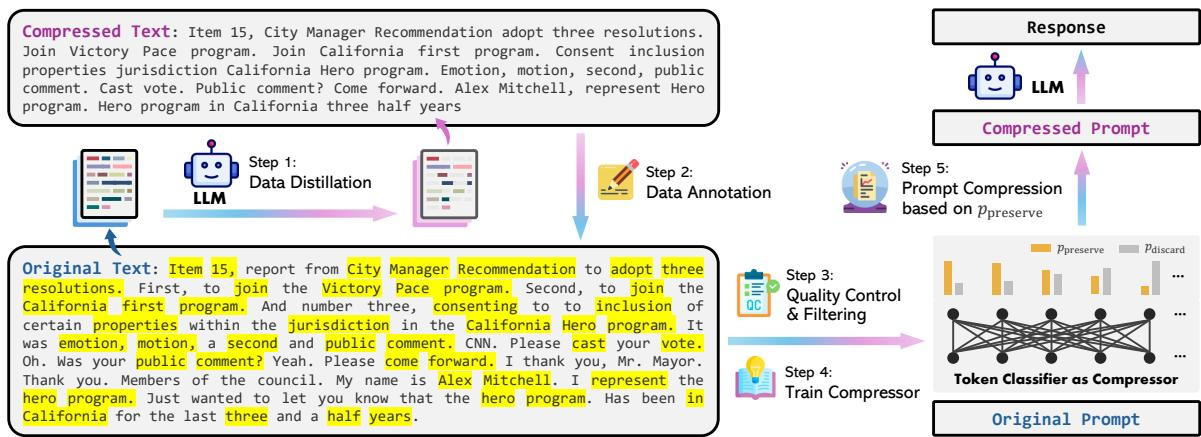
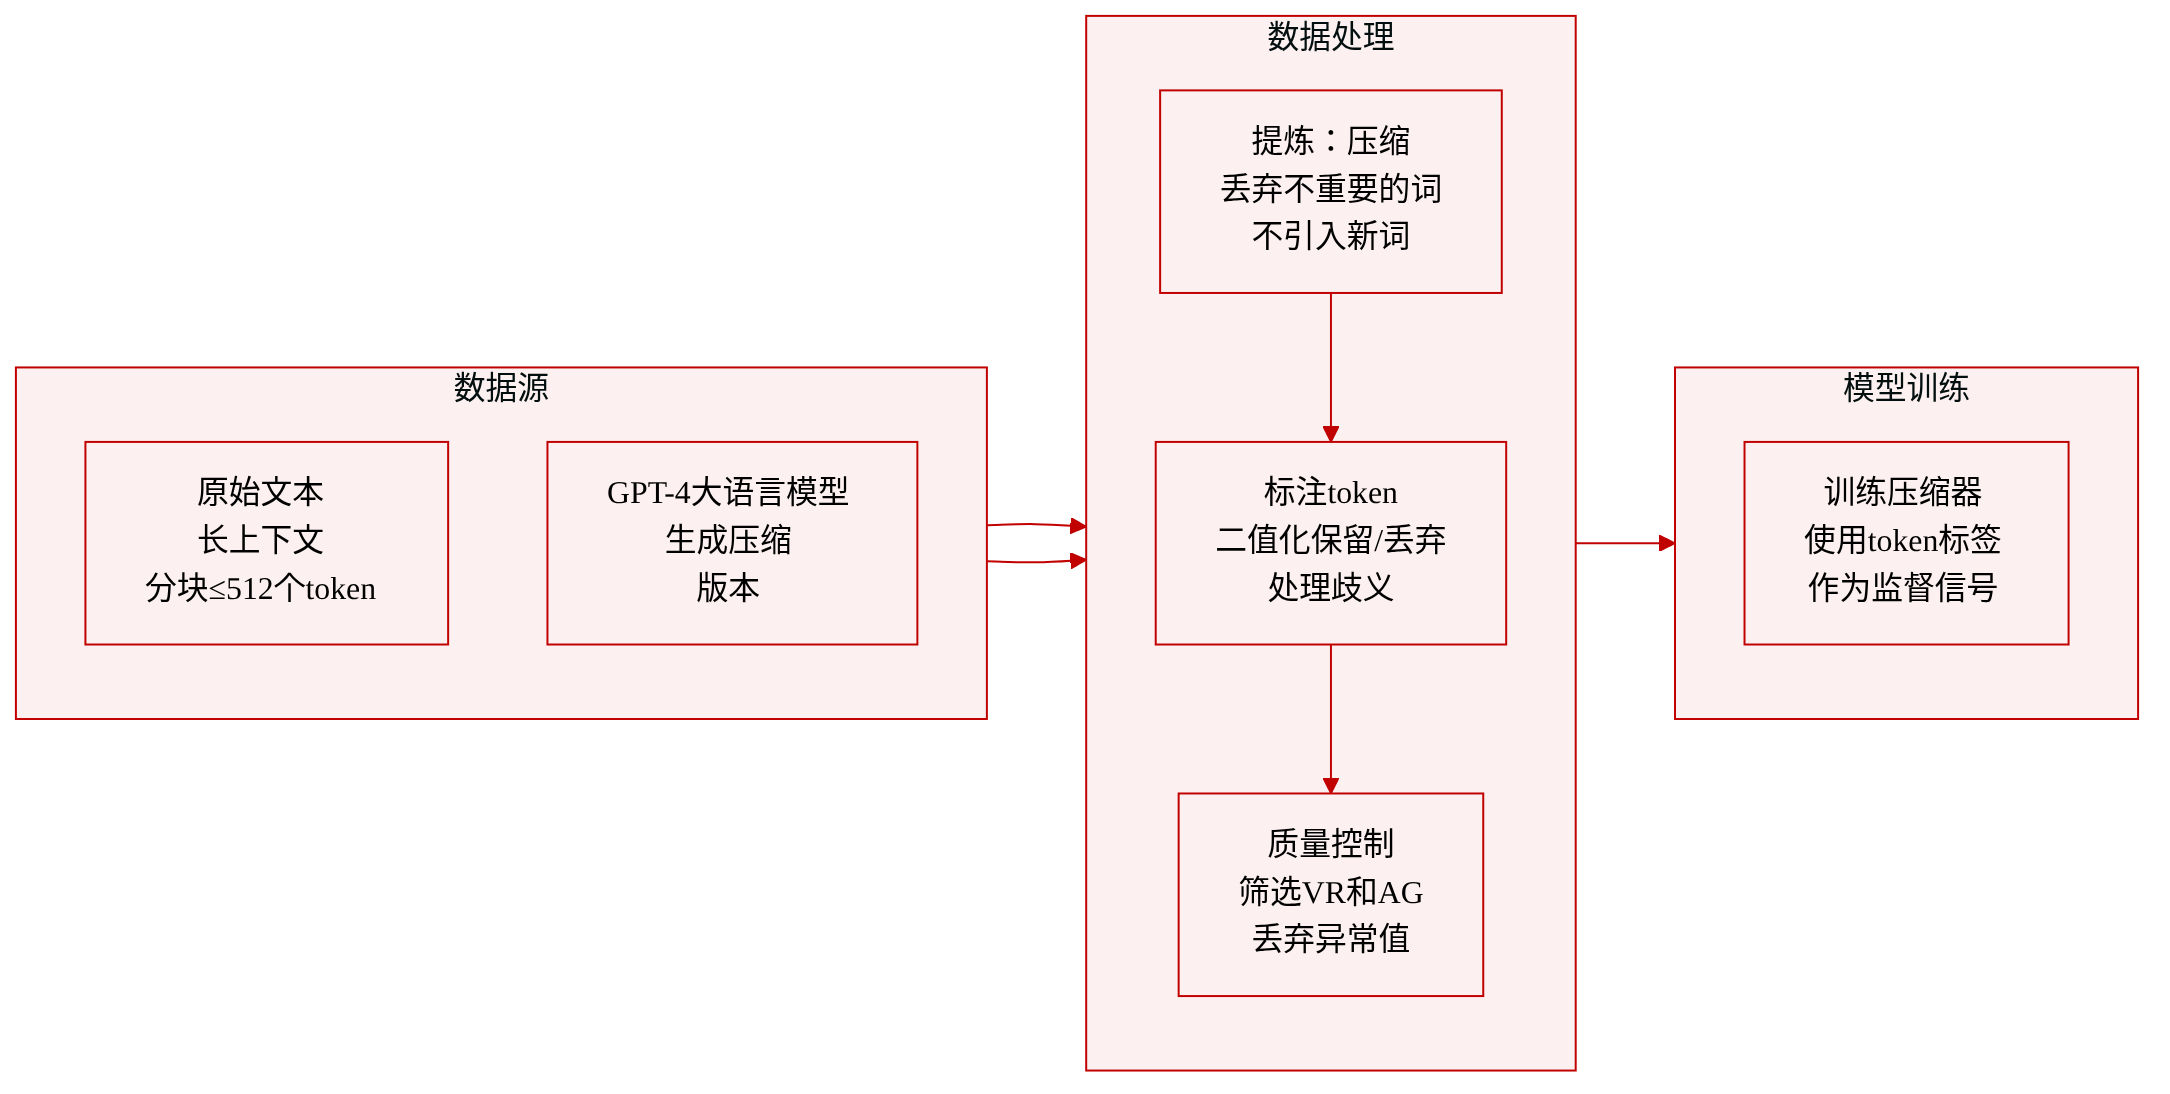
数据集基于两个主要来源构建:原始文本及其由 LLM 生成的压缩版本。为了创建高质量的训练数据,作者设计了一个三阶段流程,包括数据蒸馏、数据标注和质量控制。
1. 数据蒸馏
- 作者使用 GPT-4 生成原始文本的压缩版本。
- 目标是使压缩后的提示满足三个标准:token 减少、信息性和忠实性。
- 指令明确告诉 GPT-4 从原始文本中丢弃不重要的词而不添加任何新词,以减少幻觉内容。
- 不使用固定压缩比。相反,GPT-4 被提示在尽可能保留信息的同时将原始文本压缩到尽可能短。
- 为保持性能,长上下文被分割为不超过 512 个 token 的块,以句号结尾。每个块单独压缩,以避免高压缩比导致信息丢失。
2. 数据标注
- 原始文本和压缩文本的配对用于创建 token 级标签。
- 原始文本中的每个 token 被分配一个二元标签,指示压缩后应保留还是丢弃。
- 标注过程解决了三个主要挑战:歧义(一个词可能在原始文本中出现多次)、变体(GPT-4 可能改变时态或复数形式)和重排(压缩版本中词的顺序可能改变)。
3. 质量控制
- 引入两个指标来过滤低质量样本。
- 变体率(VR):衡量压缩文本中原始文本中不存在的词的比例。较高的比率表明幻觉内容的可能性更大,因此排除 VR 最高的前 5% 样本。
- 对齐差距(AG):衡量自动标注标签的质量。定义为命中率(压缩文本中的词在原始文本中找到的比例)与匹配率(原始词被正确标记为保留的比例)之间的差异。完美标注的 AG 为 0。丢弃 AG 最高的前 10% 样本。
生成的过滤数据集用于训练提示压缩模型,其中二元标签作为决定保留哪些 token 的监督信号。
方法
所提出的方法建立了一个提示压缩流程,集成了数据蒸馏过程、严格的质量控制机制和 token 分类模型。框架首先从大语言模型(GPT-4)中提取知识以生成压缩文本。为确保忠实性,指令设计明确限制模型从原始文本中丢弃不重要的词而不添加任何新内容。此外,为适应不同文本类型的信息密度差异,指令中移除了固定压缩比限制,允许模型在保留必要信息的同时尽可能简洁地压缩文本。
然而,作者观察到 GPT-4 在处理非常长的上下文时倾向于应用激进的压缩比,这导致大量信息丢失。
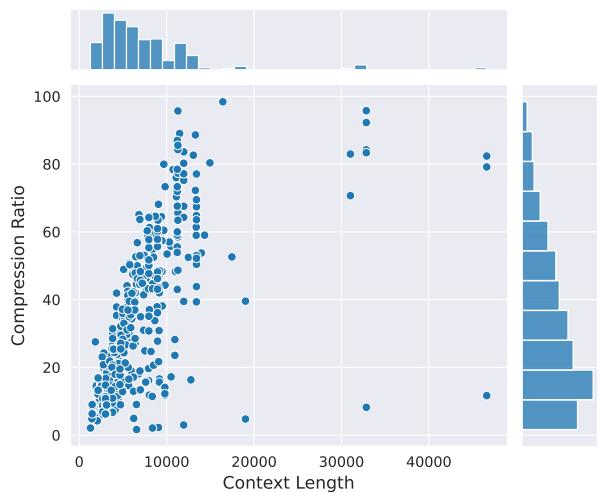
如下图所示,压缩比与上下文长度之间存在明显的相关性,压缩比随上下文长度增加而增大。为缓解此问题,蒸馏流程将长上下文分割为多个块,每个块包含不超过 512 个 token 并以句号结尾,然后单独压缩。
在生成压缩文本配对后,系统进入数据标注阶段,为原始文本中的每个 token 分配二元标签(保留或丢弃)。此过程解决了词歧义、词形变体和重排等挑战。为确保数据集质量,采用两个指标。变体率(VR)衡量压缩文本中原始文本中不存在的词的比例,作为幻觉内容的指标。其定义为:
VR=∣Scomp∣1w∈Scomp∑I(w∈/Sori)VR 分数最高的前 5% 样本被排除。此外,对齐差距(AG)通过比较匹配率(MR)和命中率(HR)来评估标注质量。AG 计算如下:
AG=HR−MR对齐差距值最高的前 10% 样本被丢弃以保持高标注质量。
核心压缩模块被形式化为二元 token 分类问题。架构利用 Transformer 编码器 fθ 作为特征提取器来捕获双向上下文信息,然后接一个线性分类层。给定原始提示 x={xi}i=1N,特征向量计算如下:
h=fθ(x)第 i 个 token 的概率分布则预测为:
p(xi,Θ)= softmax (Whi+b)其中 Θ={θ,W,b} 表示可训练参数。模型使用交叉熵损失函数训练:
L(Θ)=N1i=1∑NCrossEntropy(yi,p(xi,Θ))其中 yi 表示第 i 个 token 的真实标签。
在推理过程中,压缩策略遵循三步流程以实现目标压缩比 1/τ。首先,计算要保留的目标 token 数为 N~=τN。接下来,模型预测每个 token 的保留概率 pi。最后,系统保留概率最高的前 N~ 个 token,保持其原始顺序以形成压缩提示。此方法确保低延迟和对原始内容的忠实性。
实验
实验评估了在 MeetingBank 数据上训练的 LLMLingua-2 提示压缩器,涵盖域内摘要和问答任务,以及使用 GPT-3.5 和 Mistral-7B 作为目标 LLM 的域外长上下文、推理和上下文学习基准。该方法优于任务无关基线,同时与原始提示保持竞争力,但在长上下文任务上落后于 LongLLMLingua 等任务感知压缩方法。其他发现突出了其低计算开销、有效的上下文感知信息保留、用于提示重建的可逆压缩,以及指令和分块压缩设计的重要性。
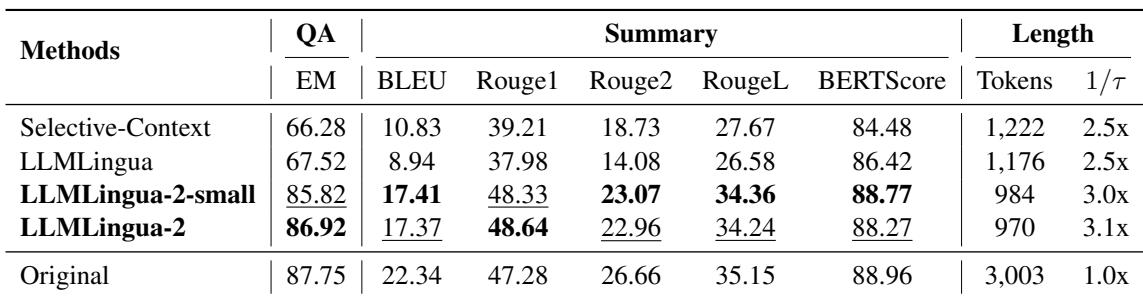
LLMLingua-2 及其较小变体在 MeetingBank 上优于先前的压缩基线,在使用的 token 远少于原始提示的情况下实现了显著更高的问答精确匹配和摘要分数。其性能接近未压缩的原始提示,表明在最小信息丢失的情况下实现了有效压缩。LLMLingua-2 将问答精确匹配比 LLMLingua 提高了约 19 个百分点,比 Selective-Context 提高了 20 多个百分点。LLMLingua-2 实现的摘要 RougeL 和 BERTScore 接近原始提示,尽管 token 数量压缩了约 3 倍。较小的 LLMLingua-2-small 模型的性能几乎与完整模型相当,展示了轻量级编码器的强大压缩能力。
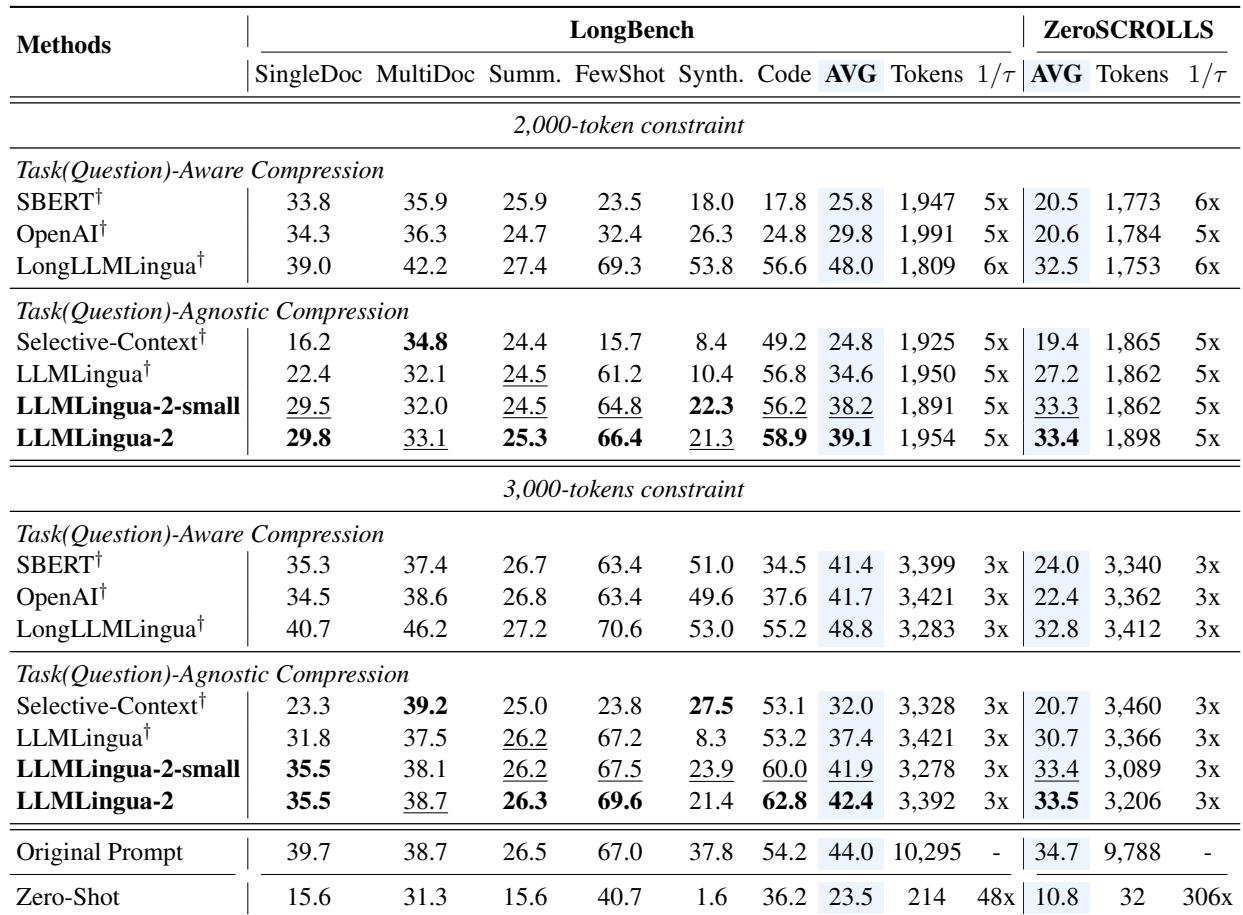
在域外长上下文基准测试中,LongLLMLingua 等任务感知压缩方法取得了最高平均分数,而所提出的任务无关模型 LLMLingua-2 优于其他任务无关基线,在某些情况下可以匹配或超过原始提示。然而,它仍然落后于利用问题信息的任务感知方法。LongLLMLingua 是一种任务感知方法,在 2,000 token 约束下在 LongBench 和 ZeroSCROLLS 上取得了最佳平均性能。任务无关的 LLMLingua-2 超过了其他任务无关基线,并在某些场景中显示出与原始提示相当或略好的结果。与任务感知压缩的性能差距归因于这些方法利用的额外问题派生信息。
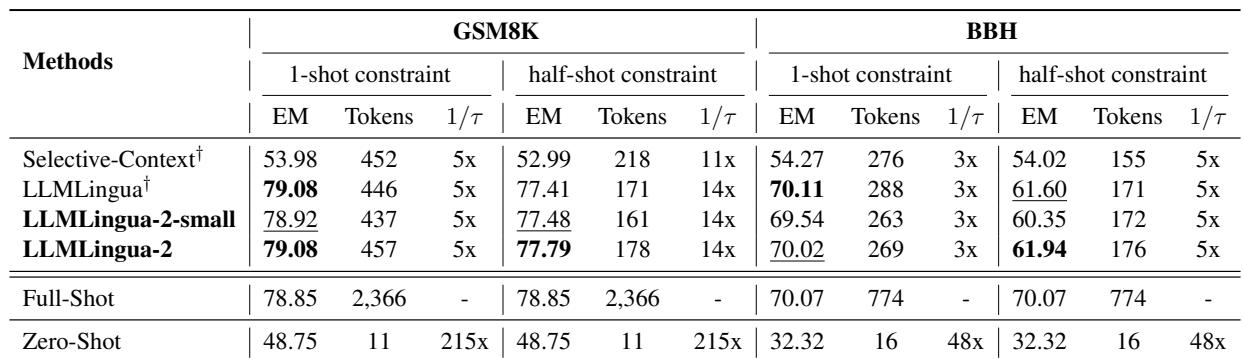
LLMLingua-2 及其较小变体在推理任务上匹配或超过原始完整提示的性能,同时使用远少于其的 token,并且优于 Selective-Context 和 LLMLingua 基线。在 GSM8K 和 BBH 上,不同样本数约束下的改进是一致的,完整的 LLMLingua-2 模型展示了准确率和压缩之间的最佳权衡。LLMLingua-2 在 GSM8K 上实现了与完整提示相当的准确率,同时将 token 使用量减少了约 5 到 14 倍。在半样本约束的 BBH 上,LLMLingua-2 在使用仅一小部分 token 的情况下略优于完整提示。较小的 LLMLingua-2-small 变体表现几乎与大模型相当,表明紧凑的压缩器可以保持强大的推理性能。
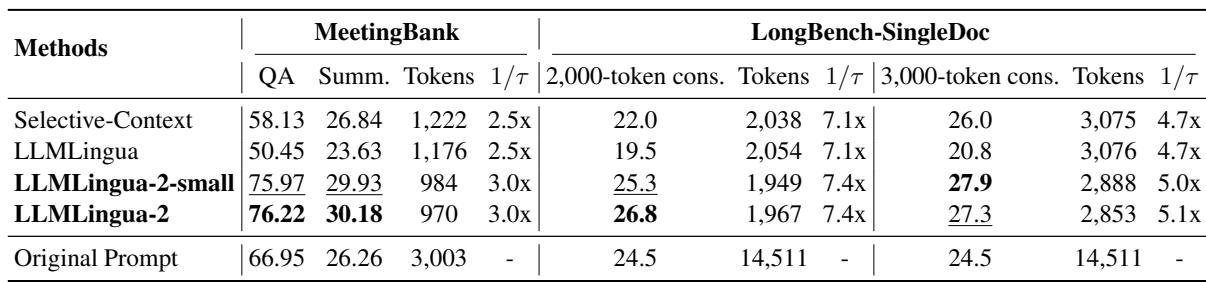
以 Mistral-7B 作为目标模型时,LLMLingua-2 及其较小变体在摘要和问答分数上均高于基线压缩方法和原始未压缩提示,同时使用的 token 远少于后者。性能提升表明更短、信息密集的提示可以改善 Mistral-7B 的推理质量,这可能是因为它处理长上下文的效果较差。LLMLingua-2 和 LLMLingua-2-small 在 MeetingBank 和 LongBench 任务上均优于 Selective-Context 和 LLMLingua。LLMLingua-2 生成的压缩提示比原始提示产生更好的结果,尽管使用的 token 约少 3 倍。较小的 LLMLingua-2-small 模型实现了与完整版本几乎相同的性能,展示了在缩小规模下的效率。
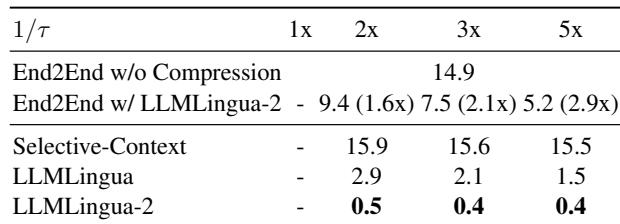
在 MeetingBank 上,LLMLingua-2 在所有压缩比下都比其他压缩基线实现更低的延迟。其端到端加速范围为 1.6 到 2.9 倍,同时将 GPU 内存成本降低 8 倍,表明计算开销显著更小。在 2 倍、3 倍和 5 倍压缩比下,LLMLingua-2 的延迟始终低于 Selective-Context 和 LLMLingua。LLMLingua-2 的端到端加速随压缩比增加而增大,在 5 倍压缩时达到最高 2.9 倍。与其他显示更高延迟的基线不同,LLMLingua-2 随压缩比增加而产生的额外延迟增长最小。
实验评估了任务无关提示压缩方法 LLMLingua-2,与 LLMLingua 和 Selective-Context 等基线在会议问答、摘要、推理和域外长上下文基准上进行对比。LLMLingua-2 及其较小变体在使用显著更少的 token 的同时一致地匹配或超过原始未压缩提示的性能,并明显优于压缩基线。在推理任务和以 Mistral-7B 为目标模型时,压缩提示甚至比原始提示更好,表明更短、信息密集的输入有利于长上下文处理能力较弱的模型。尽管利用问题信息的任务感知方法在某些长上下文基准上仍然领先,但 LLMLingua-2 还降低了延迟和 GPU 内存成本,其紧凑的小型版本性能几乎与完整模型相当。