Command Palette
Search for a command to run...
MobileCLIP:通过多模态强化训练实现快速图像-文本模型
MobileCLIP:通过多模态强化训练实现快速图像-文本模型
Pavan Kumar Anasosalu Vasu Hadi Pouransari Fartash Faghri Raviteja Vemulapalli Oncel Tuzel
DataComp-12M 图像-文本对
摘要
对比预训练的图像-文本基础模型(如 CLIP)在广泛的下游任务中展现出了优异的零样本性能和更强的鲁棒性。然而,这些模型采用了基于大型 Transformer 的编码器,带来了显著的内存和延迟开销,给在移动设备上的部署带来了挑战。在本研究中,我们引入了 MobileCLIP——一个针对运行时性能优化的新型高效图像-文本模型系列,并提出了一种新颖且高效的训练方法,即多模态强化训练。所提出的训练方法利用来自图像字幕模型和一组强 CLIP 编码器的知识迁移,以提高高效模型的准确性。通过将额外知识存储在强化数据集中,我们的方法避免了训练时的计算开销。MobileCLIP 在多个数据集的零样本分类和检索任务中,设立了新的延迟-精度权衡最先进水平。我们的 MobileCLIP-S2 变体相比之前基于 ViT-B/16 的最佳 CLIP 模型,速度快了 2.3 倍,同时精度更高。我们进一步验证了多模态强化训练的有效性,训练了一个基于 ViT-B/16 图像主干的 CLIP 模型,在 38 个评估基准上相比之前最佳模型实现了平均性能提升 +2.9%。此外,我们表明,与未强化的 CLIP 训练相比,所提出的方法实现了 10 倍至 1000 倍的学习效率提升。代码和模型可在 https://github.com/apple/ml-mobileclip 获取。
一句话总结
Apple 推出了 MobileCLIP,这是一个高效的图像-文本模型系列,其新颖的多模态强化训练通过强化数据集从字幕生成模型和一组 CLIP 编码器集成中迁移知识,从而避免训练时的计算开销。MobileCLIP-S2 的推理速度比 ViT-B/16 CLIP 快 2.3×,同时实现了更高的准确率,在 38 个基准测试中取得了新的最先进延迟-准确率权衡,并实现了 10×–1000× 的学习效率提升。
核心贡献
- 引入了 MobileCLIP,这是一个针对低延迟、设备端推理优化的高效卷积-Transformer 混合图像和文本编码器系列。MobileCLIP-S2 变体的运行速度快 2.3 倍,同时比之前最佳的基于 ViT-B/16 的 CLIP 模型实现了更高的准确率,为零样本分类和检索设定了新的最先进延迟-准确率权衡。
- 提出了多模态强化训练,这是一种将预训练图像字幕生成模型和一组强大的 CLIP 编码器集成的知识迁移到离线存储目标中的策略,从而避免训练时的计算开销。与先前最佳方法相比,该方法在 38 个评估基准测试中将基于 ViT-B/16 的 CLIP 模型的平均性能提升了 +2.9%。
- 贡献了 DataCompDR-12M 和 DataCompDR-1B,这是 DataComp 数据集的强化变体,其中包含了合成字幕和集成派生的目标。在这些数据集上训练相对于非强化 CLIP 训练展示了 10 倍到 1000 倍的学习效率提升。
引言
像 CLIP 这样的大型图像-文本模型虽然实现了强大的零样本性能,但对于移动端部署来说体积过大且速度过慢。先前的工作面临一个关键的权衡:大规模训练高效架构在计算上不可行,而小规模训练产生的准确率不高,无法指导设计选择。此外,较小的模型天生会损失准确率,需要更好的训练方法来弥补。
作者引入了一种数据集强化策略,用合成字幕和一组强大的预训练 CLIP 模型的嵌入来丰富 DataComp 数据集,从而得到 DataCompDR。这种方法极大地提升了学习效率,使得快速架构探索成为可能。利用这一策略,作者设计了 MobileCLIP,这是一个具有结构重参数化的混合 CNN-Transformer 编码器系列,实现了最先进的延迟-准确率权衡,其中最快的变体比标准 ViT-B/16 CLIP 快 5 倍且小 3 倍,同时保持相似的准确率。
数据集
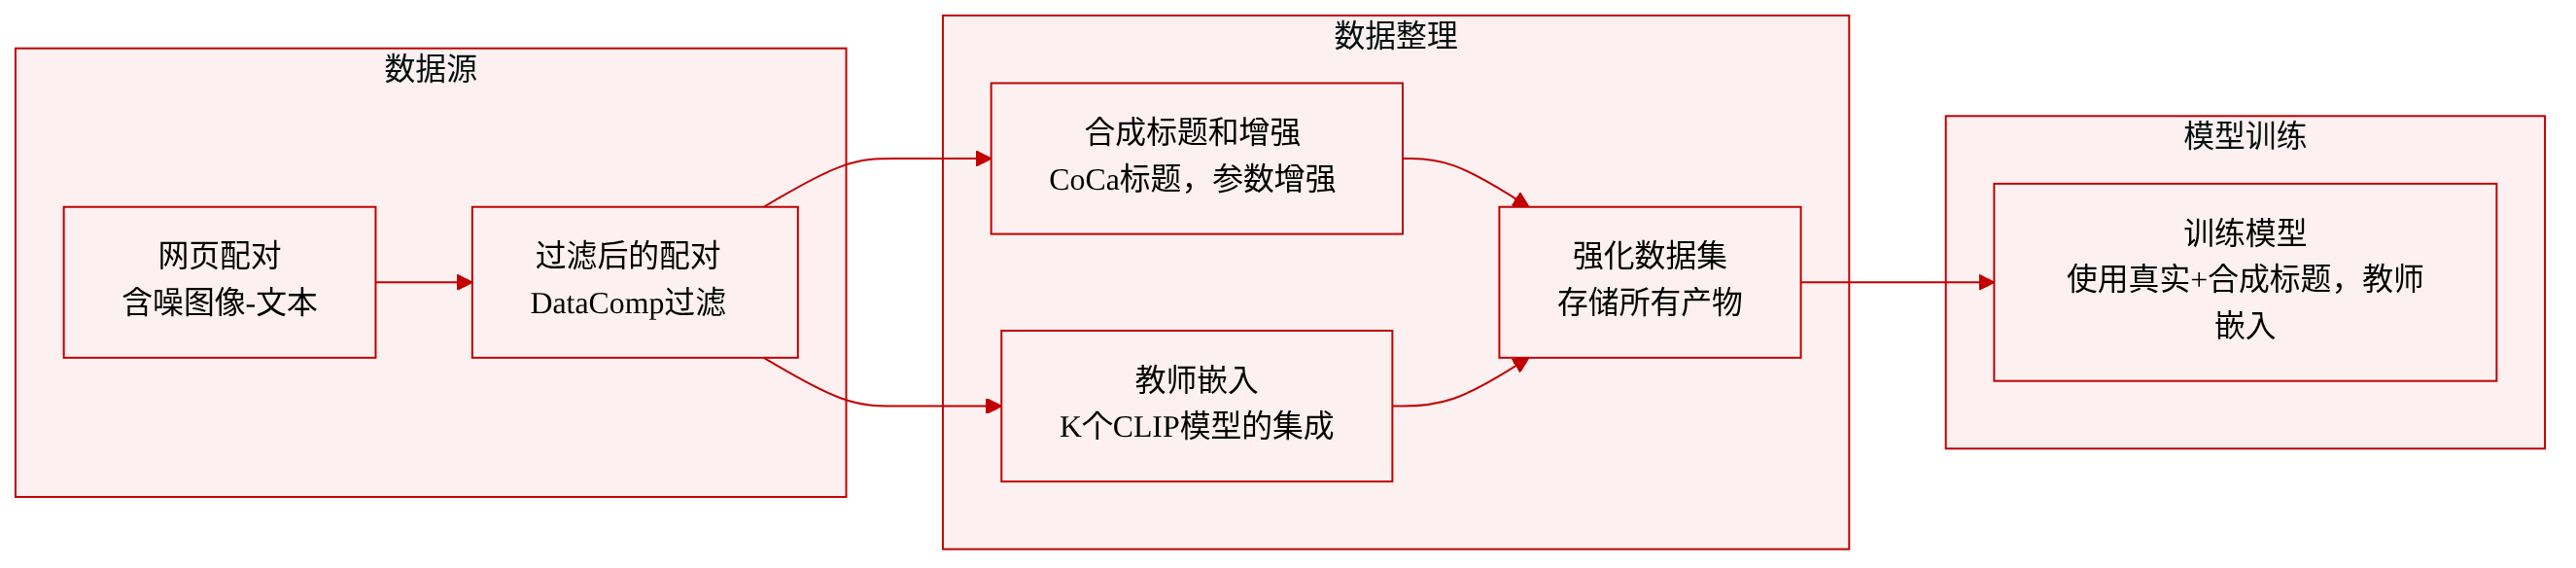
作者引入了一个数据集强化过程,以改善用于 CLIP 风格训练的网络来源图像-文本数据的质量。以下是数据集组成、处理和使用的详细说明。
数据集组成和来源
- 基础数据来自大规模网络来源的图像-文本对,这些数据天生带有噪声。
- 为了减少噪声,作者利用了现有的过滤机制(例如 DataComp 风格的过滤),但注意到过滤后的字幕可能仍然缺乏视觉描述性。
- 强化数据集为每个原始图像-字幕对增加了额外的合成和多模态产物(见下文)。
每个强化组件的关键细节
- 合成字幕:CoCa 模型为每张图像生成多个合成字幕,以提升视觉描述性。论文中报告了生成字幕数量的消融实验。真实字幕更加具体但噪声更大;两者的组合被证明对最佳零样本检索和分类性能至关重要。
- 图像增强:对于每张图像,使用参数化的增强函数创建多个增强版本,并存储参数以保证可复现性。论文中对增强的数量和类型进行了消融实验。
- 集成教师嵌入:K 个 CLIP 模型的集成充当强大的教师。对于每张增强图像和每个合成字幕,作者从所有 K 个教师中计算特征嵌入。他们还为真实字幕计算教师嵌入。
强化数据集模式
- 每个数据集条目存储:原始图像、原始(真实)字幕、增强参数、合成字幕,以及增强图像、合成字幕和真实字幕的教师特征嵌入。
论文如何使用数据
- 数据集强化是一次性的预处理成本,可在多次高效模型训练和实验中摊销。
- 在训练期间,模型消费强化数据集,同时使用真实和合成字幕以及教师嵌入来改善学习。混合比例和每个组件的影响通过消融实验进行评估(例如,合成字幕的数量、增强的数量和种类、教师选择)。
处理说明
- 增强函数是参数化的,参数与数据一起保存,以便每张增强图像可以从原始图像精确重现。
- 教师嵌入使用集成离线计算,确保相同的强化数据集可以在实验中重用而无需重新计算。
方法
作者提出了一个多模态强化训练框架,旨在增强高效图像-文本模型(如 MobileCLIP)的训练,而无需承担在线教师评估的计算开销。核心策略包括一个一次性的数据集强化阶段,在该阶段生成并存储额外的知识,随后是基于蒸馏的训练过程。
数据集强化流程
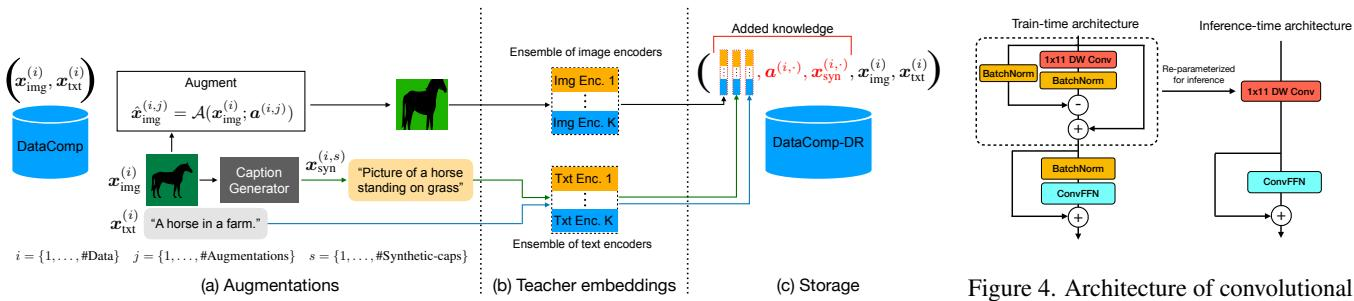
该方法首先用更丰富的信息增强基础图像-文本数据集(例如 DataComp)。对于每张图像,系统使用参数化的增强函数生成多个增强版本。同时,使用强大的图像字幕生成模型(如 CoCa)为每张图像生成多个合成字幕,提供比原始网络爬取字幕更具描述性的视觉细节。
为了从更大的模型中迁移知识,作者利用一组强大的预训练 CLIP 模型作为教师。系统使用该教师集成计算增强图像、合成字幕和真实字幕的特征嵌入。所有这些附加信息(增强参数、合成字幕和教师嵌入)与原始数据一起存储,以创建强化数据集(DataComp-DR)。这确保了生成这些知识的繁重计算只发生一次,从而允许高效的迭代训练。
请参考框架图了解完整流程,该图展示了增强和合成字幕的生成、教师嵌入的计算,以及将此附加知识存储到强化数据集中的过程。
训练过程和损失函数
在训练期间,学生模型利用强化数据集从真实和合成信号中学习。对于每个训练步骤,数据加载器为给定样本随机选择一个增强和一个合成字幕。这允许构建两个不同的训练信号:(增强图像,真实字幕)对和(增强图像,合成字幕)对。
训练目标结合了标准对比损失和知识蒸馏损失。总损失定义为:
LTotal(B)=(1−λ)LCLIP(B)+λLDistill(B)蒸馏损失通过最小化教师嵌入和学生嵌入的相似性矩阵之间的 Kullback-Leibler 散度,使学生的输出与教师集成对齐。由于教师嵌入是预先计算并存储在数据集中的,学生可以通过一次前向传播计算此损失,而无需在训练期间运行教师模型。
模型架构设计
该框架采用了特定的架构选择以确保效率,特别是对于文本编码器。作者引入了一个名为 Text-RepMixer 的混合文本编码器,它将用于 token 混合的 1-D 卷积与自注意力层相结合。
如框架图的架构部分所示,该设计将训练时和推理时的结构解耦。在训练期间,模型使用包含 1x1 深度可分离卷积和 BatchNorm 层的标准模块。对于推理,架构被重新参数化;跳跃连接和 BatchNorm 层被融合到主卷积路径中。这种重新参数化显著降低了延迟,同时保持了自注意力组件提供的表示能力。图像编码器遵循类似的以效率为中心的设计,基于 FastViT 但减小了 MLP 扩展比以提高参数效率。
实验
评估使用 DataComp 基准测试,涵盖零样本分类、检索和 ARO 组合任务,并在 DataComp-12M 上进行消融实验和在 DataComp-1B 上进行大规模训练。关键发现表明,强图像增强、合成字幕和集成教师显著提升了性能,而混合文本编码器提供了有利的速度-准确率权衡。使用 DataCompDR 的强化训练实现了超过 100 倍的数据效率,并持续优于先前方法,包括更大和训练时间更长的模型,同时还改善了 ARO 上的组合理解。
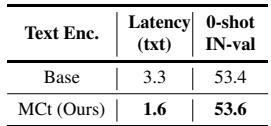
该表比较了基础 Transformer 和所提出的 MCt 混合文本编码器之间的文本编码器延迟和零样本 ImageNet 准确率,显示 MCt 在略微提高准确率的同时大幅降低了延迟。与 FastViT 的图像编码器比较也被提及,但未在提供的表格数据中量化。MCt 文本编码器将延迟从 3.3 毫秒降至 1.6 毫秒,同时将零样本准确率从 53.4% 提高到 53.6%。混合文本编码器设计结合了卷积和自注意力,被证明比纯卷积或基础 Transformer 替代方案更高效。
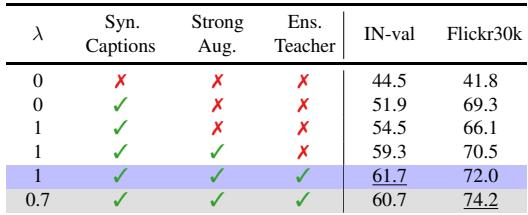
消融研究分别考察了合成字幕、强增强和集成教师对蒸馏 CLIP 模型的影响。添加合成字幕带来了显著的提升,尤其是在检索方面,而强增强和集成教师进一步提升了零样本分类。损失权重 lambda 在分类和检索性能之间提供了一个权衡。在标准 CLIP 训练中使用合成字幕将 ImageNet 准确率提高了 7.4 个百分点,将 Flickr30k 提高了 27.5 个百分点。与蒸馏结合时,强图像增强在 ImageNet 上增加了 4.8 个百分点,在 Flickr30k 上增加了 4.4 个百分点。使用集成教师相对于单个教师在 ImageNet 上贡献了 2.4 个百分点的提升。lambda 为 1.0 时获得最佳 ImageNet 准确率,而 0.7 时获得最高的 Flickr30k 检索分数。
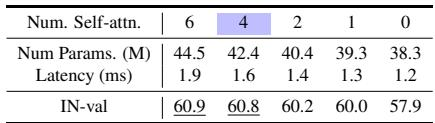
减少模型中的自注意力层数会降低参数数量和推理延迟,但也会降低 ImageNet 验证准确率。完整的 6 层配置在 60.9% 时达到最高准确率,而 0 层变体下降至 57.9%,尽管其体积更小且速度更快。在 DataCompDR 上训练相对于标准设置不引入额外时间开销。移除自注意力层将模型大小从 44.5M 逐步减少到 38.3M 参数,延迟从 1.9 毫秒减少到 1.2 毫秒。随着自注意力层的移除,准确率从 60.9% 平滑下降到 57.9%,表明在效率和性能之间存在权衡。效率提升来自更少的自注意力层,但准确率损失仍然适中,0 层变体仍高于 57%。
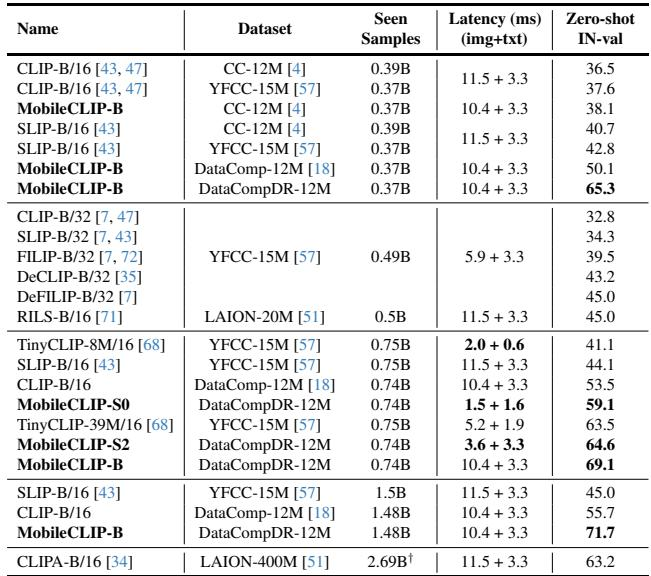
该表在相似的训练预算下比较了各 CLIP 变体的零样本 ImageNet 准确率和延迟。使用混合文本编码器的 MobileCLIP-B 在 DataCompDR-12M 上训练时达到了最高准确率(65.3%),同时保持比标准 CLIP-B/16 更低的文本编码器延迟。使用相同架构但较少策展的数据(DataComp-12M)仅获得 50.1% 的准确率,这表明了数据过滤的重要性。使用混合文本编码器的 MobileCLIP-B 在 DataCompDR-12M 上达到 65.3% 的零样本准确率,优于所有被比较的模型。在 CC-12M 或 YFCC-15M 上训练的标准 CLIP-B/16 仅达到约 36-38% 的准确率,远低于 MobileCLIP-B。MobileCLIP-B 的文本编码器延迟(3.3 毫秒)低于 CLIP-B/16(3.3 毫秒),同时图像延迟也降低了(10.4 对 11.5 毫秒)。
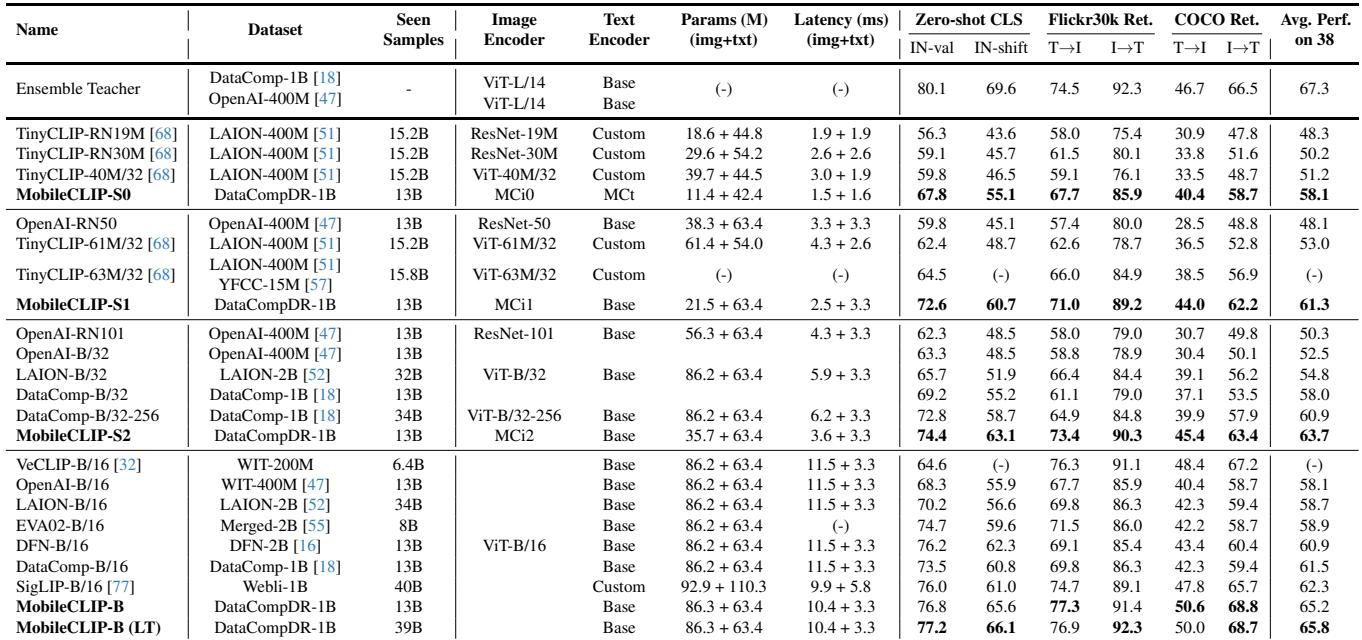
MobileCLIP 系列在不同的延迟组中持续实现最佳的平均性能,优于先前大规模训练的模型(如 TinyCLIP 和基于 ViT 的基线),同时体积更小且速度更快。这些提升在检索任务和 38 数据集平均值上尤为显著,在 DataCompDR-1B 上训练的 MobileCLIP 模型展示了强大的效率和准确率权衡。MobileCLIP-S0 优于 TinyCLIP 变体,同时具有更低的延迟和更少的参数。MobileCLIP-S2 在平均性能和检索方面超越了使用 2.6 倍更长训练计划的 ViT-B/32-256 模型,同时体积更小且速度更快。MobileCLIP-B 在平均性能和检索方面优于 SigLIP-B/16,尽管体积小了 26.3% 且训练数据更少。所有 MobileCLIP 模型都是从零开始训练的,与使用 OpenCLIP 模型高级权重初始化的 TinyCLIP 不同。
在多个实验中,所提出的具有混合文本编码器的 MobileCLIP 架构相对于 Transformer 和卷积基线持续降低延迟,同时保持或提高准确率。消融研究表明,合成字幕、强增强和集成蒸馏各自贡献了有意义的提升,分类和检索之间存在取决于损失权重的权衡。移除自注意力层以适度的准确率成本换取了效率提升,相似训练预算下的比较凸显了数据策展的重要性,因为在过滤数据上训练的 MobileCLIP 优于先前模型,同时体积更小且速度更快。总体而言,MobileCLIP 变体在不同延迟组中展示了强大的效率-准确率权衡,尤其是在检索任务中。