Command Palette
Search for a command to run...
HELPSTEER:用于 STEERLM 的多属性有用性数据集
HELPSTEER:用于 STEERLM 的多属性有用性数据集
HelpSteer 帮助性对齐数据集
摘要
现有的开源有用性偏好数据集并未指明哪些因素使某些回答更有用,而另一些则不那么有用。在这些数据集上训练的模型可能偶然学习到数据集伪影(例如,仅因回答较长而偏好冗长但无用的回答)。为解决此问题,我们收集了 HELPSTEER,一个多属性有用性数据集,对构成回答有用性的各个方面进行了标注。具体而言,我们包含 37k 样本的数据集除了对回答的整体有用性进行标注外,还标注了正确性、连贯性、复杂性和简洁性。使用 HELPSTEER 数据集通过 STEERLM 技术训练 Llama 2 70B 产生的模型在 MT Bench 上得分为 7.54,这是目前无需从更强大模型(如 GPT4)获取训练数据的开放模型所取得的最高得分。我们以 CC-BY-4.0 许可证发布该数据集,网址为 https://huggingface.co/datasets/nvidia/HelpSteer。
一句话总结
NVIDIA研究人员引入了HELPSTEER,这是一个包含37k个样本的多属性有用性数据集,对正确性、连贯性、复杂性和简洁性以及整体有用性进行了标注,以解决现有偏好数据中的伪特征学习问题。通过STEERLM对Llama 2 70B进行训练,在MT Bench上取得了7.54的得分,这是不依赖GPT-4生成训练数据的开放模型中的最高分。该数据集以CC-BY-4.0许可证发布。
核心贡献
- 引入了HELPSTEER,一个包含37,000个样本的多属性有用性数据集,除了整体有用性外,每个响应还针对正确性、连贯性、复杂性和简洁性进行了标注,提供了比现有仅排序数据集更细粒度的偏好信号。
- 使用STEERLM技术在HELPSTEER上训练Llama 2 70B,在MT Bench上取得了7.54的得分,这是不依赖GPT-4等专有模型训练数据的开放模型中最高的。
- 以CC-BY-4.0许可证公开发布该数据集,使社区能够在此基础上构建和复现这项工作。
引言
对齐通用领域语言模型以遵循用户指令通常集中在有用性和安全性这两个目标上,然而有用性本身的概念定义仍然不清晰。近期方法依赖黑盒用户或标注者的偏好来回避这一问题,但该策略在计算和数据上开销大,在智力上也无法令人满意,并且存在教导模型将长度等同于质量的风险。先前定义有用性的尝试使用了创造性和幽默等属性,这些属性仅适用于特定情境,如故事写作,在正式或任务导向的环境中可能会适得其反。领域特定研究表明,有用性的因素因应用而异,例如,摘要任务重视准确性、覆盖范围和连贯性,而长文问答则强调相关性、事实性和完整性。
作者提出,通用领域响应的有用性可以从四个维度进行评估:正确性、连贯性、复杂性和简洁性。正确性涵盖所有相关事实的包含而无错误,连贯性捕捉表达的一致性和清晰度,复杂性反映响应的智力深度,简洁性与细节量相关,而细节量与人类偏好正相关。为验证这一框架,他们创建了HELPSTEER,一个包含37,000个对话的数据集,其中每个响应都针对这四个属性以及整体有用性进行了标注。他们还指出了现有数据源的局限性,指出许多数据集使用GPT-4标注而未进行人工验证,引发了对偏差的担忧,以及OpenAI服务条款下的潜在法律冲突,该条款限制使用输出来开发竞争性模型。
作者使用STEERLM技术在HELPSTEER上训练Llama 2 70B模型,在不依赖强大专有系统训练数据的模型中取得了7.54的MT Bench最高分。由此产生的模型比Llama 2 70B Chat和其他基线更真实、连贯,同时在简洁性和复杂性方面保持用户可操控性。该数据集以CC-BY-4.0许可证公开提供,以支持进一步研究和社区建设。
数据集
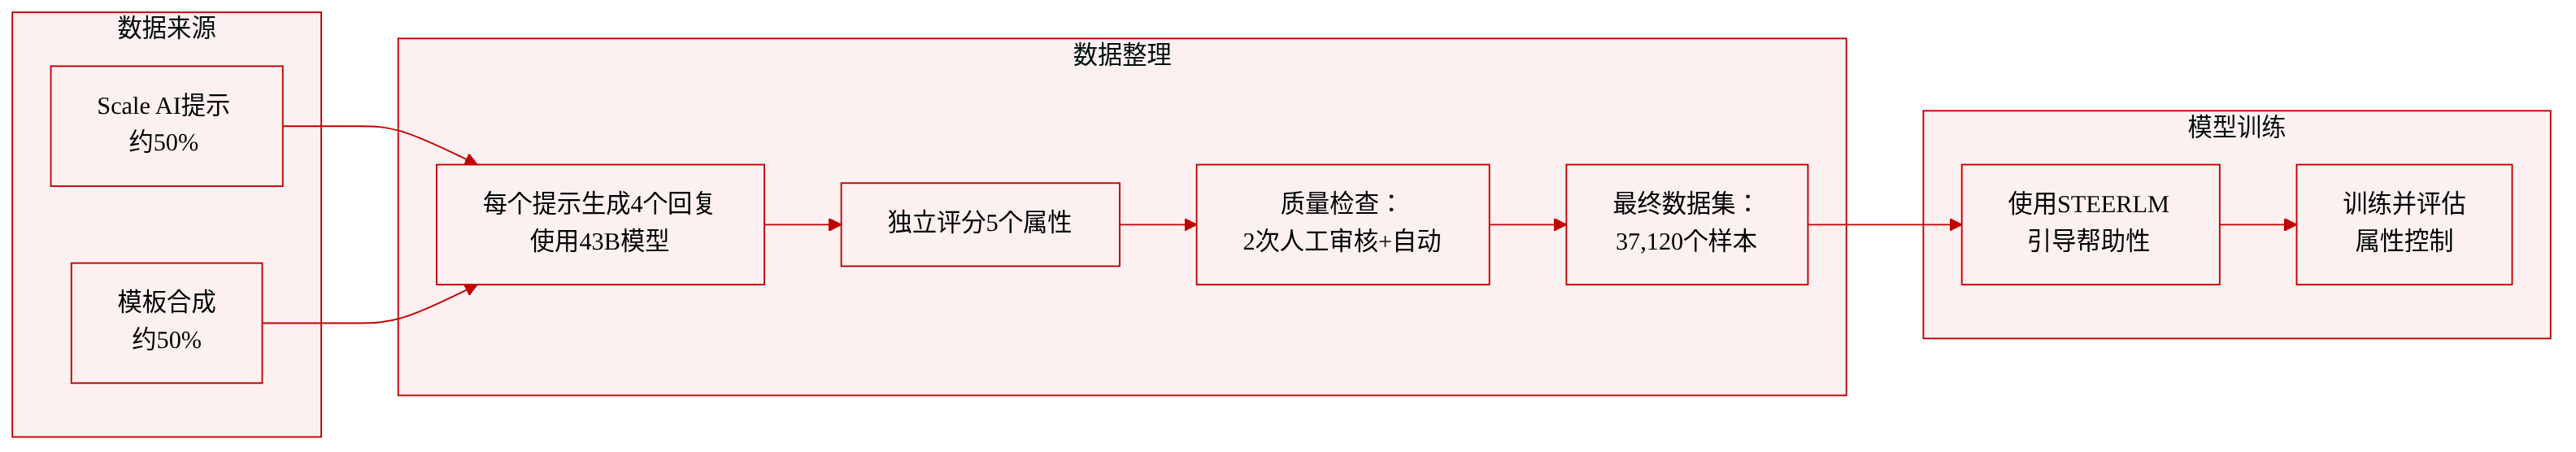
作者引入了HELPSTEER,该数据集旨在解决将STEERLM技术应用于Open Assistant数据集时所遇到的局限性。原始响应表现出事实不准确、不连贯、过于简化或过于冗长等问题,尤其是在涉及参考文本的任务中,包括重写、摘要、分类、提取和封闭式问答。
数据集构成与来源:
- 该数据集包含37,120个高质量标注样本,基于10,459个单轮提示构建。
- 大约一半的提示由外部数据标注供应商Scale AI创建,另一半使用模板合成生成,以多样化提示来源。
- 生成了一个更大的初始提示集,其中约20%因不满意而被过滤掉。
提示分布:
- 类别包括开放式问答、生成和头脑风暴,以及上述五个参考文本任务。
- 每个类别约占提示的10%,剩余20%分配给五个表现欠佳的任务,以提高其代表性。
响应生成:
- 使用内部430亿参数模型为每个提示生成四个不同的响应。
- 生成设置:最大上下文长度4,096个token,温度1.0,top_p 0.80,top_k 1000,重复惩罚1.0,产生多样但合理的输出。
标注过程:
- 每个响应独立评分五个属性:有用性、正确性、连贯性、复杂性和简洁性,采用0到4的Likert-5量表。
- 与比较同一提示下响应的RLHF标注不同,独立评分使标注工作量线性增长而非二次增长。
- 约200名位于美国的标注者通过Scale AI招募,经过英语水平筛选、入门培训课程和涉及35个示例响应的测试后入选。
- 每个标注至少接受两次人工审核,加上自动检查,随后作者进行质量保证过滤。
数据统计与分析:
- HELPSTEER包含37.1k个对话,与Open Assistant的59.4k相当。
- 提示平均长度为2,491.8个字符(标准差1,701.7),显著长于Open Assistant的397.5个字符(标准差620.8),主要由于摘要、重写和提取任务中的参考文本。
- 响应平均为497.3个字符(标准差426.7)。
- 平均属性评分:连贯性3.30,正确性2.84,复杂性1.44,简洁性1.53,有用性2.78(满分4)。
- 正确性和连贯性与有用性强相关(Pearson R > 0.6),而复杂性和简洁性与有用性弱相关(Pearson R > 0.2)。
- 以有用性为因变量的OLS回归显示,四个属性解释了有用性73.0%的方差。
在论文中的使用:
- 该数据集与STEERLM技术结合使用,为有助于有用性的属性获得更好的标注,特别是对于五个参考文本密集型任务,这些任务的表现欠佳。
- 该数据集作为训练和评估资源,用于在有用性相关属性方面引导模型响应。
方法
为解决STEERLM技术应用于Open Assistant数据集时的局限性,作者构建了专用数据集HELPSTEER,旨在捕获响应有用性的细粒度属性。收集流程包括四个阶段:提示收集、响应生成、响应标注和质量保证。
提示收集。 作者收集了10,459个单轮提示,其中约一半由外部标注供应商创建,其余通过模板语法生成。为确保多样性和覆盖面,生成了一个更大的初始提示集,其中约20%的不满意提示被过滤掉。遵循先前的工作,收集范围涵盖开放式问答、生成和头脑风暴任务,以及Open Assistant数据集中代表性不足的五个任务:重写、摘要、分类、提取和封闭式问答。每个类别分配约10%的提示,剩余20%保留给基础STEERLM模型表现较弱的五个任务。
响应生成。 使用内部430亿参数模型为每个提示生成四个不同的响应,最大上下文长度为4,096个token。生成配置使用温度1.0、top_p为0.80、重复惩罚1.0和top_k为1000,产生多样而合理的响应。
响应标注。 每个响应独立评分五个属性:有用性、正确性、连贯性、复杂性和简洁性,采用0到4的Likert-5量表。与RLHF标注不同,RLHF标注比较同一提示下的响应,导致标注工作量相对于每个提示的响应数量呈二次增长,而HELPSTEER对每个响应独立评分。这种设计使标注工作量线性增加。约200名位于美国的标注者通过供应商参与。候选人需先完成初步评估,包括英语水平测试,然后参加入门培训课程,最后标注35个示例响应。标注后,供应商进行质量保证,每个标注至少经过两次人工审核,同时还有自动检查,作者也独立验证结果。经过多阶段过滤,最终数据集包含37,120个高质量标注样本。
STEERLM训练。 作者遵循STEERLM方法训练Llama 2 13B和70B模型,这是一种作为RLHF替代方案的模型对齐方法。STEERLM包含四个关键步骤。首先,训练一个属性预测模型,以预测多个语义属性的得分,这些属性捕获响应有用性的维度,如正确性和连贯性。其次,使用训练好的预测模型对提示-响应对进行这些属性的标注。第三,执行属性条件监督微调(AC-SFT),在标注数据上训练基础模型,以生成受指定属性值约束的响应。第四,通过采样模型获得多样、高质量的响应,自举额外训练数据,可以进一步改进AC-SFT模型。
若干修改简化了原始STEERLM流程。仅使用Open Assistant (OASST)数据集进行AC-SFT训练,而不是多个数据集。OASST的属性标签被缩放到0-4范围,以与HELPSTEER标注一致。对于属性预测模型,结合OASST和HELPSTEER数据集,总共预测九个标签:OASST的质量、幽默、有毒性和创造性标签,加上HELPSTEER的五个标签。排除了对AC-SFT模型进行采样并重新训练自举生成的步骤,因为初步探索显示收益甚微。最后,作者使用回归模型而非基于语言模型的属性预测器,回归模型表现更好。实现方式是从Llama 2基础模型中获取最后一个隐藏状态,并为每个属性添加回归头。
训练超参数。 属性预测和属性条件SFT模型均训练800步,全局批量大小为128(接近2个epoch),恒定学习率5e-6,使用AdamW优化器。推理时,所有属性设置为4,但创造性、幽默和毒性设置为0,除非实验重点是可控性。
实验
实验评估了使用HELPSTEER数据集训练的STEERLM与基线(包括SFT、RLHF、开源数据集上的DPO以及Llama 2 70B Chat)的对比,使用自动指标(MT Bench用于有用性,TruthfulQA用于正确性,困惑度用于连贯性,FKGL用于复杂性,响应长度用于简洁性)以及人类排名和Elo分数。结果表明,STEERLM产生了最有帮助、最正确、最连贯的响应,在自动和人工评估中均优于所有基线,在指令跟随类别的提升尤为显著。消融研究证实,所有五个HELPSTEER属性都有助于有用性,其中正确性尤为关键,同时也表明仅优化有用性可能会降低事实准确性。可控性演示进一步表明,用户在推理时可以有效控制响应的复杂性和简洁性,以适应不同的受众和场景。
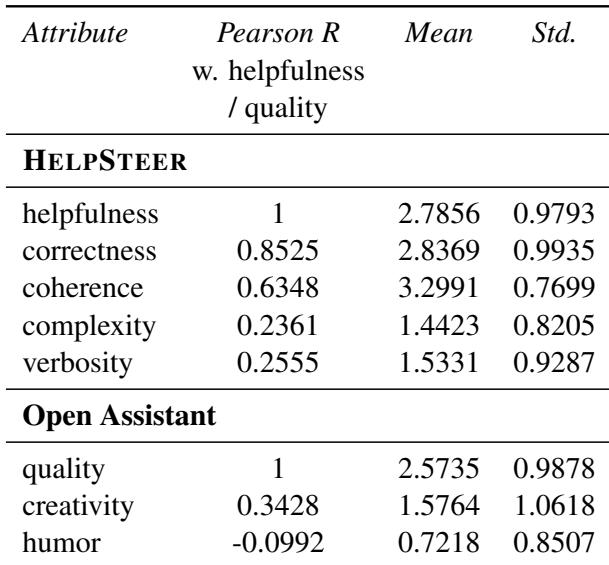
该表格比较了三个开源的有用性偏好数据集,突出了标注属性和数据集规模的差异。HELPSTEER提供多个细粒度属性,Open Assistant包含三个宽泛属性,而HH-RLHF仅提供成对偏好。消融分析表明,HELPSTEER的属性对模型有用性的影响大于Open Assistant的属性,并且结合两个属性集可获得最佳性能。HH-RLHF是最大的数据集,但缺少属性级标签,仅依赖于偏好和被拒绝的响应对。HELPSTEER对话较少,但包含详细属性,如正确性、连贯性、复杂性和简洁性。消融结果显示,从HELPSTEER中移除正确性或有用性会降低有用性,其中正确性对事实性至关重要。HELPSTEER属性对有用性的贡献大于Open Assistant属性,而同时使用两个属性集会得到最有帮助的模型。
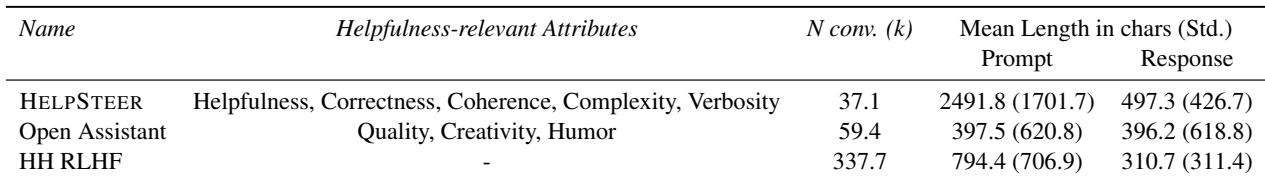
该表格报告了两个数据集中有用性相关属性的描述性统计和相关性,表明正确性和连贯性与有用性强相关,而复杂性和简洁性关联较弱。HELPSTEER响应往往连贯且适度正确,但复杂性和简洁性较低,这些属性共同解释了有用性中的大部分方差。正确性和连贯性与有用性呈现强正相关,而复杂性和简洁性仅呈现弱相关。HELPSTEER响应具有较高的平均连贯性、适度的正确性以及较低的复杂性和简洁性,共同产生中等有用的响应。根据回归分析,四个属性合计解释了有用性73%的方差。Open Assistant的创造性和幽默等属性与质量的相关性较弱或为负,表明它们对有用性并非必需。
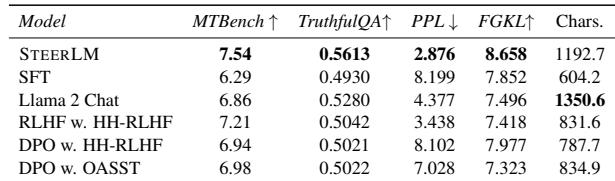
STEERLM在自动指标上优于基线模型,取得了最高的MT Bench得分,同时比强大的RLHF基线需要更少的计算。与开源训练模型和Llama 2 Chat相比,其响应更有帮助、更正确、更连贯且简洁性适当。结果表明,基于正确性、连贯性、复杂性和简洁性等多个属性进行条件约束能够提高响应质量。STEERLM在MT Bench上取得了最高的有用性得分,超过了所有基线,包括在开源数据集上使用RLHF或DPO训练的基线。与最佳RLHF基线相比,STEERLM获得了更高的MT Bench得分,同时仅使用一小部分计算量,而类似计算量的替代模型则落后更多。STEERLM产生的响应更真实、更连贯(困惑度更低),且细节适当,在简洁的开源训练模型和更冗长的Llama 2 Chat之间取得了平衡。与开源训练模型和Llama 2 Chat相比,STEERLM在编码、数学、推理、提取和角色扮演等指令密集型类别中表现出显著提升。
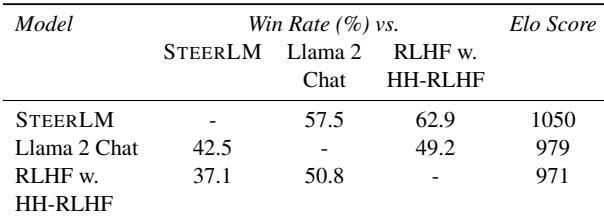
在人类成对评估中,STEERLM模型在针对Llama 2 Chat和RLHF基线的对抗中均取得了最高的Elo得分和胜率。尽管需要的计算量更少,它仍胜过这些模型,并在直接比较中因其有用性和正确性而受到青睐。STEERLM获得了1050的最高Elo评级,对Llama 2 Chat的胜率为57.5%,对RLHF基线的胜率为62.9%。Llama 2 Chat得分较低,对STEERLM的胜率为42.5%,Elo为979,而RLHF基线以971落后。评估表明,STEERLM产生的响应比两种替代方案更有帮助、更正确,尽管其中一个基线需要的计算量大约是其五倍。
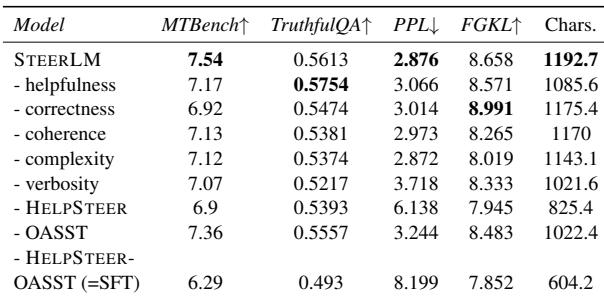
在训练过程中移除任何五个HELPSTEER属性都会降低MT Bench,表明每个属性都对有用性有贡献。针对有用性和正确性的消融表明,仅优化有用性可能会降低事实正确性,而移除正确性训练会显著损害整体有用性。一起使用所有属性可获得最佳MT Bench,优于单独使用任一属性集或普通SFT模型训练的模型。移除任何HELPSTEER属性都会降低MT Bench,证实每个属性都有助于提高有用性。丢弃有用性会增加TruthfulQA MC2,表明明确优化有用性可能以正确性为代价。移除正确性会导致MT Bench下降最大,并提高响应复杂性(FKGL),表明事实训练对有用性和清晰度都很重要。移除完整的HELPSTEER属性集比移除Open Assistant属性集降低MT Bench更多,表明HELPSTEER属性对有用性的贡献更大。同时使用两个属性集可获得最高的MT Bench,而单独任一集合仍优于普通SFT模型。
在各项实验中,作者将HELPSTEER数据集和STEERLM模型与Open Assistant、HH-RLHF以及RLHF训练系统等基线进行了比较。细粒度的HELPSTEER属性,尤其是正确性和连贯性,被证明比宽泛的Open Assistant属性对有用性更具影响力,这些因素解释了73%的有用性方差。STEERLM在MT Bench和Elo得分上取得最高分,同时使用的计算量显著减少,在人类成对评估和指令密集型任务中均超过基线。消融研究证实,每个HELPSTEER属性都有助于有用性,其中正确性至关重要,尽管明确优化有用性可能会略微降低事实准确性。