Command Palette
Search for a command to run...
KITAB:评估大语言模型在信息检索中的约束满足能力
KITAB:评估大语言模型在信息检索中的约束满足能力
Marah I Abdin Suriya Gunasekar Varun Chandrasekaran Jerry Li Mert Yuksekgonul Rahee Ghosh Peshawaria Ranjita Naik Besmira Nushi
KITAB 约束信息检索数据集
摘要
我们研究了最先进的模型回答信息检索中的约束满足查询(例如,“圣地亚哥的冰淇淋店列表”)的能力。过去,这类查询被认为只能通过网络搜索或知识库来解决。近来,大语言模型(LLM)在此任务中展现出了初步的涌现能力。然而,许多当前的检索基准要么已经饱和,要么未衡量约束满足能力。鉴于对LLM事实错误和幻觉的日益关注,我们提出了KITAB,一个新的数据集,用于衡量语言模型的约束满足能力。KITAB包含来自600多位作者和13,000个查询的书籍相关数据,并提供了一种相关的动态数据收集和约束验证方法,以便为其他作者获取类似的测试数据。我们对GPT4和GPT3.5的扩展实验,在不同维度上(如信息流行度、约束类型和上下文可用性)刻画并解耦了常见的失败模式。结果表明,在没有上下文的情况下,模型表现出严重的局限性,如无关信息、事实错误和不完整性,随着信息流行度的降低,许多问题会加剧。虽然上下文的可用性减少了无关信息,但对于满足约束并无帮助,揭示了约束满足的基本障碍。我们开源了我们的贡献,以促进未来模型在约束满足能力方面的进一步研究。
一句话总结
微软研究院、伊利诺伊大学厄巴纳-香槟分校和斯坦福大学的研究人员提出了 KITAB,一个包含超过 600 位作者的 13,000 条书籍相关查询的数据集,用于评估大语言模型在信息检索中的约束满足能力。研究显示,上下文的可用性可以缓解不相关信息的问题,但无法解决根本性障碍,GPT4 和 GPT3.5 表现出严重的局限性(包括事实错误和不完整性),且随着信息流行度的降低而加剧。
核心贡献
-
本文引入了 KITAB,一个用于衡量语言模型约束满足能力的新数据集,包含跨越 600 多位作者的 13,000 条书籍相关查询,以及一种动态数据收集和约束验证方法,可生成覆盖其他作者的可比较测试数据。
-
该数据集支持对期望较长列表输出的查询中的约束类型和复杂度进行控制,并包含约束程度和信息流行度等元数据,以支持对模型行为的细粒度分析。
-
在 GPT4 和 GPT3.5 上的扩展实验对信息流行度、约束类型和上下文可用性维度上的失败模式进行了表征和解耦,发现上下文的可用性减少了不相关信息但未能提升约束满足度,揭示了即使在提供完整相关上下文的情况下仍然存在的根本性障碍。
引言
大语言模型(LLM)现已为对话式搜索引擎提供支持,但由于基准饱和、训练数据污染以及开放端输出评估的挑战,评估其事实准确性仍然困难。作者研究了大语言模型中的约束满足问题,其中查询规定了输出必须满足的条件,例如“{作者}在{年份}之后发表的论文列表”。这一视角概括了关键词搜索、布尔搜索和分面搜索,并且对于用户需要精确的结构化信息而非创造性文本的场景至关重要。以往的基准侧重于具有单一答案的简单单约束查询,且已基本饱和,模型中如何处理生成较长输出的多约束查询仍是未解问题。
作者引入了 KITAB,一个文学领域的查询数据集,固定作者约束的同时变化词汇、时间和命名实体约束。他们在四种受控条件下评估了 GPT4 和 GPT3.5:基线检索某作者的全部书籍、仅凭参数化知识回答查询、提供完整上下文后回答查询,以及模型先自行构建上下文再回答的自构上下文设置。研究发现,即便是最先进的模型,在仅依赖参数化知识时,也有 12% 至 41% 的情况会编造不相关的书籍,且对不太知名的作者错误率更高。提供完整上下文可以减少不相关性,但无法解决约束满足失败的问题,而自检索提示会加剧幻觉,因为模型为了满足约束而编造书名。GPT4 相较 GPT3.5 有所改进,但差距有限,且各条件下完全匹配准确率均低于 35%。KITAB 还包含对不重叠作者列表的动态数据收集和清洗流程,有助于应对基准泄漏和饱和问题,支持独立测试。
数据集
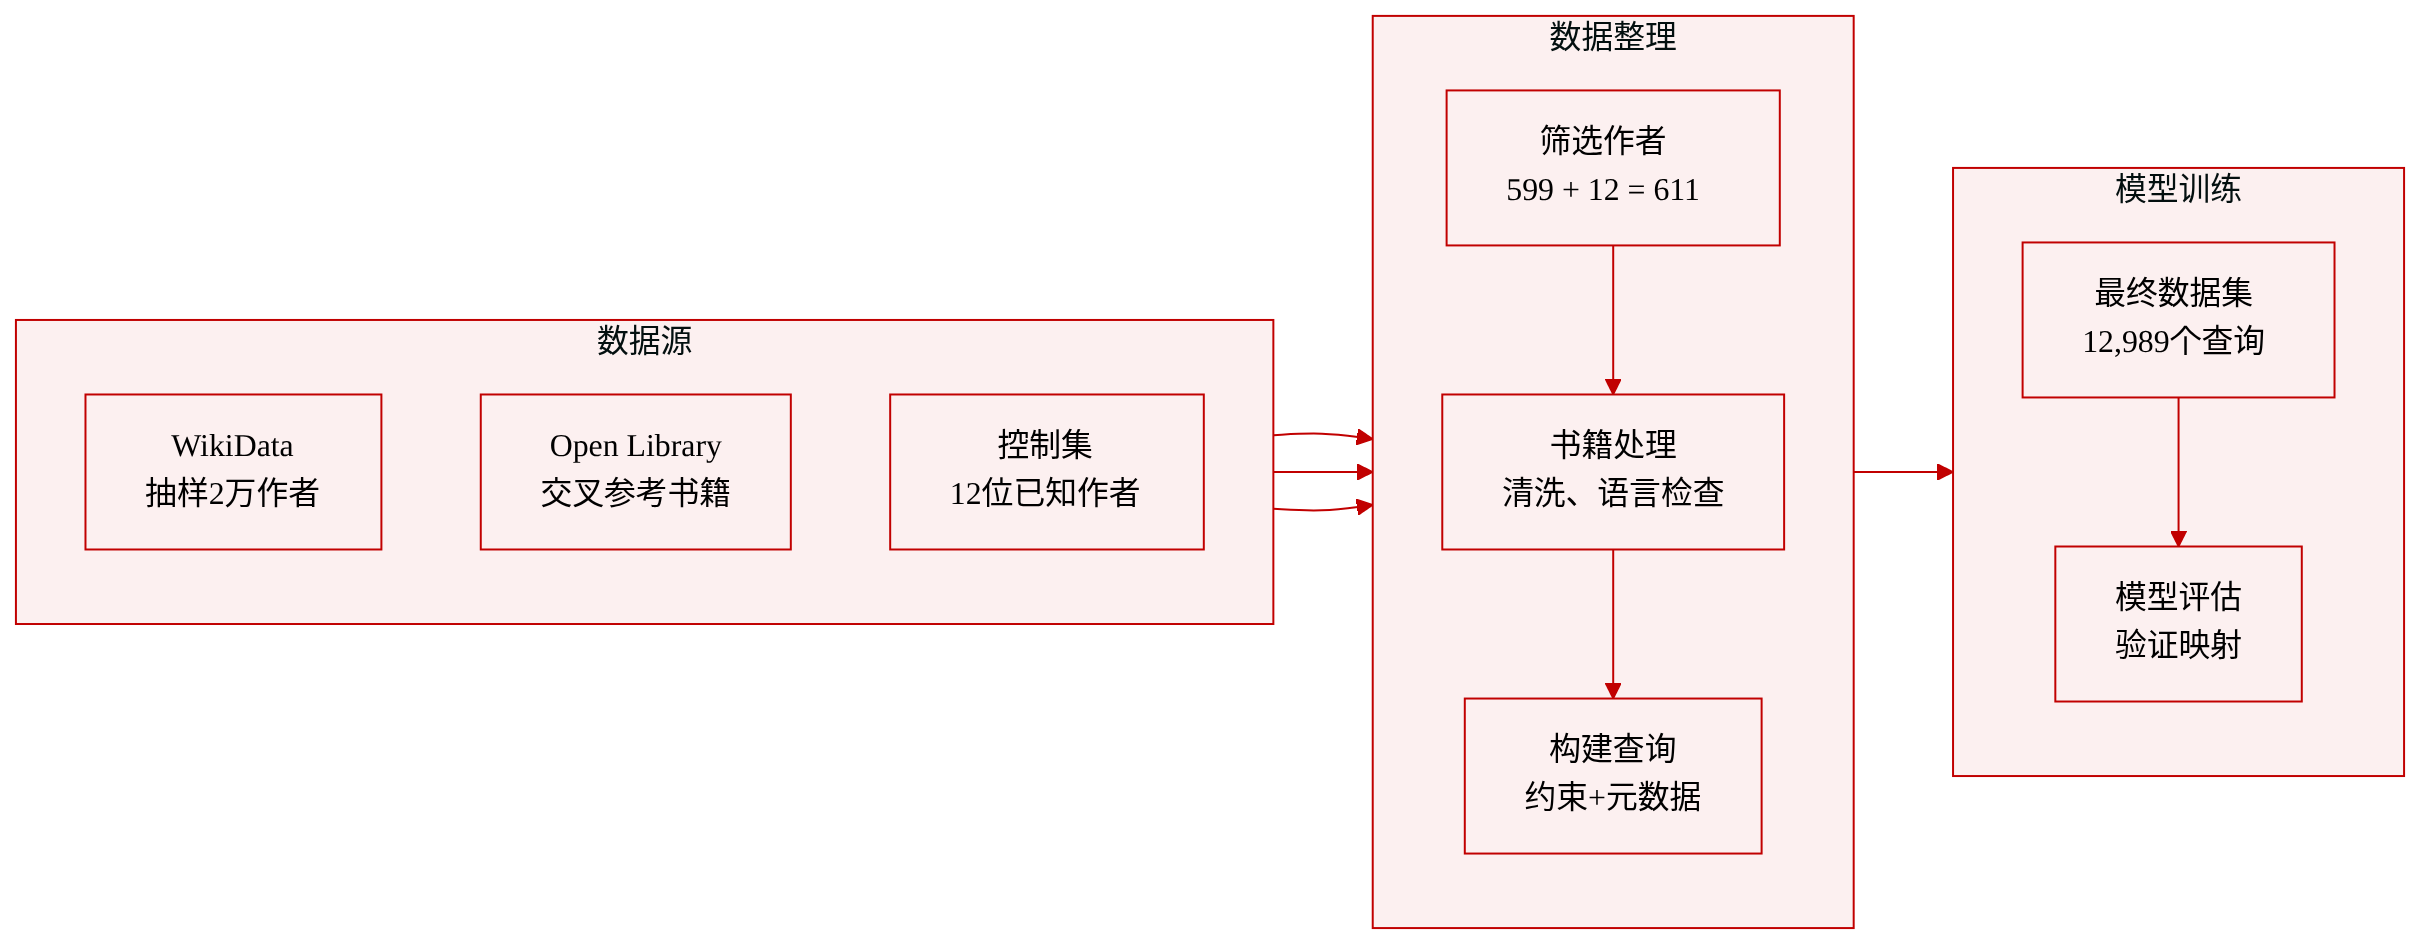
引入 KITAB:约束满足的新基准
作者引入了 KITAB,一个旨在评估大语言模型(LLM)在文学领域中约束满足能力的新数据集。该数据集提供了一个包含 12,989 条查询的框架,每条查询都配有一组 LLM 在生成书名时必须满足的约束。
1. 数据集构成与来源 数据集构建是一个多阶段过程,首先从 WikiData 进行作者采样,然后与 Open Library 存储库进行交叉验证。
- 作者采样: 作者从 WikiData 中采样了 20,000 位作者,然后筛选掉 1850 年以前出生、作品少于 10 部或多于 300 部的作者,最终保留了 1,505 位。
- 最终作者集合: 将这些作者与 Open Library 进行交叉验证,只保留在其中拥有至少五部作品的作者,由此得到 599 位作者。另外增加了 12 位来自五大洲的人工挑选知名作者作为对照集用于质量检查,最终作者总数达到 611 位。
- 流行度代理指标: 作者使用 WikiData 中每位作者的站点链接数作为信息流行度的代理指标,这一因素已知会影响事实错误的产生。
2. 书籍收集与处理 对于每位作者,作者收集了 Open Library 中标记为英语或语言字段为空的全部书籍。使用 Azure Cognitive Services 的额外语言检测检查确保了仅保留最早的英文版本。清洗过程包括:
- 去重 以及跨 Open Library 和 WikiData 的作者身份和出版年份交叉核验。
- 书名变体: 保留同一书名的不同变体(例如“Gödel, Escher, Bach”与“Gödel, Escher, Bach: An Eternal Golden Braid”),以方便评估。
- 质量检查: 人工标注显示,GPT4 查询中不到 5% 和 GPT3.5 查询中不到 6% 可能受缺失书名的影响,对模型比较的影响较小。
3. 书籍元数据与约束构建 为便于验证,KITAB 包含了每本书的丰富元数据:
- 提供的元数据: 出版年份以及书名中的人名或城市名列表。
- 实体识别: 使用 Azure Cognitive Services 和 GPT4 共同检测人名以实现文化互补性,同时使用 Azure Cognitive Services 和 Geonames 数据库检测城市名。
所有查询都遵循固定形式:第一个约束始终是作者,后面是可变的各类约束:
- 词汇约束: 书名以某个字母开头/结尾,或具有特定字数。
- 时间约束: 在特定年份之间出版。
- 命名实体约束: 书名中存在或不存在某个城市名或人名。
- 子采样: 对查询进行子采样以确保约束类型的均衡表示和不同的约束程度。
4. 数据集统计与使用 最终数据集包含 8,239 条单约束查询和 4,750 条双约束查询。
- 双重约束: 所有约束均可单独满足,仅 0.76% 联合不可满足。不匹配任何书名的不可满足约束占查询的 7.99%。
- 使用方式: KITAB 用于离线模型评估。它提供了验证函数和所有满足 12,989 条查询中每条查询的书籍的完整映射,从而可以直接评估 LLM 生成的输出。此工作流设计可适用于电影、餐厅或研究论文等其他领域。
方法
作者提出了一个综合框架,围绕 KITAB 数据集的构建和一组特定实验条件,评估大语言模型(LLM)在受约束查询上的表现。主要目标是剖析模型在约束满足方面的性能,并识别信息检索任务中的瓶颈。
数据收集与数据集构建
该方法始于严格的数据收集流水线,以确保数据质量和多样性。作者从 WikiData 中采样作者,应用严格过滤器排除异常值和不准确的数据:排除 1850 年以前出生的作者,仅保留拥有 10 到 300 部关联作品的作者。然后将这些候选作者与 Open Library 存储库进行交叉验证,确保有足够数量的英文出版物(至少五部作品)。该过程最终得到 611 位作者的精选样本。
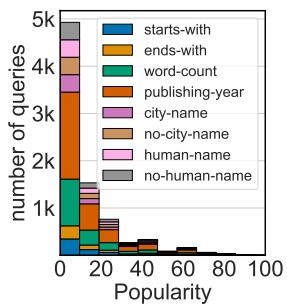
这些作者的分布呈现不同程度的流行度,以 WikiData 中的站点链接数来衡量。如上图所示,数据集覆盖了广泛的流行度层级,查询分布在“以...开头”、“以...结尾”、“字数”以及时间或命名实体约束等不同约束类型中。这种多样性允许分析模型性能与内容流行度和约束程度之间的相关性。
在作者选择之后,系统从 Open Library 收集书籍元数据。流水线包括使用 Azure Cognitive Services 进行语言检测以筛选英文版本、去重,以及与 WikiData 交叉核验作者身份和出版年份。为便于约束验证,数据集包含提取的元数据,如出版年份和通过 Azure Cognitive Services 与 Geonames 识别出的命名实体(人名和城市名)。
约束与查询生成
查询通过将固定作者约束与可变的书籍约束相结合来生成。约束分为三类:
- 词汇约束: 书名以特定字母开头或结尾,或具有特定字数。
- 时间约束: 在特定年份范围内出版。
- 命名实体约束: 书名中存在或不存在城市名或人名。
数据集包含 8,239 条具有单一书籍约束的查询和 4,750 条具有两个书籍约束的查询。生成过程确保约束类型的均衡表示以及可满足和不可满足查询的混合(约 8% 不可满足)。
实验条件
为回答研究问题,作者使用特定提示模板设计了五种不同的实验条件。这些条件隔离了模型能力的不同方面:
- ALL-BOOKS(模板 1): 要求模型列出作者的全部书籍。这作为检索性能的上限,独立于约束满足。
- NO-CONTEXT(模板 2a): 模型必须仅使用其参数化知识来满足约束,不提供外部上下文。
- WITH-CONTEXT(模板 2b): 该条件模拟检索增强生成(RAG)设置。模型获得该作者的完整书籍列表作为上下文,并要求基于约束进行筛选。这隔离了模型在拥有完整信息时验证约束的能力。
- SELF-CONTEXT(模板 3): 一种链式思考方法,模型首先检索书籍列表,然后将约束应用于该自生成列表。
- SINGLE-ITEM(模板 4): 模型对单个书名评估约束,以将单条目验证与列表处理分离。
该实验设计允许对失败发生的位置进行细粒度分析,无论是检索环节、约束理解环节,还是两者结合环节。
实验
实验在 KITAB 数据集上评估了 GPT-4 和 GPT-3.5,使用了包括无上下文、自构上下文、检索上下文和单条目在内的提示变体,以隔离书籍约束验证中的失败。即使在宽松的模糊匹配指标下,两个模型的表现均不佳,GPT-4 在所有条件下的完全正确率均低于 35%;链式思考有帮助但不够充分,提供完整上下文可以减少无关输出但不会提高约束满足度或完整性。性能因约束类型而异,以“结尾”约束比“开头”约束更难,而否定约束相对容易;虽然作者流行度在超过低阈值后能显著减少不相关信息,但并未带来正确性的提升,这表明仅靠扩展规模和检索并不能解决约束验证问题。
GPT4 和 GPT3.5 在所有提示条件下均表现出高比例的不相关信息和较差的约束满足度。提供完整上下文可以减少不相关信息,但并未显著改善约束满足度或完全正确率,后者整体仍然很低。两个模型表现相似,GPT4 略有领先但远未达到可靠水平。提供上下文后不相关信息率大幅下降,但约束满足度仍然较低。所有条件下的完全正确率都极低,尽管 WITH-CONTEXT 显示出明显改善。GPT4 仅略微优于 GPT3.5,表明仅靠扩展规模并不能解决约束满足问题。
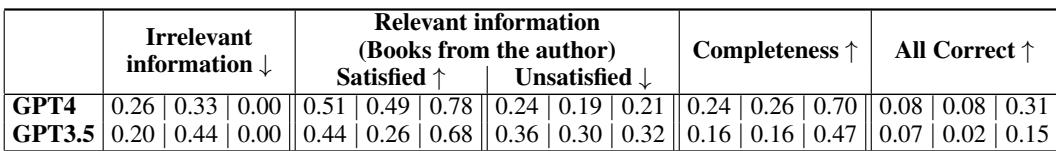
该表比较了单书和双书查询中的约束类型,显示了约束程度如何随类型和查询复杂度而变化。这些模式用于检验模型在受约束事实检索任务中的表现。以“开头”和“结尾”约束比字数或无姓名约束更受约束。双书查询通常比单书查询的约束程度更高,但城市名约束除外,后者反而下降。虽然较高的约束程度通常降低性能,但“结尾”和城市名约束表现出相反的趨勢。
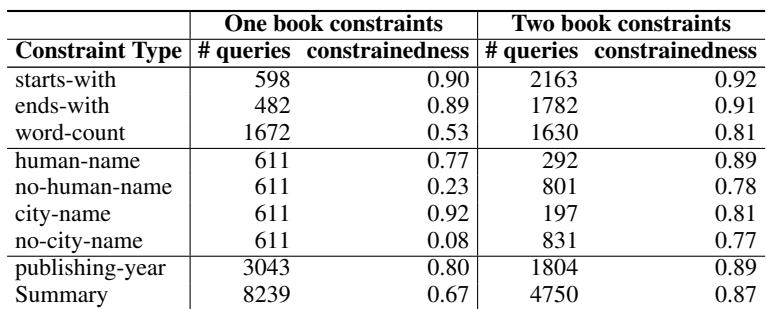
GPT4 在 KITAB 基准上的整体表现不佳,不同约束类型之间存在显著差异。“结尾”查询比“开头”查询困难得多,而否定和实体约束相对容易。添加上下文减少了不相关的书籍提及,但并未改善约束满足度或完整性,而自生成的链式思考实际上增加了无关输出。“结尾”约束对模型来说比“开头”困难得多,这可能是由于需要向前规划。提供上下文几乎消除了不相关的书籍,但满足度和完整性仍然较低。更高的流行度减少了不相关信息,但在满足度、完整性或完全正确率方面未显示明显益处。
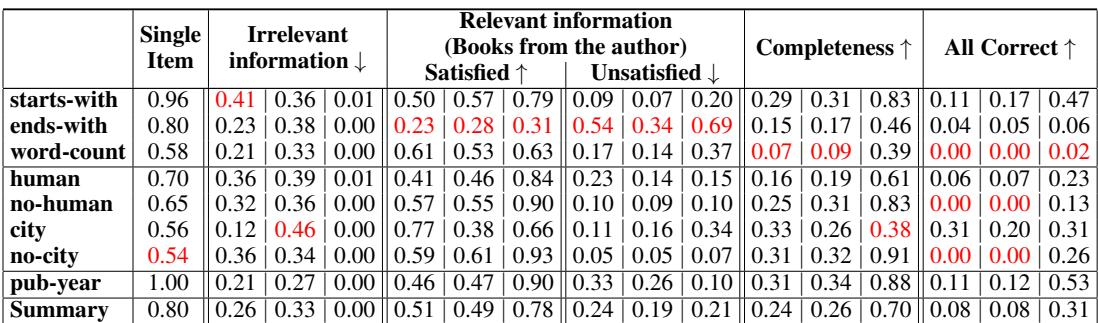
在全部实验中,提供完整上下文持续减少了不相关信息,但未显著改善约束满足度或整体正确性,后者对 GPT-3.5 和 GPT-4 而言仍然很低。约束类型和查询复杂度影响性能,“结尾”约束比“开头”约束困难得多,而否定和实体约束相对容易。添加上下文几乎消除了不相关的书籍提及,但满足度和完整性基本保持不变,而自生成的链式思考甚至增加了无关输出。更高的流行度减少了不相关信息,但满足度或正确性没有明显提升,这表明仅靠扩展规模和上下文不足以解决受约束事实检索的挑战。