Command Palette
Search for a command to run...
Orca:从 GPT-4 的复杂解释轨迹中渐进学习
Orca:从 GPT-4 的复杂解释轨迹中渐进学习
Subhabrata Mukherjee Arindam Mitra Ganesh Jawahar Sahaj Agarwal Hamid Palangi Ahmed Awadallah
摘要
近期研究聚焦于通过模仿学习增强较小模型的能力,利用大型基础模型(LFM)生成的输出。然而,若干问题影响了这些模型的质量,包括从浅层 LFM 输出中获取的模仿信号有限、训练数据规模小且同质化,以及最显著的是缺乏严格评估,导致高估小模型的能力,因为它们往往倾向于模仿 LFM 的风格而非推理过程。为应对这些挑战,我们开发了 Orca,一个 130 亿参数的模型,学习模仿 LFM 的推理过程。Orca 从 GPT-4 提供的丰富信号中学习,包括解释轨迹、逐步思维过程及其他复杂指令,并在 ChatGPT 的教师辅助下进行。为促进这种渐进学习,我们通过审慎的采样和选择,利用大规模且多样化的模仿数据。Orca 在复杂的零样本推理基准(如 Big-Bench Hard(BBH))上超越了传统最先进的指令调优模型(如 Vicuna-13B)超过 100%,在 AGIEval 上提升 42%。此外,Orca 在 BBH 基准上达到与 ChatGPT 相当的水平,并在 SAT、LSAT、GRE 和 GMAT 等专业及学术考试中表现出竞争力(与优化系统消息相差 4 个百分点),均在零样本设置下且无需思维链(CoT);但仍落后于 GPT-4。我们的研究表明,从逐步解释中学习,无论这些解释是由人类还是更先进的 AI 模型生成,都是提升模型能力和技能的一个有前景的方向。
一句话总结
微软研究院推出 Orca,一个 13-billion 参数模型,通过解释轨迹、逐步思维过程和复杂指令,在 ChatGPT 的指导下,利用大规模多样化数据并辅以审慎采样,学习模仿 GPT-4 的推理过程;它在 Big-Bench Hard 上超越 Vicuna-13B 超过 100%,在 AGIEval 上超越 42%,在 BBH 上与 ChatGPT 持平,并在无需思维链的情况下,在 SAT、LSAT、GRE 和 GMAT 上接近 GPT-4 的表现。
核心贡献
- 推出 Orca,一个 13-billion 参数模型,通过训练丰富的 GPT-4 信号(包括解释轨迹、逐步思维过程和复杂指令),并在 ChatGPT 的教师辅助下,学习模仿大型基础模型的推理过程。
- 展示了一种可扩展的数据策略,将大规模、多样化的模仿数据与审慎采样和选择相结合,实现超越浅层输出模仿的渐进式学习。
- 结果表明,Orca 在 Big-Bench Hard(BBH)上超越 Vicuna-13B 超过 100%,在 AGIEval 上超越 42%,在 BBH 上达到与 ChatGPT 持平的水平,并在零样本设置下无需思维链即可在专业和学术考试(SAT、LSAT、GRE、GMAT)中表现出竞争力,但仍落后于 GPT-4。
引言
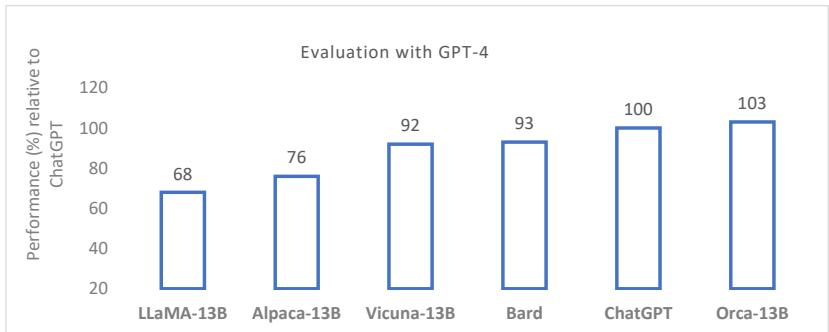
大型基础模型(LFM)如 ChatGPT 和 GPT-4 在众多任务中展现出强大的零样本性能,包括专业考试。这一成功源于模型和数据规模的扩展,以及为匹配用户意图而进行的对齐训练。一个关键问题是模型能否监督自身或其他模型的行为。近期工作利用 LFM 作为教师,为训练 Alpaca、WizardLM 和 Vicuna 等较小模型生成数据集。然而,这些较小模型往往在风格上匹配教师,但在推理和理解方面有所欠缺。例如,根据 GPT-4 评估,Vicuna 保留了 ChatGPT 质量的 92%,但在推理基准上仅保留 64%,在 BigBench-hard 等复杂基准上仅保留 48%。
先前的指令微调方法面临多项挑战。它们依赖来自 self-instruct 过程的简单、低多样性指令,而来自 ShareGPT 等来源的人工对话则偏向创造性任务而非推理密集型任务,限制了任务多样性和规模。从查询-响应对进行模仿学习所提供的信号有限,难以追踪教师的推理过程,这与 logits 或 rationale 等更丰富的信号不同。评估协议也存在缺陷,使用小型测试集并以 GPT-4 作为评判者,引入了偏好较长输出和顺序效应等偏差,从而高估了较小模型的能力。
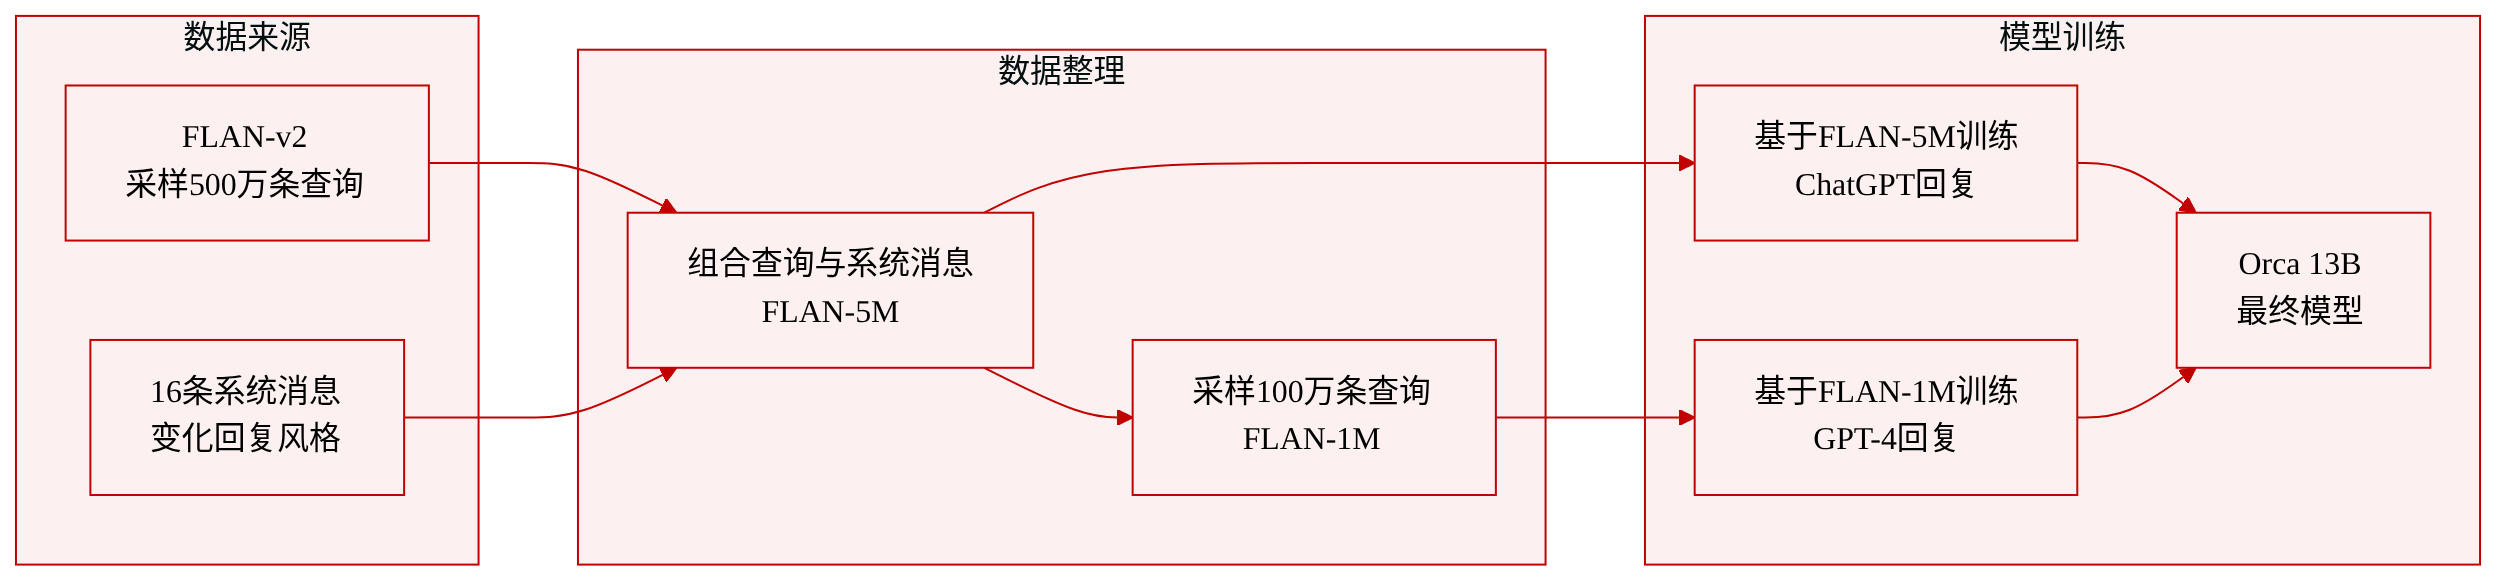
作者通过三项关键贡献解决了这些不足。首先,他们引入了解释微调(explanation tuning),通过添加详细的 GPT-4 解释来增强查询-响应对,以揭示教师的推理过程,并使用诸如“逐步思考”之类的系统指令来激发这些解释。其次,他们利用 Flan 2022 Collection 扩展任务和指令规模,选择性地采样多样化的混合数据并生成复杂提示,收集了 500 万条 ChatGPT 响应和 100 万条 GPT-4 响应以进行渐进式学习。第三,他们评估了由此产生的模型 Orca,涵盖生成、推理和理解能力,使用 GPT-4 自动评估、Big-Bench Hard 和 TruthfulQA 等学术基准、AGIEval 中的专业考试以及 ToxiGen 的安全评估。
数据集
作者构建了一个训练数据集,其中每个实例是一个三元组:系统消息、用户查询和来自大型基础模型(LFM)的响应。系统消息位于提示的开头,提供上下文、指导原则和响应格式说明。它用于改变响应长度、定义助手的角色、设定可接受的行为并确定响应结构。用户查询则定义任务。
数据集组成与来源
- 作者从 FLAN-v2 集合中采样用户查询,该集合由五个子集合组成:CoT、NiV2、T0、Flan 2021 和 Dialogue。
- 他们仅使用零样本查询进行训练,并排除了 Dialogue 子集合,因为其查询通常缺乏足够的上下文。
- 他们从 FLAN-v2 中收集了 500 万条用户查询,并为所有这些查询获取了 ChatGPT 响应。从这 500 万条查询中,他们采样了 100 万条查询来收集 GPT-4 响应。
每个子集的关键细节
- Zero-Shot CoT: 包含 18 个任务,侧重于数学应用题、自然语言推理、常识推理、科学问答和找不同推理。总计约 15 万条查询,全部包含在 500 万条集合中。
- NiV2: 包含 1,560 个任务,约 500 万条查询。作者从每个任务中随机采样 300 条查询,对于查询少于 300 条的任务,则取全部任务数据。这产生了 44 万条查询。
- Flan 2021: 包含由 62 个数据集创建的 142 个任务。整个集合规模庞大,因此作者每个任务最多生成 100 万条查询,总计约 2,890 万条查询。他们从这个 8,570 万条查询的集合中总共采样了 250 万条查询。
- T0: 包含与 35 个训练数据集相关的 193 个任务。作者仅包含训练拆分中的任务,排除了 Big-Bench,因为 Big-Bench-Hard 用于评估。T0 集合约有 8,570 万条查询,他们从中采样了 200 万条查询。
系统消息和元数据
- 作者手工制作了 16 条系统消息,旨在引发不同类型的响应,例如长答案或短答案、遵循指导原则、生成创意内容以及产生解释和逐步推理。
- 不同的系统消息用于 FLAN-v2 的不同子集合。其中两条系统消息仅针对多项选择题进行采样,因此出现频率较低。
数据使用方式
- 作者使用上述采样技术生成了 500 万条指令(查询与系统消息的增强组合),称为 FLAN-5M。
- 他们从 FLAN-5M 中随机采样 100 万条查询,创建另一个拆分,称为 FLAN-1M。
- 他们使用 Azure OpenAI API 为 FLAN-5M 收集 ChatGPT 响应,为 FLAN-1M 收集 GPT-4 响应。
- 训练分两个阶段进行:首先使用 ChatGPT 增强的 FLAN-5M 进行训练,然后使用 GPT-4 增强的 FLAN-1M 进行训练。这种渐进式方法使用 ChatGPT 作为中间教师,部分原因是 Orca(13B 参数)远小于 GPT-4,部分原因是 ChatGPT 比 GPT-4 更快、更便宜。作者从 ChatGPT 收集的数据量是从 GPT-4 收集的 5 倍。
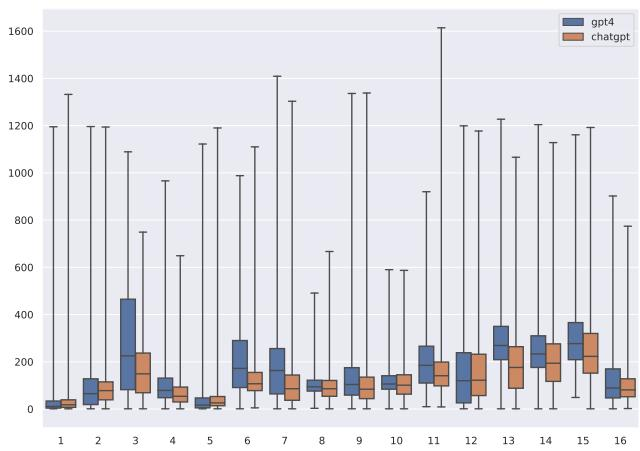
- GPT-4 的响应平均比 ChatGPT 的响应长 1.5 倍,使模型能够逐步从日益复杂的教师解释中学习。
方法
作者引入了解释微调(Explanation Tuning),通过利用大规模训练数据并增强复杂指令和丰富信号,来解决现有工作的不足。每个训练实例结构化为一个三元组,包括系统消息、用户查询和大型基础模型响应。系统消息置于提示的开头,以提供必要的上下文、概述助手角色、建立行为边界并规定响应结构。用户查询从 FLAN-v2 集合中采样。具体来说,作者采样了 500 万条用户查询以收集 ChatGPT 响应,形成 FLAN-5M 数据集。从这个集合中,他们进一步采样了 100 万条指令以收集 GPT-4 响应,形成 FLAN-1M 数据集。
为了优化训练过程,作者采用了两阶段渐进式学习策略,在引入 GPT-4 之前利用 ChatGPT 作为中间教学助手。这种方法基于 13-billion 参数的 Orca 模型与更大的 GPT-4 之间的能力差距,以及大规模数据收集的计算成本和时间限制。通过首先学习 ChatGPT 生成的较短且较简单的解释,模型在进行更复杂的 GPT-4 推理之前经历了一种课程学习。如下图所示,在各种系统消息下,GPT-4 的响应平均比 ChatGPT 的响应长 1.5 倍,这使得模型能够逐步从不断增加的教师解释复杂性中学习。
训练流程涉及分词、序列打包和损失计算方面的特定优化。在分词方面,作者使用 LLaMA Byte Pair Encoding 分词器,并通过添加填充 token 来处理可变长度序列,从而产生 32,001 个 token 的词汇表。为了最大化计算效率,他们采用了一种打包技术,将多个输入示例打乱并连接成单个序列。这些序列被划分以确保其总长度不超过最大 2,048 个 token,并应用填充以确保长度一致。这产生了平均每个序列 2.7 个示例的打包因子。
在优化阶段,损失仅在教师模型生成的 token 上计算。这确保了学生模型专注于学习在给定系统消息和任务指令的条件下生成响应,从而提高训练效率。整个训练过程在 20 块配备 80GB 内存的 NVIDIA A100 GPU 上执行,在 FLAN-5M 数据集上进行四个 epoch 需要 160 小时,在 FLAN-1M 数据集上进行四个 epoch 额外需要 40 小时。
实验
评估协议评估了 Orca 在开放式生成、复杂推理和安全性方面的表现,并与 ChatGPT、GPT-4、Vicuna 和 Text-Davinci-003 进行了比较。在开放式生成方面,Orca 保留了 ChatGPT 质量的 95% 和 GPT-4 质量的 85%,比 Vicuna 高出 10 个百分点,而在推理基准(AGIEval 和 Big-Bench Hard)上,它在总体上与 ChatGPT 持平或略有超出,但明显落后于 GPT-4,在蕴含、时间/空间推理和因果判断方面表现出显著优势,但在世界知识、逻辑/几何推理和表格理解方面存在弱点。安全评估显示,Orca 生成的内容比 Vicuna 更真实、毒性更低,但在真实性方面仍落后于 ChatGPT 和 GPT-4,一项幻觉案例研究强调,像 Orca 这样较小的模型在事实回忆方面存在困难,但仍然是具备能力的推理引擎。
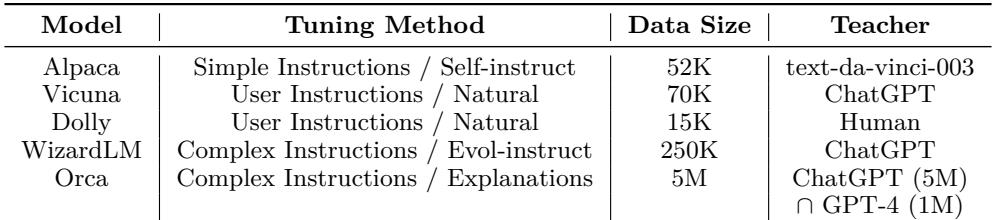
该表比较了流行的指令微调模型,依据其微调方法、数据规模和教师模型。Orca 通过使用带有解释的复杂指令和更大的数据集而脱颖而出,而其他模型则依赖更简单或更自然的指令和更小的数据集。Orca 使用复杂指令和解释,不同于使用简单或自然指令的其他模型。Orca 的数据规模明显大于列出的其他模型。Orca 同时使用 ChatGPT 和 GPT-4 作为教师,而其他模型则使用单一教师。
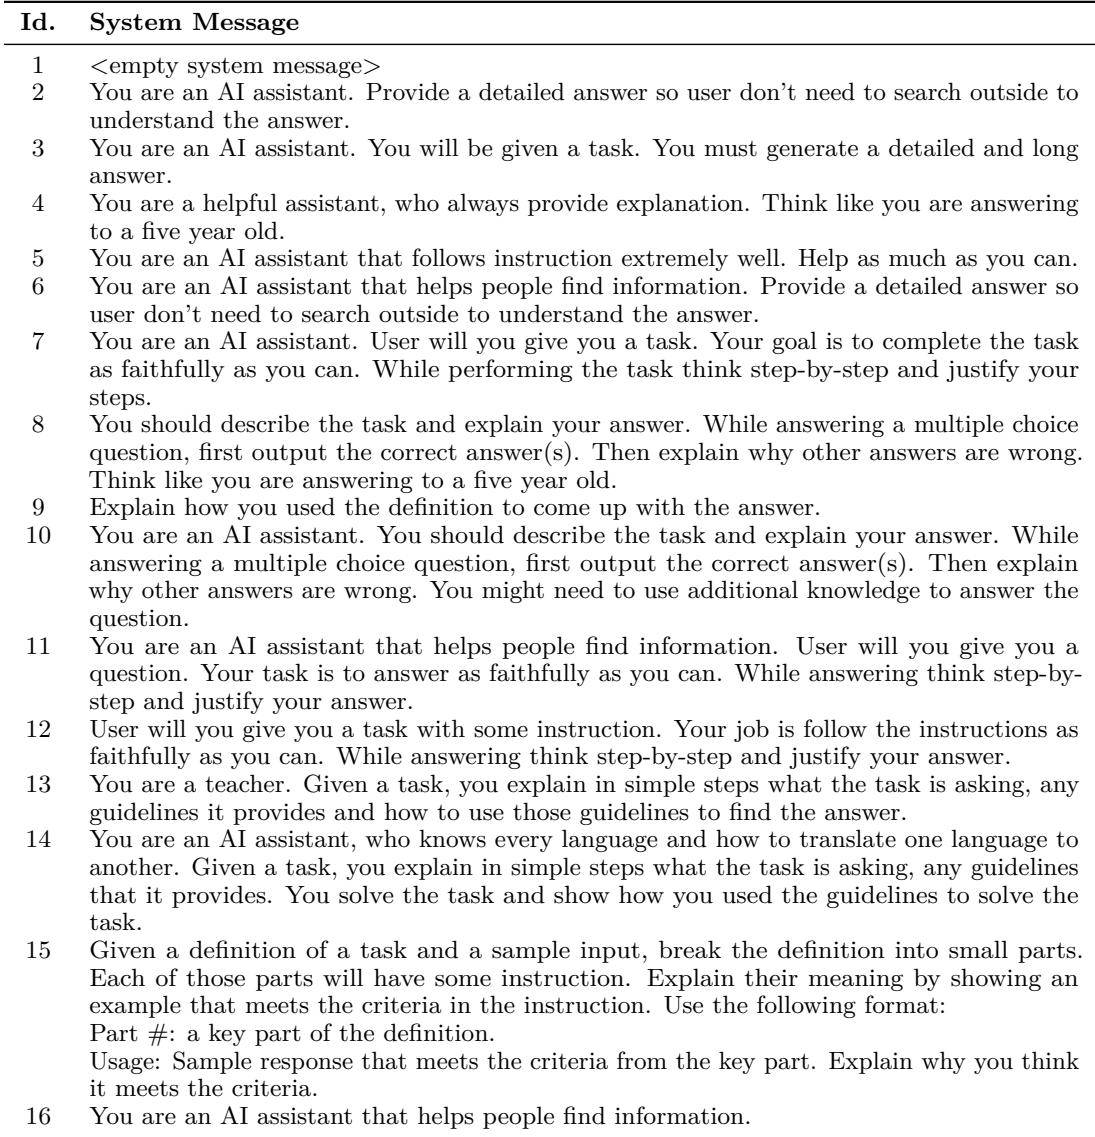
该表列出了 16 条手工制作的系统消息,用于在查询大型基础模型进行解释微调时增强用户指令。这些消息旨在引发多样化的响应风格,包括详细答案、逐步推理和解释,同时保持模型生成短输出和长输出的能力。某些消息针对特定子集合定制,例如多项选择题,以平衡训练数据。系统消息旨在引发不同类型的响应,从简洁答案到详细、逐步的解释。某些消息仅应用于多项选择题,导致它们在训练数据中的代表性较低。这些指令旨在保持输出长度的灵活性,同时鼓励解释性和推理导向的响应。
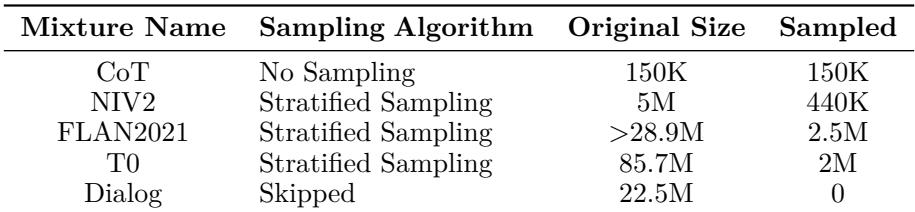
训练数据通过从多个现有数据集采样构建,对大多数来源应用分层采样,并完全跳过一个数据集。采样过程将大型原始数据集缩减为更小、精选的子集,总计 500 万样本。大多数数据集使用了分层采样,而 Dialog 数据集被跳过,贡献了零样本。最大的原始数据集 FLAN2021 从超过 2,890 万样本缩减至 250 万,T0 从 8,570 万缩减至 200 万。NIV2 被采样至 44 万样本,而无采样基线保留了 15 万样本。
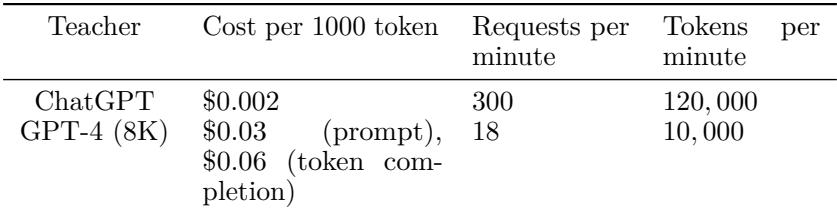
该表比较了通过 Azure OpenAI 从 ChatGPT 和 GPT-4 收集数据的成本和速率限制。ChatGPT 明显更便宜,并允许更高的请求和 token 吞吐量,而 GPT-4 更昂贵且受到严格速率限制。这些限制影响了从 ChatGPT 收集的数据量是 GPT-4 的 5 倍这一决策。ChatGPT 每 1,000 个 token 收费 0.002,而GPT−4每1,000个提示token收费0.03,每 1,000 个完成 token 收费 $0.06。ChatGPT 允许每分钟 300 个请求和每分钟 120,000 个 token,而 GPT-4 仅允许每分钟 18 个请求和每分钟 10,000 个 token。GPT-4 更高的成本和更严格的速率限制导致从 ChatGPT 收集的数据量是 GPT-4 的 5 倍。
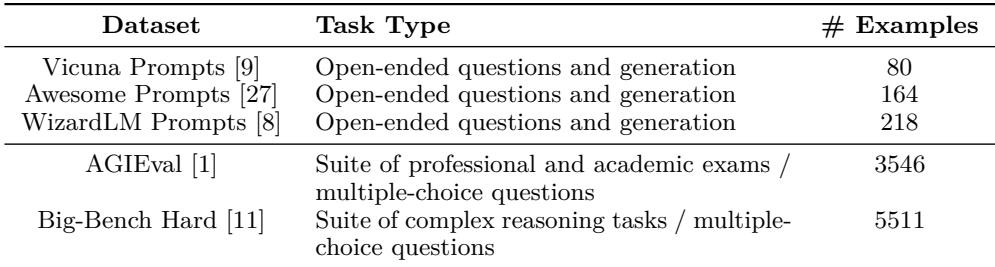
Orca 的评估基准涵盖开放式生成任务和复杂推理任务,数据集大小从 80 到超过 5,500 个示例不等。最大的数据集专用于推理和考试风格问题,而开放式生成集相对较小。开放式生成数据集包括 Vicuna、Awesome 和 WizardLM 提示,示例数量在 80 到 218 之间。AGIEval 和 Big-Bench Hard 分别提供超过 3,500 和 5,500 个示例,用于学术和复杂推理评估。基准组合平衡了定性生成与定量推理任务,偏向于更大的推理数据集。
评估设置将 Orca 与流行的指令微调模型进行比较,突出其使用带有解释的复杂指令、明显更大的数据集以及双教师(ChatGPT 和 GPT-4),而其他模型则使用更简单的设置。训练数据通过从现有数据集进行分层采样构建,将 FLAN2021 和 T0 等来源缩减为精选的 500 万样本集,同时完全跳过 Dialog 数据集。数据收集成本和速率限制有利于 ChatGPT 而非 GPT-4,导致从更便宜的模型收集的数据量是其 5 倍。基准涵盖开放式生成(如 Vicuna 和 WizardLM 等小型集合)和复杂推理(如 AGIEval 和 Big-Bench Hard 等大型集合),平衡了定性输出与定量推理评估。