Command Palette
Search for a command to run...
FLAIR:用于联邦学习的带标注图像数据集
FLAIR:用于联邦学习的带标注图像数据集
Congzheng Song Filip Granqvist Kunal Talwar
FLAIR: 联邦学习标注图像数据集
摘要
跨设备联邦学习是一种新兴的机器学习(ML)范式,其中大量设备共同训练一个 ML 模型,而数据保留在设备上。这一研究领域面临一系列独特的实际挑战,为了系统地取得进展,需要针对该范式定制的新数据集。现有的图像领域联邦学习基准未能准确捕捉许多真实应用场景的规模和异质性。我们提出了 FLAIR,一个适用于联邦学习的、具有挑战性的大规模多标签分类图像数据集。FLAIR 包含来自 51,414 名 Flickr 用户的 429,078 张图像,并捕捉了联邦学习中通常遇到的许多复杂情况,例如异质性用户数据和长尾标签分布。我们针对该数据集在不同学习设置下实现了多个基线,以支持不同任务。我们相信 FLAIR 可以作为推动联邦学习最新技术发展的高挑战性基准。数据集访问和基准代码可在 https://github.com/apple/ ml-flair 获取。
一句话总结
苹果公司的研究人员引入了 FLAIR,这是一个大规模带注释的图像数据集,包含来自 51,414 位 Flickr 用户的 429,078 张图像,用于跨设备联邦学习中的多标签分类。该数据集捕捉了异构用户数据和长尾标签分布,为推进这一范式的最新进展提供了具有挑战性的基准。
核心贡献
- 这项工作引入了 FLAIR,这是一个用于联邦学习中多标签分类的大规模带注释图像数据集,包含来自 51,414 位 Flickr 用户的 429,078 张图像,反映了诸如异构用户数据和长尾标签分布等现实世界的复杂性。
- 论文提供了跨集中式、联邦式和差分隐私学习设置的可复现基线,使得在该基准上能够在不同隐私约束下对方法进行标准化评估。
- 数据集和基准代码已在项目仓库中公开发布,为研究社区提供了一个具有挑战性且易于获取的资源,以推动联邦学习研究。
引言
远程设备产生了大量数据,这些数据可以改善设备上的机器学习,但隐私、带宽和存储限制使得集中式数据收集不可行。联邦学习通过在保持数据位于用户设备上的同时协作训练模型来解决这一问题,并且当与差分隐私结合时,它提供了强大的形式化保证。然而,该领域的进展受到缺乏现实、大规模基准数据集的阻碍:当前的图像基准要么依赖于对经典数据集(如 MNIST 或 CIFAR)的人工划分,这可能无法反映现实世界的非独立同分布(non-IID)分布,要么使用现实的用户划分但规模有限,例如仅有 1,262 位用户的 Landmarks 数据集。为了填补这一空白,作者引入了 FLAIR,这是一个大规模多标签图像分类数据集,包含来自 51,414 位真实 Flickr 用户的 429,078 张图像,具有粗粒度和细粒度两级标签层次。FLAIR 自然地表现出常见的联邦学习挑战,包括用户贡献不均衡、特征偏斜和标签分布偏斜,并且作者提供了集中式、联邦式和差分隐私设置下的可复现基准,以及随机初始化和预训练初始化下的基准。
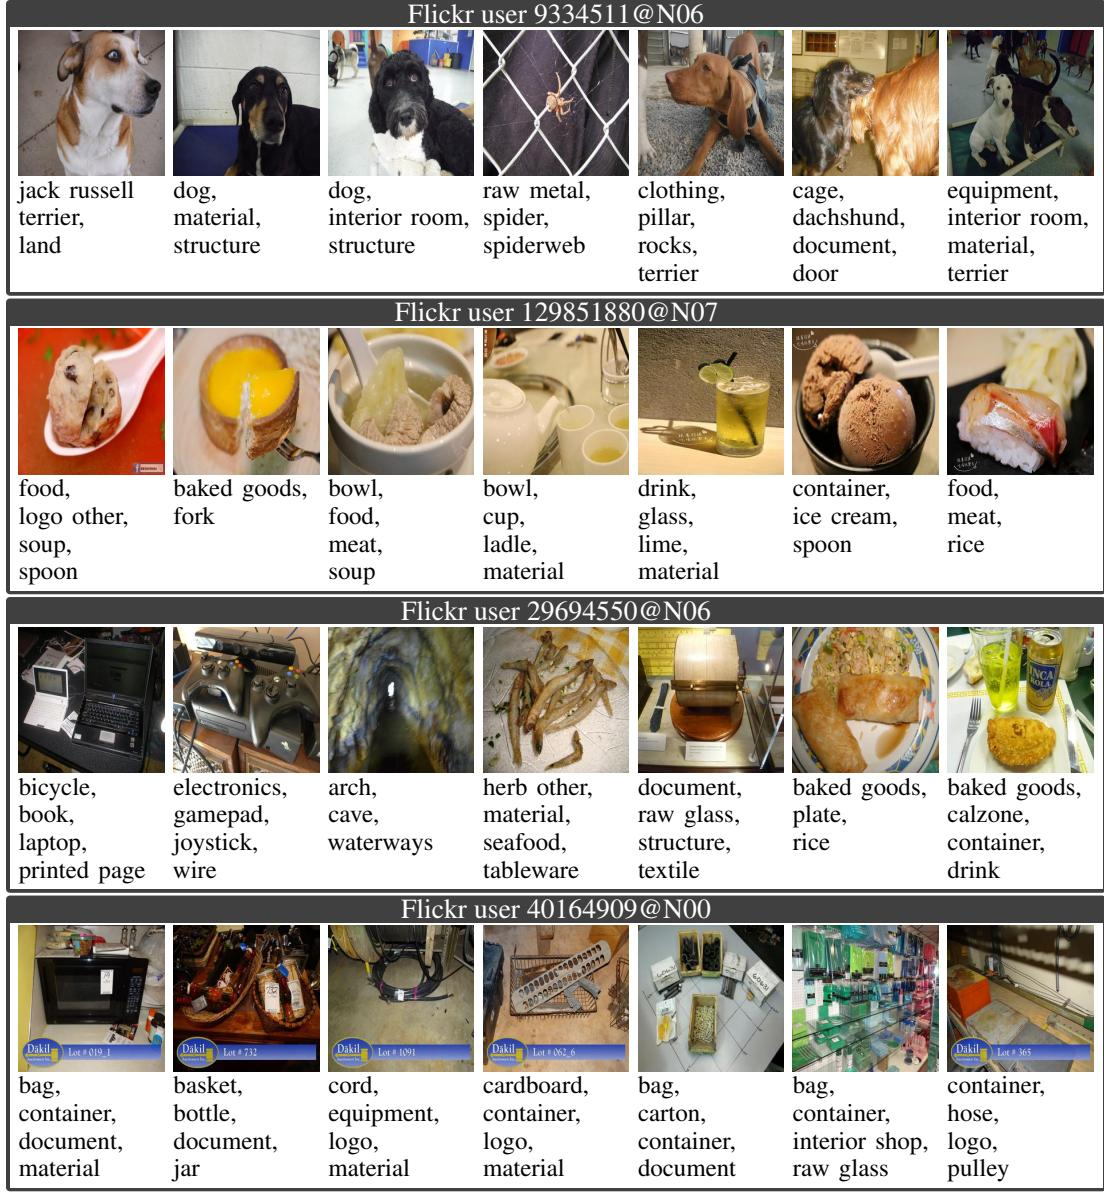
数据集
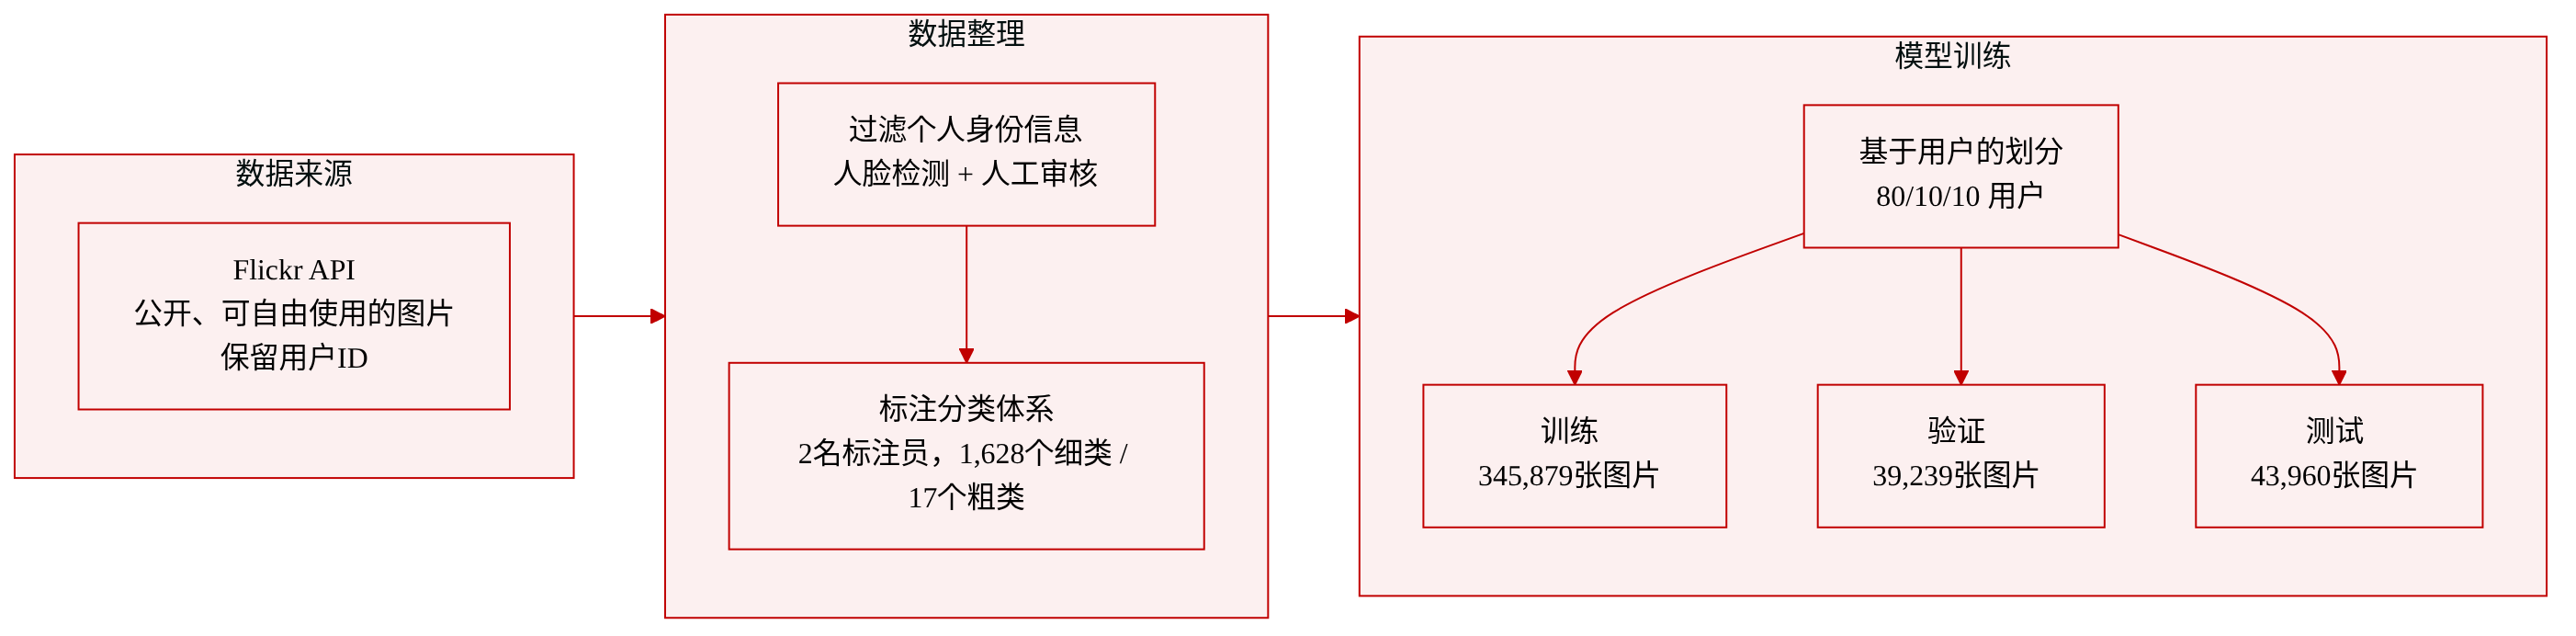
作者构建了 FLAIR 数据集用于联邦图像分类研究。以下是其组成、处理和使用方式的总结。
来源与构成
- 图像通过 Flickr API 策划,保留原始 Flickr 用户 ID,以便来自同一用户的所有图像自然分组在一起。
- 仅包含公开共享且具有允许许可的图像。
过滤与标注
- 两阶段过滤过程可移除个人身份信息(PII)。首先,人脸检测模型自动移除包含人脸的图像。然后,人工标注者审查剩余图像,采用双标注者设置,其中第一位标记 PII,第二位验证结果。
- 最初未标记的图像使用包含 1,628 个细粒度类别的分类体系进行标注。该分类体系还定义了 17 个粗粒度类别,每个细粒度类别映射到一个粗粒度类别。
- 标注也使用每张图像两名标注者,一名负责标记,一名负责验证。如果对象不明确且无法分配细粒度标签,则改用粗粒度标签。
规模与统计
- 最终数据集包含来自 51,414 位 Flickr 用户的 429,078 张图像,具有 17 个粗粒度和 1,628 个细粒度标签。
- 每个用户的图像数量严重偏斜。最大的 2.3% 用户合计持有的图像数量与底部的 97.7% 用户合计持有的图像数量相同,这使得 FLAIR 在联邦图像基准中具有第二大的数量偏斜,仅次于 iNaturalist-User-120k。
- 特征分布偏斜使用每个用户平均像素直方图与总体平均像素直方图之间的推土机距离进行衡量,并在最常见的标签(结构类)上计算以消除类别不平衡的影响。与模拟的非独立同分布划分相比,自然的非独立同分布划分增加了偏斜。
- 标签也不平衡。最常见的粗粒度类别“结构”出现 228,923 次,存在于 87% 的用户中。最不常见的“宗教”在 1.4% 的用户中出现了 866 次。在细粒度标签中,1,628 个类别中的 1,255 个出现在少于 0.1% 的用户中。
数据集划分与使用
- 作者提供了基于 Flickr 用户 ID 的固定训练、验证和测试划分,使得任何用户不会出现在多个分区中。
- 该划分将 80% 的用户分配给训练集,10% 给验证集,10% 给测试集。这产生了 345,879 张训练图像、39,239 张验证图像和 43,960 张测试图像。
- 保留的用户分组和自然偏斜旨在反映现实的联邦学习条件,其中每个用户的本地数据分布与全局分布不同。
方法
作者考虑了一种联邦学习设置,其中中央服务器协调分布式用户群体上的模型训练,同时将每个用户的数据保留在其自己的设备上。在每轮通信中,服务器对用户子集进行采样,并将当前全局模型发送给他们。每个被采样的用户在其私有数据上执行几步本地 SGD,然后仅将产生的梯度更新传回服务器。服务器聚合这些每用户更新,并将其作为伪梯度应用于全局模型,遵循诸如 SGD 或 Adam 之类的优化器。
为了减轻共享梯度更新可能泄露单个用户敏感信息的风险,作者将差分隐私(DP)集成到联邦训练过程中。一个随机机制 M:D↦R 被认为满足 (ϵ,δ)-差分隐私,如果对于任意两个相邻数据集 d,d′ 和任何输出子集 S⊆R,有
Pr[M(d)∈S]≤eϵPr[M(d′)∈S]+δ.在联邦上下文中,如果两个数据集可以通过添加或移除与单个用户关联的所有示例来获得,则它们是相邻的。该定义确保任何单个用户的整个数据贡献的存在或缺失对模型分布具有有界影响。
为了在实践中实现这一保证,作者以两种关键方式修改了标准联邦平均算法。首先,每个用户的模型更新被裁剪,使其 L2 范数以预定常数为界,从而限制聚合更新的敏感性。其次,在服务器应用更新之前,将根据裁剪边界和所需隐私参数校准的高斯噪声添加到从采样用户群体聚合的更新中。对于隐私核算,作者假设每个用户被均匀且独立地采样,并且采样用户的精确集合对任何对手保持隐藏。
在算法设计的同时,作者收集并策划了一个专门用于评估隐私保护联邦学习性能的数据集。图像通过 Flickr API 获取,并保留相关的 Flickr 用户 ID,以便数据自然地按用户分组,反映真实联邦部署中典型的非独立同分布分布。为了消除个人身份信息,应用了严格的两阶段过滤流程。首先,人脸检测模型自动移除任何包含人脸的图像。其次,人工标注者手动检查剩余图像并标记仍然包含 PII 的图像,第二位标注者验证每个标记以确保准确性。然后使用包含 1,628 个细粒度对象类别的分类体系对图像进行标注,并进一步组织为 17 个粗粒度类别。每张图像由一位标注者标记并由另一位验证;如果对象不明确且无法分配细粒度标签,则使用粗粒度标签。这一策划过程产生了一个特定于用户的图像数据集,支持在形式隐私保证下进行现实的联邦学习实验。
实验
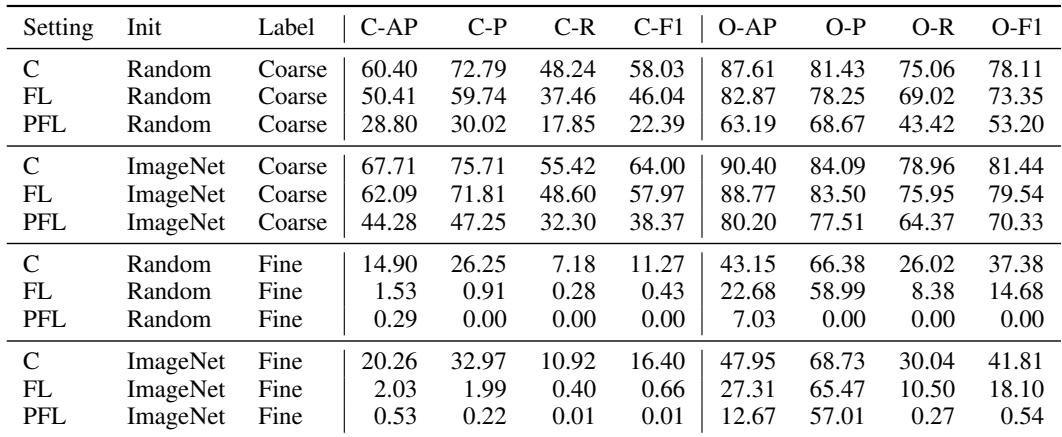
实验在集中式、非私有联邦和差分隐私联邦学习设置下,使用 ResNet-18 模型对 FLAIR 数据集进行多标签分类基准测试,指标包括精确率、召回率、F1 和平均精确率。结果表明,相对于集中式训练,联邦学习显著降低了性能,最大下降发生在细粒度且不常见的类别上,而应用差分隐私进一步加剧了这些差距,特别是对于稀有类别。较大的客户端群体规模通过减少噪声改善了私有联邦学习的收敛性,而从预训练模型微调减轻了但并未消除性能损失。研究结果强调了类别不平衡、长尾分布和 DP 噪声是异构私有联邦设置中的关键挑战,激励了少样本学习、个性化和噪声鲁棒算法的未来研究。
在 FLAIR 基准上,联邦学习始终不如集中式训练,且每类指标的差距大于整体指标的差距。差分隐私进一步降低了性能,并且这种负面影响在粗粒度和细粒度分类体系中的稀有类别上被放大。细粒度标签尤其具有挑战性,无论初始化如何,联邦模型相对于集中式基线都表现出急剧下降。从头开始的联邦学习在每类指标上比集中式训练落后约 20%,但整体指标仅落后 6%,而当从预训练模型微调时,这些差距缩小到 8% 和 2%。在联邦学习中加入差分隐私导致从头开始的每类指标下降约 40%,整体指标下降约 24%,而微调将这些损失减少到约 30% 和 10%。对于细粒度分类体系,联邦学习的表现远差于集中式学习,每类差距约为 90%,整体差距约为 50%,与初始化无关。在联邦学习和私有联邦学习下,稀有类别遭受更多损失;频繁类别与不频繁类别之间的性能差距随着 DP 的加入而扩大,如粗粒度类别平均精确率差异所示。在私有联邦学习中,较大的客户端群体规模减少了聚合更新上的噪声,并导致更快、更好的泛化,特别是在从头训练或微调时。
该表报告了在集中式、联邦式和私有联邦学习下,粗粒度类别的每类平均精确率,每种设置均包括从头训练或微调。性能在各类别之间差异很大,并且对于更频繁的类别始终更高;联邦学习和差分隐私降低了性能,对更稀有类别的影响更明显,而微调减轻了部分损失。类别频率在所有训练设置中与精确率呈正相关。频繁类别与不频繁类别之间的性能差距在联邦学习下扩大,并在应用差分隐私时变得更大。与从头训练相比,从预训练模型微调减少了由联邦学习和差分隐私引起的精确率下降。
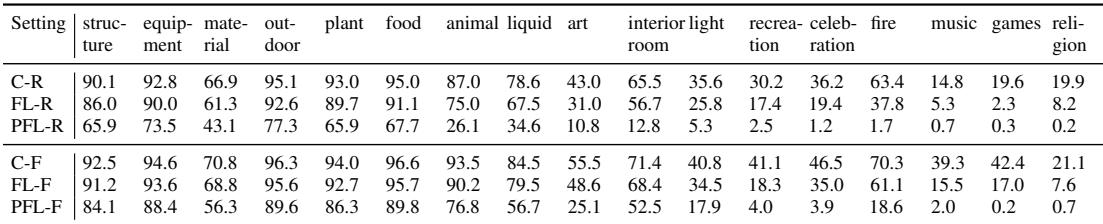
在 FLAIR 基准上,联邦学习始终不如集中式训练,每类指标的差距大于整体指标的差距,并且差分隐私进一步降低了性能,特别是对于稀有类别和细粒度分类体系。从头训练放大了这些差距,而从预训练模型微调减轻了部分损失。类别频率在所有设置中与精确率呈正相关,频繁类别与不频繁类别之间的性能差距在联邦学习下扩大,并且在应用隐私时更大。在私有联邦学习中,较大的客户端群体规模通过减少聚合更新上的噪声导致更快、更好的泛化。