Command Palette
Search for a command to run...
MKQA:面向多语言开放域问答的语言多样性基准
MKQA:面向多语言开放域问答的语言多样性基准
Shayne Longpre Yi Lu Joachim Daiber
MKQA: 多语言知识问答数据集
摘要
跨语言建模的进展依赖于具有挑战性、真实性和多样性的评估集。我们引入了多语言知识问答(MKQA),这是一个开放域问答评估集,包含10k个问答对,覆盖26种类型多样的语言(总计260k个问答对)。答案基于经过严格整理的语言无关数据表示,使得结果在不同语言间具有可比性,且不受特定语言段落的影响。该数据集包含26种语言,提供了迄今为止用于评估问答的最广泛语言范围。我们对多种最先进的方法和基线进行了基准测试,涵盖生成式和抽取式问答,这些方法在Natural Questions上训练,并在零样本和翻译设置下进行评估。结果表明,该数据集即使在英语中也具有挑战性,在低资源语言中尤其如此。
一句话总结
Apple Inc. 推出了 MKQA,这是一个开放域问答基准,包含跨 26 种类型多样语言的 1 万组问答对(共 26 万组),使用与语言无关的答案表示,并对在 Natural Questions 上训练的生成式和抽取式模型在零样本和翻译设置下进行基准测试,表明该数据集即使在英语中也具有挑战性,尤其是对于低资源语言。
核心贡献
- 本文介绍了多语言知识问答(MKQA),一个开放域问答评估集,包含跨 26 种类型多样语言的 1 万组问答对,共 26 万组,提供了迄今为止最广泛的问答评估语言覆盖。
- 本文设计了 MKQA,基于人类可回答的问题,提供与语言无关、与检索无关的答案标注,与现有资源相比,实现了更公平的跨语言比较和更高的答案覆盖率(67.58%,而 TyDi 的平均覆盖率为 38%)。
- 本文对在 Natural Questions 上训练的最新抽取式和生成式问答模型在零样本和翻译设置下进行基准测试,表明该数据集即使在英语中也具有挑战性,在低资源语言中尤其困难,表明仍有很大的改进空间。
引言
问答系统正日益多语言化,但在英语等高资源语言之外,训练和评估数据仍然稀缺。现有的多语言问答数据集具有现实性和挑战性,但存在语言多样性有限、缺乏跨语言直接可比的示例,且通常与数据集附带的段落绑定。依赖于特定段落的抽取式标注在被翻译时也会引入“翻译腔”伪影,并将评估限制在基于检索的方法上。
作者引入了多语言知识问答(MKQA),这是一个开放域问答评估集,旨在克服这些局限性。作者从 Natural Questions 中选取了 1 万个真实英语查询,并将其翻译成另外 25 种语言和方言,涵盖 14 个语系的 26 种语言。一个核心设计选择是用高质量的、与语言和检索无关的标注替换段落内嵌答案跨度,这些标注直接链接到 Wikidata 实体和结构化值类型(如数字、日期和字符串)。这使得 MKQA 兼容任何问答技术,包括知识图谱、稠密和稀疏检索以及生成式方法,同时避免翻译伪影。该数据集在所有语言上完全平行,能够跨类型多样的语言对系统进行直接公平的比较。作者实施了严格的标注质量控制,并验证了问题具有地理不变性,因此答案在不同文化背景下保持一致。MKQA 是迄今为止最大、语言最多样化的开放域问答评估集,基线结果显示仍有很大的改进空间,尤其是在低资源语言中。
数据集
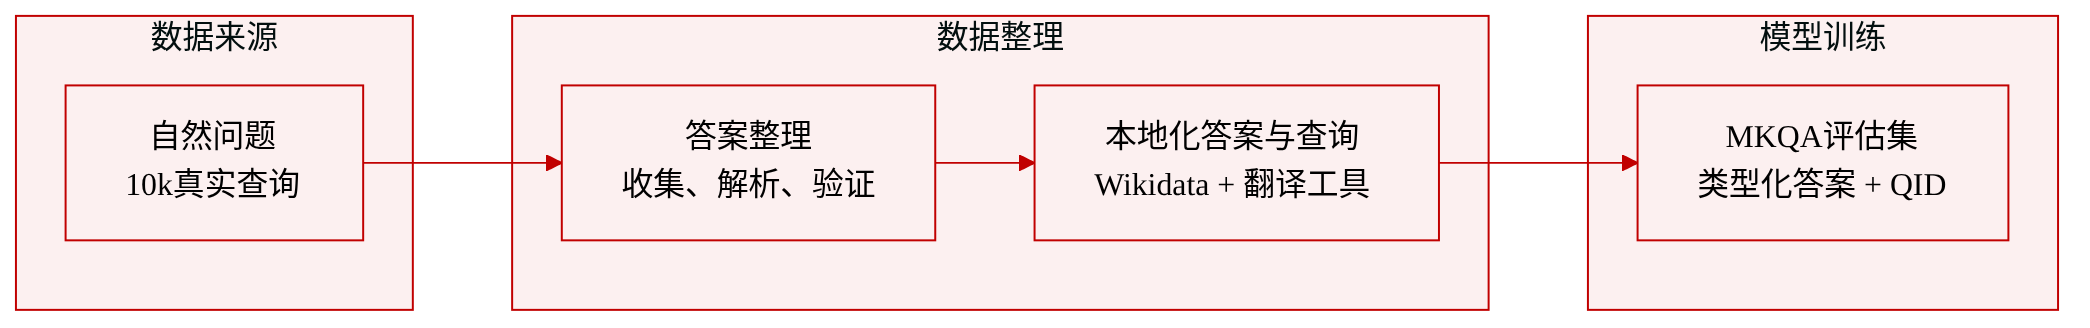
数据集构成与来源
- 作者引入了 MKQA(多语言知识问答),一个为跨语言开放域问答构建的评估集。
- 来源池是从 Natural Questions (NQ) 中采样的 1 万个查询。选择 NQ 是因为它包含由信息寻求用户生成的真实查询。
- 作者力求评估集具有三个特性:真实的问题、可靠的标注(通过标注者间一致性验证),以及灵活的任务设置,该设置对底层建模技术不做过多假设,从而能够跨方法进行公平比较。
- 数据集覆盖一组语言,这些语言的选择旨在最大化类型多样性和世界人口覆盖。按至少有一种入选语言为官方语言的国家衡量,所选语言覆盖了世界人口的 90.62%。
答案整理流程
作者通过多阶段答案整理流程构建数据集:
-
原始答案收集:5 名标注者独立搜索网络,为每个查询复制或生成理想答案。标注者从定义好的类型体系中选取答案类型,并按各类型的格式说明输入答案文本。该类型体系包括:
- 原子值:日期、数字以及带或不带单位的数值范围。
- 实体:使用 Wikidata QID 标注,涵盖通用实体、人物、物体和大多数地点。
- 是/否:二元答案。
- 短答案:无法归入原子值、实体或二元类型但仍为短短语的答案。
- 长答案:当不存在简单事实性或短短语答案且需要更长或可视化解释时使用。为简化评估,这些在评估中被视为“不可回答”。
- 不可回答:表示查询表述不当或不存在明确答案。
-
答案解析:标注者规范化日期和数字格式,并对照 Wikidata 实体解析答案文本。对于短答案,内部实体链接系统生成 Wikidata 候选实体。系统向前 3 名评分者显示前 10 个建议,由评分者选择正确实体或“以上皆非”。当评分者意见不够一致时,由领域专家提供正确的参考。此步骤消除同音异义词歧义并收集有效的同义词和别名。
-
答案验证:5 名标注者中至少 2 人给出的任何规范化答案均被接受为黄金答案。对于未达到该一致性阈值的标注,领域专家审阅全部 5 份初步标注并做最终决定,有权选择、修改或覆盖现有的规范化答案。
-
答案本地化:已验证的答案通过两种方法本地化到目标语言。对于 Wikidata 解析的答案,使用目标语言中的 Wikidata 名称和别名。在适用情况下使用当地字母转写,并将单位术语自然化(例如,“11 月”、“世纪”、“英亩”、“光年”)。日期答案模板为年、月、日的每种组合生成,兼容美式和欧式日期格式以及数字或文字月份。当 Wikidata 链接不可用时,专业双语翻译人员提供当地对应表达,可选择音译、翻译、保持不变或混合方式。
-
查询本地化:双语翻译人员翻译每个查询,在保留含义的同时保持自然措辞。翻译人员是目标语言的母语者,必须通过验证英语流利度的入学考试,并按标准时薪获得报酬。平均而言,每个目标语言约有 16 名翻译人员参与 1 万个源查询的翻译。
数据集质量与统计
- 作者在略超过 1% 的数据上进行了小规模评分实验,以衡量翻译质量和答案可接受性(称为地理不变性)。
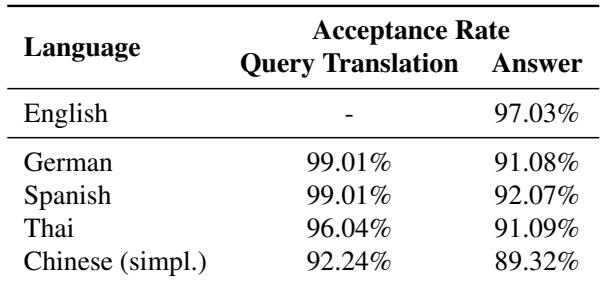
- 德语、西班牙语和泰语的查询翻译始终被评为可接受,而简体中文的翻译接受率较低。大多数翻译问题涉及实体本地化和领域特定术语。
- 答案可接受性在英语中最高,但对于与英语语言距离较远的泰语,仍然保持 90% 或以上。
- 答案质量问题的主要原因包括:
- 答案因文化背景而异(44%),例如实体的本地化版本具有不同属性。
- 跨语言普遍存在的通用标注问题(33%),包括时效性答案和有歧义的查询。
- 实体音译不正确(11%)。
- 通用翻译伪影(11%),导致问题与语言无关答案之间不匹配。
- 与 NQ 相比,MKQA 的“不可回答”或“长答案”类型占比较低(32.4%,而 NQ 为 63%)。这一变化反映了定义上的转变,即从检索到的段落是否包含答案,转变为拥有完整网络访问权限的人能否简洁地回答,因此 MKQA 中的答案标注仅反映查询本身的属性,与任何检索系统无关。
元数据与评估中的使用
- 数据集包含每个示例的补充元数据:答案类型和实体答案的 Wikidata QID。
- 这些元数据使从业者能够使用更具可解释性的指标进行错误分析,并允许答案进一步本地化到 MKQA 覆盖范围之外的维基百科语言。
- 作者鼓励未来的多语言问答基准报告地理不变性,并对示例的可靠性进行基准测试,包括翻译伪影的存在,如本工作所做。
方法
数据收集方法被构建为六步流程,旨在生成高质量的多语言问答数据。该过程分为答案整理和本地化两个阶段。参考框架图以了解各步骤的概览。
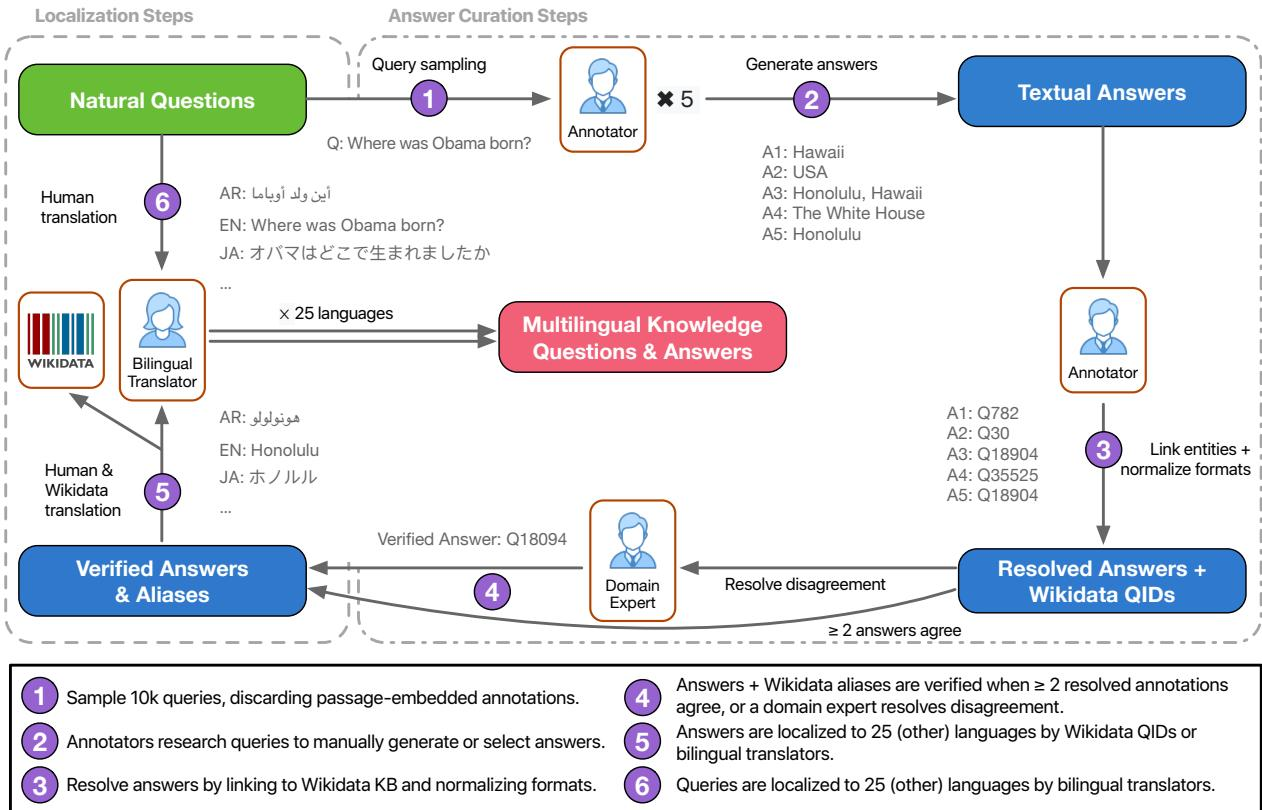
该流程从查询采样开始,从 Natural Questions 数据集中选取 1 万个查询。这些查询作为答案整理阶段的基础。在此阶段,5 名独立标注者研究每个查询以生成或选择理想答案。标注者将回答分类为预定义的类型体系,包括原子值、实体、是/否答案、短答案、长答案和不可回答类别。这种分类允许对特定答案类型进行自动处理。例如,日期和带单位的数字等原子值被格式化以支持自动链接到 Wikidata 实体。
收集原始答案后,系统规范化格式并对照 Wikidata 知识库解析实体。此步骤将每个答案关联到唯一的 Wikidata QID,确保一致性和消歧。验证阶段随后确保答案的可靠性。如果至少 2 名标注者提供相同的规范化答案,则该答案被接受为黄金标准。对于缺乏共识的情况,领域专家审阅标注并做最终决定。专家可以选择、修改或覆盖现有答案以解决分歧。
本地化阶段紧随其后,将已验证的英语查询和答案翻译成 25 种目标语言。对于答案本地化,系统主要利用 Wikidata 名称和别名。该方法保留当地字母并自然化单位术语,同时保留阿拉伯数字。当 Wikidata 链接不可用时,聘请专业双语人工翻译。为翻译人员提供英语查询、答案以及维基百科页面等上下文。指示翻译人员使用音译、翻译或两者结合的方式,以确保文化和语言准确性。
最后一步涉及查询本地化。目标语言的母语者(已通过英语流利度验证)翻译查询。指示翻译人员在保留原始含义的同时确保自然措辞,并在适用情况下使用本地化实体名称。这一严格的本地化过程确保数据集具有鲁棒性,适用于评估多语言问答模型。
实验
实验评估了 MKQA 上跨 26 种语言的多语言开放检索问答,结合了检索、机器翻译以及抽取式或生成式阅读器。结果表明,将查询翻译为英语并使用 DPR 优于多语言稀疏检索,最佳系统在黄金段落上使用带 XLM-R 的 Translate-Train,但所有基线都远落后于纯英语基准,且在可回答问题上表现最差。分析显示多语言检索是关键瓶颈,而模型将长答案和真正不可回答的示例处理方式相似,低资源语言仍远低于“无答案”下界。
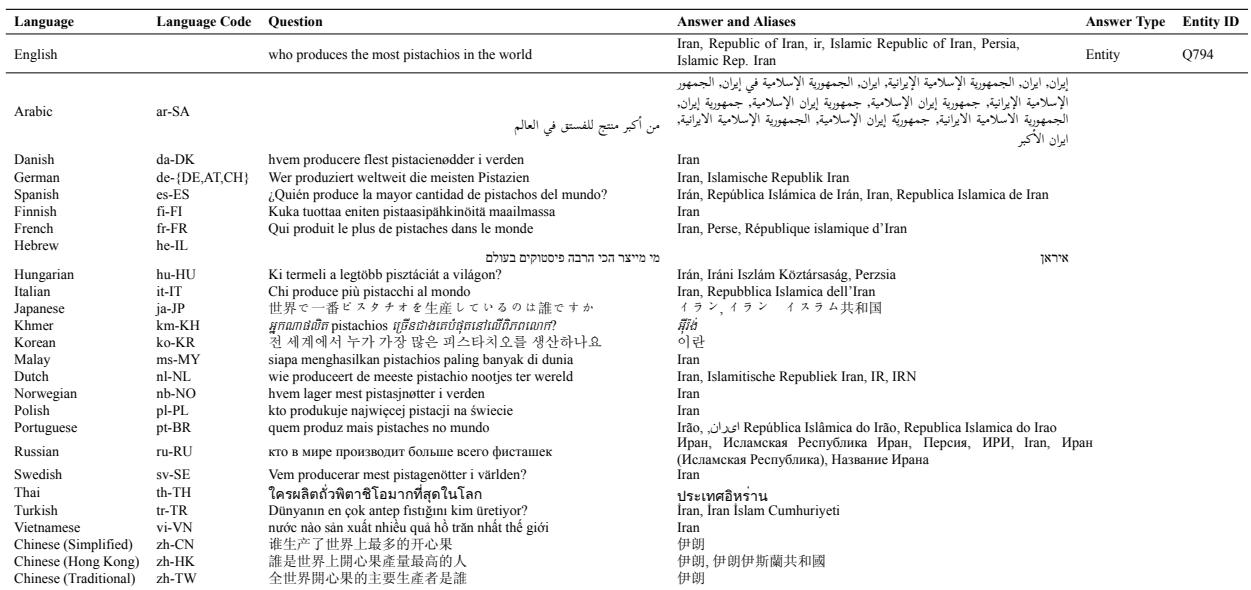
MKQA 提供了一个多语言开放域问答基准,包含翻译成 26 种语言的 1 万个真实问题,使用 Wikidata 链接的答案和类型化值标注。示例展示了一个开心果产量查询,在所有语言中答案一致为伊朗,并带有实体和别名标注以支持与检索无关的评分。每个问题都被人工翻译成多种语言,使用标准化的 IETF BCP-47 代码,支持可比较的跨语言评估。答案以 Wikidata 实体及其别名为基础,支持超越段落抽取的灵活评分方法。不到 4% 的答案因地理或文化背景而异,确保大多数查询具有位置不变性。
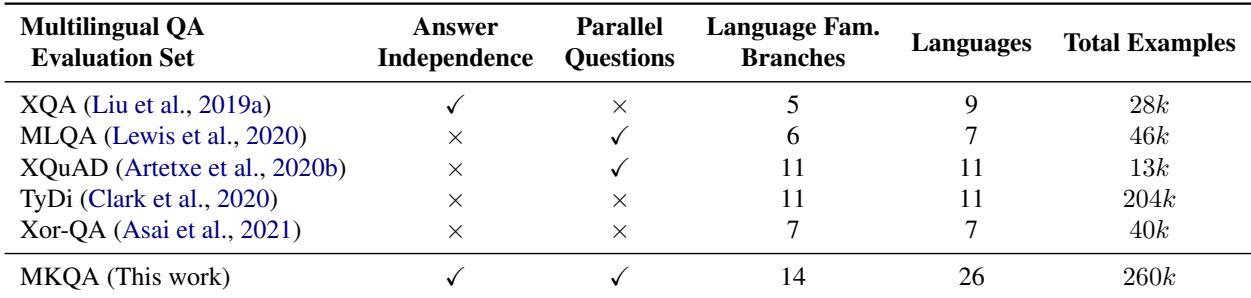
该表格比较了多语言问答评估集在答案独立性、平行问题、语言多样性和规模方面的差异。MKQA 的突出之处在于同时提供答案独立性和跨 26 种语言、26 万个示例的平行问题,在覆盖范围和灵活性上超越了其他数据集。MLQA 和 XQuAD 等现有数据集缺乏答案独立性,而 XQA 和 TyDi 不提供平行问题。MKQA 是唯一同时具备答案独立性和平行问题的数据集。MKQA 覆盖 26 种语言,在比较的集合中最多,共有 26 万个示例。MLQA、XQuAD 和 TyDi 等其他数据集缺乏答案独立性,而 XQA 和 TyDi 不具有平行问题。
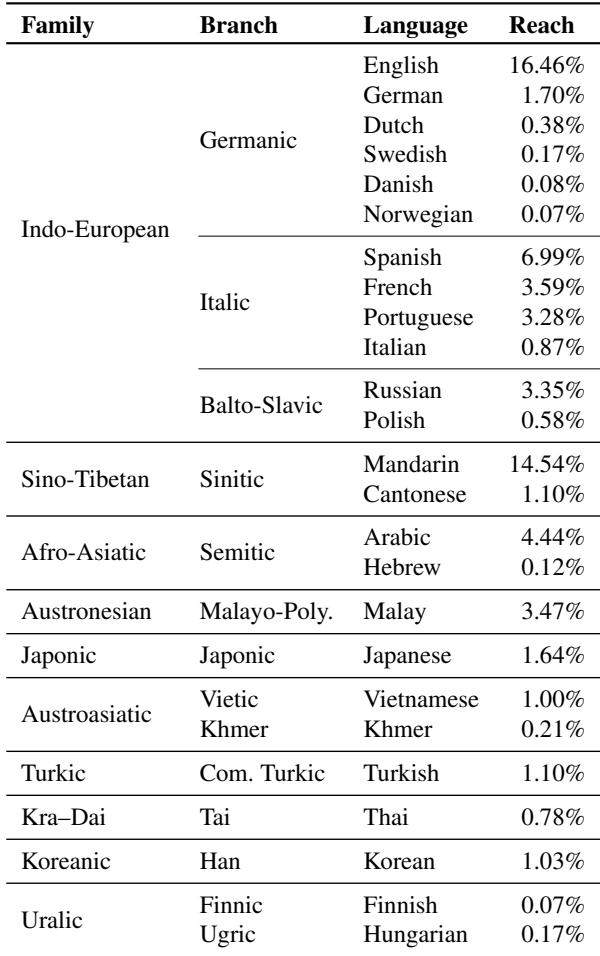
所选语言以印欧语系为主,日耳曼语族和意大利语族均有代表。英语的全球覆盖范围最大,其次是西班牙语,而荷兰语和斯堪的纳维亚语言等几种日耳曼语言的母语者占比较小。这种分布反映了类型多样性与实际人口覆盖之间的权衡。英语是该集合中使用最广泛的语言,覆盖范围几乎是第二大语言的近两倍。日耳曼语言数量最多,但大多数全球覆盖范围非常低,凸显了其有限的母语者人口。西班牙语是列出的唯一罗曼语言,是覆盖范围第二大的语言,远超所有非英语日耳曼语言。
对数据集的小样本评分显示,德语、西班牙语和泰语的查询翻译具有很高的可接受性,而中文翻译的评分较低。所有被测非英语语言的答案质量保持 89% 以上,以英语作为基线表现最佳。翻译和答案错误经常重叠,答案问题往往与文化背景差异相关。德语和西班牙语的查询翻译可接受率达 99%,而中文约为 92%。即使对于与英语语言距离较远的泰语,答案可接受性也保持在 89% 以上。英语答案的可接受性约为 97%,略高于所有其他语言。错误的查询翻译通常会使对应的答案不可接受,因此错误重叠。约 44% 的答案质量问题源于文化背景,例如季节或配音演员的差异。
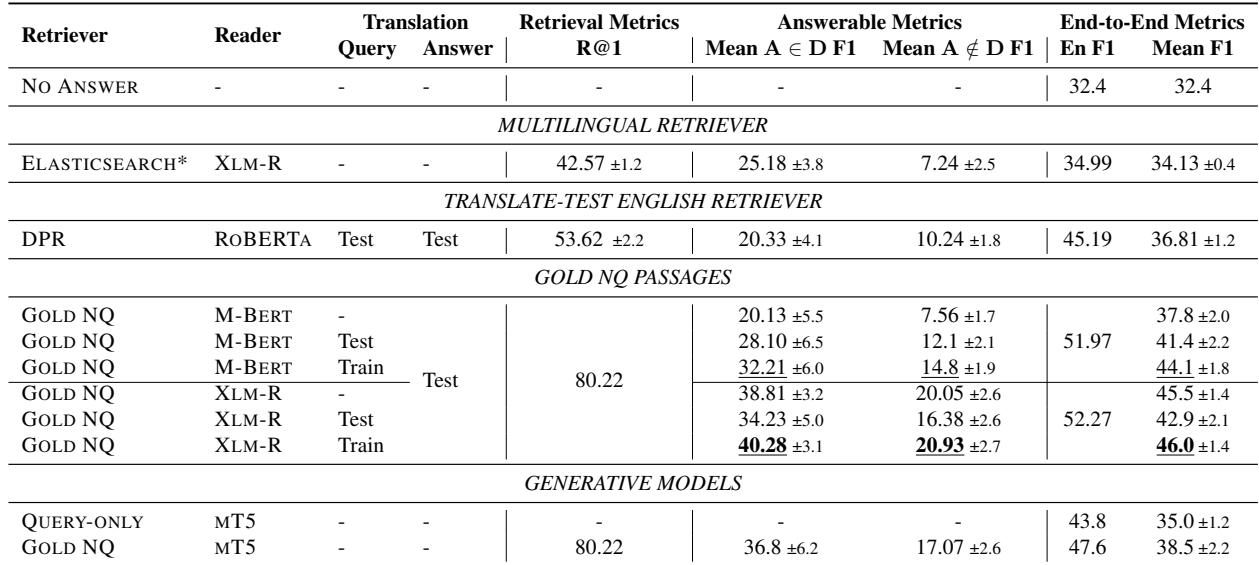
使用 NQ 黄金段落和 XLM-R 阅读器的 Translate-Train 在检索、可回答和端到端指标上取得最佳整体性能。通过 Elasticsearch 进行的多语言稀疏检索不如基于翻译的英语 DPR,“无答案”基线设置了 32.42% F1 的下界。可回答问题比整体端到端指标更难,检索成功仍是关键瓶颈。在 NQ 黄金段落上使用 XLM-R 的 Translate-Train 取得了最高的平均 F1,优于 M-Bert、Translate-Test 和零样本方法。翻译后接英语 DPR 胜过多语言 Elasticsearch 检索器,后者在检索和端到端性能上均较弱。可回答问题的 F1 低于组合端到端指标,表明正确检索段落是一大挑战。
本评估引入了 MKQA,一个多语言开放域问答基准,包含翻译成 26 种语言的 1 万个问题,独特地结合了答案独立性和平行问题,支持灵活的、与检索无关的评分。语言选择在类型多样性与母语者覆盖之间取得平衡,人工评估显示大多数语言的翻译可接受性很高,但中文略低;答案质量保持稳健,文化背景导致部分错误。在模型实验中,使用黄金段落的 XLM-R 阅读器 Translate-Train 取得最佳性能,优于多语言稀疏检索和零样本方法,而检索成功仍是端到端准确率的主要瓶颈。