Command Palette
Search for a command to run...
混合生成-检索变换器用于对话领域自适应
混合生成-检索变换器用于对话领域自适应
Igor Shalyminov Alessandro Sordoni Adam Atkinson Hannes Schulz
Meta-Learning Wizard-of-Oz 元学习多领域对话数据集
摘要
领域自适应近来已成为对话系统研究中的一个关键问题。深度学习虽然是建模此类系统的首选技术,但在拥有海量训练数据时效果最佳。然而,在现实场景中,并非每个新领域都能获得这样的资源,因此,用少量对话示例进行训练的能力可被视为至关重要。在大规模数据源上进行预训练并适应目标数据,已成为深度学习框架内少样本问题的标准方法。在本文中,我们介绍了在DSTC-8快速领域自适应任务中的获胜方案,这是一种基于GPT-2的混合生成-检索模型,针对多领域MetaLWOz数据集进行了微调。该模型在响应生成方面既稳健又多样,同时将检索逻辑作为回退机制,在人类评估中达到了MetaLWOz上的最先进水平(比第二名系统提升超过4%),并在适应未见过的MultiWOZ数据集时获得了有竞争力的泛化性能。
一句话总结
赫瑞瓦特大学和微软研究院的研究人员提出了一种基于 GPT-2 的混合生成-检索模型,在 MetaLWOz 上进行微调,该模型通过将检索作为鲁棒响应生成的备用机制,赢得了 DSTC-8 快速领域适应任务,在人工评估中取得了最先进的性能(比 MetaLWOz 第二名高出 >4%),并在未见过的 MultiWOZ 数据上展现出具有竞争力的泛化能力。
核心贡献
- 提出了一种基于 GPT-2 的混合生成-检索模型,在多领域 MetaLWOz 数据集上进行微调,该模型赢得了 DSTC-8 快速领域适应任务。
- 将鲁棒且多样化的生成式响应生成与面向低置信度场景的检索式备用机制相结合,实现了少样本目标导向对话适应中的有效迁移学习。
- 在 MetaLWOz 的人工评估中取得了最先进的性能,比第二名系统提升了超过 4%,并在主要训练阶段未接触过的 MultiWOZ 数据集上展现了具有竞争力的泛化能力。
引言
目标导向的对话系统面临着在有限数据下快速适应新领域的挑战,这是在标注对话数据稀缺的工业部署场景中的一项关键需求。先前的迁移学习方法虽然构成了最先进的领域适应方法的基础,但仍未达到足以直接应用于生产环境的性能水平。作者提出了一种混合生成与检索方法,将生成模型与检索逻辑相结合,作为低置信度场景下的备用机制。该方法通过迁移学习实现了快速领域适应,并赢得了 DSTC-8 快速领域适应任务,在人工评估中达到了最先进的性能。尽管在主要训练阶段未接触 MultiWOZ 数据集,该方法在该数据集上也展现出具有竞争力的泛化能力。作者承认,数据高效的对话响应生成仍然是一个开放问题,并提出探索元学习(即"学习如何微调")作为未来改善跨多个领域微调性能的一个有前景的方向。
实验
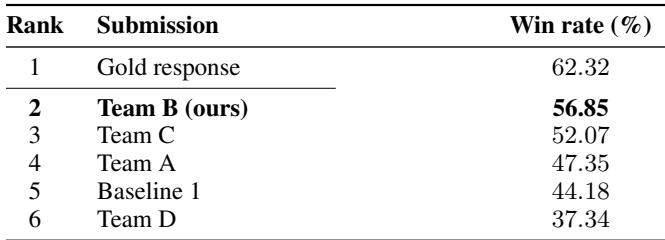
在成对评判比较中,黄金响应以最高的胜率排名第一,提交系统紧随其后排名第二。其余系统按降序排列,基线和另一支团队表现最差。提交系统整体排名第二,略落后于黄金响应。黄金响应明显优于所有其他系统,而排名最低的团队的胜率比领先者低超过 20 个百分点。
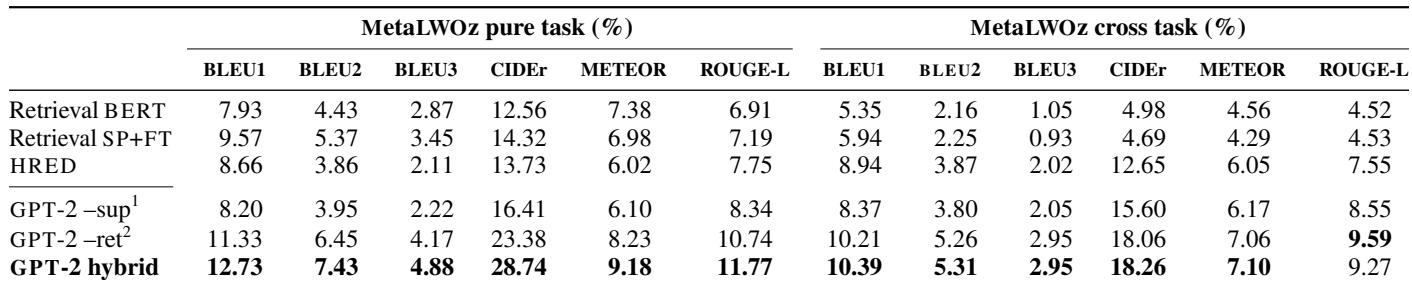
基于 GPT-2 的模型在纯任务和跨任务设置中均优于纯检索和 HRED 基线。GPT-2 混合模型在纯任务中始终取得最高分数,而带有检索逻辑但不采用混合机制的 GPT-2 也表现良好,尤其是在跨任务 ROUGE-L 指标上。基于检索的方法落后于生成模型,尤其是在跨任务场景中。GPT-2 混合模型在纯任务指标上领先,而基于检索的方法明显较低。在跨任务场景中,带有检索逻辑的 GPT-2 在某些指标上达到或超过了混合模型,但两者都优于 HRED 和检索基线。不带支持集的 GPT-2 表现不如带支持集或混合版本的模型,这表明了检索支持的价值。
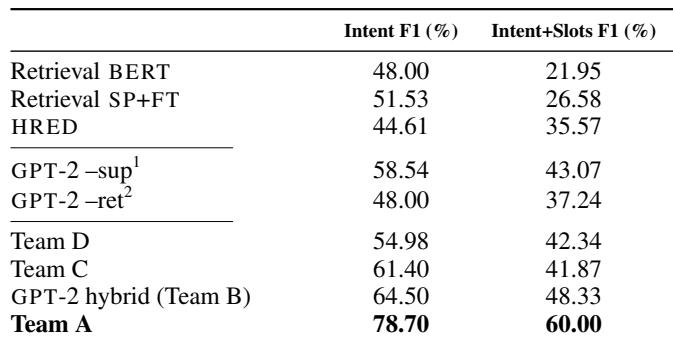
在 MultiWOZ 纯任务基准上,生成方法在意图和槽位指标上普遍优于基于检索的基线。GPT-2 监督变体在意图和槽位综合 F1 上取得最佳成绩,而 C 团队在独立意图 F1 上得分最高。HRED 的意图得分明显较低,但综合得分相对较强,这表明其错误分布有所不同。GPT-2-sup 在意图和槽位综合 F1 上领先,而 C 团队在意图 F1 上得分最高。基于检索的模型(BERT 和 SP+FT)在这两项指标上均落后于生成模型。HRED 在意图和综合 F1 之间存在较大差距,表明其槽位相关错误更多。
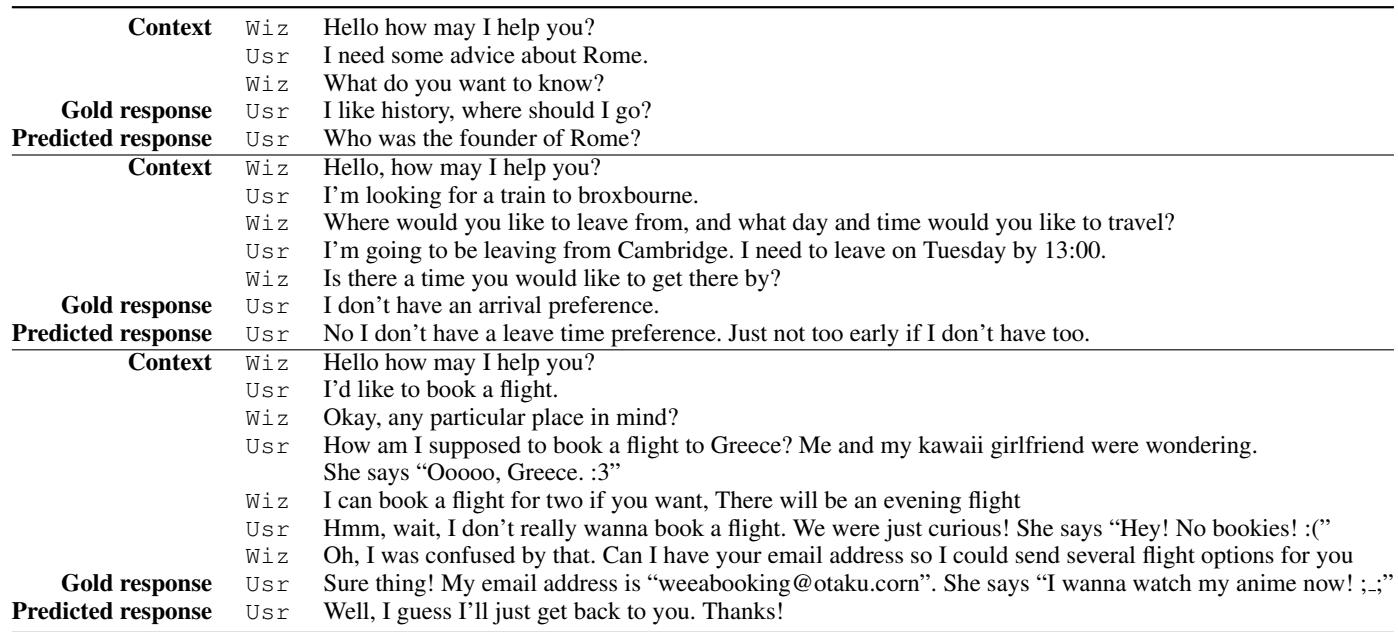
该表格展示了 GPT-2 混合系统的示例对话轮次,将预期的黄金响应与模型的预测响应进行对比。在第一个示例中,模型提出了一个事实性的历史问题,而没有回应用户表达的对历史的兴趣。第二个示例展示了旅行相关的情境,其中向导询问出发详情。针对用户表达的对历史的兴趣,模型询问了罗马的建立者,而不是询问用户想去哪里。模型的预测响应将对话转向了一个事实性问题,而黄金响应则旨在从用户那里获取更多偏好。第二个情境展示了火车旅行请求,向导提示用户提供出发地点和时间。
在所有 MetaLWOz 领域中,GPT-2 混合模型生成响应的频率高于检索响应的频率,生成比例始终超过 57%。在跨任务预订航班领域中,生成偏好最为明显,而在旅游领域中则最不明显。在每个数据集和领域中,生成的响应数量都多于检索的响应数量。最高的生成占比出现在跨任务预订航班领域,为 68.2%,而旅游领域最低,为 57.4%。纯任务领域的生成率介于 57.4% 和 64.1% 之间,表明对生成的依赖程度保持了一致但有所变化。
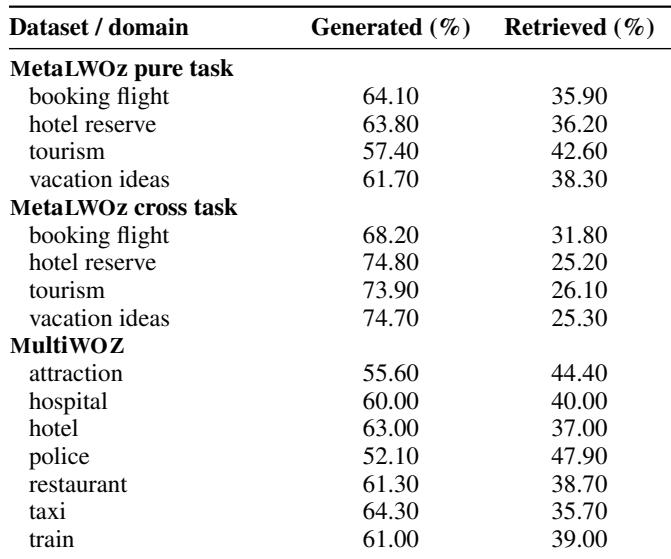
评估结果显示,所提出的系统整体排名第二,在成对比较中略落后于黄金响应,而黄金响应明显优于所有其他系统。在各个基准任务中,基于 GPT-2 的生成模型在纯任务和跨任务设置中均持续优于纯检索和 HRED 基线,其中混合变体在纯任务指标上领先,检索支持提升了生成质量。在 MultiWOZ 纯任务中,生成方法在意图和槽位准确率上均优于检索基线,GPT-2 监督版本取得了最佳综合分数,而 HRED 的槽位相关错误多于意图错误。定性分析显示,混合系统有时会将对话转向事实性问题而不是引导用户表达偏好,并且在所有 MetaLWOz 领域中更倾向于生成而非检索,生成率介于 57% 到 68% 之间。