Command Palette
Search for a command to run...
MS MARCO:一个人工生成的机器阅读理解数据集
MS MARCO:一个人工生成的机器阅读理解数据集
MS MARCO 微软机器阅读理解数据集
摘要
我们提出了一个大规模机器阅读理解数据集,将其命名为 MS MARCO。该数据集包含 1,010,916 个匿名问题——采样自 Bing 的搜索查询日志——每个问题均配有人工生成的答案,以及 182,669 个完全由人工重写的生成答案。此外,数据集还包含 8,841,823 个段落——提取自 Bing 检索到的 3,563,535 个网页文档——这些段落为整理自然语言答案提供了必要信息。MS MARCO 数据集中的一个问题可能对应多个答案,也可能完全没有答案。基于该数据集,我们提出了三项难度各异的任务:(i)给定一组上下文段落,预测问题是否可回答,并以人类的方式提取并合成答案;(ii)基于上下文段落,生成一个(如果可能的话)仅凭问题和段落上下文即可理解的、形式良好的答案;以及(iii)给定一个问题,对一组检索到的段落进行排序。数据集的规模以及问题源自真实用户搜索查询这一事实,使 MS MARCO 区别于其他知名的公开机器阅读理解与问答数据集。我们相信,该数据集的规模及其真实世界属性,使其对机器阅读理解和问答模型的基准测试具有吸引力。
一句话总结
微软人工智能与研究部门发布了 MS MARCO,一个大规模机器阅读理解数据集,包含 1,010,916 条匿名的真实 Bing 查询及其人工生成的答案,以及 8,841,823 条抽取的段落,并提出了三个任务——可回答性预测、答案生成和段落排序——凭借其规模和真实世界来源,该数据集与以往数据集显著不同,为问答模型建立了极具吸引力的基准。
核心贡献
- 该论文介绍了 MS MARCO,一个大规模机器阅读理解数据集,包含 1,010,916 条来自 Bing 搜索日志的匿名真实用户问题、人工生成的答案,以及 8,841,823 条从网络文档中抽取的段落。
- 该数据集定义了三个难度递增的任务:预测可回答性并合成答案、从上下文段落中生成形式良好的答案,以及为给定问题对检索到的段落进行排序。
- MS MARCO 的规模和真实查询来源使其区别于现有的 MRC 数据集,为评估自然语言答案生成和神经信息检索模型提供了基准。
引言
机器阅读理解对于智能助理、聊天机器人和语音交互界面来说是一项关键能力,但在实际场景中部署 MRC 需要模型能够处理噪声文本、信息冲突以及跨越多个文档的答案。现有的 MRC 数据集往往存在不足:规模太小,不足以训练大型神经模型;依赖合成或众包生成的问题,而非来自真实用户查询;使用干净的源材料(如维基百科);并且通常要求答案来自单一文本片段。作者引入了 MS MARCO,一个包含超过一百万条匿名 Bing 搜索查询的大规模数据集,每条查询都配有从网络中检索到的段落和人工生成的自由文本答案;该数据集包含无法回答的问题,并要求模型从多个段落中抽取和综合信息,从而弥补了以往基准在真实性和规模上的不足。
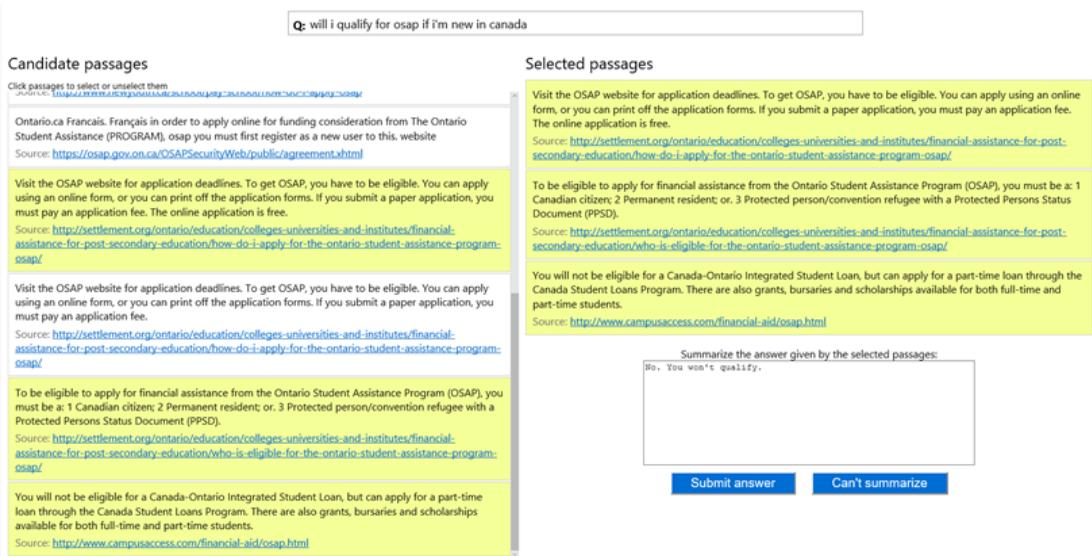
数据集
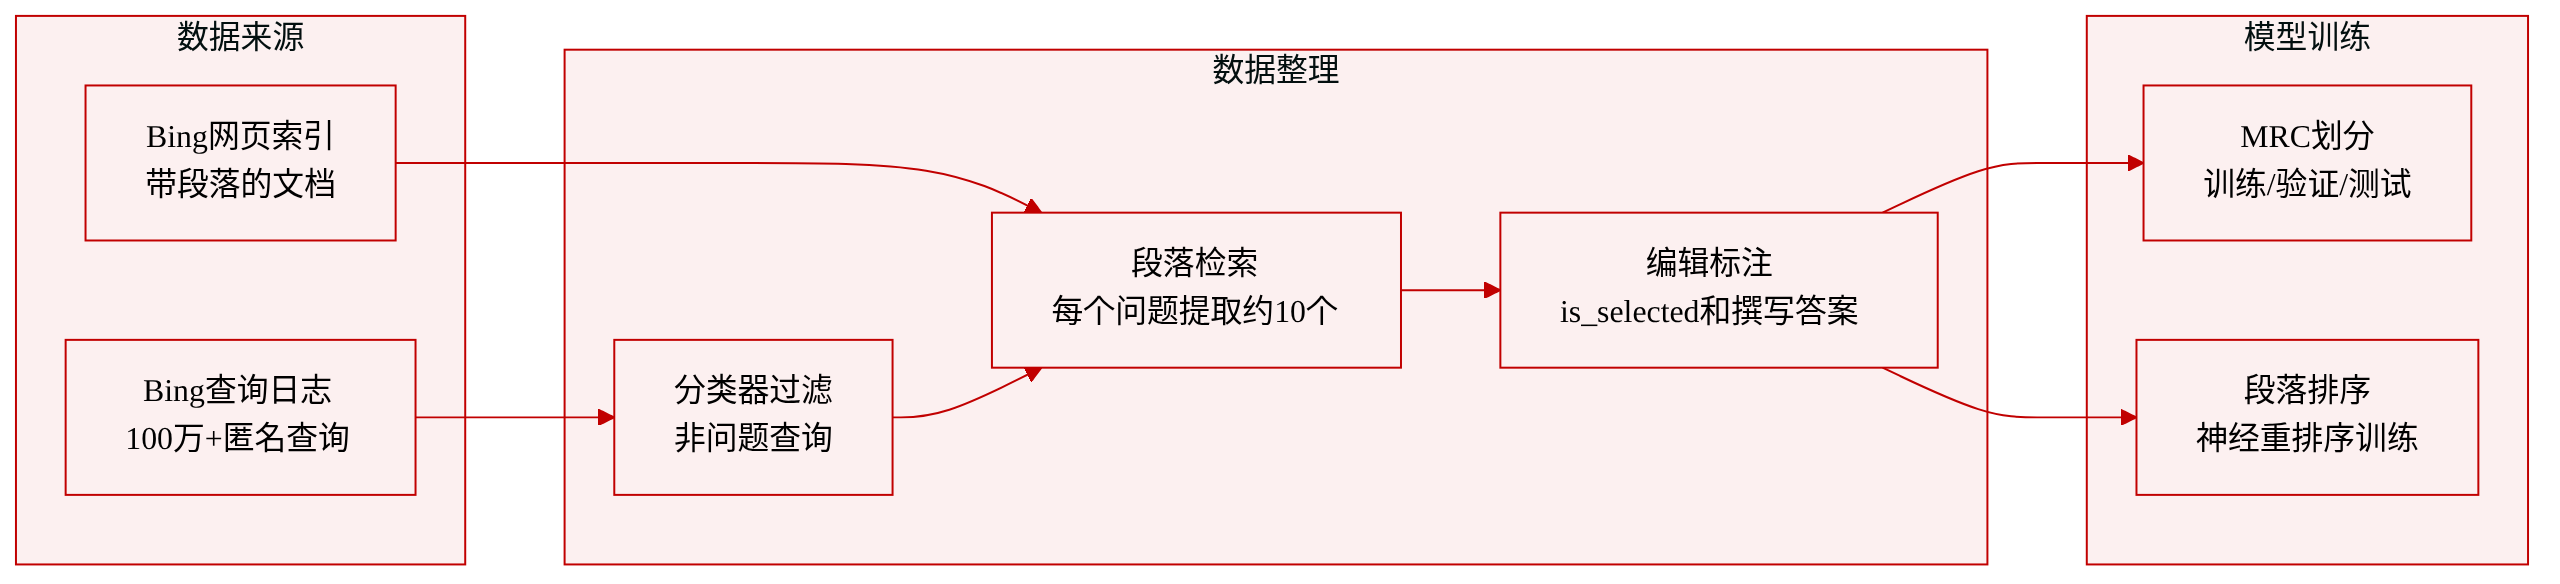
作者介绍了 MS MARCO 数据集,这是一个基于真实世界 Bing 搜索查询构建的大规模机器阅读理解集合。其构成和处理方式如下所述。
数据集构成与来源
- 该数据集包含 1,010,916 个问题、1,026,758 个唯一答案以及约 1000 万个段落(平均每个问题 10 个段落)。所有问题均来自匿名的 Bing 搜索日志。
- 首先使用机器学习分类器过滤掉非问题查询。然后,编辑人员进一步标注每个问题是否可基于所给段落进行回答。
- 通过 Bing 的大规模索引检索相关网页文档,并从这些文档中自动抽取段落。人工编辑标记出包含有用信息的段落(
is_selected),并严格根据段落内容撰写自然语言答案。
关键子集与细节
- 问题: 来自 Bing 日志的经过过滤的问题查询。一个额外的分类器为每个问题标注片段类型:NUMERIC、ENTITY、LOCATION、PERSON 或 DESCRIPTION。
- 段落: 每个问题约检索 10 个段落。编辑标注了他们在撰写答案时所使用的段落(
is_selected=1),当没有答案时将全部标记为 0。 - 答案: 人工撰写的答案;有些问题有多个答案,有些则没有。答案仅基于所给段落综合而成。
- 形式良好的答案: 单独一位编辑对一部分答案进行改写,以改善语法、减少与段落的逐字重叠,并使答案自包含(例如,“一杯有 16 汤匙。”)。
- 文档: 从 Bing 索引中经过后处理得到,包含 URL、正文文本和标题。大约有 30 万份文档因已不在索引中而无法检索。
- 问题类型: 自动分配的片段标签,如上所列。
衍生的段落排序数据集
- 作者取 MS MARCO 中所有段落的并集(约 1000 万条),并利用
is_selected标注创建了一个问题-段落相关性对集合。该标注是不完整的——相关但未被编辑选中的段落未被标记。 - 该子集用于提出一个重排序挑战,并在 TREC 2019 Deep Learning 赛道中设置了一个临时的检索任务。
论文如何使用该数据
- 完整的 MS MARCO 数据集作为一个具有挑战性的基准,用于训练和评估机器阅读理解模型,反映了真实用户的信息需求,其中包含复杂且有时模糊的查询。
- 段落排序数据集用于训练神经排序模型。
is_selected标签作为相关性的训练信号,尽管它们是稀疏的。 - 论文在此处未明确详述训练/验证/测试集的划分,但标准的 MS MARCO 发布版包含了预定义的训练集、开发集和测试集划分。
方法
作者利用 MS MARCO 数据集设计了三个难度递增的机器学习任务,每个任务针对问答和信息检索中不同的能力。这些任务共同构成了一个用于评估生成式和重排序系统的结构化基准。
新手任务关注可回答性检测和简洁答案生成。系统必须首先判断问题是否仅能基于所给段落进行回答。如果答案不被支持,系统必须输出“No Answer Present”。否则,系统应以最简形式生成正确答案,无需满足自然语言流畅性要求。
中级任务通过要求生成形式良好的答案来扩展新手任务。系统再次判断可回答性,但当存在答案时,生成的文本必须是自包含的,并且在朗读时即使没有原始问题和段落上下文也能被理解。这迫使模型生成语法连贯、上下文独立的回答。
段落重排序任务将焦点转移至信息检索。对于给定问题,系统接收一组由 BM25 检索到的 1000 个候选段落。系统必须生成这些段落的相关性排序,根据它们包含回答问题所需信息的可能性进行排列。该任务旨在提供一个大规模数据集,用于训练和评估神经 IR 模型,与另外两个任务的生成式挑战形成互补。
实验
实验使用针对不同答案类型定制的指标,在 MS MARCO v1.1 数据集上评估了生成式、判别式和完形填空式模型,然后在 v2.1 数据集上对阅读理解模型进行了基准测试。结果发现 v2.1 数据集更难,因为模型难以处理无法回答的问题,也难以生成需要所给段落之外词汇的答案。
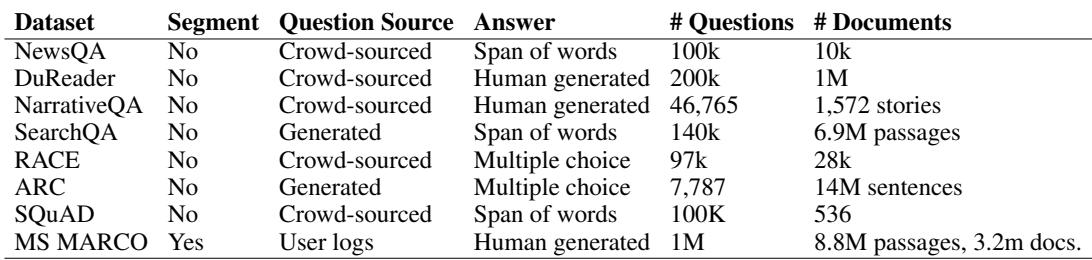
该表格将 MS MARCO 与几个已建立的 MRC 数据集进行了比较,这些数据集均为非分段式。与 MS MARCO 不同,这些数据集完全依赖众包或算法生成的问题,其答案格式涵盖抽取式文本片段、人工撰写的回答或多选题。所有列出的数据集在“Segment”一栏中均标记为 No,与 MS MARCO 的分段结构形成对比。问题来源要么是众包,要么是生成式,而 MS MARCO 使用的是来自 Bing 的真实用户查询。答案类型包括词片段、人工生成和多项选择,而 MS MARCO 提供的是人工生成的答案。
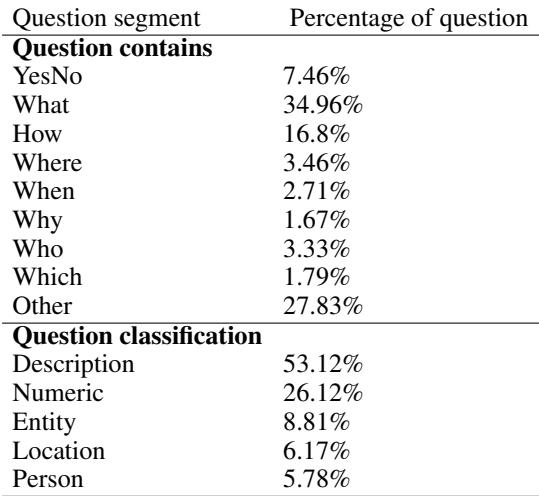
答案类型分布显示出对“What”问题的强烈偏向,该类问题构成了最大的单一类别,约占 35%。“How”和是否类问题紧随其后,而“Where”、“When”和“Why”查询各自仅占数据集的一小部分。“What”问题占据主导地位,约占数据集中所有查询的 35%。是否类和“How”问题合计占数据的 24% 以上,而“Where”、“When”和“Why”各自占比均低于 4%。
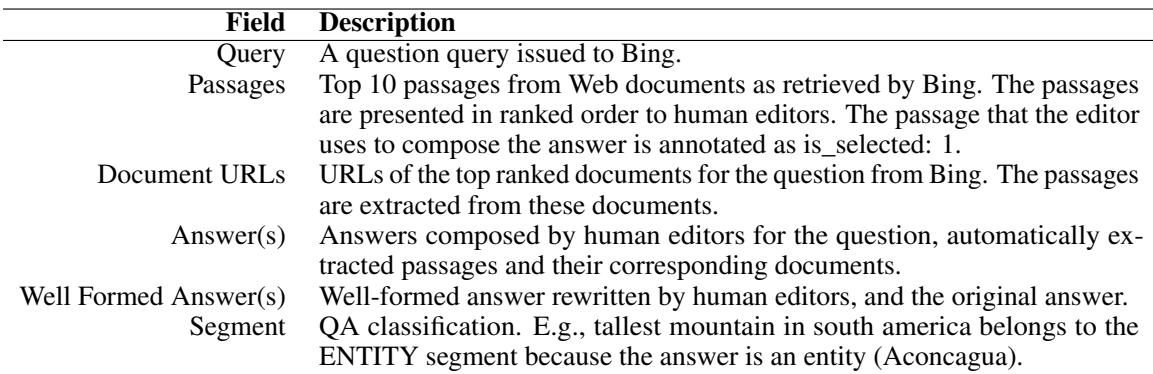
MS MARCO 数据集基于过滤为问题意图的真实 Bing 搜索查询构建,段落从排名靠前的网络文档中抽取。人工编辑选择相关段落并撰写自然语言答案,同时提供一个改写后的形式良好的答案。数据集为每个问题-答案对分配了一个片段类别。查询是来自 Bing 日志的真实用户问题,经过机器学习分类器过滤,以排除导航性和非问题意图。Bing 检索到的前 10 个段落会呈现给编辑,编辑将用于撰写答案的段落标记为已选择。编辑生成一个原始答案和一个可能使用段落之外通用词汇的形式良好的答案。每个 QA 对被分类到一个片段中,例如,对于“tallest mountain in south america”这类问题,分类为 ENTITY。
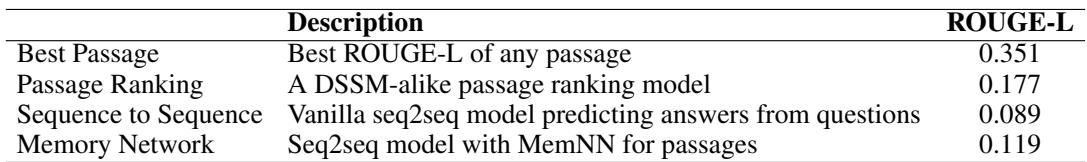
在 MS MARCO 的一个子集上,从任何段落中可获得的最佳 ROUGE-L 为 0.351。在训练模型中,类似 DSSM 的段落排序方法达到了 0.177,大幅优于生成式模型。普通的序列到序列模型和记忆网络分别获得了 0.089 和 0.119,表明段落排序对于此任务要有效得多。段落排序模型的 ROUGE-L(0.177)大约是普通序列到序列模型(0.089)的两倍。记忆网络相比普通 seq2seq 模型有所提升,但仍远低于段落排序基线。最佳段落 oracle 得分为 0.351,表明所有模型都有很大的提升空间。
在多答案 MS MARCO 子集上,最佳段落基线比记忆网络模型获得了更高的 BLEU 和显著更高的 pa-BLEU。记忆网络的 pa-BLEU 得分与其 BLEU 几乎相同,而最佳段落基线则表现出从 BLEU 到 pa-BLEU 的巨大提升。最佳段落基线在两个指标上均优于记忆网络,在 pa-BLEU 上的差距尤其显著。记忆网络在 BLEU 和 pa-BLEU 之间几乎没有差异,相比之下,最佳段落基线的 pa-BLEU 远高于 BLEU。
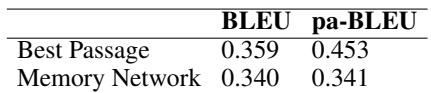
该评估将 MS MARCO 与现有的 MRC 数据集进行了比较,突出了其使用真实用户查询、分段结构和人工生成答案的独特之处,并考察了问题类型的分布,该分布严重偏向“What”问题。数据集的构建过程包括过滤 Bing 查询,并由编辑选择段落和撰写自然语言答案,每个对都被分配了一个片段标签。子集上的实验表明,段落排序模型大幅优于生成式方法,且最佳段落 oracle 得分表明存在显著的改进空间。在多答案设置中,选择最佳段落再次被证明比记忆网络更有效,在段落感知的 BLEU 上提升尤为显著。