Command Palette
Search for a command to run...
在线教程丨快速决策,按需推理,JEV-27B-VL基于Qwen3.8-27B,支持图文判断、多选与评分
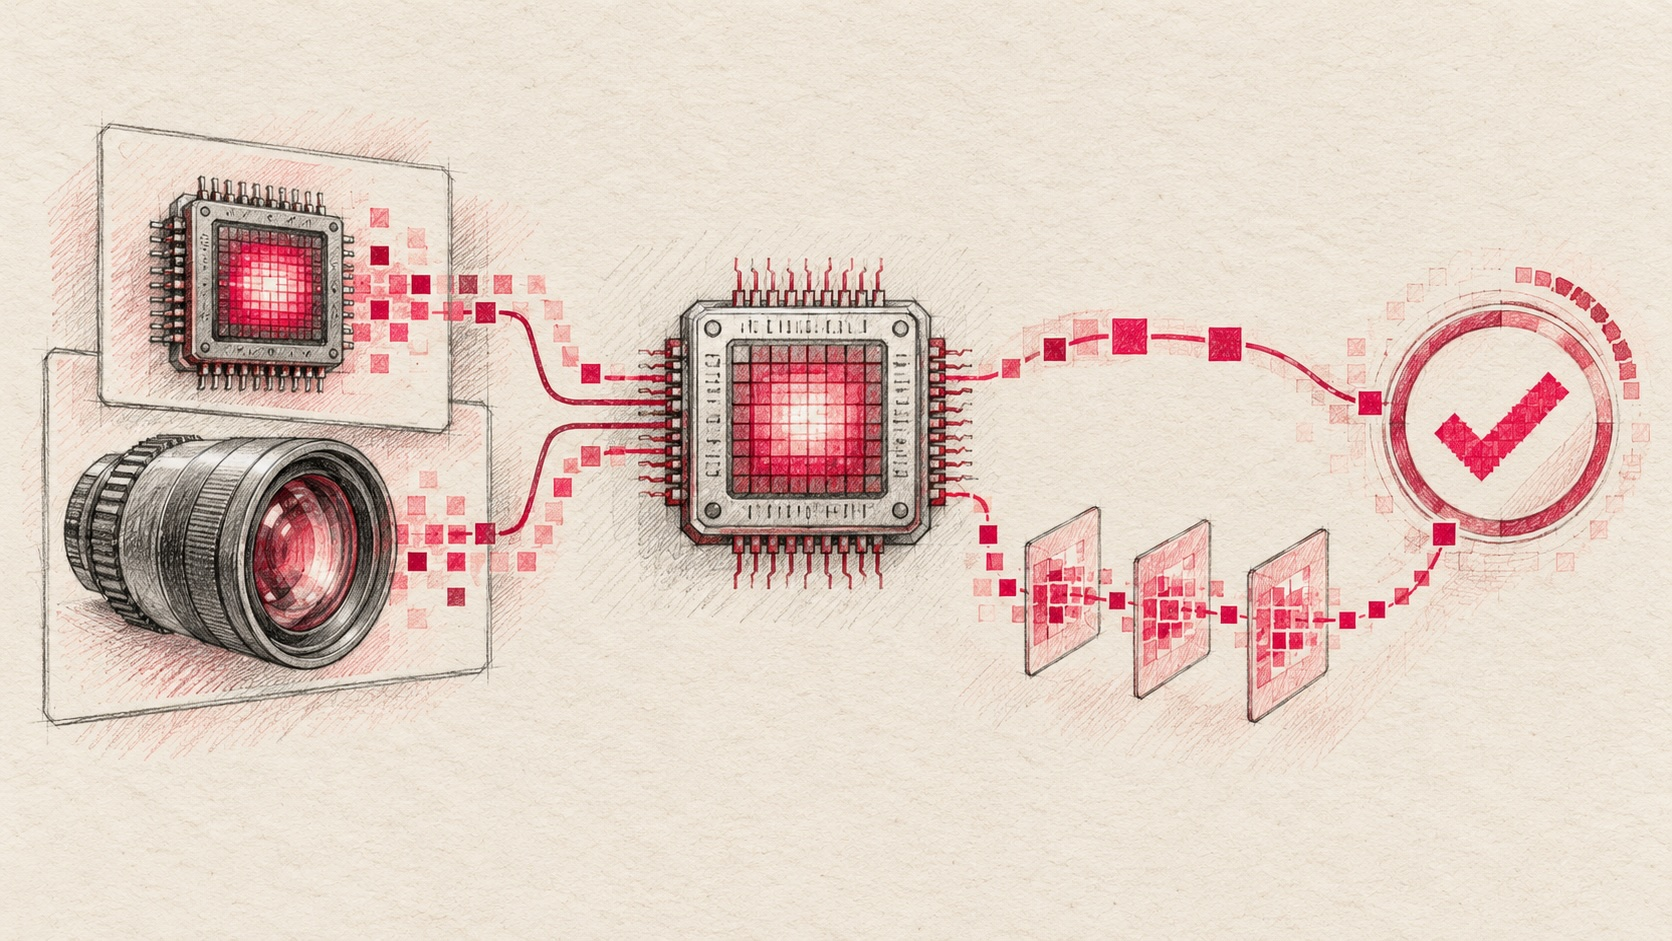
视觉语言模型已经能够理解图片、回答问题;然而 AI 看图,不一定非要生成一大段回答。比如,判断一张图片是否包含违规内容、从多个商品中选出最符合要求的一款,或者判断短视频封面是否值得推荐——这些任务真正需要的,往往不是一段详尽的分析,而是一个明确的决定,以及这个决定有多大把握。
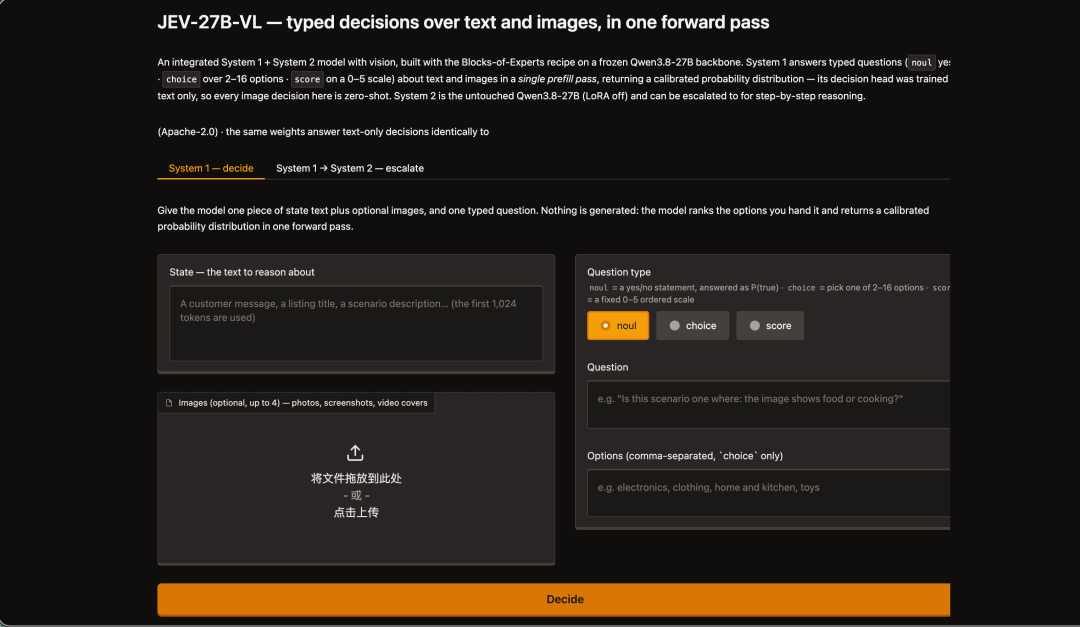
由 AutoTrust 团队于 2026 年推出的视觉决策模型,JEV-27B-VL ,正在探索一种不同的解决思路。 其在社区 Jev Decision Index 0.3 的 Vision 榜单中排名第一。据项目介绍,与主要面向开放式文本生成的视觉语言模型不同,JEV-27B-VL 更关注 Typed Decisions(类型化决策):让模型针对文本和图像输入,直接给出符合指定类型的判断结果。
技术上,JEV-27B-VL 以 Qwen3.8-27B 为基础,通过 Blocks-of-Experts 方案整合两种不同的处理路径:System 1 负责快速决策,System 2 负责深入推理。它重新安排了不同任务的计算路径,避免让每一次判断都承担完整生成和推理的成本,从而实现模型的轻量化。 System 1 通过专门的决策头,在一次前向传播中输出各选项的校准概率,支持 Yes / No 判断、多选题(2–16 个选项)以及 0–5 分评分,无需逐个 Token 自回归生成答案。如果决策置信度较低,再进一步调用 System 2,使用原始 Qwen3.8-27B 进行逐步推理。相比所有任务都走完整的生成流程,这种按需分配计算的方式更适合对延迟和推理成本敏感的应用。
当任务只需要一个决定,就不必让模型生成一篇答案。 目前,HyperAI 官网(hyper.ai)的教程板块已上线「JEV-27B-VL:面向文本与图像的结构化决策模型」,帮助开发者快速调用模型能力。
在线运行:
更多在线教程:
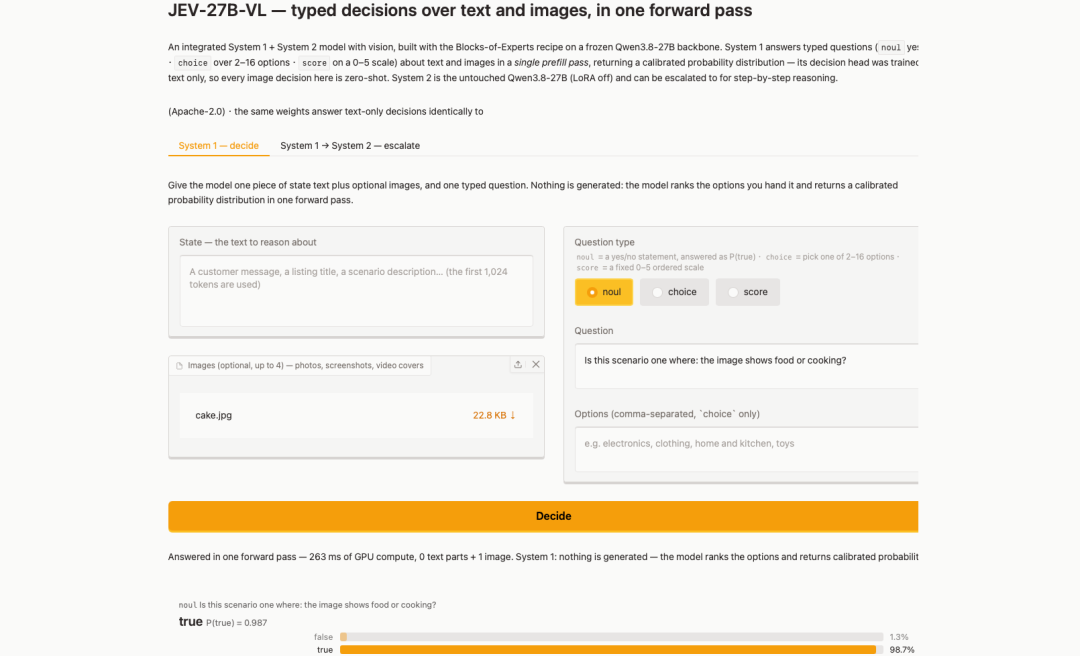
Demo 运行
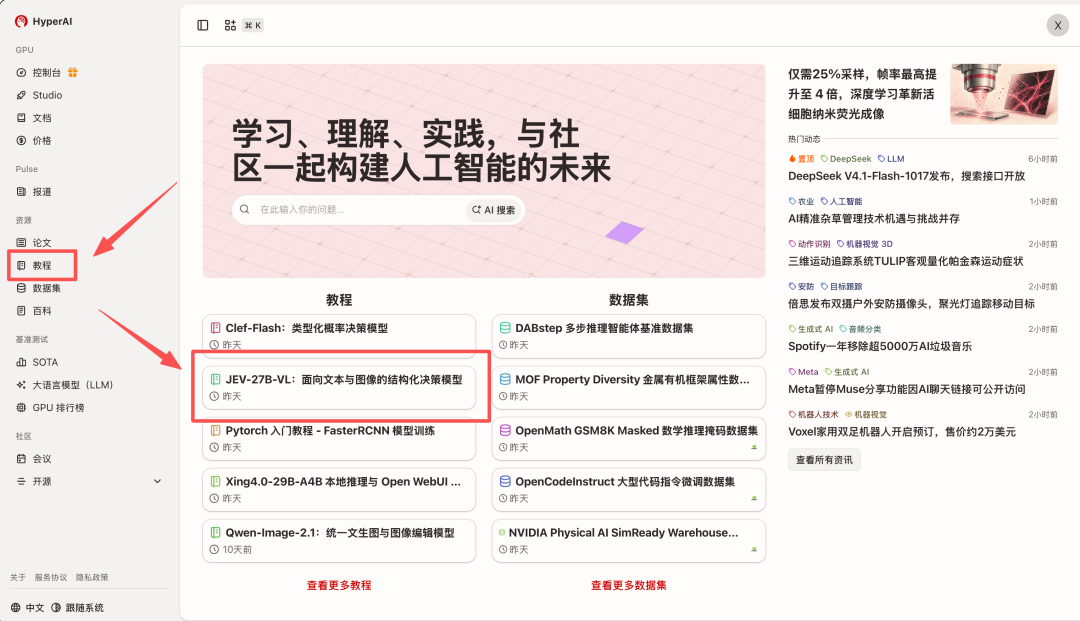
- 进入 hyper.ai 首页后,选择「教程」页面,或点击「查看更多教程」,选择「JEV-27B-VL:面向文本与图像的结构化决策模型」,点击「运行此教程」。
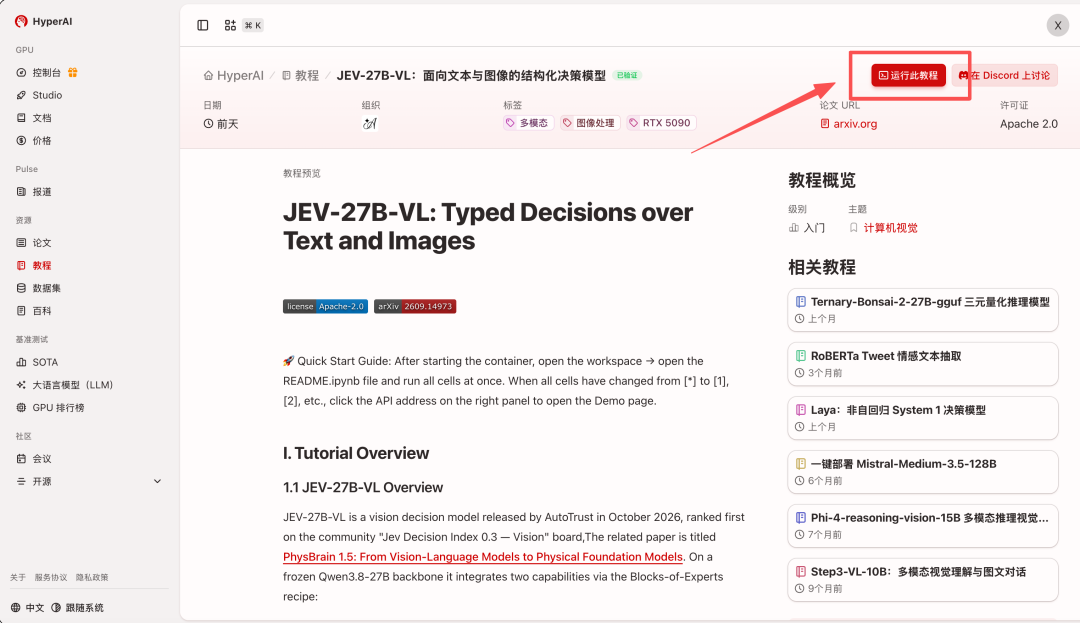
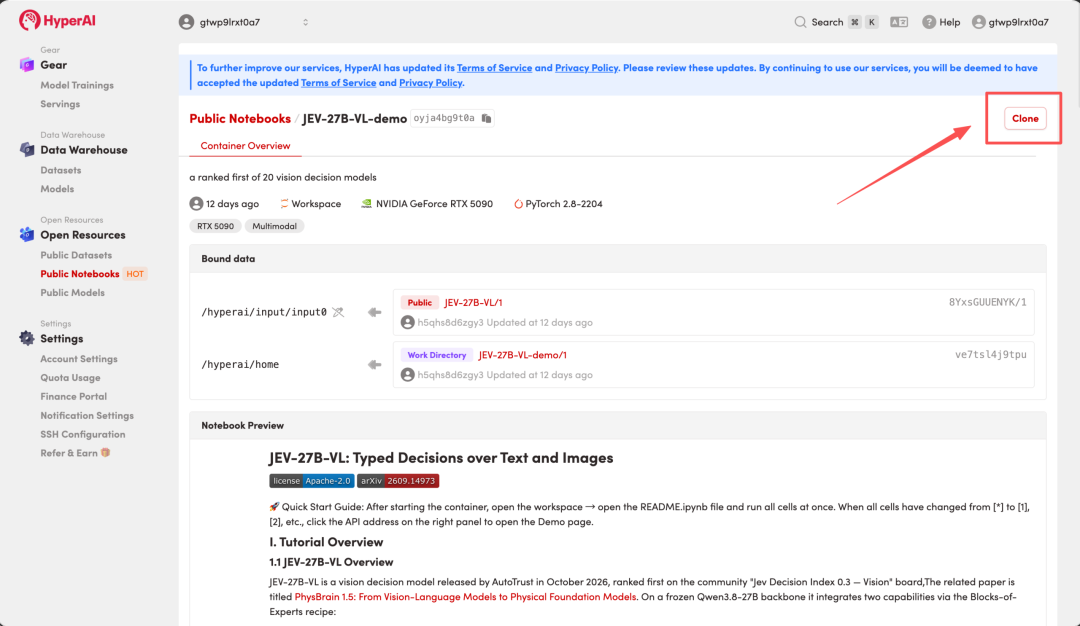
2.页面跳转后,点击右上角「Clone」,将该教程克隆至自己的容器中。
注:页面右上角支持切换语言,目前提供中文及英文两种语言,本教程文章以英文为例进行步骤展示。
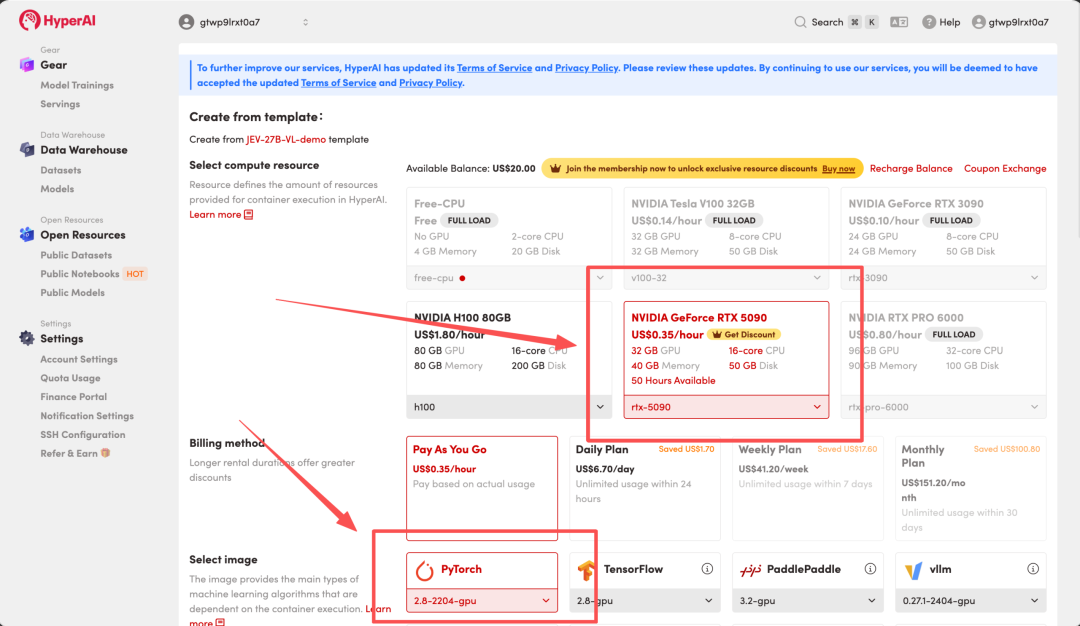
- 选择「NVIDIA RTX 5090」以及对应镜像,点击「Continue job execution(继续执行)」。本教程默认使用 NVIDIA GeForce RTX 5090(32 GB 显存)资源。
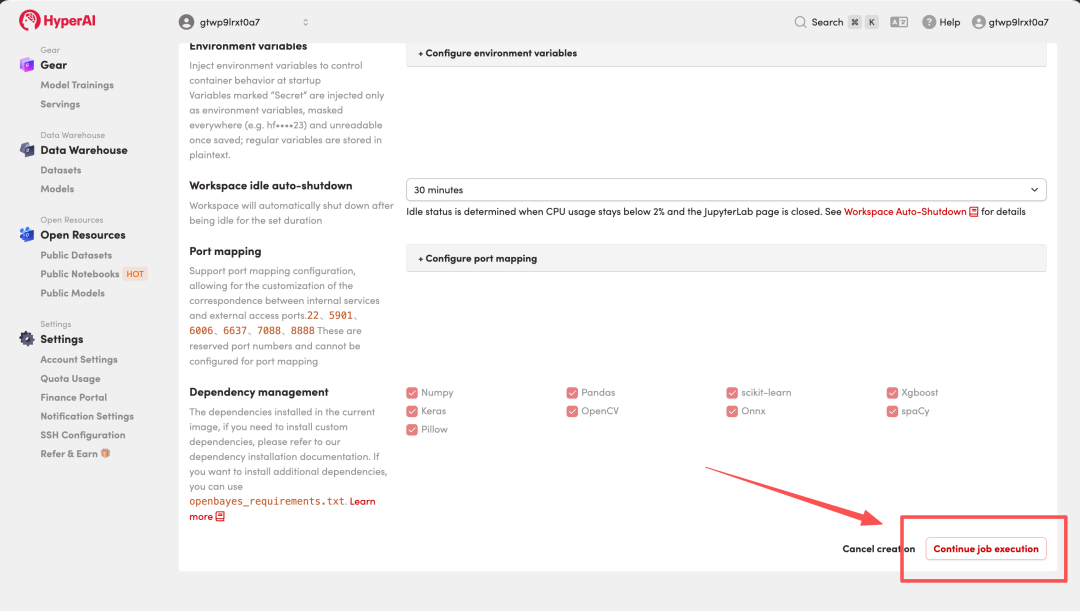
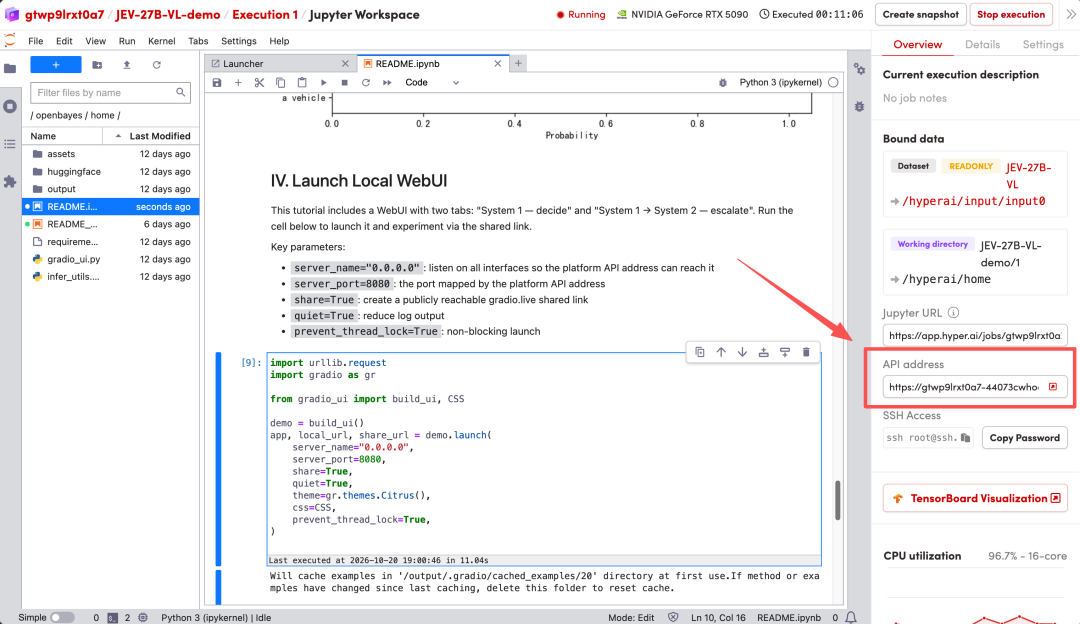
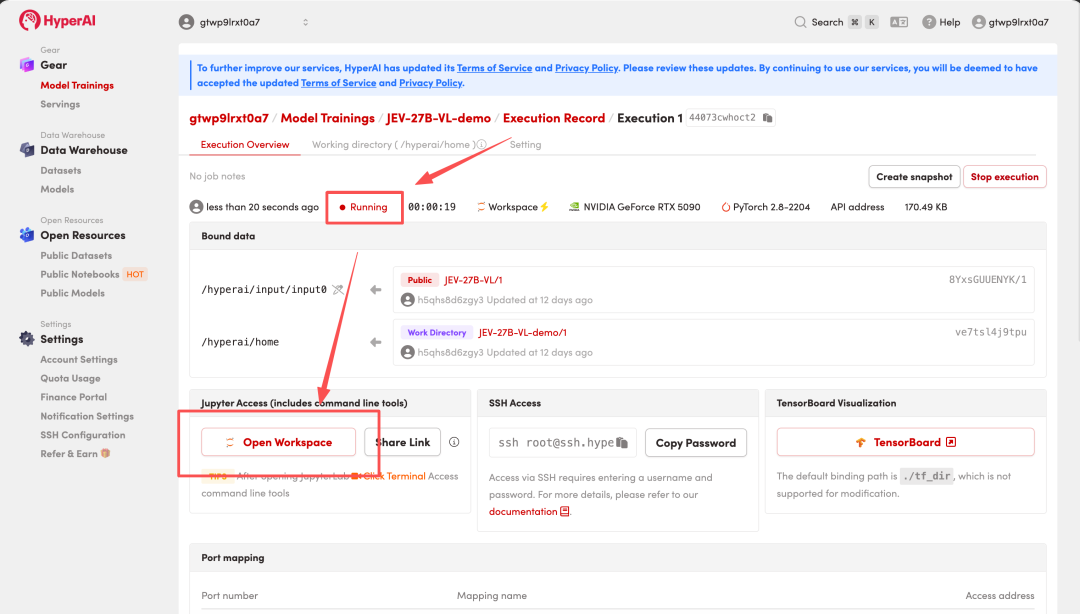
4.等待分配资源,当状态变为「Running(运行中)」后,点击「Open Workspace」进入 Jupyter Workspace。
效果展示
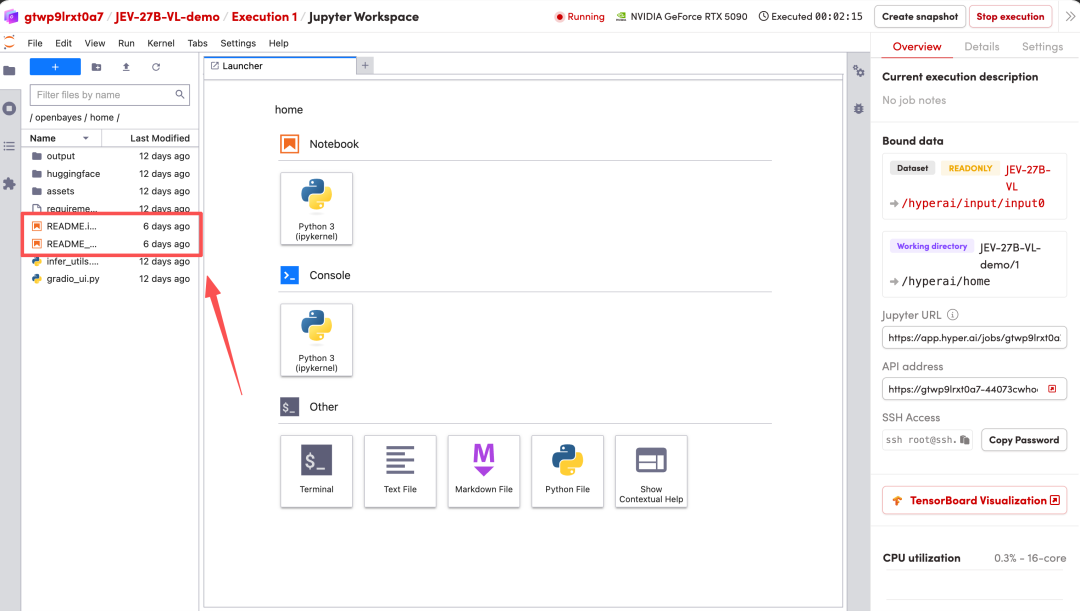
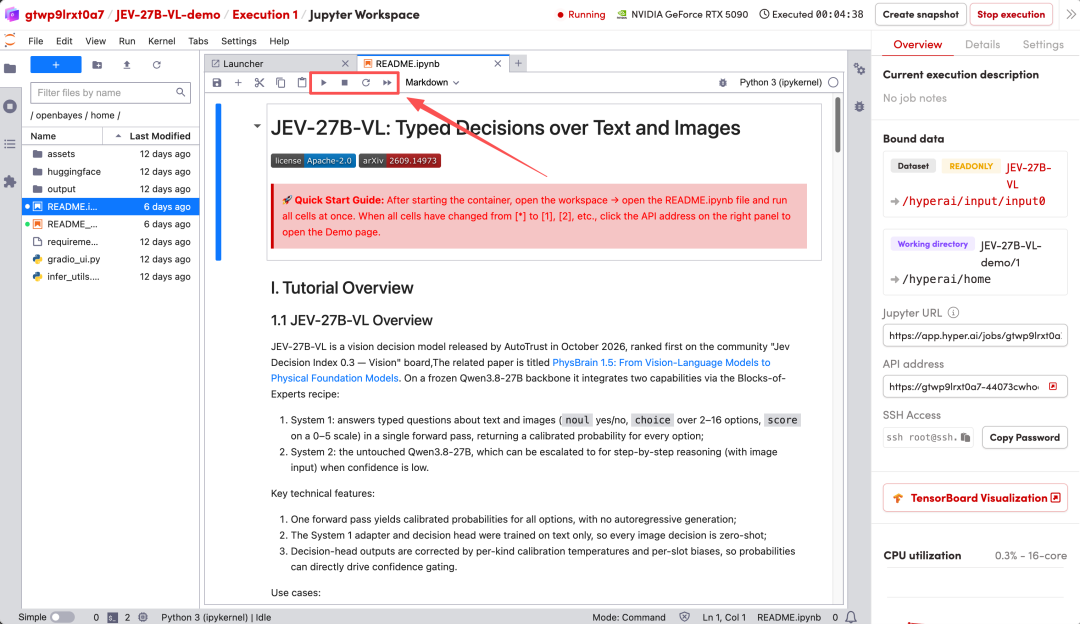
1.页面跳转后,点击左侧 README 文件,进入后点击上方 Run(运行)。
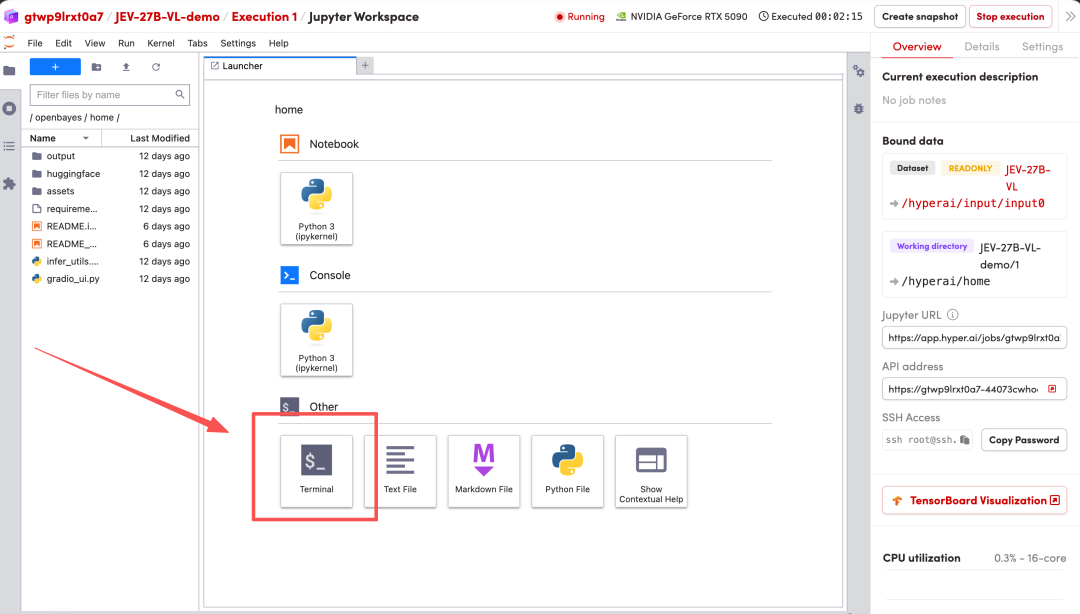
2.待运行完毕后,请打开新终端,执行以下命令启动 Open WebUI。
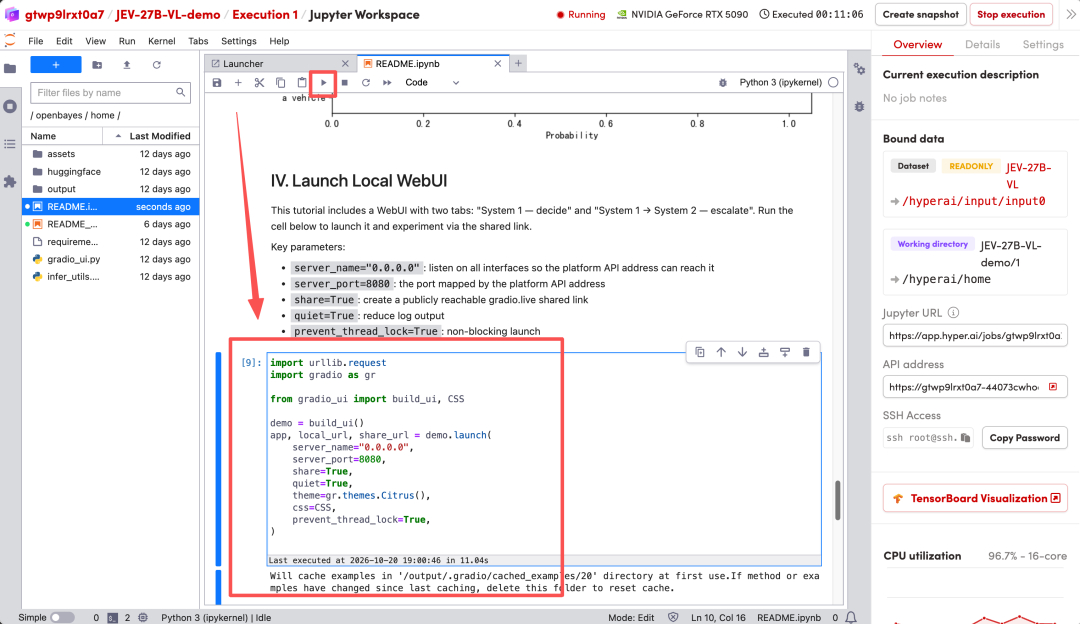
3.启动后,点击右侧 API 地址即可在浏览器中访问 Open WebUI 界面。