Command Palette
Search for a command to run...
零样本识别准确率达95.4%,MIT等提出CLaC模型,实现材料结构与语言的跨模态对齐

材料发现的一项重要任务,是从庞大的化学与结构空间中筛选具有目标性能的候选材料。近年来,图神经网络通过学习晶体的三维原子结构,在材料属性预测、结构生成等任务中取得了显著进展。然而,这类模型通常依赖预定义的属性标签或数值条件,难以直接理解自然语言描述的材料需求;大语言模型虽然擅长处理文本,却缺乏对晶体空间结构及其物理属性的准确表征。
将晶体结构与自然语言结合,为材料发现提供了新的思路,但现有晶体数据库规模有限,学术文献又集中于少数热门材料,文本描述与材料属性之间缺乏充分的对应关系,制约了多模态模型的训练效果。
针对这一问题,麻省理工学院、韩国蔚山科学技术院、伊利诺伊大学厄巴纳-香槟分校、MIT-IBM Watson AI Lab 等机构的研究人员提出了对比语言-晶体模型(Contrastive Language-Crystals,CLaC)。该模型利用大语言模型生成以材料属性为依据的合成叙述,通过对比学习将晶体结构与自然语言映射到共享表征空间。 实验表明,相比直接使用学术文献文本训练的模型,CLaC 在零样本材料理解和自然语言引导的材料检索任务中表现出明显优势。
相关研究成果以「Scaling multimodal materials representation learning with synthetic narratives」为题,已发表于 Nature Communication。
论文地址:
https://www.nature.com/articles/s41467-026-76378-7#Sec10
12.6 万组晶体-文本配对数据,扩展材料语义覆盖范围
训练晶体多模态模型,首先需要建立晶体结构与自然语言之间的对应关系。虽然现有材料数据库积累了大量晶体结构和计算属性,但相关文本主要散落在学术论文中,且集中于少数研究充分的材料,难以覆盖多样化的晶体结构,也无法保证文本包含完整的材料属性信息。
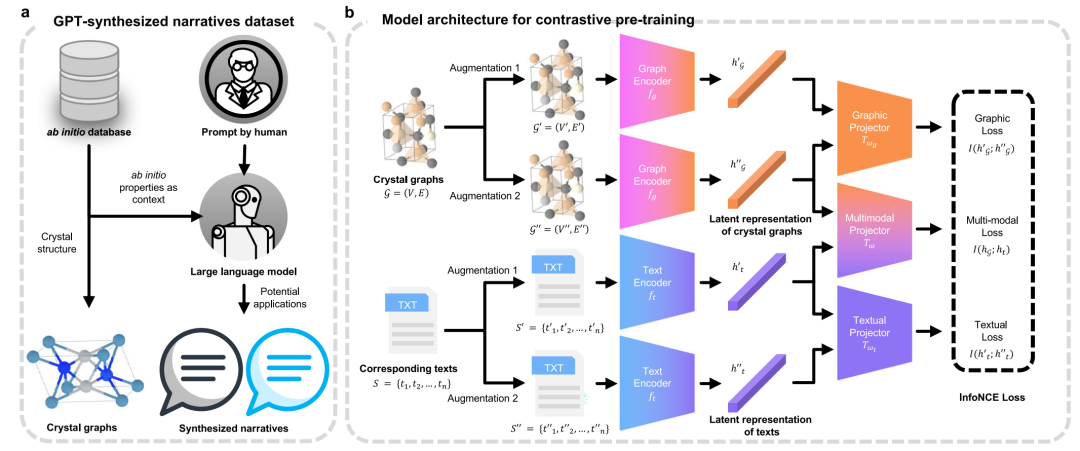
为此,该研究以 Materials Project 数据库为基础,收集了约 12.6 万条晶体材料数据, 并分别构建晶体图结构和自然语言描述。晶体结构通过 Jarvis-tools 工具转换为图数据,以原子及其相互作用表示三维结构;文本部分则采用研究人员此前开发的 GPT 合成叙述数据集,利用大语言模型根据材料数据库中的计算属性生成描述性文本。
与简单地将化学式或元素组成转换为文字不同,合成叙述以材料计算属性为依据,涵盖结构特征、物理性质、功能行为及潜在应用等信息。例如,根据某种晶体的组成、带隙和密度等已知数据,生成包含相应物理特征及应用信息的描述,使晶体结构与更丰富的材料语义建立对应关系。
为验证合成叙述的作用,研究人员还构建了学术文献对照数据集,以化学式为检索条件,从约 400 万篇科学论文全文中提取相关段落,最终获得约 40 万组材料-自然语言句子配对数据, 但仅覆盖约 400 种无机化合物。相比之下,GPT 合成叙述涵盖的不同晶体种类数量约为学术文献数据的 300 倍。
两类文本数据分别用于训练 CLaC-Synthetic(合成叙述版本)和 CLaC-Paper(学术文献版本),以比较不同数据来源对模型性能的影响。数据集按照 8:1:1 的比例划分为训练集、验证集和测试集。
结合图神经网络与语言模型,实现晶体结构和自然语言对齐
CLaC 借鉴了 CLIP 在视觉语言领域的对比学习方法, 通过联合学习晶体结构与文本描述,将两种信息映射到共享表征空间,使模型能够计算材料与自然语言之间的语义相似度。
CLaC 采用双编码器架构,由晶体图编码器、文本编码器和多模态投影模块组成。 晶体图编码器负责提取原子组成、局部配位环境及三维几何结构等信息,文本编码器则处理材料属性、功能特征和应用需求等自然语言描述。两类信息分别转换为向量后,通过投影模块进入统一的潜在空间,建立晶体结构与文本语义之间的对应关系。
在晶体结构编码方面,该研究采用 PaiNN(Polarizable Atom Interaction Neural Network)图神经网络,通过等变消息传递机制学习原子间的空间关系,在捕捉局部原子环境的同时保留几何信息,并引入 CGCNN 和预训练原子间势模型 ORB 作为对照。
文本编码器则比较了 SciBERT、MatSciBERT、OPT-125M 和 Galactica-125M 等预训练语言模型,涵盖双向编码与自回归两类架构。结合后续实验结果,研究人员最终采用 PaiNN 与 Galactica-125M 作为主要编码器组合。
CLaC 的核心是跨模态对比学习。 训练时,同一种材料的晶体图与文本描述被视为正样本配对,不同材料之间的结构与文本组合则构成负样本配对。模型通过 InfoNCE 对比损失,提高正确配对的向量相似度,降低不匹配样本之间的相似度,逐步学习晶体结构、物理属性与自然语言之间的关系。
考虑到配对数据有限,该研究还加入了模态内对比学习,使模型能够识别同一晶体的不同结构表示,以及同一材料的不同文本描述。 其中,晶体图通过原子位置扰动和 0–5% 的晶格应变进行数据增强;文本则通过随机删除和打乱句子顺序生成不同版本,每个句子的保留概率为 50%。这些方法能够提高模型对轻微结构变化和文本表达差异的鲁棒性。研究人员没有采用同族元素替换,因为这可能改变材料的配位环境、电子结构及实际属性。
预训练过程中,晶体图编码器从头训练,文本编码器使用预训练权重初始化。模型采用 512 维联合嵌入空间、AdamW 优化器,学习率为 2×10⁻⁵,有效批量大小为 256,最多训练 5 个周期。
完成预训练后,CLaC 可以将自然语言查询转换为向量,与材料数据库中预先计算的晶体向量进行相似度比较,从而筛选具有目标属性的候选材料, 无需针对每种属性重新训练模型。不过,CLaC 本身并不直接生成晶体结构,其主要作用是建立语言与晶体结构之间的联系,为后续材料逆向设计提供支持。
从零样本材料理解到自然语言检索,验证跨模态学习效果
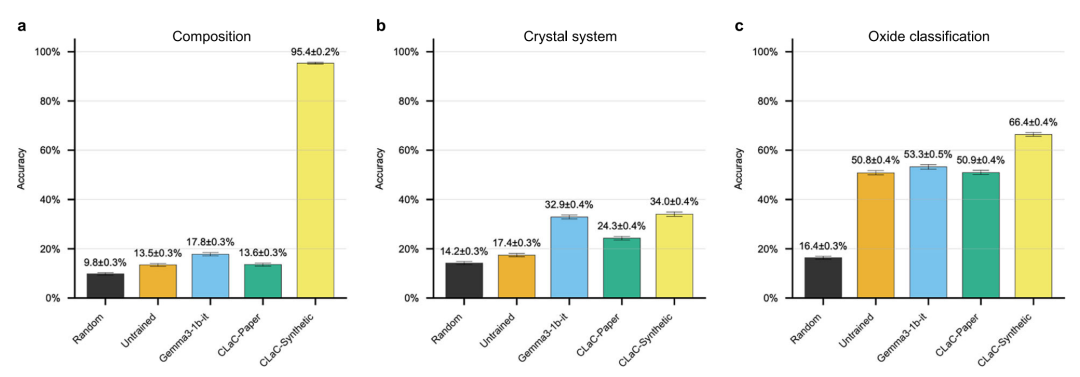
为评估 CLaC 的性能,研究人员设计了多项零样本实验,重点考察模型的晶体理解、自然语言检索及物理属性表征能力,并与未经训练的模型、Gemma-3-1b-it 和 CLaC-Paper 等基线进行比较。
首先,在零样本多模态理解实验中,模型需要根据晶体结构,从多个候选文本中选择正确描述,涉及元素组成、晶系和氧化物类型三类任务。结果显示,CLaC-Synthetic 在元素组成分类中的准确率达到 95.4% ± 0.2%, 显著高于 Gemma-3-1b-it 的 17.8% 和 CLaC-Paper 的 13.6%;氧化物分类准确率达到 66.4% ± 0.4%,同样优于其他模型。
不过,CLaC-Synthetic 在晶系分类中的准确率仅为 34.0% ± 0.4%,与 Gemma-3-1b-it 的 32.9% 接近。这可能与晶系数据分布不均衡、训练批量较小有关,表明模型对晶体对称性等精细几何特征的理解仍然有限。
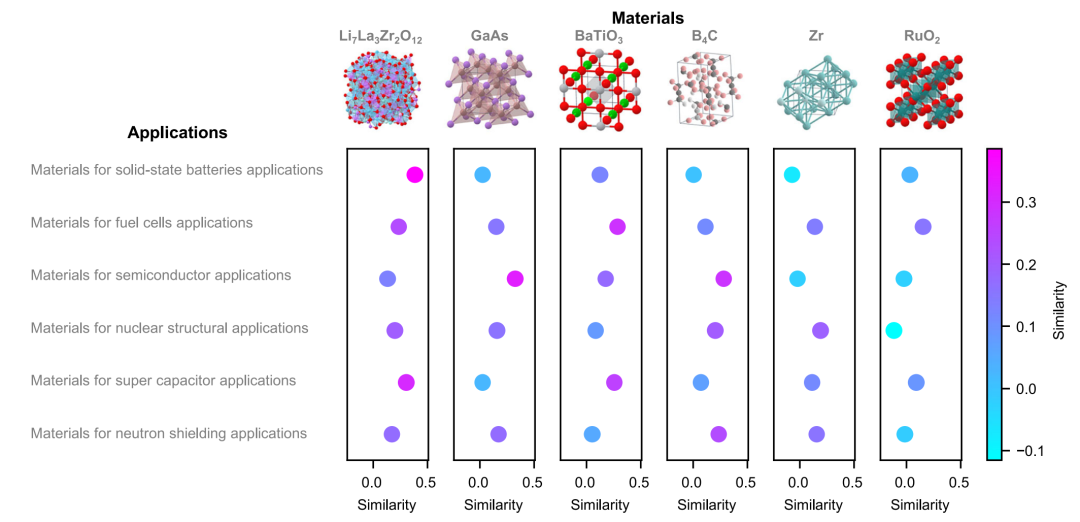
研究人员还选取 Li₇La₃Zr₂O₁₂、GaAs、BaTiO₃ 等六种典型材料,以及固态电池、半导体、超级电容器等六类应用场景,分析材料与应用描述之间的相似度。 结果显示,模型能够识别 Li₇La₃Zr₂O₁₂ 与固态电池、GaAs 与半导体、RuO₂ 与超级电容器等典型关联,说明其表征中包含一定的材料功能与应用知识。
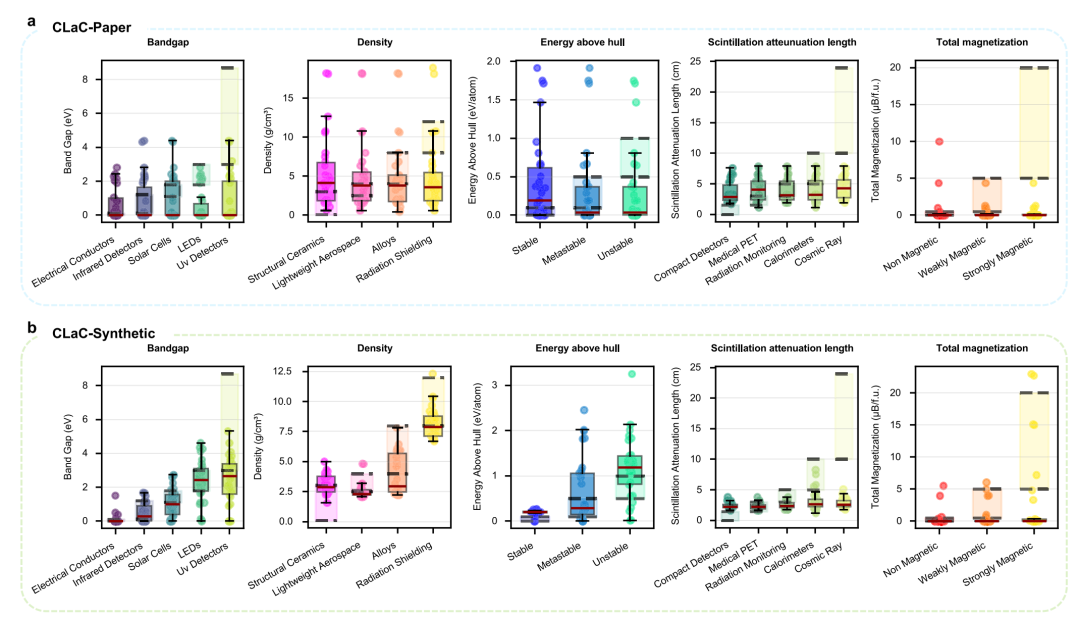
在零样本逆向设计实验中,研究人员将传统属性预测的方向反转,根据目标性能的自然语言描述检索候选材料。实验涉及带隙、密度、凸包能量差、闪烁衰减长度和总磁化强度五项属性。对于每条查询,模型检索相似度最高的前 30 种材料,并通过平均绝对误差(MAE)衡量其真实属性与目标值的差异。
结果显示,CLaC-Synthetic 在五项属性检索中均优于随机基线。 其中,带隙检索的平均绝对误差为 0.641 eV,低于随机检索的 1.185 eV;密度检索分别为 0.799 g/cm³ 和 2.148 g/cm³;闪烁衰减长度检索分别为 1.033 cm 和 2.697 cm。而 CLaC-Paper 的整体表现接近随机选择,说明以计算属性为依据生成的合成叙述,比直接提取的学术文献文本更有利于建立语言与材料属性之间的对应关系。
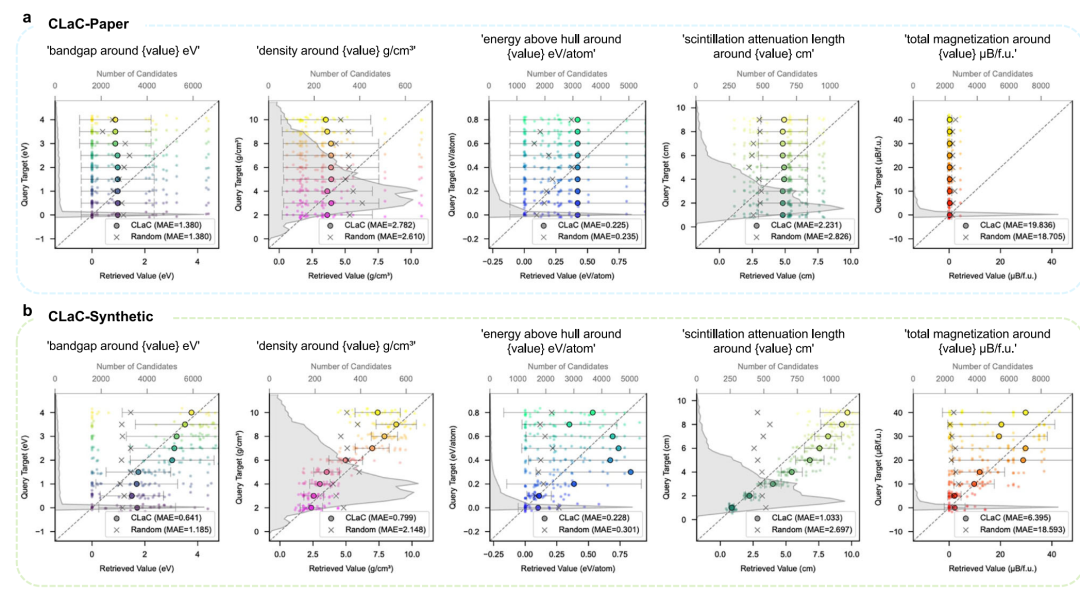
除了精确数值,该研究还测试了「高带隙、低密度、强磁性」等定性描述。结果发现,CLaC-Synthetic 检索材料的属性分布能够随查询语义变化, 例如从低带隙转向高带隙时,候选材料的带隙也相应增大;而 CLaC-Paper 难以形成这种区分,说明合成叙述有助于模型理解定性描述与实际物理属性之间的关系。
在应用验证中,研究人员以固态电池电解质筛选为例,根据含锂材料和高带隙条件进行检索。排名前 30 的候选材料全部含有锂元素,平均带隙为 3.23 eV。其中,排名第四的 Li₆PClO₅ 已在其他研究中被识别为潜在候选材料,排名第九的 Li₄SiO₄ 也曾被制备为固体电解质薄膜。不过,由于训练数据不包含离子电导率信息,现有结果尚不能证明这些材料满足固体电解质的全部性能要求。
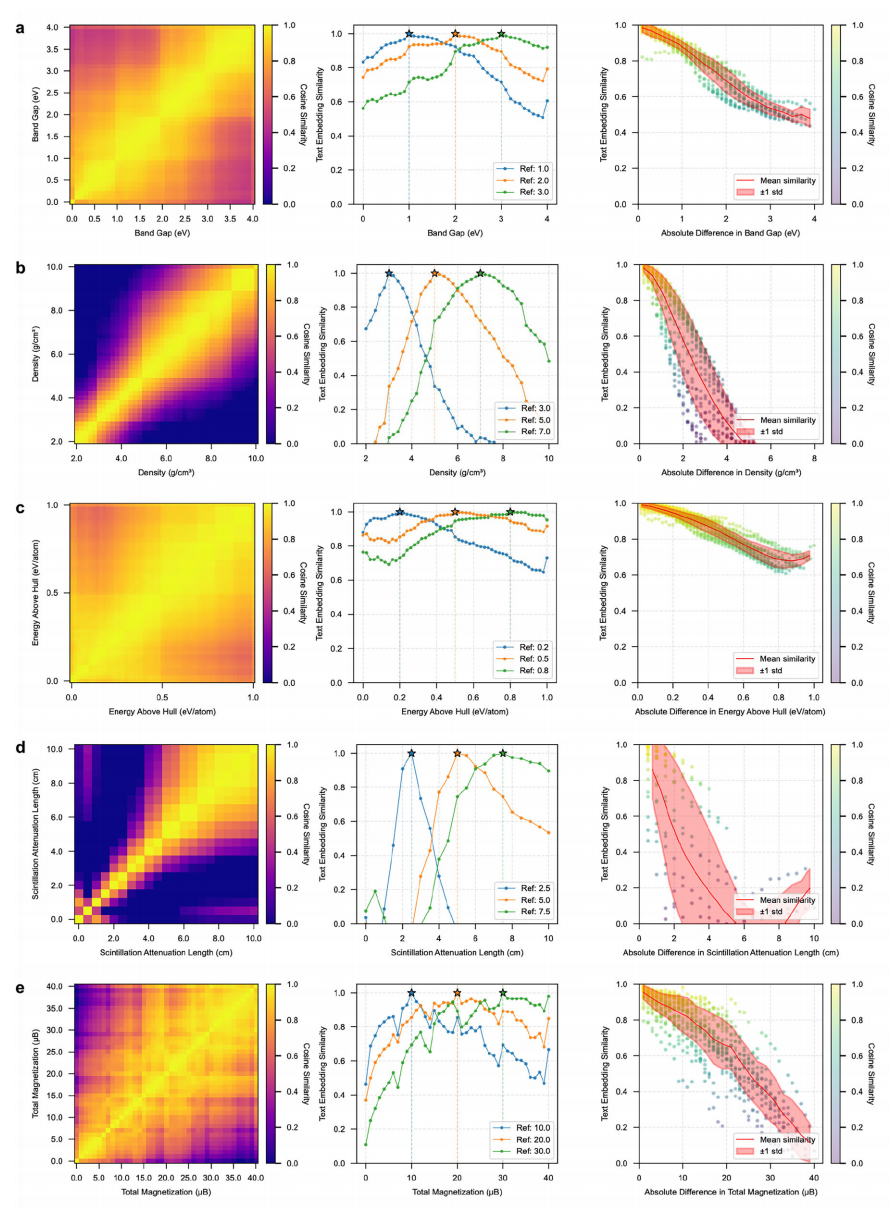
为分析模型如何理解数值信息,该研究进一步考察了文本嵌入空间中的属性连续性。结果显示,CLaC-Synthetic 的向量相似度随属性数值差异增大而逐渐下降。 例如,以 2.0 eV 带隙为参考,当查询值增加至 4.0 eV 时,余弦相似度从 1.0 降至约 0.65,表明模型能够表达物理量的大小关系。其中,密度和闪烁衰减长度的相似度下降较快,对应较高的检索精度;凸包能量差的变化相对平缓,检索误差也更大。相比之下,CLaC-Paper 和未经跨模态对齐的 Galactica-125M 均未表现出清晰的连续数值关系。
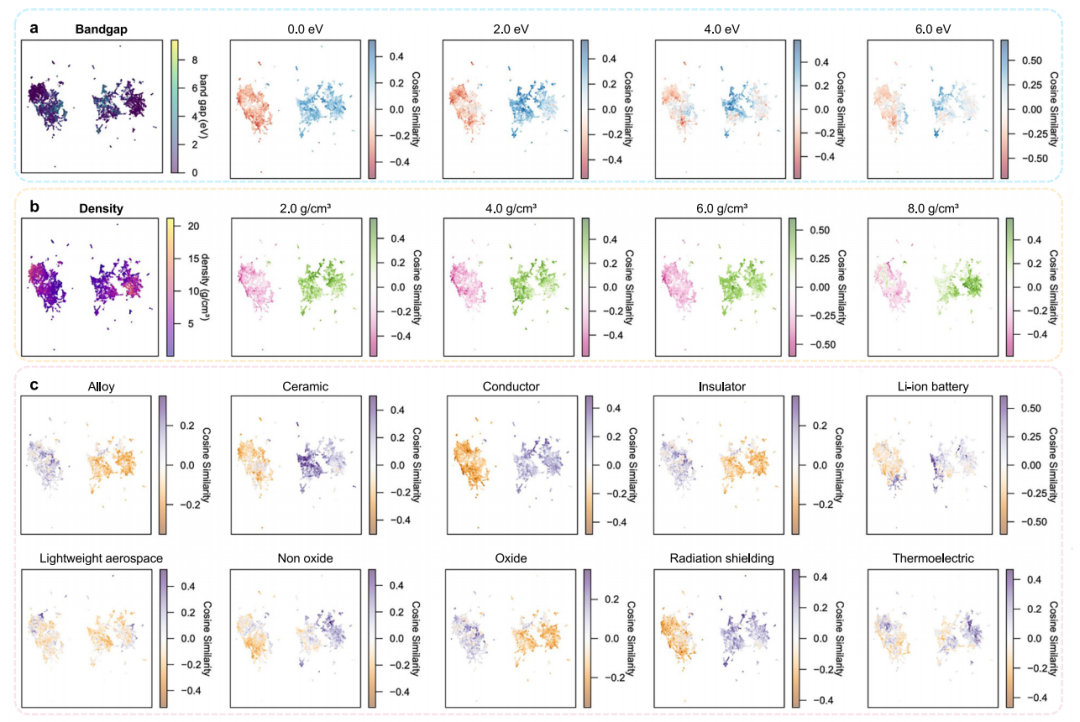
最后,研究人员利用 UMAP 对晶体结构和文本表征的潜在空间进行可视化。 尽管两种模态形成相对独立的聚类,但其材料邻域关系高度一致:晶体图空间中最近的 50 个邻居,平均有 57% 也出现在文本空间对应的最近 50 个邻居中,远高于随机情况下的 0.4%。此外,带隙、密度等物理属性呈现规律性分布,“陶瓷”“导体”“锂离子电池”等描述也对应不同的晶体区域,进一步验证了模型对材料属性及功能类别的跨模态表征能力。
写在最后
CLaC 的研究表明,晶体材料多模态学习的关键不仅在于数据规模,还在于材料属性与自然语言之间能否建立准确的对应关系。通过以计算属性为依据生成合成叙述,CLaC 在零样本材料理解和语言引导检索中取得了优于文献文本训练模型的表现。不过,模型在晶系识别等精细结构任务中仍存在不足,目前也难以处理多晶、缺陷结构及金属有机框架等复杂体系,更无法直接生成新的晶体结构。未来,如何提高合成数据的准确性,扩展模型对复杂材料的适用范围,并将语言检索与晶体生成、物理验证相结合,仍是这类模型走向实际材料设计需要解决的问题。