Command Palette
Search for a command to run...
基于 1 百万物种的百亿级基因数据,英伟达等构建 EDEN 系列模型,基因组与蛋白质预测能力达 SOTA
可编程生物学的根本目标在于对生命系统实现理性设计与精准调控,从而为复杂疾病带来革命性疗法。然而,这一进程长期受限于生物系统的内在复杂性。跨尺度的调控网络、隐藏的长程序列依赖关系,以及生物应对环境变化的多样适应性,都使得传统「试错式」研发陷入定制化、低通量、高成本的困境。
究其根本,当前计算模型所依赖的训练数据,无论规模还是多样性,都远未覆盖生命在数十亿年进化中形成的浩瀚设计空间。这些模型因此难以捕捉到通用设计法则,在面对多模态、跨尺度的创新疗法设计时,泛化能力严重不足。
为突破这一根本性限制,Basecamp Research 、英伟达及多所顶尖学术机构共同开发了 EDEN 系列宏基因组基础模型,通过从海量跨物种、关联环境信息的自然进化数据中学习,首次系统性地提炼出生物设计的深层「语法」与通用原则。该模型参数规模达 280 亿,在多项基准测试中取得了 SOTA,其核心突破在于获得了卓越的跨物种序列理解与生成能力,从而将生物工程从「筛选」推进到「可预测编程」的新阶段。
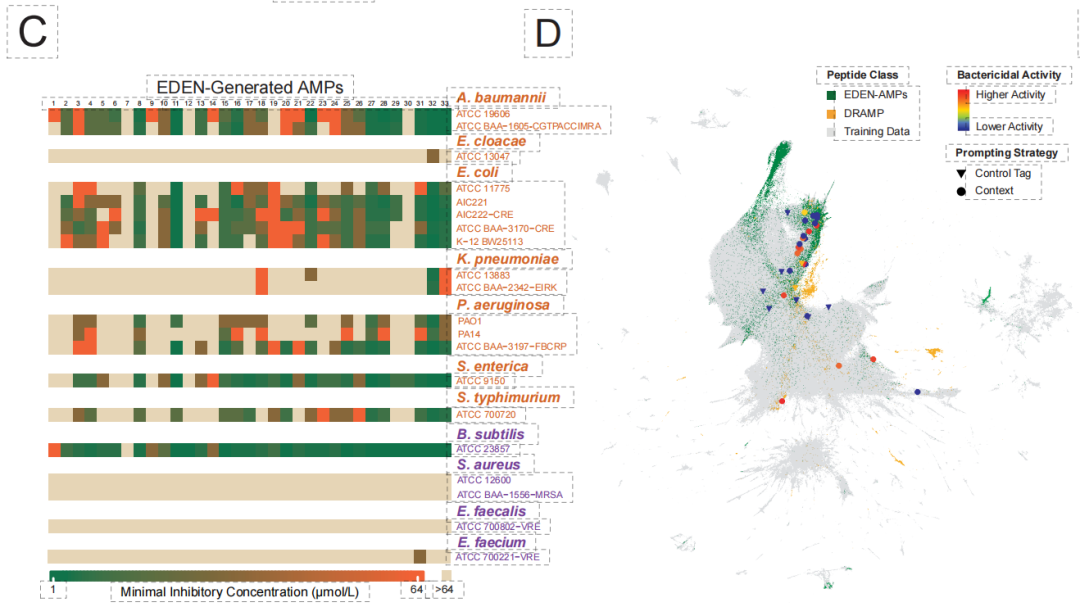
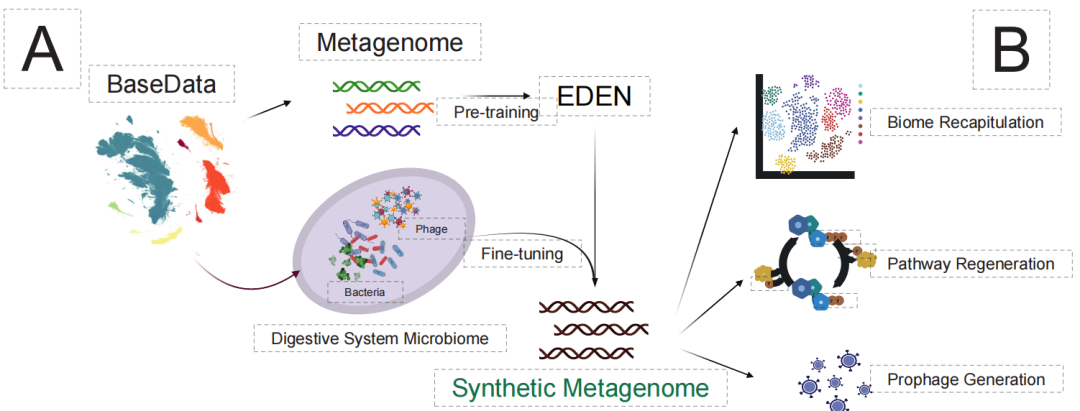
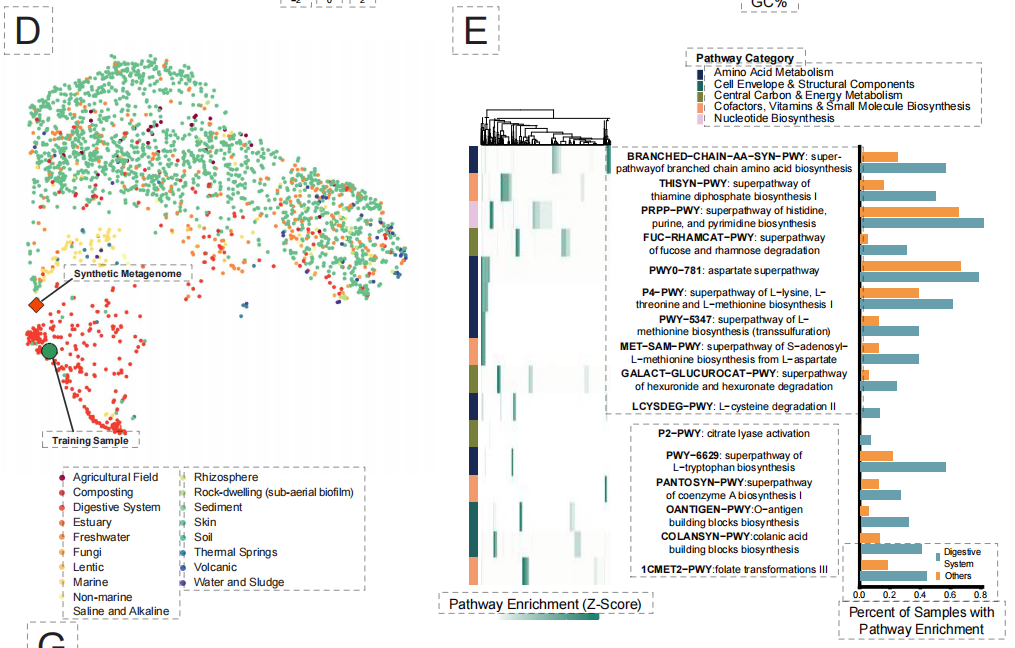
为验证 EDEN 作为统一生物设计引擎的能力,研究团队在多种治疗模式上进行了系统测试。在基因治疗中,仅凭目标位点 30 个碱基的提示,EDEN 即可从头设计出能在人类基因组中精准整合大片段的活性重组酶。在抗菌肽设计方面,同一模型生成的肽库对多重耐药病原体活性高达 97%,且具备微摩尔级效价。在生态系统层面,EDEN 成功构建出包含数万个人工基因组、代谢途径准确且物种关联性合理的合成微生物组。
相关研究成果以「Designing AI-programmable therapeutics with the EDEN family of foundation models」为题,已发表预印本于 bioRxiv 。
研究亮点:
* 开创了从进化历史中直接学习通用设计原则的新范式,利用覆盖全球生物多样性的宏基因组数据库 BaseData 进行训练,获得了卓越的跨物种序列理解与生成能力
* 验证了单一基础模型驱动多尺度、多模态疗法设计的强大通用性,证明一个模型即可统一应对从分子到生态系统的复杂设计挑战。
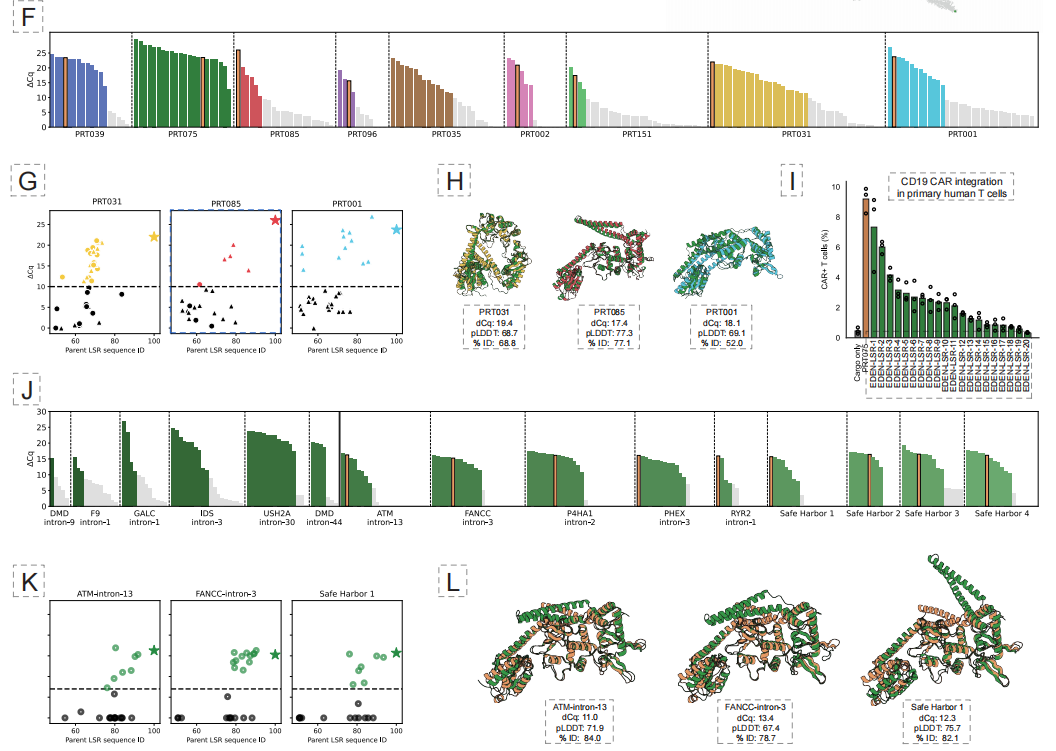
* EDEN 仅凭 DNA 提示,就能为多种疾病相关位点设计出功能性的重组酶,在未经训练的靶点上实现了 63.2% 的功能命中率
 论文地址:
https://doi.org/10.64898/2026.01.12.699009关注公众号,后台回复「EDEN」获取完整 PDF
更多 AI 前沿论文: https://hyper.ai/papers
BaseData 数据集:以高质量长序列重塑生物 AI 数据基准
该研究使用的 BaseData 数据集从根本上突破了传统生物数据库的局限。传统数据库通常依赖有限的参考基因组和碎片化的短序列,而 BaseData 旨在系统性地捕捉完整进化信号,构建了一个覆盖全球生物多样性的进化基因组数据供应链。
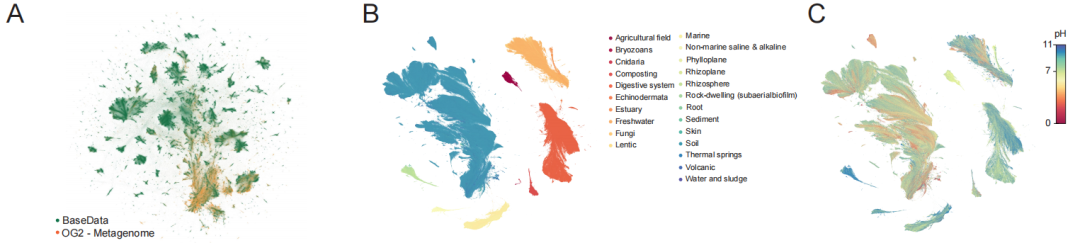
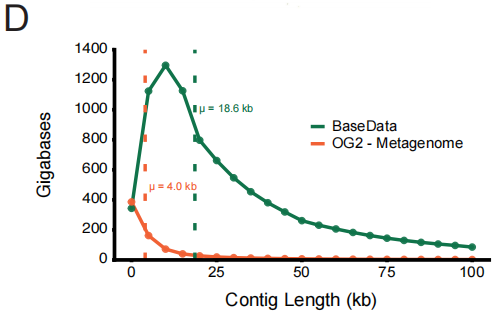
BaseData 的核心价值首先体现在规模与战略性构成上。如下图所示,其包含 9.7 万亿个用于训练的核苷酸标记,涵盖超过 1 百万个新物种和 1 千亿个新基因。更重要的是,其内容并非随机采集,而是刻意富集了环境宏基因组、噬菌体及可移动遗传元件等高信息密度的序列。这些数据天然记录了噬菌体-宿主互作、水平基因转移等关键进化动力,为模型学习跨物种的通用功能规则提供了核心素材。
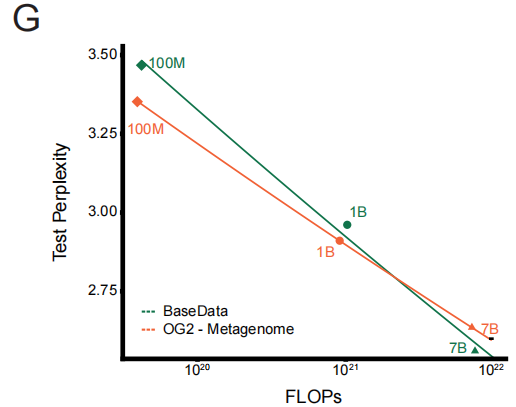
此外,所有数据均通过覆盖 28 个国家、 208 项许可的规范化法律协议获取,建立了从源头到使用的可追溯与利益共享框架,为大规模生物 AI 研究设立了必要的伦理与治理标准。
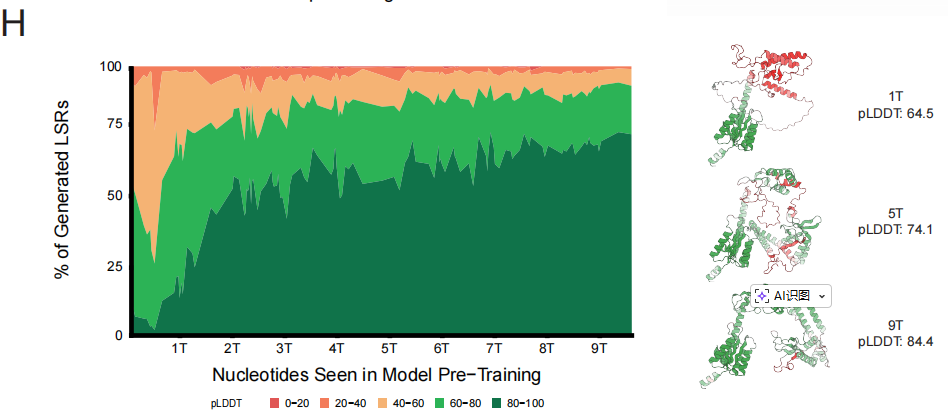
EDEN 模型家族以「规模化、通用性与可扩展性」为核心设计原则,模型参数规模跨越 1 亿至 280 亿。其中,作为核心工作模型的 EDEN-28B,其架构与训练策略均深度适配宏基因组数据的独特性质。
在模型架构上,EDEN 采用了经过大规模语言模型验证的仅解码器 Transformer 架构,具体基于 Llama 3.1 的设计风格。这一选择得益于 Transformer 对长程依赖关系卓越的建模能力。 EDEN-28B 包含 48 层网络,隐藏层维度为 6,144,配备 48 个注意力头,使用 SwiGLU 激活函数与 RoPE 位置编码。模型使用单核苷酸分辨率的标记化方法,词汇表大小为 512,从而能够以最基础的「字母」级别理解和生成 DNA 序列。
一项关键技术亮点在于其长序列生成能力。尽管模型的上下文窗口设定为 8,192 个标记,但在实际应用中,它能够稳定生成并准确拼接超过 13,000 个碱基对的连贯基因组序列,且保持正确的基因顺序、阅读框与调控元件结构。这表明模型所学到的远非局部模式匹配,而是能够推断并应用一套超越物理窗口长度的、更深层的基因组组织「语法」。整个训练在 1,008 个 H100 GPU 上完成,通过大规模分布式计算实现了对海量进化数据的高效学习。
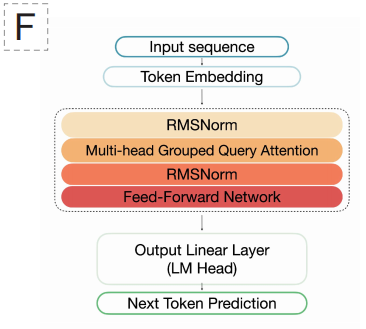
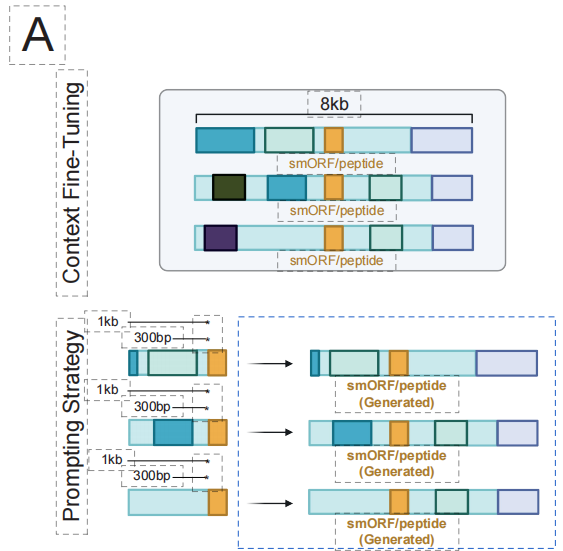
在此坚实基础上,针对特定治疗设计任务——例如设计靶向特定 DNA 位点的重组酶或生成新型抗菌肽——仅需使用少量高质量的任务配对数据进行轻量级微调,即可使模型快速掌握该任务的「方言」。这种设计使单一的 EDEN 模型能够作为一个通用的「生物序列引擎」,灵活适配并驱动从基因插入、多肽设计到微生物组工程等截然不同的治疗模式,真正实现了「一个模型,多重能力」的可编程生物学愿景。
驱动从分子、细胞到生态系统级别的治疗创新
为系统验证 EDEN 模型在实际治疗设计中的通用性与有效性,研究团队选择了在尺度、模式与生物复杂性上截然不同的四个关键方向进行实验验证。
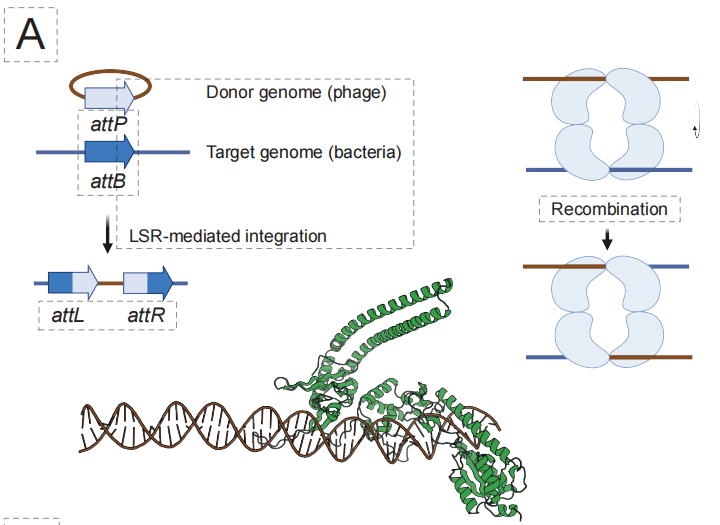
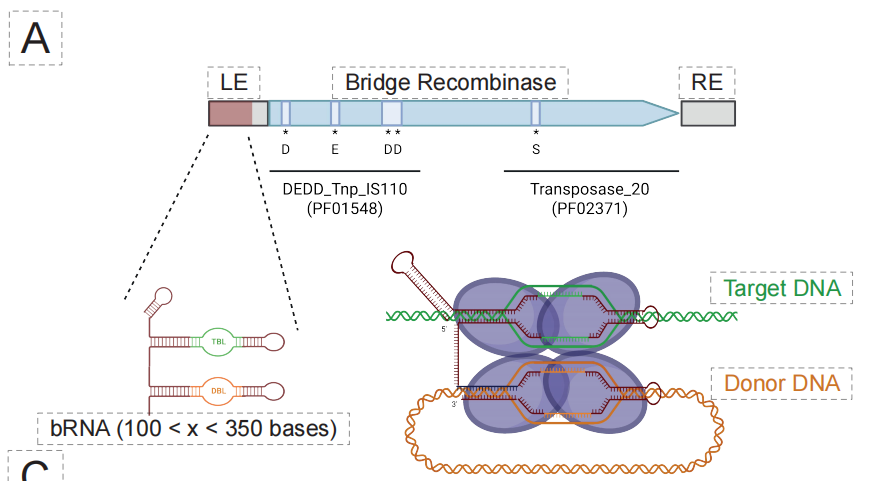
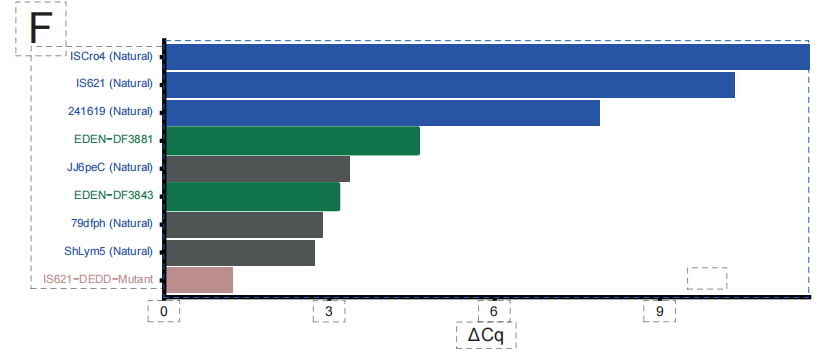
在 AI 可编程基因插入(aiPGI)领域,团队重点攻克了「大片段 DNA 精准整合」这一长期瓶颈。传统 CRISPR 技术依赖造成双链断裂,而天然的大型丝氨酸重组酶无法识别人类基因组序列。如下图所示,EDEN 的解决方案是,通过对模型中蕴含的数百万 LSR‑附着位点配对关系进行微调,构建出能够理解「目标 DNA 序列→对应重组酶」映射关系的 EDEN‑LSR 模型。
AI 与合成生物学的融合创新
近年来,可编程生物学领域在学术界与工业界的融合创新步伐显著加快,一系列重磅进展正在重新定义生物设计的边界。
全球顶尖学术机构正以前所未有的规模和精度,将进化智慧转化为可计算的模型。例如,2024 年初,由 DeepMind 、 Isomorphic Labs 与多所大学组成的联合团队,发布了能同时预测蛋白质结构、相互作用并生成具有特定功能全新蛋白质的 AlphaFold 3 模型。该模型首次将生物分子的复杂共舞纳入统一框架进行高精度模拟,被 Nature 杂志评价为「在绘制生命的分子机器内部运作方式上实现了飞跃」。
产业界则加速将这些突破转化为平台与疗法。在 AI 制药领域,NVIDIA 与 Recursion Pharmaceuticals 发布了生物化学 AI 模型库 BioNeMo,旨在使药物发现从「大海捞针」转向「按图索骥」。合成生物学公司 Ginkgo Bioworks 则利用其自动化平台,系统性设计用于碳捕获和化学品生产的微生物群落,推动「合成生态系统」的工程化。
这股由数据和算法驱动的新浪潮,正推动生物学从观察描述的科学,转变为一门可编写、可调试、可预测的工程学科,不仅意味着我们能够更精准地编写生命代码来攻克疾病,更预示着我们将有能力系统地设计生物系统,以应对资源、环境与健康领域的全球性挑战。
参考链接:
1.https://nvidianews.nvidia.com/news/nvidia-announces-broad-expansion-of-its-biomedicine-platform
2.https://www.ginkgobioworks.com/2024/01/04/ginkgo-bioworks-and-pfizer-expand-collaboration-to-advance-rna-based-therapeutics/