Command Palette
Search for a command to run...
覆盖 2 亿分子质谱图,捷克科学院发布 DreaMS 模型,构建全球最大规模质谱数据集 GeMS
据统计,人类目前所探索的天然小分子化学空间尚不足其总量的 10%,而非靶向代谢组学实验中,超过 90% 的质谱图因缺乏可靠的注释而沦为「数据废墟」。
在这场分子解密的关键战役中,核心挑战在于破解串联质谱(MS/MS)的复杂语言。作为一种现代化学分析的前沿工具,液相色谱—串联质谱(LC-MS/MS)系统通过液相色谱实现分子的高效分离,随后利用碰撞诱导解离技术生成碎片离子的质谱图,这一过程类似于将分子拆解后分析其碎片拼图。
然而,现有的分析工具在拼凑出完整分子图像方面存在显著局限性:即便像先进的 SIRIUS 算法,也因过度依赖有限的光谱库和人工规则,而面对占总量 80% 以上的未知天然分子时,往往面临无库可查的困境。 2023 年发表于《自然・方法》的一项研究指出,全球代谢组学数据库中,仅有 2% 的 MS/MS 谱图得以成功注释,而剩余的 98% 犹如深海中的暗礁,严重阻碍着新药发现与疾病诊断研究的进程。
为了解决这一难题,来自捷克科学院有机化学与生物化学研究所的研究团队,借鉴了 GPT 系列在语言领域取得的突破性进展,致力于为质谱图打造专属的翻译器。研究人员从全球天然产物社交分子网络(GNPS)中挖掘出 7 亿条 MS/MS 谱图,成功构建起史上规模最大的质谱数据集 GeMS,并训练出拥有 1.16 亿参数的 Transformer 模型 DreaMS 。该模型如同让人工智能从零开始学习分子的「破碎语法」,通过预测掩蔽的光谱峰和色谱保留顺序,在未标注的质谱图中成功发现了隐藏的结构规律:其生成的 1,024 维表征向量,能够精准反映分子间的结构相似性,并且对于不同质谱条件下的信号波动展现出强大的鲁棒性。
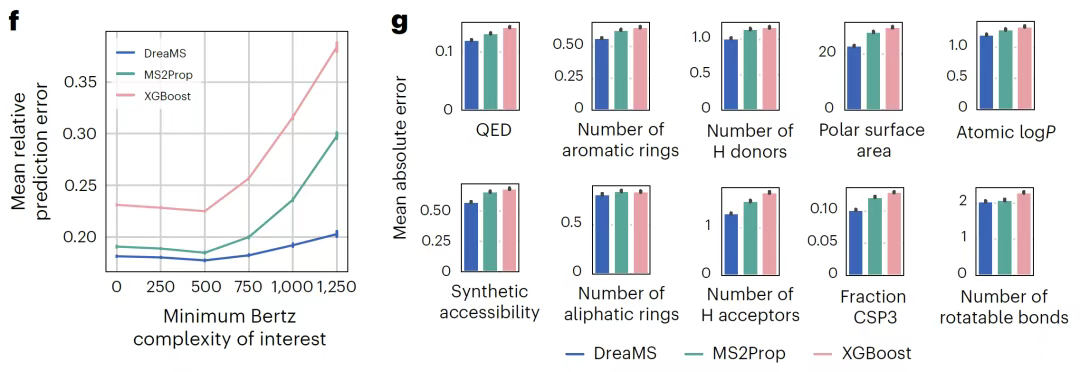
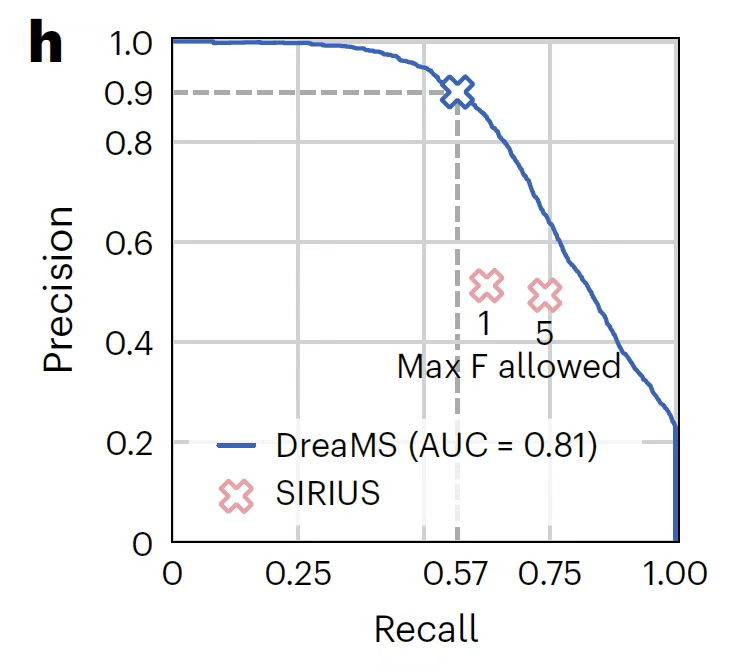
研究表明,经过微调的 DreaMS 在多种质谱注释任务中表现卓越,包括预测光谱相似性、分子指纹、化学性质以及氟元素的存在等,均超越了传统算法和近期开发的机器学习模型。更令人瞩目的是,DreaMS 图谱已整合 2.01 亿条谱图,构建起涵盖细菌、植物、人体代谢物的超级分子网络,为化学界打造了一部能够实时更新的「分子百科全书」,为相关领域的研究与应用提供了极具价值的资源。
相关研究成果以「Self-supervised learning of molecular representations from millions of tandem mass spectra using DreaMS」为题,已发表于国际权威期刊 Nature Biotechnology 。
 论文地址:
更多 AI 前沿论文:
GeMS 化学质谱数据集下载地址: https://go.hyper.ai/IC2yw
GeMS 数据集:7 亿光谱构建超大规模质谱数据库
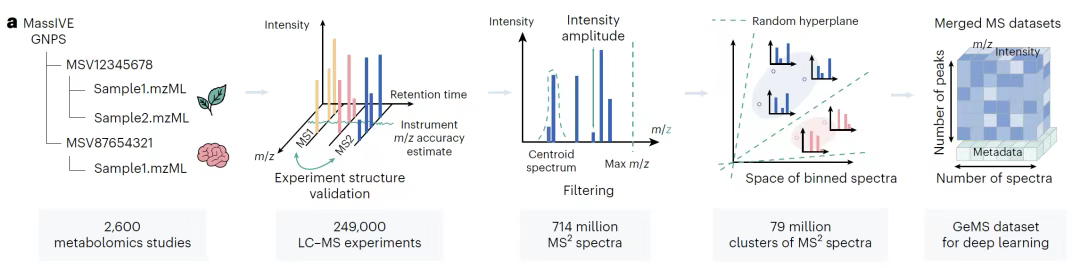
该研究构建的核心数据基础是从 MassIVE GNPS 存储库深度挖掘的 GeMS 数据集,其规模与质量在代谢组学领域具有突破性意义。
GeMS 化学质谱数据集下载地址: https://go.hyper.ai/IC2yw
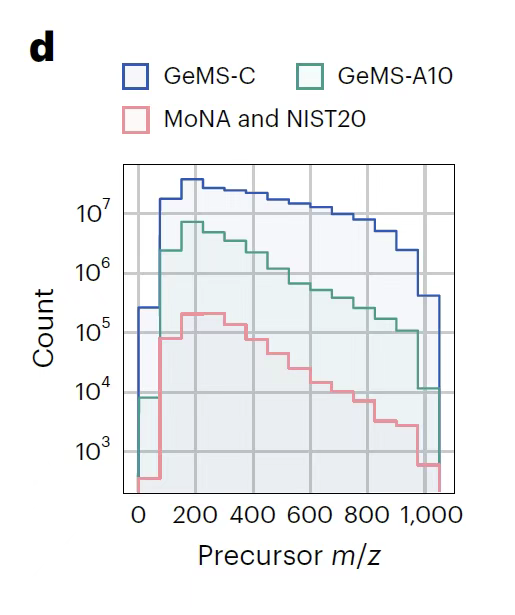
如下图所示,研究团队整合了 25 万个涵盖生物与环境领域的 LC-MS/MS 实验数据,从中提取约 7 亿条 MS/MS 光谱,并通过严格的质量控制算法将其划分为 GeMS-A 、 GeMS-B 、 GeMS-C 三个子集。其中,GeMS-A 以 97% 的 Orbitrap 质谱仪采集光谱为主,代表最高质量标准;GeMS-C 则纳入 52% Orbitrap 与 41% QTOF 光谱,在保证一定质量的同时大幅扩展数据规模。这种分层设计既保留了高精度仪器数据的可靠性,又通过包容性更强的子集覆盖更广泛的质谱技术来源,确保数据集的多样性。
DreaMS 模型:基于自监督 Transformer 的质谱解析新范式
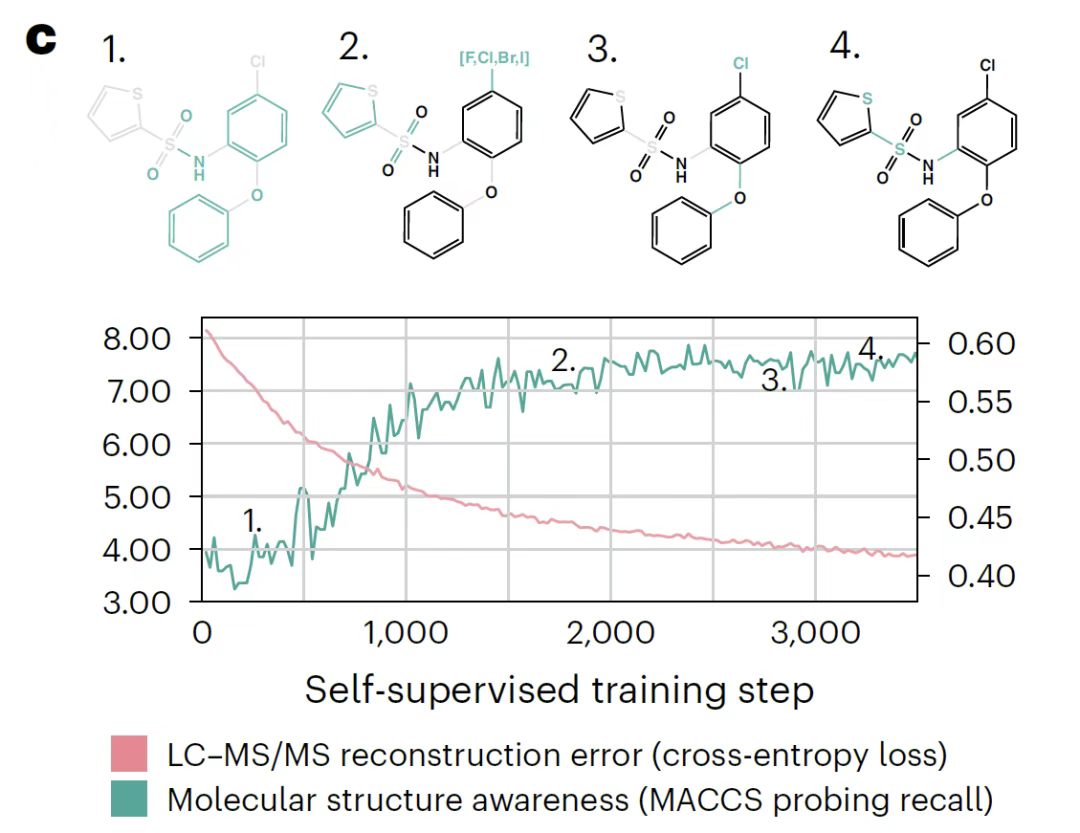
基于 GeMS 数据集,DreaMS 模型旨在通过自监督学习从未标注的 MS/MS 光谱中提取分子表征。该模型借鉴自然语言处理中的 BERT 架构,开创了小分子质谱领域的自监督学习范式。其核心设计包括双重训练目标:一是对光谱内 30% 的质荷比(m/z)进行与强度成比例的随机掩蔽,并训练模型重建掩蔽峰,同时引入「母离子标记」聚合光谱级信息(类似语言模型的句子级表征);二是通过同一 LC-MS/MS 实验的光谱对,学习预测色谱洗脱顺序,强化分子结构与出峰规律的内在关联。
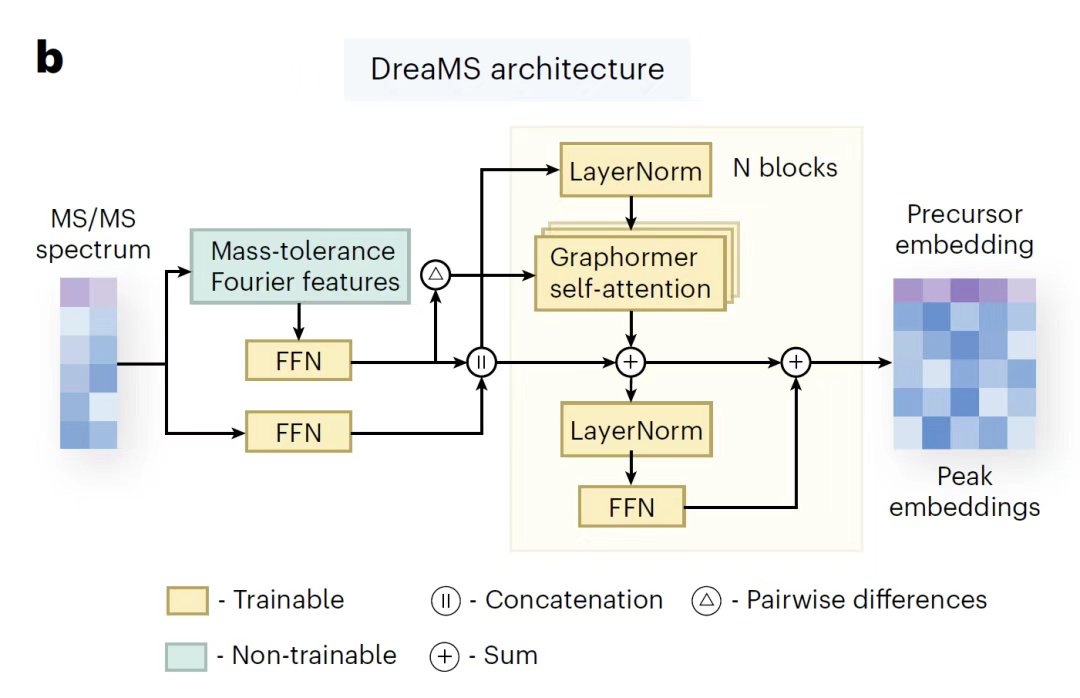
在模型架构方面,如下图所示,DreaMS 基于 7 层 Transformer 编码器,配备 8 头自注意力机制,可生成 1,024 维表征向量。针对高分辨率质荷比数据,模型采用傅里叶特征(Fourier features)预处理技术,将连续质量值分解为正弦/余弦频率分量,捕捉整数与浮点部分的细节,并通过前馈网络进一步关联元素组成预测;强度值经浅层网络处理后与傅里叶特征拼接,作为 Transformer 输入。此外,DreaMS 显式引入所有峰对的傅里叶特征差异至自注意力头(借鉴 Graphormer 架构),直接建模中性损失关系,避免额外标记或复杂计算。
DreaMS 模型跨任务迁移:质谱分析从单分子解析到全代谢组互联
DreaMS 模型作为首个基于自监督学习的质谱解析基础模型,在跨任务迁移能力上展现出显著优势。研究团队将其适配于四大核心任务:
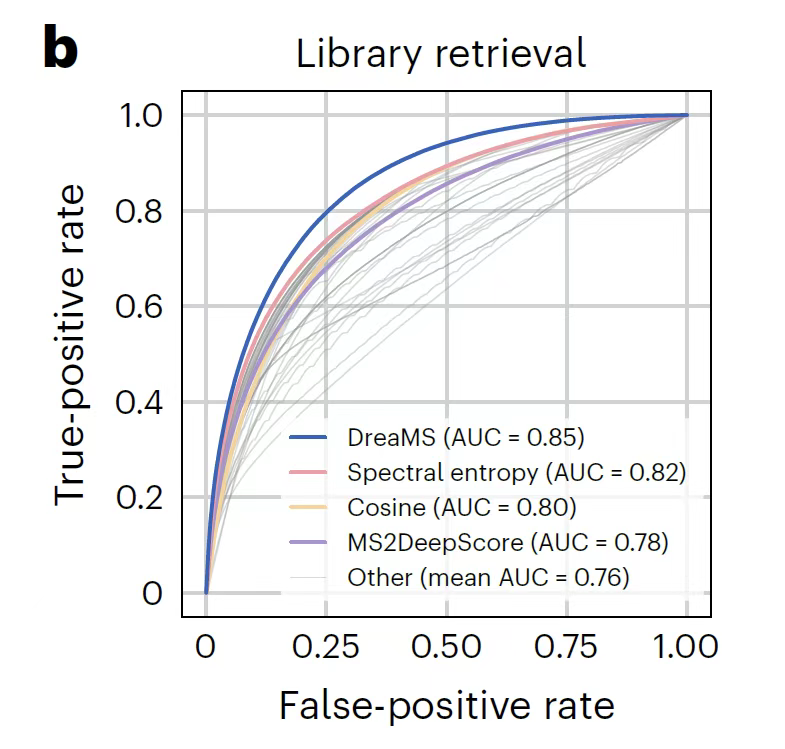
在光谱相似性分析中,如下图所示,模型首先通过自监督表征实现零样本匹配,其嵌入空间余弦相似性与分子结构相似性的相关性(如 Tanimoto 系数)超越了需依赖标注数据训练的监督算法 MS2DeepScore;针对零样本对分子结构细微差异不敏感的局限,通过设计包含参考光谱、同分子正样本与近质量负样本的三元组难例进行对比微调,使前体质量偏差在 10ppm 内的检索任务中,微调后的 DreaMS 显著优于 44 种传统相似性度量,且嵌入结果对质谱仪器差异具备更强鲁棒性,UMAP 分析显示其表征空间严格按分子化学式与结构基序聚类。
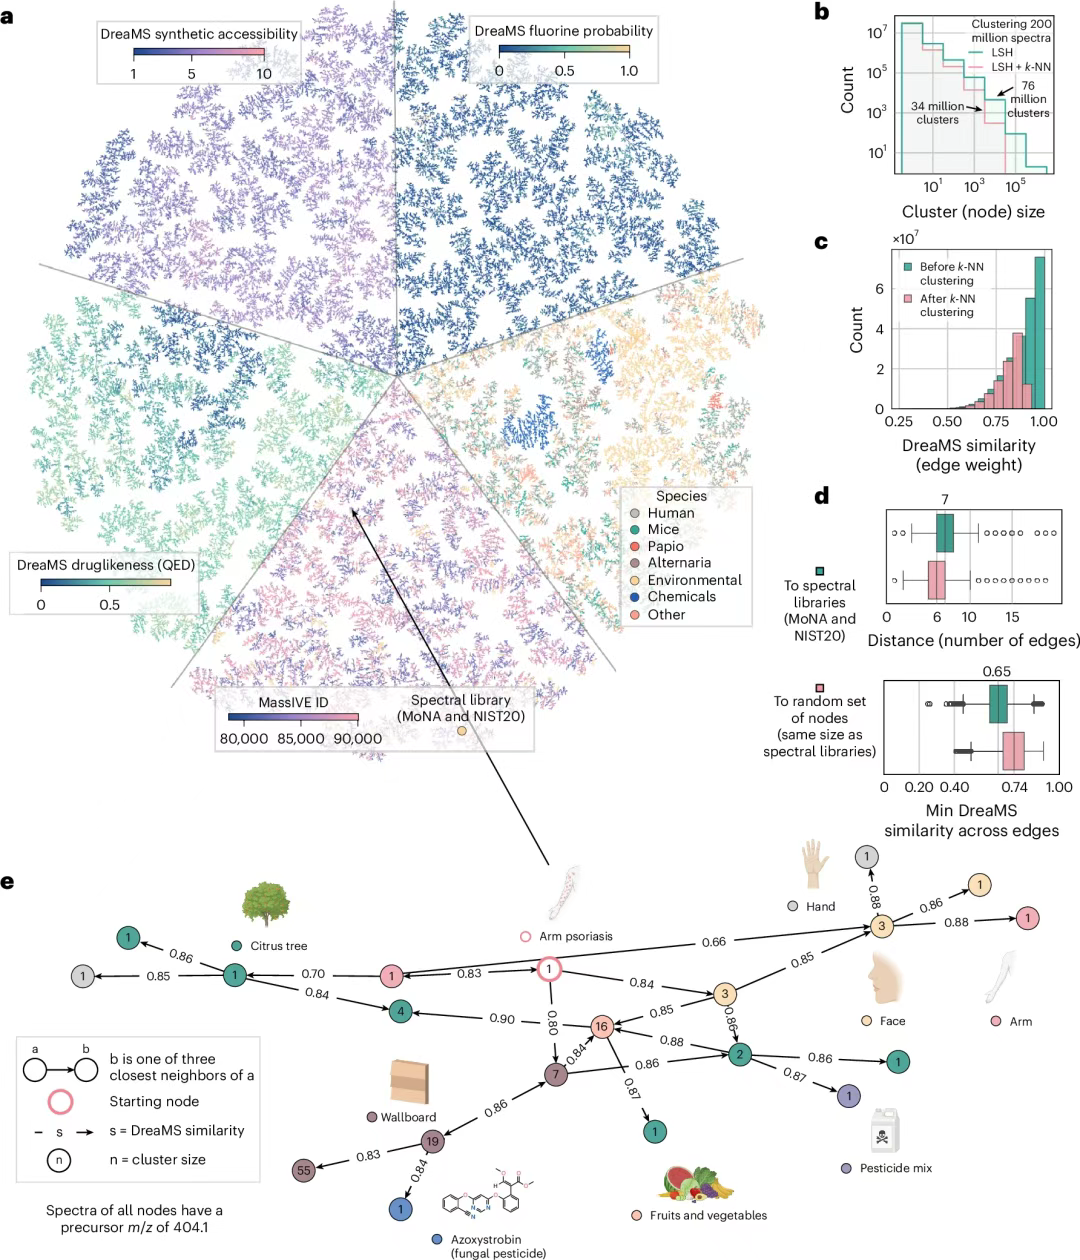
在手臂银屑病代谢组研究中,如下图 e 所示,图谱通过光谱连通性揭示了疾病与杀菌剂吡唑醚菌酯的潜在关联,关联路径涉及污染食物、处理树木等环境暴露源,为复杂疾病病因探索提供了全新数据驱动视角。这种从单任务精准注释到全库网络推断的能力,标志着质谱解析技术从「单分子解码」迈向「全代谢组互联」的新时代。
产学研协同,驱动质谱解析技术革新
在小分子质谱解析与代谢组学研究领域,全球高校与企业正以创新技术推动该领域的突破。
在高校研究方面,中国清华大学胡泽平实验室开发的 AI 辅助多组学大数据分析技术,结合高精准代谢组学方法,成功揭示了肿瘤微环境中神经元与癌细胞的代谢互作机制,发现了可作为治疗靶点的神经递质调控通路,其成果多次被 Nature 系列期刊专题评述。中国科学院大连化物所研发的「CataAI 表征专家系统」,通过将深度学习技术融入质谱数据分析流程,利用自建数据库与新算法,实现了从质谱图到分子结构的智能推荐,并针对能源催化材料的复杂表征数据,开发了双阶段神经网络模型。
美国加州大学圣地亚哥分校(UCSD)的全球天然产物社交分子网络(GNPS)平台,作为本文所述研究的 DreaMS 模型核心数据集 GeMS 的来源,持续推动跨机构质谱数据共享与整合。其最新研究通过乙醇与甲醇溶剂体系的对比,建立了高通量肠道微生物组代谢组学分析方法,为解析宿主 – 微生物互作机制提供了标准化流程。
在企业创新实践中,美国公司安捷伦推出了 Pro iQ 系列等新一代液质检测系统,具有卓越的性能和灵敏度,是复杂生物分子监测和杂质检测的理想之选。其质量范围扩大至 m/z 2–3000,并通过安捷伦喷射流离子源(AJS)技术提高了灵敏度,支持小分子和大分子的常规和痕量检测,为食品安全监管提供了颠覆性技术手段。中国企业凯莱谱科技依托液相色谱串联质谱技术,自主研发的 20 余款临床质谱试剂盒产品,覆盖 300 余个检测项目,其中血液和尿液中儿茶酚胺代谢物的检测试剂已写入中华医学会内分泌学会专家共识,成为临床金标准。
总的来说,当前小分子质谱解析与代谢组学研究领域,正经历着一场由高校和企业共同引领的技术革新。这些创新不仅在理论上深化了人类对生物体系复杂性的理解,更是在实际应用中展现出了巨大的潜力,从癌症早期诊断到心血管疾病预后预测,从催化材料研发到食品安全监管,这场由算法创新与实验科学共振引发的革命,或将彻底重构从基础研究到临床应用的全链条生态,为相关领域带来更为深远的影响。
最后给大家推荐一个活动,HyperAI 超神经将于 7 月 5 日在北京举办第 7 期 Meet AI Compiler 技术沙龙。我们有幸邀请到了来自 AMD 、北京大学、沐曦集成电路等多位资深专家,欢迎大家点击下方链接报名~
https://www.huodongxing.com/event/1810501012111
参考文章:
1.https://mp.weixin.qq.com/s/1QUjLMtj_6ui9T0gbuZtrA
2.https://dicp.cas.cn/xwdt/ttxw/202411/t20241107_7435521.html
3.https://ccms-ucsd.github.io/GNPSDocumentation/
4.https://mp.weixin.qq.com/s/Wgh2w0G76koqc9AY0PBHcg