Command Palette
Search for a command to run...
登 Cell 子刊!清华大学张强锋课题组开发 SPACE 算法,组织模块发现能力领先同类工具
多细胞生物中的细胞尽管共享相同的基因组,但因其内部基因调控网络的差异以及与周围微环境中相邻细胞的外部信号交流,使得它们在形态、基因表达和功能上展现出显著的多样性。为了将细胞类型信息与其在组织内的空间位置相关联,空间转录组学 (Spatial Transcriptomics,简称 ST) 技术应运而生。该技术既能获得高分辨率的转录组数据,还能和位置信息相对应,确定不同细胞亚型或转录状态在空间上的分布和位置关系,对于重新认知生命结构、个体发育、生命演化以及定义疾病具有关键性作用。
近年来,随着空间转录组学技术的不断发展,研究者能够在单细胞分辨率下获得细胞的基因表达谱,同时保留细胞在组织内的空间位置信息。如何有效地利用这些空间信息来识别空间细胞亚型并发现组织模块,成为空间转录组数据分析的核心任务。
当前,空间转录组数据分析面临以下两方面难题:第一,对于空间细胞类型的识别,许多研究仅使用细胞基因表达谱而忽视细胞的空间位置信息。近年来的研究表明,原本被认为是同质性的细胞类型,根据其在组织中的位置,可以进一步细分为多个亚型。第二,对于组织模块的发型,由于构成组织的不同细胞的基因表达特征可能高度异质化,之前的分析方法未能充分利用单细胞分辨率空间转录组数据中细胞类型的异质性。
基于此,清华大学生命科学学院/结构生物学高精尖创新中心/清华-北大生命科学联合中心张强锋副教授课题组,近日在 Cell Systems 杂志在线发表题为「Tissue module discovery in single-cell resolution spatial transcriptomics data via cell-cell interaction-aware cell embedding」的研究论文。
该研究开发了基于图自编码器 (Graph autoencoder) 深度学习框架的人工智能算法 SPACE (spatial transcriptomics data analysis via「interaction-aware」cell embedding),能够从单细胞分辨率的空间转录组数据中识别空间细胞类型和发现组织模块,可被用于大规模的空间转录组研究。
研究亮点:
* 开发了空间转录组数据人工智能分析工具 SPACE,可从单细胞分辨率的空间转录组数据中,识别空间细胞类型并发现组织模块
* SPACE 在细胞类型识别和组织模块发现方面明显优于其他工具,尤其是在包含多种细胞类型的复杂组织中
* SPACE 可用于大规模的空间转录组研究,以了解空间邻近细胞之间的相互作用如何影响细胞类型和组织模块生物学功能
 论文地址:
https://www.cell.com/cell-systems/fulltext/S2405-4712(24)00124-8
开源项目「awesome-ai4s」汇集了百余篇 AI4S 论文解读,并提供海量数据集与工具:
https://github.com/hyperai/awesome-ai4s
数据集:多数据集验证 SPACE 能力
为了验证 SPACE 的能力,研究中用到了多个数据集,汇总如下:
数据集下载地址: https://go.hyper.ai/CBJfX
MERFISH 小鼠 PMC 数据集
对于 MERFISH 小鼠 PMC 数据集,从 Brain Image Library 获得对数转换的标准化细胞-基因矩阵,然后移除标记为「其他」的细胞或位于主样本区域外的细胞。
数据集链接:
STARmap 小鼠 PLA 数据集
对于 STARmap 小鼠 PLA 数据集,标准化的细胞-基因矩阵由原始论文提供并进行了对数转换。
数据集链接:
https://drive.google.com/file/d/1DDCowUuZ7PPFUSZsjvSqntWkYJMjf1Na/view?usp=sharing
MERFISH 小鼠 AB 数据集
对于 MERFISH 小鼠 AB 数据集,从 CELL x GENE 库获得基因计数矩阵。每个细胞的总计数标准化为 10,000,然后对标准化的细胞-基因矩阵进行对数转换。
数据集链接:
https://cellxgene.cziscience.com/collections/31937775-06024e52-a799-b6acdd2ba2e
MERFISH 小鼠 WB 数据集
对于 MERFISH 小鼠 WB 数据集,从 GitHub 库获得对数转换的标准化细胞-基因矩阵。
数据集链接:
https://github.com/AllenInstitute/abc_atlas_access
Xenium 人类 BC 数据集
对于 Xenium 人类 BC 数据集,从 10x genomics 网站获得基因计数矩阵。每个细胞的总计数标准化为 10,000,然后对标准化的细胞-基因矩阵进行对数转换。
数据集链接:
https://www.10xgenomics.com/products/xenium-in-situ/preview-dataset-human-breast
CosMx 人类 NSCLC 数据集
对于 CosMx 人类 NSCLC 数据集,从 nanoString 网站获得对数转换的标准化细胞-基因矩阵。
数据集链接:
https://nanostring.com/products/cosmx-spatial-molecular-imager/ffpe-dataset/nsclc-ffpe-dataset
Visium 人脑数据集
对于 Visium 人脑数据集,基因计数矩阵使用 Bioconductor 包 spatialLIBD 获得。使用 python 包 SCANPY(v1.9.1)的 scanpy.pp.highly_variable_genes() 函数(flavor = “seurat_v3”)在 Visium 人脑数据集的每个样本中识别出前 3,000 个高度可变基因。然后每个细胞的总计数标准化为 10,000,对标准化的细胞-基因矩阵进行对数转换。
数据集链接:
https://bioconductor.org/packages/release/data/experiment/html/spatialLIBD.html
模型架构:基于细胞-细胞相互作用感知的细胞嵌入的模型
SPACE 使用图自编码器 (Graph autoencoder) 框架来学习低维的细胞嵌入,该细胞嵌入描述了空间转录组数据中每个细胞自身的基因表达信息以及其与空间邻近细胞的相互作用信息(因此称该细胞嵌入为细胞-细胞相互作用感知的细胞嵌入,cell-cell interaction-aware cell embedding)。在该细胞嵌入基础上,SPACE 再通过聚类算法识别空间细胞亚型和发现组织模块。
从架构来看,SPACE 模型由三部分组成:编码器 (三层图注意网络) 、邻近图解码器和基因表达解码器,下图显示了该模型的整体框架:
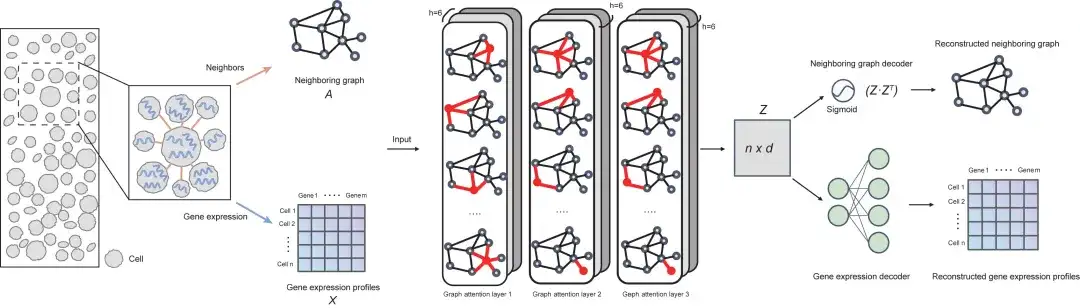
为了训练 GAE 模型,SPACE 采用自监督学习,旨在最小化基因表达谱和邻接图的总重构损失。学习到的细胞表示随后可以使用各种聚类算法进行细胞类型识别和组织模块发现。
先前开发的深度学习工具使用了图卷积网络 (GCN) (例如,SpaGCN 、 SpaceFlow 、 GraphST 和 SEDR) 或图注意自动编码器 (例如,STAGATE) 来生成「邻域感知」嵌入,这些嵌入通过聚合分析细胞及其邻近细胞的基因表达谱来发现组织模块。 SPACE 主要从以下三个方面区别于这些工具:
第一,SPACE 需要从相同的低维细胞表示中重构基因表达谱和邻接图(通过两个独立的解码器)。这种设计使得 SPACE 能够记住分析细胞及其各个邻近细胞的基因表达谱和空间交互关系。相比之下,其他方法尽管将邻接图作为输入,但并不重构图。为了强调这一区别,本研究称 SPACE 生成的细胞嵌入为「细胞-细胞相互作用感知的细胞嵌入」。
第二,SPACE 定义了一个感知域比例,用于确定基因表达谱和邻接图重构损失的相对权重。这一可调比例使 SPACE 能够根据特定研究需要调整学习重点,强调每个分析细胞的基因表达谱或空间邻近细胞的相互作用。
第三,SPACE 还在 GAT 编码器中使用注意力机制,在邻域信息聚合过程中自适应地学习每个邻域的权重。这种方法自动考虑了不同邻域在基因表达谱重构过程中的各自贡献。
研究结果:SPACE 在细胞类型识别和组织模块发现方面优于其他同类工具
使用多个空间转录组数据集对 SPACE 进行测试,证明 SPACE 发现的细胞群落与人工标注的组织结构在空间分布特征上相似。
评估 SPACE 识别空间信息细胞类型的能力
研究最初使用 MERFISH 描述的小鼠初级运动皮层 (PMC) 的 ST 数据集 (从切片 153 开始) 来研究 SPACE 识别细胞类型的能力。结果显示,SPACE 识别的细胞类型与原始研究中报告的细胞类型很好地匹配,如下图所示;此外,SPACE 还为某些细胞类型 (如星形胶质细胞和少突胶质细胞) 提供了更高分辨率的细胞类型标注。
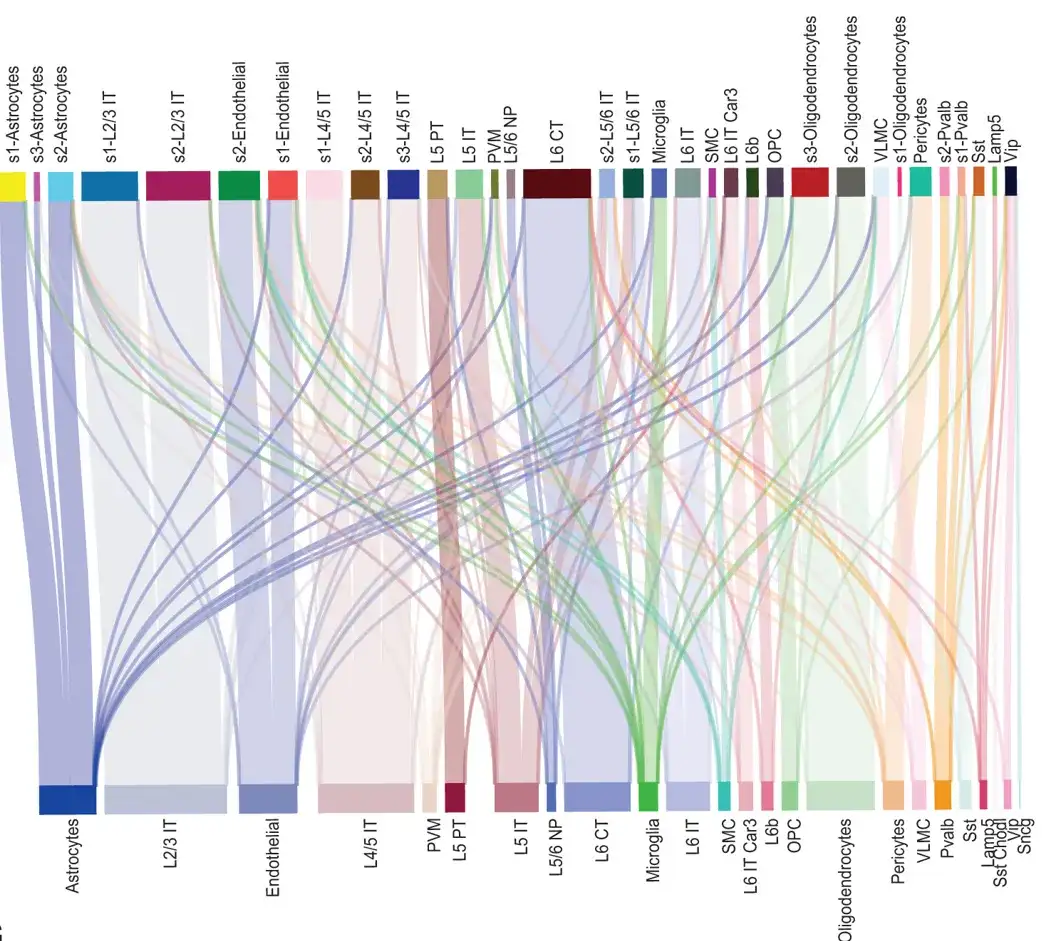 桑基图展示了 MERFISH 小鼠 PMC 数据集的第 153 片中,所有细胞的空间信息中,相关细胞类型与原始细胞类型之间的对应关系
接着,研究人员进一步聚焦已鉴定的星形胶质细胞 (皮质层中的神经胶质细胞) 和少突胶质细胞 (中枢神经系统的髓鞘细胞) 亚型。星形胶质细胞曾被认为是一种同质细胞类型,但最近的 ST 研究报告称,它们在不同的大脑区域具有不同的功能。
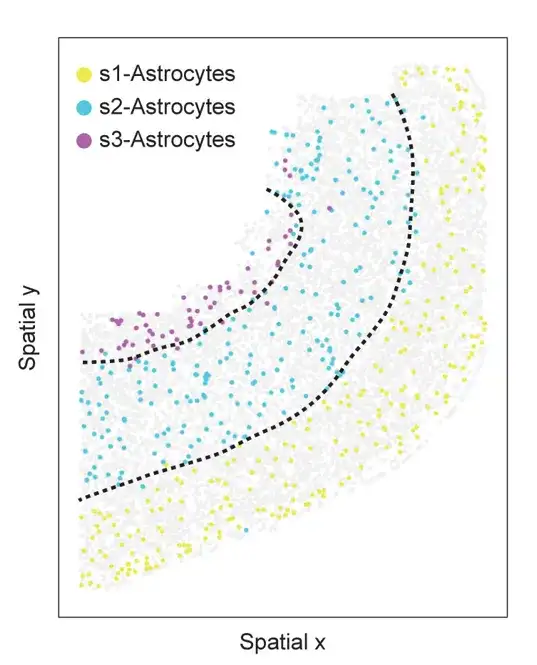 MERFISH 小鼠 PMC 数据集中第 153 片的空间信息相关的星形胶质细胞亚型。细胞按星形胶质细胞亚型进行着色,浅灰色点表示其他细胞。虚线表示上层、深层和白质
试验中,SPACE 在 PMC 切片 153 中发现了三种不同的亚型,如上图所示,每种亚型在空间上分布在不同的皮质层中。类似于星形胶质细胞,SPACE 还将少突胶质细胞分类为三种具有不同空间分布模式的空间信息亚型。

综上所述,基于不同 ST 方法和组织的两个独立数据集的分析支持了以下结论:SPACE 能够基于 ST 数据集中的空间信息识别出空间信息具有生物学差异的细胞类型。
评估 SPACE 在细胞类型识别中的表现
研究人员将 SPACE 与目前用于从空间转录组学数据中识别细胞类型的两种工具 BANKSY 和 FICT 进行了比较,这两种工具除了基因表达外,还考虑了空间信息。在分析中,研究人员还加入了 SCANPY,一种广泛用于细胞类型识别的工具,尽管它仅考虑基因表达。
为了进行比较,研究人员使用了前面提到的 MERFISH 小鼠 PMC 数据集和 STARmap 小鼠 PLA 数据集。如下图显示,SPACE 能够识别不同的空间信息星形胶质细胞和少突胶质细胞亚型,但 SCANPY 和 FICT 都无法定义具有皮质层分辨空间分布模式的星形胶质细胞和少突胶质细胞亚型。
对于 STARmap 小鼠 PLA 数据集,虽然 SPACE 和 BANKSY 成功识别了两种糖原滋养层细胞亚型,但 SCANPY 和 FICT 未能识别糖原滋养层细胞亚型,这可能是由于两种糖原滋养层细胞亚型之间的周围细胞类型存在明显差异。
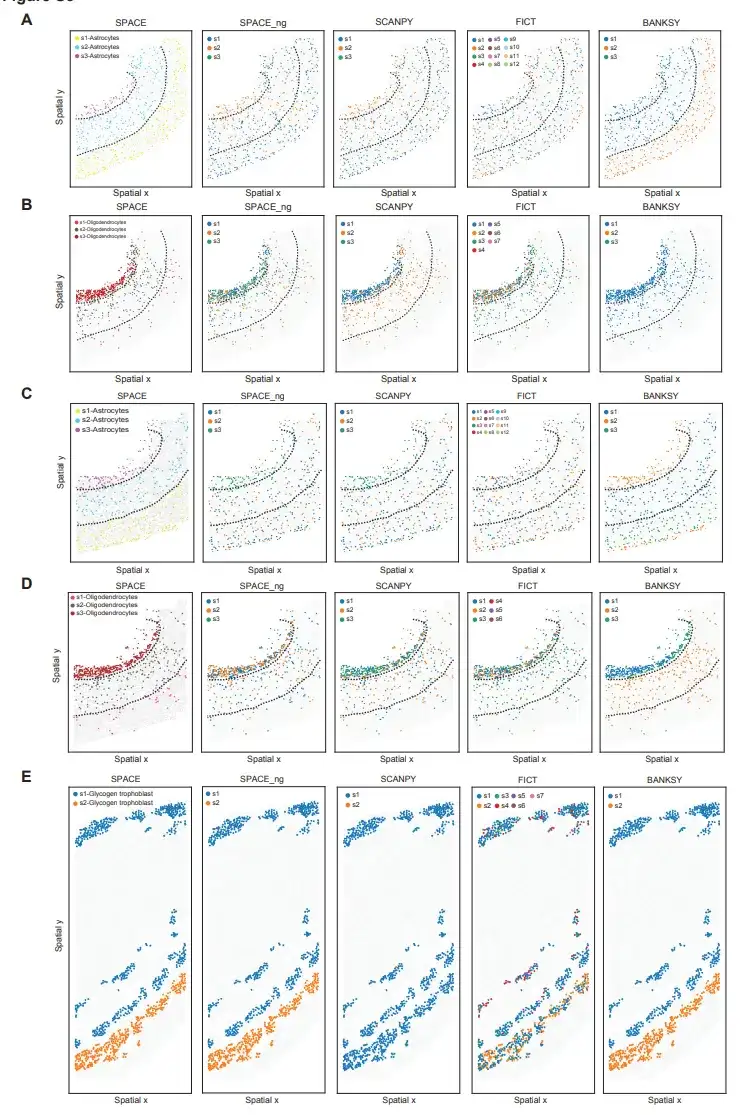
SPACE 在组织模块发现方面优于最先进工具
空间转录组学研究的一项重要任务是发现给定组织中的组织模块。为了评估 SPACE 在这方面的能力,研究人员将 SPACE 与 SEDR 、 SpaGCN 、 STAGATE 、 BANKSY 、 SpaceFlow 、 GraphST 、 Schürch 等人的方法,以及 SCANPY 和 SPACE_ng 进行了比较,并使用了两个前述的 ST 数据集 (MERFISH 小鼠 PMC 数据集和 STARmap 小鼠 PLA 数据集),以及三个具有标注组织模块的附加数据集,包括 MERFISH 小鼠老化大脑 (AB) 数据集、 MERFISH 小鼠整个大脑 (WB) 数据集和 Xenium 人类乳腺癌 (BC) 数据集, 这些数据集代表了从不同组织、不同条件下获得的 ST 数据。
总体而言,SPACE 在 5 个数据集中的 2 个表现远超其他竞争工具,并在其他 3 个数据集中的表现几乎与表现最佳的工具相当(相对于各自最佳的工具),如下图所示:
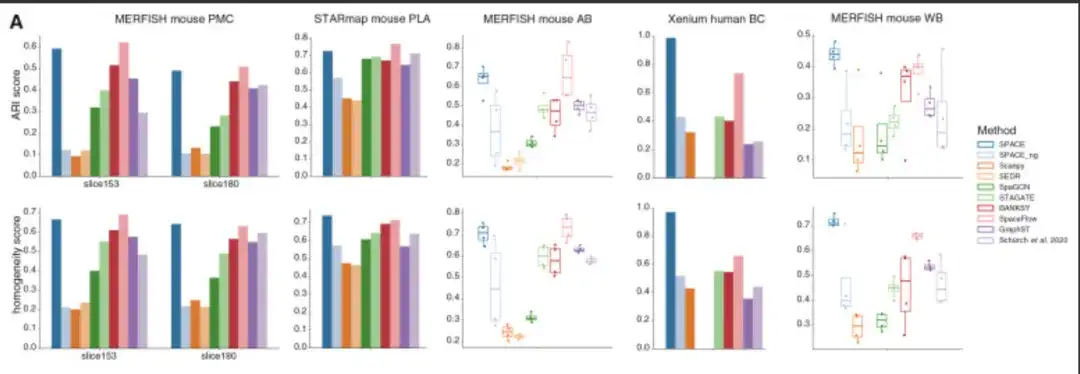
破除空间转录组数据分析的挑战
空间转录组技术是生物信息学领域近年来的重大突破之一,2020 年被 nature method 评为年度技术。该技术通过同时测量大量细胞的空间位置和细胞内的转录组计数,弥补了单细胞测序技术难以测量单个细胞之间位置关系的缺陷,从而为理解多细胞之间的相互作用提供了全新的数据基础——发展针对空间转录组数据的基础分析方法是当前生物信息学领域的前沿问题之一。
细胞空间定位信息与其分子特征谱的耦合产生了新型的多模态高通量数据资源,这对高效的数据分析与信息挖掘方法的开发提出了许多挑战,而人工智能则为解决这些挑战提供了新的思路。
 2022 年 7 月,上海交通大学电子信息与电气工程学院自动化系沈红斌教授、 袁野副教授课题组在 Nature 子刊 Nature Computational Science 上发表了题为:「Cell clustering for spatial transcriptomics data with graph neural networks」(利用图神经网络对空间转录组数据进行细胞聚类)的研究论文。
论文链接:https://www.nature.com/articles/s43588-022-00266-5
论文提出了一种基于图卷积神经网络的空间转录组细胞聚类方法(Cell Clustering for Spatial Transcriptomics,CCST),为处理空间转录组数据提供了新方案,具有被应用于生命医药科学中多层次基础问题研究的潜力,包括建模基因表达的空间分布、分析细胞动力学以及发现关键细胞亚型相互作用及其分子机制等。
2023 年 4 月,约翰斯·霍普金斯大学 (Johns Hopkins University) 的研究团队开发了 SpaceMarkers,这是一种生物信息学算法,可以利用 ST 数据的潜在空间分析,推断出细胞间相互作用的分子变化。研究人员使用这种方法来推断转移、侵袭性和前驱病变以及免疫治疗的 Visium 空间转录组学数据中肿瘤免疫相互作用的分子变化。
该研究以「Uncovering the spatial landscape of molecular interactions within the tumor microenvironment through latent spaces」为题发布在 Cell Systems 。
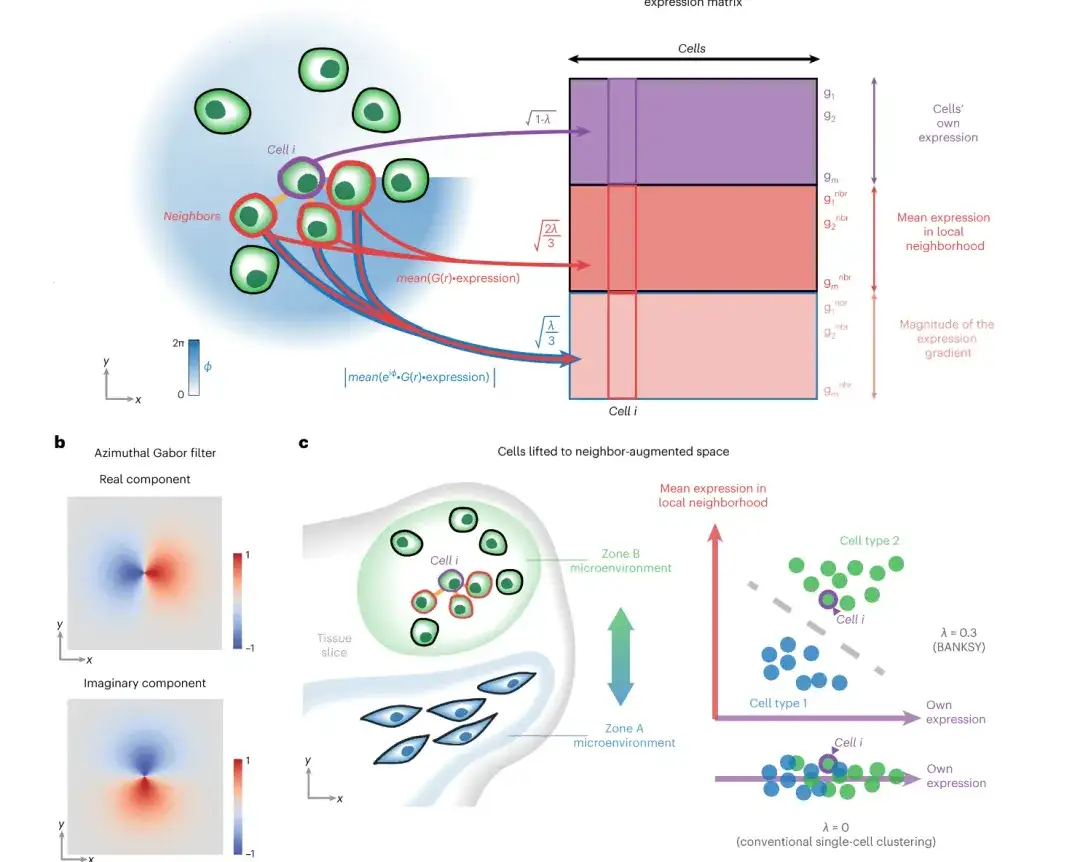
今年 4 月,一篇发表在国际杂志 Nature Genetics 上题为「BANKSY unifies cell typing and tissue domain segmentation for scalable spatial omics data analysis」的研究报告中,来自新加坡 A*STAR 研究所等机构的科学家们通过研究报道了一种名为 BBANKSY 的算法 (Building Aggregates with a Neighborhood Kernel and Spatial Yardstick),该算法作为一种创新的空间组学数据分析工具,其主要功能是将空间组学数据中的细胞根据类型和组织域进行有效分类。
论文链接:https://www.nature.com/articles/s41588-024-01664-3
参考资料:
1.https://www.cell.com/cell-systems/fulltext/S2405-4712(24)00124-8#secsectitle0030
2.https://www.tsinghua.edu.cn/info/1175/112190.htm
3.https://news.bioon.com/article/367a820e60b9.html
4.https://www.sohu.com/a/677912398_12