Command Palette
Search for a command to run...
整合蛋白序列/三维结构/功能特征等数据,德国团队基于度量学习构建构建人类 E3 泛素连接酶「全景图」
生物体中,细胞蛋白的及时降解与更新是维持蛋白稳态的关键。泛素-蛋白酶体系统(UPS)是调控信号传导和蛋白质降解的核心机制。在这一系统中,E3 泛素连接酶作为关键催化单元,负责识别特定底物并催化泛素标记,从而调控蛋白降解、定位和功能状态。此外,E3 连接酶还调控免疫和炎症通路。由于其组织特异性表达及与发育和代谢综合征(包括癌症进展)的关联,E3 连接酶已成为很有前景的药物靶点,尤其适用于以往难以药物化的靶标。
与 E1(约 10 种)和 E2(约 50 种)酶相比,人类已鉴定出大量 E3 连接酶(约 600 种)。尽管如此,许多人类 E3 连接酶仍仅被部分表征,仍有大量酶处于假设或未知状态。迄今为止,已研究的 E3 连接酶表现出高度异质性,使其成为最具多样性的酶类之一,为模式识别和大规模研究带来瓶颈。因此,对人类 E3 连接酶组——即人类基因组编码的全部 E3 连接酶进行详细表征和分析,对于全面理解其生物学功能至关重要。
在此背景下,来自德国歌德大学的研究团队对「人类 E3 连接酶组(human E3 ligome)」进行了分类,整合了多层次数据,包括蛋白序列、结构域组成、三维结构、功能以及表达模式。该团队的分类方法基于度量学习(metric-learning)范式,采用弱监督的层级框架,以捕捉 E3 家族及亚家族间的真实关系。这一方法扩展了 E3 酶的传统分类(RING 、 HECT 和 RBR 类),区分了多亚基复合物与单体酶,并将 E3 酶映射到底物及潜在药物作用靶点。
相关研究成果以「Multi-scale classification decodes the complexity of the human E3 ligome」为题,已刊登 nature communications 。
研究亮点:
* 将现有 E3 连接酶的结构域架构、三维结构、功能、底物网络及小分子相互作用映射到分类框架中,以获得一般性及家族特异性洞察
* 所开发的多尺度分类框架涵盖了典型及非典型 E3 机制,为理解 E3 连接酶的广阔生物学图景提供了完整路线图
* 为开发 E3-底物网络的药物干预策略打开了新思路
 论文地址:
https://www.nature.com/articles/s41467-025-67450-9
关注公众号,后台回复「E3 酶」获取完整 PDF
更多 AI 前沿论文: https://hyper.ai/papers
数据集:构建人类 E3 泛素连接酶数据
研究团队首先整合了来自 8 个独立数据源的人类 E3 泛素连接酶数据,包括既往文献报道和公共数据库(E3Net 、 UbiHub 、 UbiNet 2.0 、 UniProt 、 BioGRID 等),形成初步数据集共计 1,448 个蛋白条目。通过对各来源数据的交叉比对与一致性评分,去除了重复和潜在假阳性条目。随后,利用 InterPro 提供的 RING 、 HECT 和 RBR 催化结构域特征,筛选出 462 个高置信度的催化 E3 泛素连接酶,形成最终的人类 E3 连接酶组。
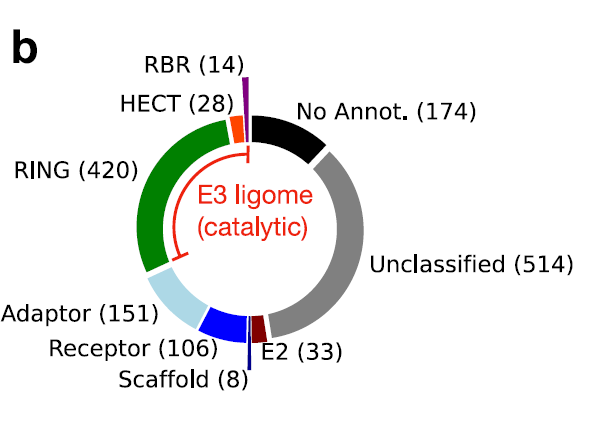
在多亚基 E3 复合物(如 Cullin-RING ligases)中,三个功能不同的子单元(支架蛋白、适配蛋白和受体蛋白)协同工作,将 E2~Ub 分子定位到特定底物上。大型、刚性且位于中心的支架蛋白(如 Cullin 家族,Cul1–Cul5)通过同时结合催化 RING 指结构域亚基和适配蛋白/受体的对接位点,组织起整个连接酶复合体;适配蛋白桥接各模块,将支架蛋白 N 端对接面与独立的底物受体相连;受体蛋白决定底物特异性,直接识别并结合底物上的降解信号(degron),确定哪些底物会被泛素化(如 Skp2 、 Keap1 、 VHL)。研究团队独立注释并分类了三类亚基:151 个适配蛋白、 106 个受体蛋白和 8 个支架蛋白,并利用它们的蛋白–蛋白相互作用(PPIs)绘制多亚基 E3 的底物映射。
随后,在催化结构域筛选阶段,研究人员以催化能力为核心判据,对候选蛋白进行严格过滤。通过 InterPro 等结构域数据库,系统识别与 E3 活性直接相关的关键催化结构域,包括 RING 、 HECT 和 RBR 。仅保留明确包含这些结构域、且在序列和结构层面支持其泛素连接功能的蛋白,构建最终的「催化型 E3 连接酶」。这一过程有效剔除了仅参与调控、但不具备直接催化能力的辅助蛋白,从而保证了核心 E3 集合的功能一致性。
基于度量学习的多尺度分类框架
为了捕捉人类 E3 连接酶组中的复杂关系,研究人员采用机器学习方法来学习一个 Emergent 距离度量,整体框架如下图:
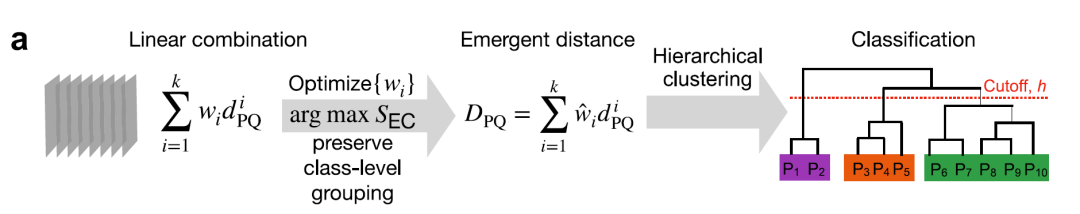
研究人员通过计算 12 种不同的距离来编码 E3 连接酶两两之间的关系,这些距离覆盖多个粒度层次:一级序列、结构域架构、三级结构、功能、亚细胞定位以及细胞系/组织表达。所有距离度量均被缩放至 [0,1] 区间,以便比较和组合,见下图:
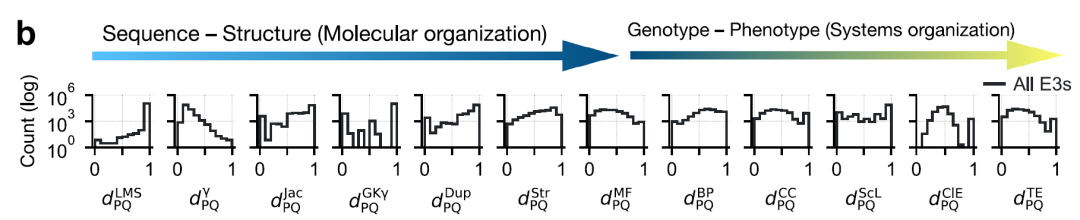
* 结构域架构层面:计算了三种距离——Jaccard 距离、 Goodman–Kruskal γ 距离和结构域重复距离
* 三维结构层面:使用 AlphaFold2 模型 TM-score
* 功能层面:蛋白对 P 和 Q 的功能距离使用 GO 注释的语义相似性衡量,涵盖* 分子功能(MF)、生物过程(BP)和细胞组分(CC)三类本体
* 亚细胞定位距离
* 组织和细胞系共表达距离
②度量优化、聚类、自助法与分类
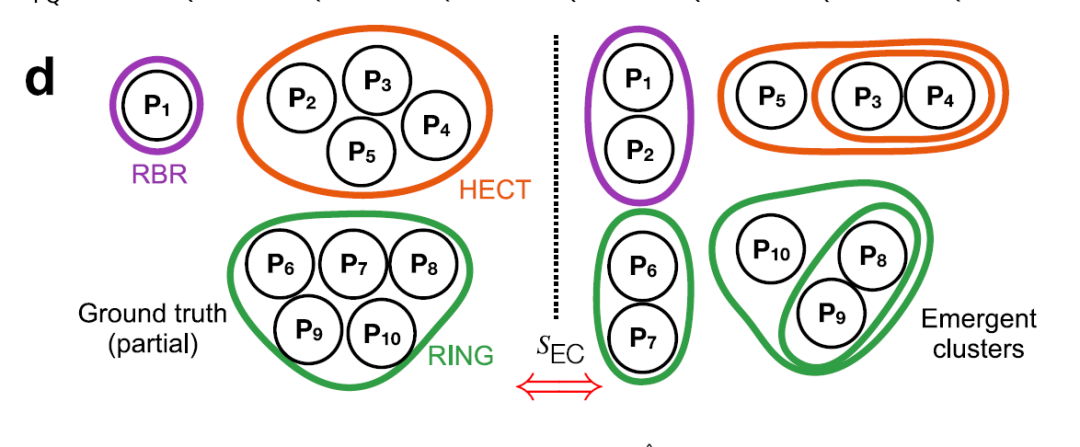
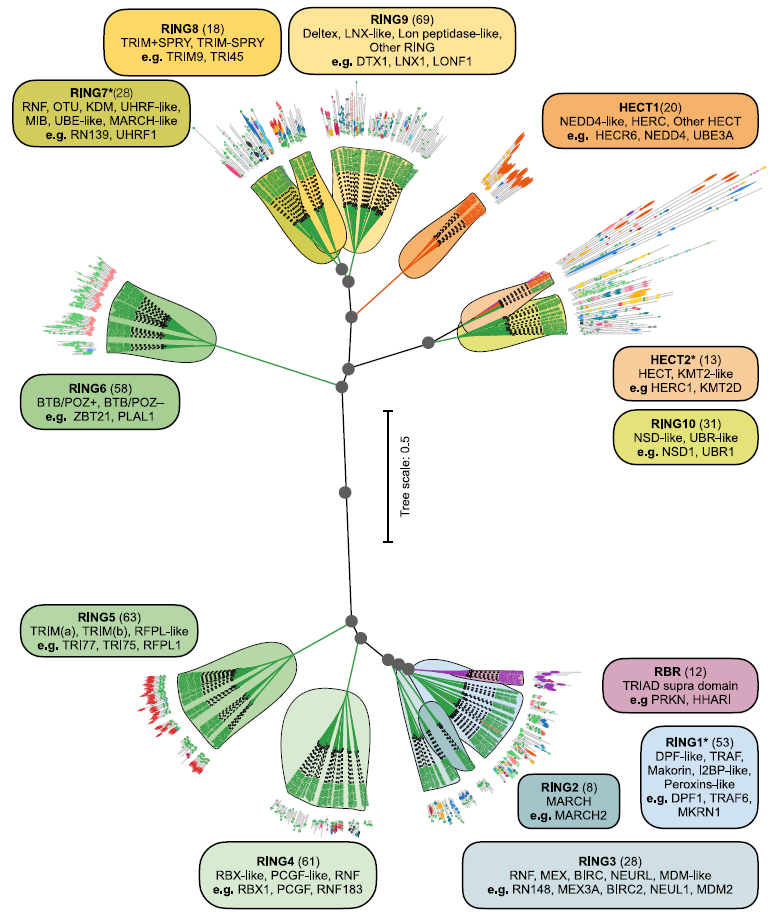
四个主要距离(γ、 Jaccard 、结构、分子功能)通过加权和整合,权重通过弱监督学习和元素中心相似指数(SEC)优化,如下图 ,得到最优组合指标。
③小分子聚类与结合概率
整合的 2D UMAP 投影用于小分子聚类,结合局部密度峰值识别 20 个代表性小分子簇。通过 log-transformed propensities(LPij)量化每个簇与 E3 蛋白的结合可能性,为后续 PROTAC 开发和靶向小分子设计提供指导。
对人类 E3 连接酶组的完整性提供了详细评估
①精细整理人类 E3 连接酶组
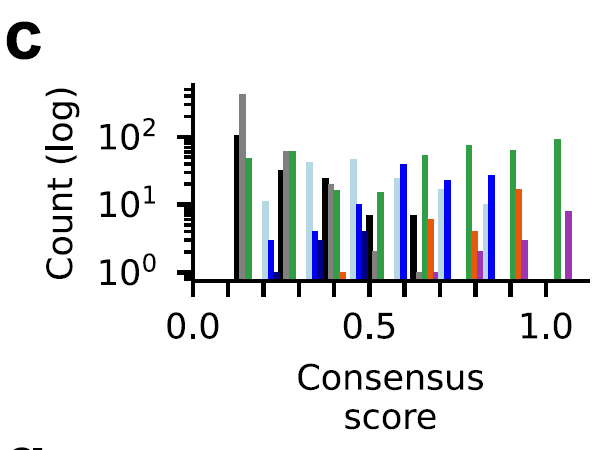
为了解决已有研究在整理 E3 系统时策略多样且定义标准常有差异的挑战,该研究团队明确界定了 E3 系统的催化成分,即包含一个或多个催化结构域的多肽序列。利用这一客观标准,能够对 E3 进行恰当注释并进行针对性分析。最终,研究人员发现所有数据集中共有 462 条多肽序列至少包含一个催化结构域,这些多肽构成了精细整理的人类 E3 连接酶组,见下图:
②人类 E3 连接酶的功能分化
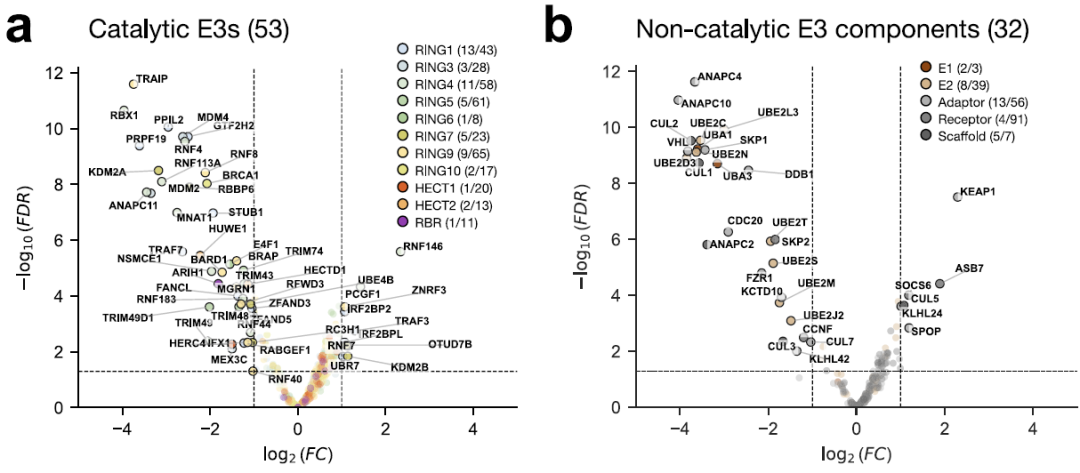
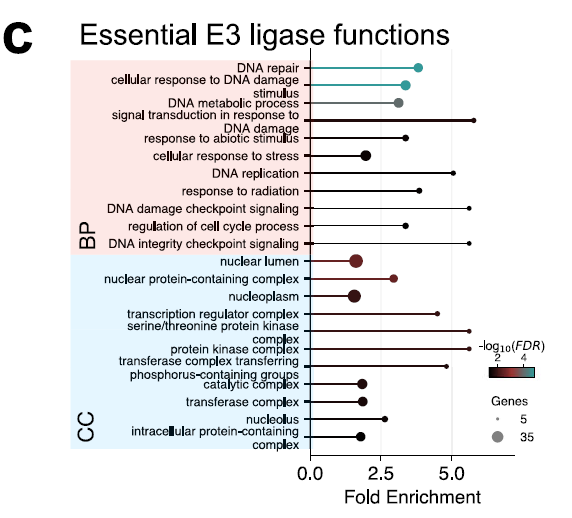
为了评估人类 E3 连接酶的功能,研究人员进行了 UPS 基因的 CRISPR-Cas9 缺失筛选,以细胞活力作为主要表型。结果显示,共识别出 53 个催化型和 32 个非催化型 E3 组分对于细胞活力至关重要,如下图:
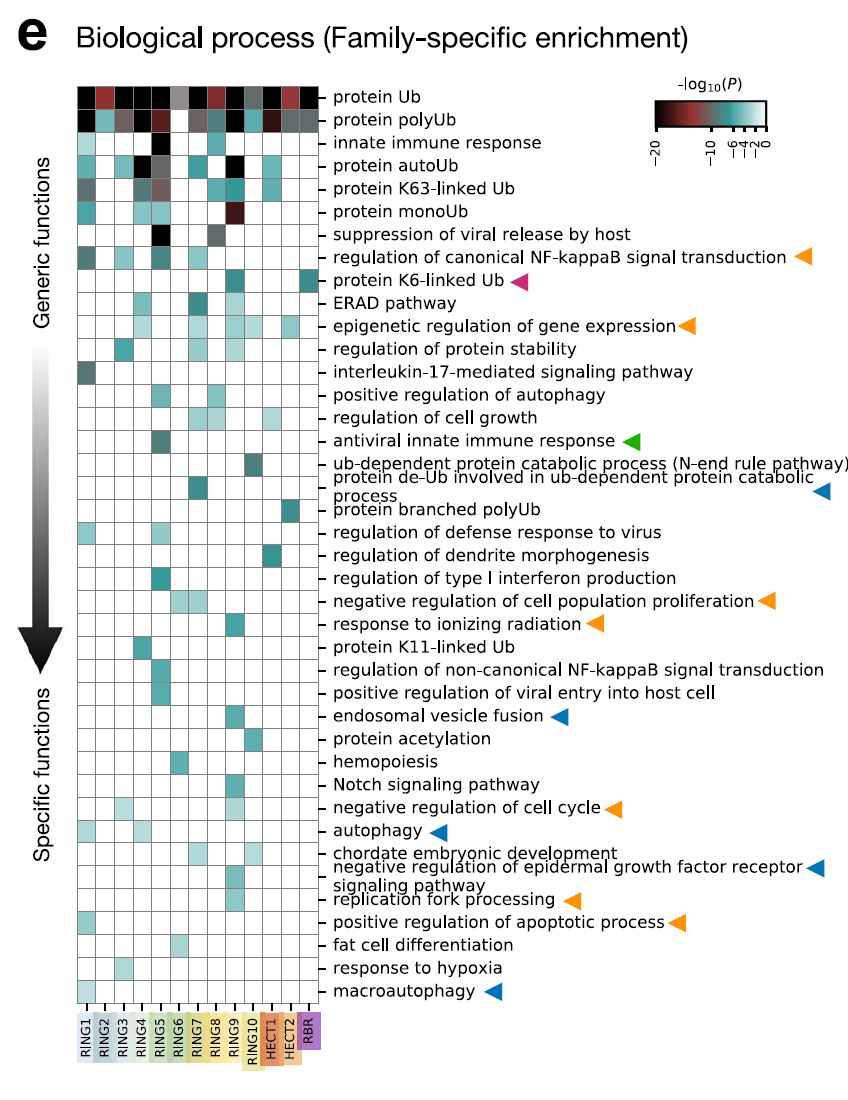
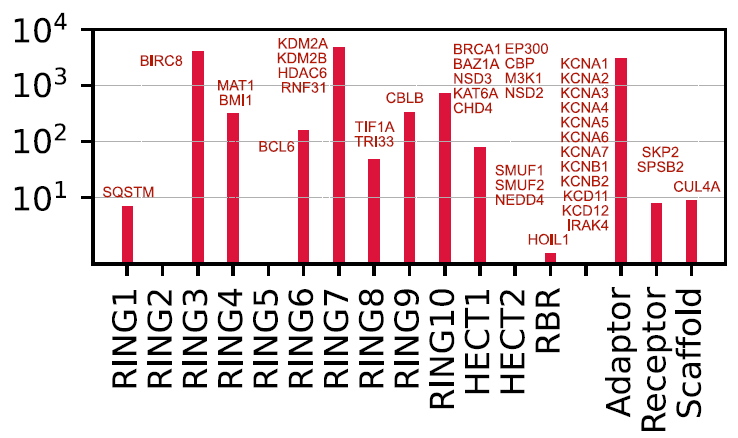
为了探索基于近距离作用的潜在治疗途径,研究人员将已知的蛋白降解靶向嵌合体(PROTAC)和 E3 结合子衍生的现有 E3 操作位映射到各个 E3 及其家族。目前,仅有 16 个蛋白(9 个催化型 E3 和 7 个适配器)可被现有 E3 操作位直接靶向。已设计的 E3 操作位大多针对适配器蛋白(如 VHL 、 CRBN),而直接靶向催化型 E3 的仅极少数(如 XIAP 、 MDM2/4/7 、 BIRC2/3/7)。
利用该研究的人类 E3 连接酶进行最近邻分析,发现 5 个高度相关蛋白(BIRC8 、 RN166/181/141 和 UBR2),如下图:
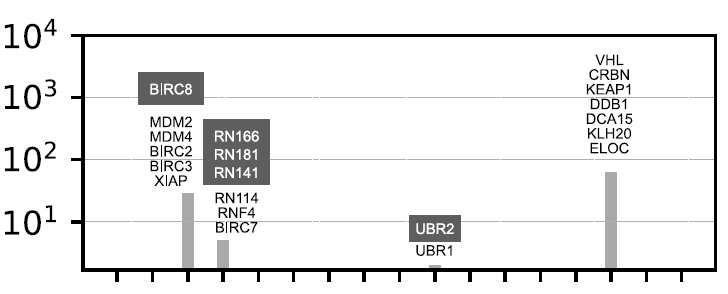 由于它们具有高度结构相似性(通常为同源蛋白),现有 E3 操作位可被重新利用来靶向这些蛋白。映射小分子 E3 结合子使研究人员获得潜在的化合物集合,可靶向另外 25 个 E3 和 15 个非催化成分,从而发现未开发的靶点,为 E3 操作位的理性设计提供先导化合物开发途径,如下图:
多尺度框架为复杂生物系统的解析提供利器
在机器学习领域,多尺度框架(multi-scale framework)指的是一种能够在不同抽象层次或不同特征尺度上处理数据的建模方法或分析策略。它并不是固定的算法,而是一种设计思想,用于整合局部与全局信息、粗粒度与细粒度特征,从而提高模型的表达能力和泛化能力。
多尺度分类框架的价值,并不局限于对 E3 连接酶家族本身的系统梳理,其更重要的意义在于提供了一种可迁移、可扩展的组学整合方法论范式。这种跨尺度的整合思路,使其天然具备向其他多模态组学数据扩展的能力,为复杂生物系统的系统性解析提供了通用工具。
例如,细胞是生命的基本单位,其功能和命运由复杂的分子网络共同决定。传统的深度学习方法虽在单细胞转录组数据的细胞类型识别中表现良好,但缺乏生物学可解释性。 2025 年 10 月 20 日,来自中国国家蛋白质科学中心(北京)、清华大学团队的研究人员提出了一种融合生物先验知识的多尺度可解释深度学习框架 Cell Decoder,实现了从基因、通路到生物过程的分层表征与推理,为单细胞水平上解码细胞类型提供了新的思路。 Cell Decoder 通过将蛋白质互作网络、基因-通路映射及通路层级关系嵌入图神经网络架构,构建出跨尺度的生物知识图谱。在七个公开单细胞数据集的人体和小鼠样本上,研究团队对 Cell Decoder 与 9 种主流方法进行了系统评测。结果显示,Cell Decoder 在预测准确率 (0.87) 与 Macro F1 (0.81) 上均居首位,且在存在噪声扰动、细胞类型不平衡及跨批次分布偏移等复杂情形下仍保持稳定性能。
论文标题:Cell Decoder: decoding cell identity with multi-scale explainable deep learning
论文地址:
https://link.springer.com/article/10.1186/s13059-025-03832-y
从更长远的视角来看,多尺度框架可以进一步与空间蛋白组学数据、小分子药物库及化学空间信息等相结合,从而打通基础生物学研究、疾病机制解析与转化应用之间的数据壁垒。随着多组学数据持续积累,这一框架有望在生命科学研究与生物医药创新中发挥越来越重要的支撑作用。
参考文献:
1.https://www.nature.com/articles/s41467-025-67450-9
2.https://blog.csdn.net/qazplm12_3/article/details/153948711
3.https://link.springer.com/article/10.1186/s13059-025-03832-y