Command Palette
Search for a command to run...
تقرير أسبوعي عن الأوراق البحثية | ثماني أوراق بحثية تركز على آخر تطورات "Agent Harness"، تغطي وكلاء البرمجة والتحكم المجسّد وتوليد الصور والفيديو
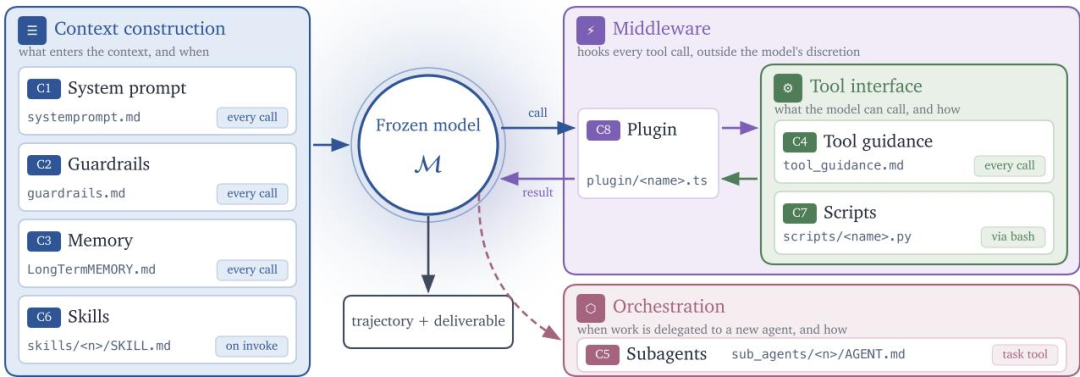
مع انتقال وكلاء الذكاء الاصطناعي (AI Agents) من مجرد الإجابة عن الأسئلة البسيطة إلى تنفيذ مهام معقدة، يبرز إطار العمل الخاص بالوكيل (Agent Harness) تدريجياً كاتجاه بحثي مهم في مجال دراسة الوكلاء. وهو إطار تشغيلي يربط بين نماذج اللغة الكبيرة (LLMs)، والأدوات، وبيئات التنفيذ، حيث يتولى تنظيم سير العمل للمهام، وإدارة السياق والذاكرة، وتنسيق استدعاءات الأدوات، بالإضافة إلى معالجة الأخطاء والتحقق من النتائج أثناء عملية التنفيذ. وببساطة، يحدد النموذج ما يمكن للوكيل التفكير فيه، بينما يؤثر إطار العمل (Harness) بشكل كبير على مدى قدرة هذه القدرات على التحول إلى أفعال عملية مستقرة وموثوقة.
لماذا يحظى إطار العمل (Harness) باهتمام متزايد؟ مع التحسن المستمر في قدرات النماذج على الاستنتاج والتوليد، لم تعد التحديات التي تواجه الوكلاء تقتصر على توليد إجابات صحيحة فحسب، بل تشمل أيضاً كيفية إكمال المهام متعددة الخطوات بشكل متتابع، وكيفية تقليل العمليات الخاطئة، وكيفية التكيف مع بيئات التنفيذ المختلفة، وكيفية التحكم في المخاطر أثناء العمليات المستقلة. يتطور إطار العمل (Harness) من كونه إطاراً أساسياً لدعم تشغيل النموذج، ليصبح تدريجياً بنية تحتية حاسمة تؤثر على فعالية تنفيذ الوكيل، وحدود تطبيقاته، وأمنه.
حول هذه القضايا، بدأ المزيد من الأبحاث مؤخراً باستكشاف تصميم وتقييم وتحسين إطار العمل (Harness) من زوايا مختلفة: حيث يحلل بعض الباحثين أدوار التخطيط، والأدوات، وإدارة السياق من خلال تجارب مضبوطة؛ ويستكشف آخرون آليات تنفيذ أكثر موثوقية في عمليات الطرفية (Terminal)، والتحكم في الروبوتات، وتوليد الصور المرئية؛ بينما يوجه باحثون آخرون انتباههم نحو قيود الأمان، والبناء الآلي، والتحسين الذاتي التكراري، في محاولة لجعل إطار العمل (Harness) ليس قادراً على التشغيل فحسب، بل قادراً أيضاً على التحسين المستمر بناءً على ملاحظات المهام.
في هذا العدد، قمنا باختيار 8 أوراق بحثية تتعلق بإطار عمل الوكلاء (Agent Harness)، تجمع بين استكشافات من مؤسسات مثل NVIDIA، وGoogle Cloud AI Research، وجامعة نورث ويسترن، وجامعة العلوم والتكنولوجيا في الصين، وغيرها من الجامعات ومراكز البحوث. تغطي هذه الأوراق مجالات تصميم الإطار، والتحكم في التنفيذ، والذكاء المجسد (Embodied AI)، والتوليد المرئي، وحوكمة الأمان، وتقييم القدرات الهندسية، والتحسين التكراري، والتطور الذاتي. فلنلقِ نظرة عليها!
إلى جانب ذلك، ستواصل قسم "الأوراق البحثية" على الموقع الرسمي لـ HyperAI متابعة أحدث الإنجازات في مجال الذكاء الاصطناعي، لمساعدتكم على البقاء على اطلاع دائم بديناميكيات الأبحاث ذات الصلة ⬇️
اطلع على أحدث الأوراق البحثية:
توصيات الأوراق البحثية لهذا الأسبوع
1. تصميم إطار العمل لوكلاء البرمجة
عنوان الورقة البحثية:
An Empirical Study of Harness Design for Coding Agents
الورقة البحثية وشرحها التفصيلي:
تقدم هذه الدراسة تحليلاً تجريبياً منهجياً لتصميم إطار العمل (Harness) لوكلاء البرمجة، مع التركيز على كيفية تأثير آليات التشغيل المختلفة على أداء المهام مع ثبات النموذج الأساسي. أجرى الباحثون تجارب مضبوطة حول ثلاث مكونات أساسية: آلية التخطيط، فضاء الأفعال، وإدارة السياق، في محاولة لفهم التأثير المحدد لكل جزء من إطار العمل على معدل نجاح المهمة، وكفاءة التنفيذ، وتكلفة الموارد. وهذا يساعد على تجنب الحكم على فعالية التصميم بناءً على الأداء النهائي للنظام الكامل فقط.
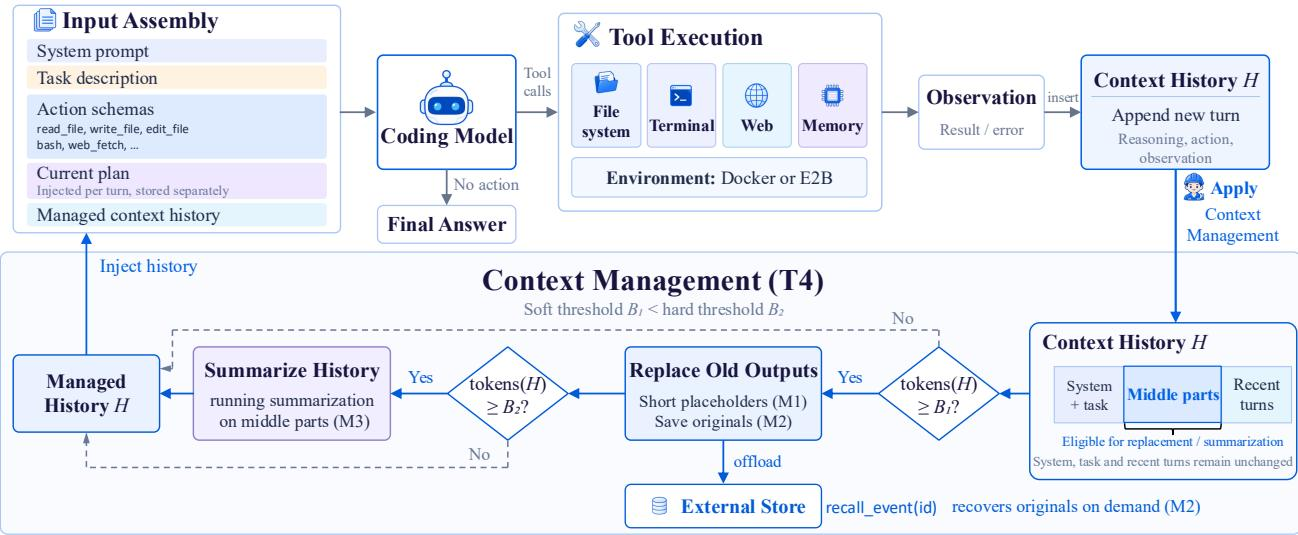
أجرى فريق البحث عدة تجارب متطابقة على معايير مثل SWE-Bench Verified و Terminal-Bench 2.1. أظهرت النتائج أن إدارة السياق أمر بالغ الأهمية للمهام طويلة المدى، حيث إن المعالجة المناسبة للمعلومات التاريخية يمكن أن تقلل من الفشل الناتج عن تجاوز سعة السياق. كما أن آلية التخطيط تحقق مكاسب مختلفة اعتماداً على قدرات النموذج، ويحتاج اختيار واجهات الأدوات أيضاً إلى التعديل وفقاً لخصائص النموذج. تشير الدراسة إلى أن إضافة المزيد من المكونات إلى إطار العمل (Harness) ليس بالضرورة أن يكون أفضل، بل يجب تصميمه بناءً على متطلبات المهمة، وقدرات النموذج، وميزانية الموارد، مما يوفر أساساً تجريبياً لإجراء أبحاث تحسين قابلة للقياس لإطار العمل في المستقبل.
2. Mid-Harness
عنوان الورقة البحثية:
Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents
الورقة البحثية وشرحها التفصيلي:
قدم باحثون من مؤسسات مثل NVIDIA، ومعهد كوريا المتقدم للعلوم والتكنولوجيا (KAIST) إطار Mid-Harness، لاستكشاف كيفية إضافة آليات أخذ عينات الأفعال والتحقق بين نموذج اللغة الكبيرة وإطار التنفيذ، لتحسين موثوقية التنفيذ لدى وكلاء الطرفية (Terminal Agents). عادةً ما ينفذ وكلاء الطرفية التقليديون الأوامر المولدة من النموذج مباشرة، لكن العمليات الخاطئة قد تغير بيئة التشغيل وتؤثر على المهام اللاحقة. وحتى لو كان النموذج قادراً على توليد أوامر أفضل، فقد لا يتمكن من تقديم الخيار الأمثل في المحاولة الأولى. يقوم Mid-Harness بتوليد عدة أفعال مرشحة قبل التنفيذ الفعلي، ثم يقارنها ويصفيها من خلال وحدة تحقق، لتقليل تأثير العمليات غير الملائمة على سير المهمة.
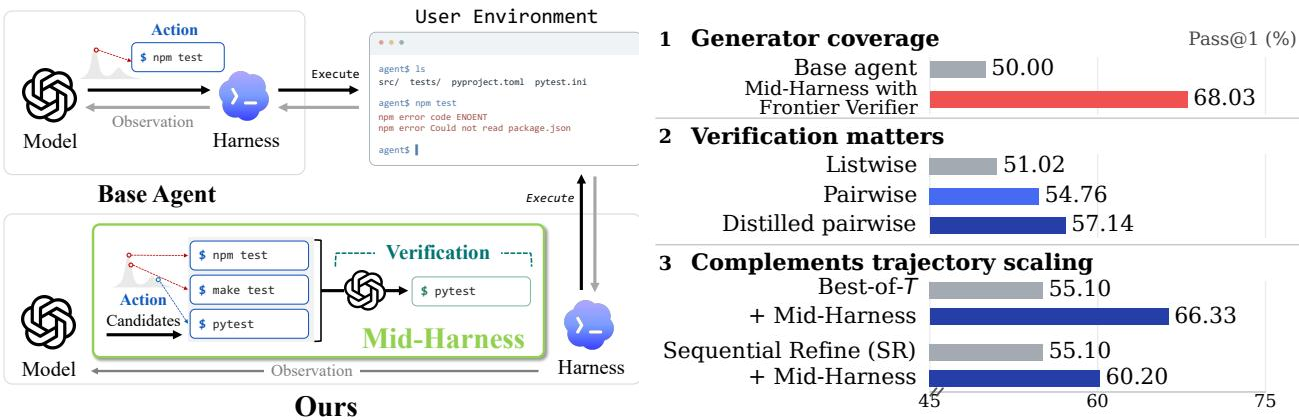
أجرى فريق البحث تجارب حول طرق أخذ عينات الأفعال المرشحة، واختيار وحدات التحقق، واستراتيجيات التنفيذ المختلفة، لتحليل القيمة الفعلية لتخصيص موارد حاسوبية إضافية بين النموذج وإطار العمل (Harness). تشير الدراسة إلى أن زيادة الأفعال المرشحة لا تؤدي بالضرورة إلى مكاسب، حيث يعتمد التأثير على قدرة وحدة التحقق على التعرف على العمليات الأفضل. كما أن آليات المقارنة والتصفية المناسبة يمكنها تحسين جودة الأفعال ورفع معدل النجاح للمسار الكامل للمهمة. تنقل هذه الدراسة تركيز التحسين من مجرد تعزيز قدرات التوليد لدى النموذج إلى اختيار الأفعال قبل التنفيذ، مما يوفر أفكاراً جديدة لبناء وكلاء طرفية أكثر موثوقية.
3. Show-Harness
عنوان الورقة:
Show-Harness: Just a VLM Agent Can Play Robots
الورقة وقراءة تفصيلية:
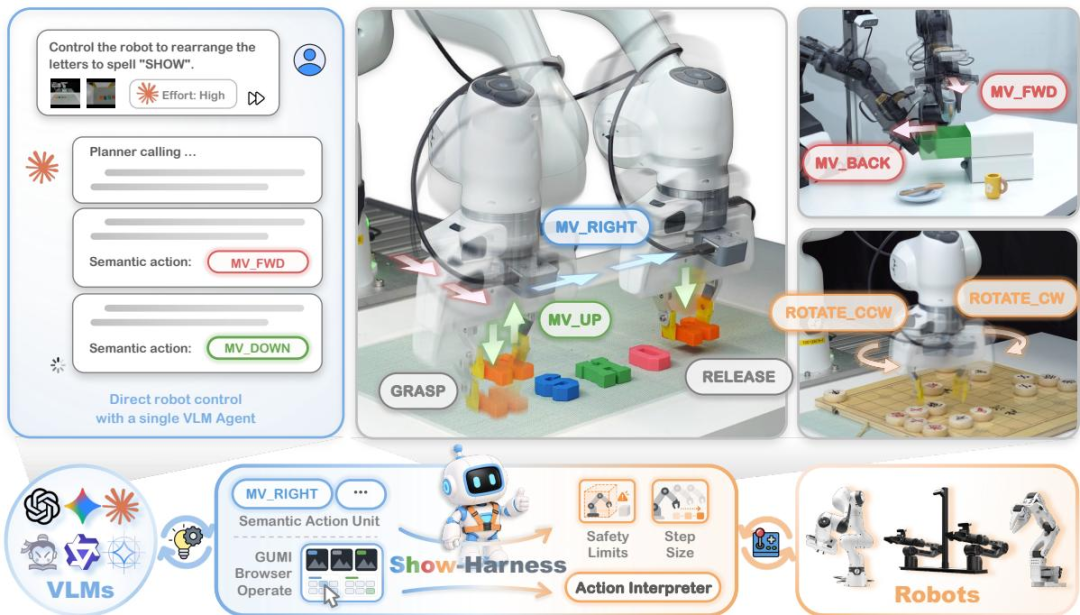
اقترح الباحثون نظام Show-Harness بهدف معالجة كيفية تحويل نماذج الرؤية واللغة (VLM) لفهمها البصري وقدراتها الاستدلالية اللغوية إلى عمليات روبوتية فعلية. عادةً ما تتطلب أنظمة الروبوتات التقليدية تدريباً متخصصاً لنماذج الرؤية واللغة والحركة، أو الاعتماد على وحدات تحكم مستقلة لتنفيذ التعليمات التي تولدها النماذج العليا. صمم Show-Harness واجهة للإجراءات الدلالية، حيث يتم تمثيل عمليات الروبوت كوحدات إجراء منفصلة يمكن للنموذج فهمها والاستدلال عليها، ثم يقوم مترجم مصمم خصيصاً للروبوت المحدد بتحويل هذه الإجراءات إلى أوامر تحكم فعلية. بالإضافة إلى ذلك، طورت فريق البحث واجهة GUMI (واجهة التلاعب بالواجهة الرسومية)، التي تدعم جمع عروض توضيحية لعمليات الروبوت من خلال واجهة رسومية، مما يقلل من الاعتماد على أجهزة التحكم عن بعد المتخصصة.
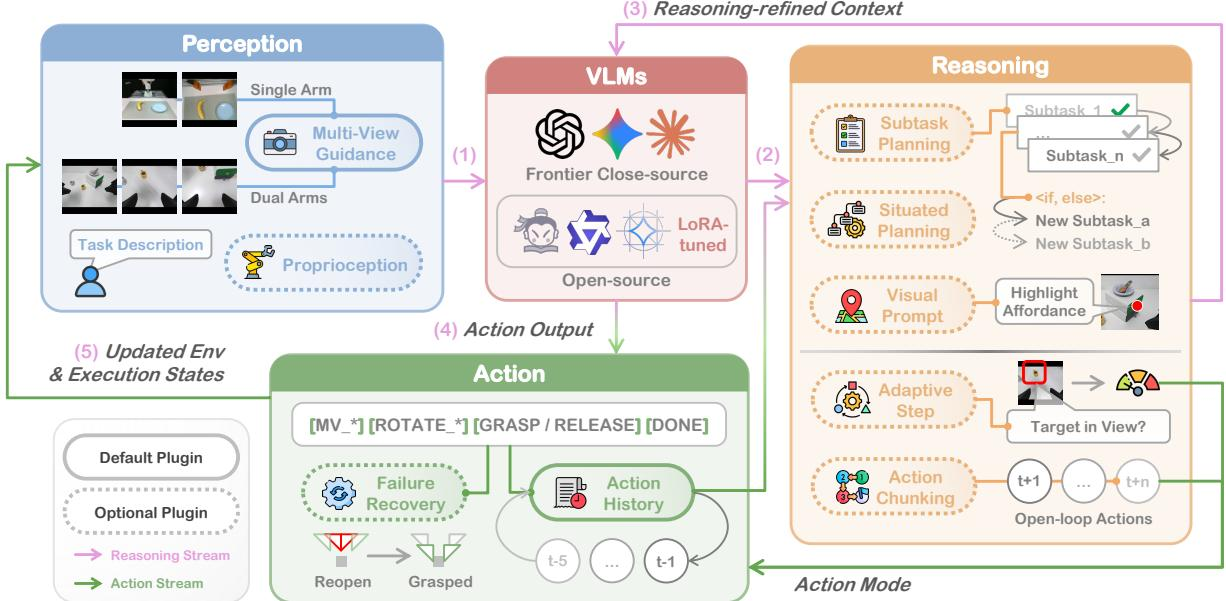
أجرى فريق البحث تقييماً عبر مهام متعددة، وأشكال روبوتية، وبيئات مختلفة، لاستكشاف أداء هذا الإطار في سيناريوهات التحكم بدون تدريب (Zero-shot) والتدريب الدقيق الخفيف. أظهرت النتائج أن Show-Harness يمكن أن يساعد نماذج VLM الرائدة في تنفيذ مهام روبوتية متنوعة دون الحاجة إلى تدريب دقيق متخصص، كما يمكنها التوافق مع نماذج مفتوحة المصدر صغيرة الحجم من خلال تدريب دقيق خفيف نسبياً. أظهرت الدراسة أيضاً أن آليات مثل التخطيط السياقي، وسجل الإجراءات، واستعادة الحالة بعد الفشل يمكن أن تحسن من استقرار التنفيذ. يشير هذا العمل إلى أن التصميم المعقول لواجهات التفاعل بين النموذج والبيئة يمكن أن يطلق العنان للقدرات المجسدة الموجودة مسبقاً في نماذج VLM الأساسية، مما يدفع إطار Harness من مجرد إطار تشغيل برمجي إلى طبقة تحكم في الأفعال بالعالم الفيزيائي.
4. MaLiang-Harness
عنوان الورقة:
MaLiang-Harness: A Programmable Path to Image and Video Generation
الورقة وقراءة تفصيلية:
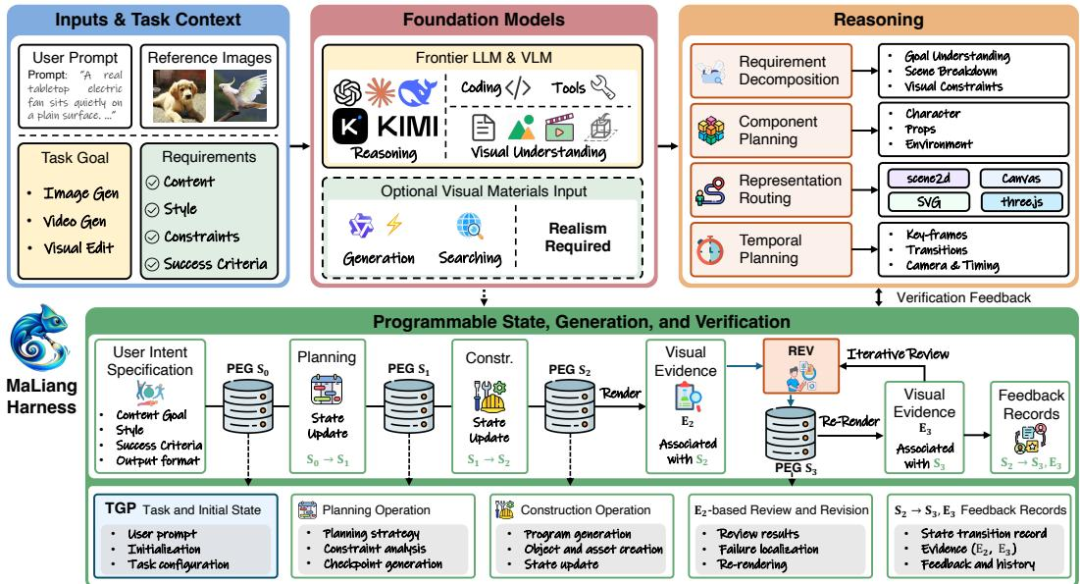
اقترح الباحثون نظام MaLiang-Harness لاستكشاف كيفية توسيع مفهوم تصميم إطار Harness إلى مجالات توليد الصور والفيديو. على الرغم من أن طرق التوليد البرمجي التقليدية توفر تحكماً واضحاً في التكوين والحركة، إلا أن نجاح تشغيل البرنامج لا يعني بالضرورة أن النتيجة البصرية النهائية تتوافق مع توقعات المستخدم. لمعالجة هذه المشكلة، ينظم هذا الإطار التوليد البصري المدعوم بنماذج لغوية كبيرة متعددة الوسائط كعملية مستمرة من البناء، والفحص، والتنقيح. ومن خلال حفظ البرامج القابلة للتنفيذ وسياق المهام، وتتبع تاريخ التحرير والأدلة على العرض، والتحقق من النسخة الحالية، يصبح عملية التوليد البصري أكثر قابلية للتتبع والاستعادة والتكرار.
قام فريق البحث ببناء MaLiang-IBench و MaLiang-VBench لتقييم قدرات توليد الصور والفيديو على التوالي، واختبار عدة نماذج لغوية كبيرة متعددة الوسائط رائدة. أظهرت النتائج أن GPT-6-Astra حققت معدل نجاح توليد بنسبة 100% في كلا المعيارين، لكن نسبة مهام الصور التي استوفت جميع عتبات الجودة البصرية كانت 96.0%، ونسبة مهام الفيديو كانت 76.9%. توضح هذه النتائج أن نجاح تنفيذ البرنامج وجودة النتيجة البصرية النهائية هما معياران مختلفان للتقييم. كما أن تشابه درجات قدرات النماذج العامة لا يعني بالضرورة أنها تؤدي بنفس الطريقة في مهام التوليد البصري. يوفر هذا البحث إطاراً تشغيلياً منهجياً للتوليد البصري القابل للبرمجة، ويوسع نطاق تطبيق إطار Harness في سيناريوهات الذكاء الاصطناعي التوليدي.
5. EvoSafeHarness
عنوان الورقة:
EvoSafeHarness: Evolving Model- and Domain-Specific Harnesses for Securing Agents
الورقة وقراءة تفصيلية:
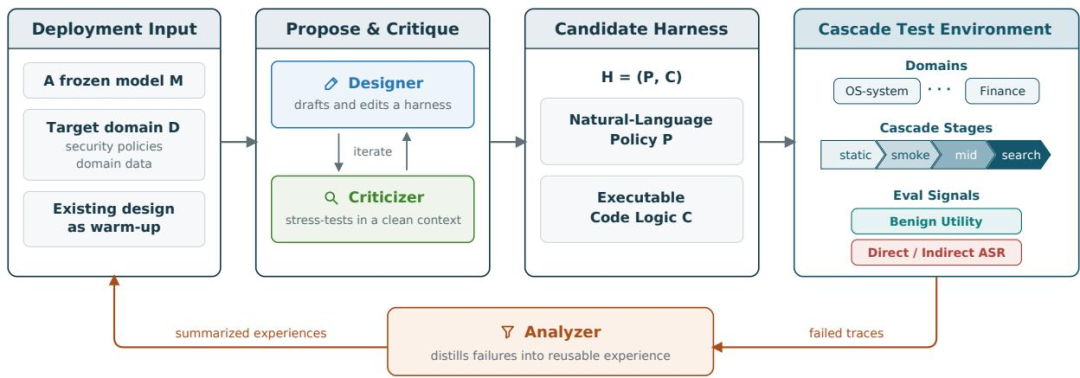
اقترح الباحثون نظام EvoSafeHarness لمعالجة مشاكل الأمن والحماية للوكلاء الذكيين (Agents) في مواجهة الطلبات الضارة المباشرة وحقن التعليمات غير المباشرة. عادةً ما تكون قيود الأمان التقليدية مصممة مسبقاً من قبل خبراء وتُطبق على نماذج ومجالات مهام مختلفة، لكن الخصائص السلوكية للنماذج المختلفة ومتطلبات المخاطر في المجالات المختلفة ليست متطابقة. قد تؤدي القواعد الثابتة إلى تقييد المهام الطبيعية بشكل مفرط، أو قد تفوت مخاطر أمنية في سيناريوهات محددة. يحول EvoSafeHarness تصميم قيود الأمان إلى عملية قابلة للتحسين، حيث يعدل بشكل مشترك سياسات الأمان باللغة الطبيعية والمنطق البرمجي القابل للتنفيذ، ويجمع بين ملاحظات سلوك النموذج المستهدف، والمعايير الخاصة بالمجال، والمراجعات التصادمية، لتوليد مجموعة قيود أكثر ملاءمة لبيئة النشر المحددة.
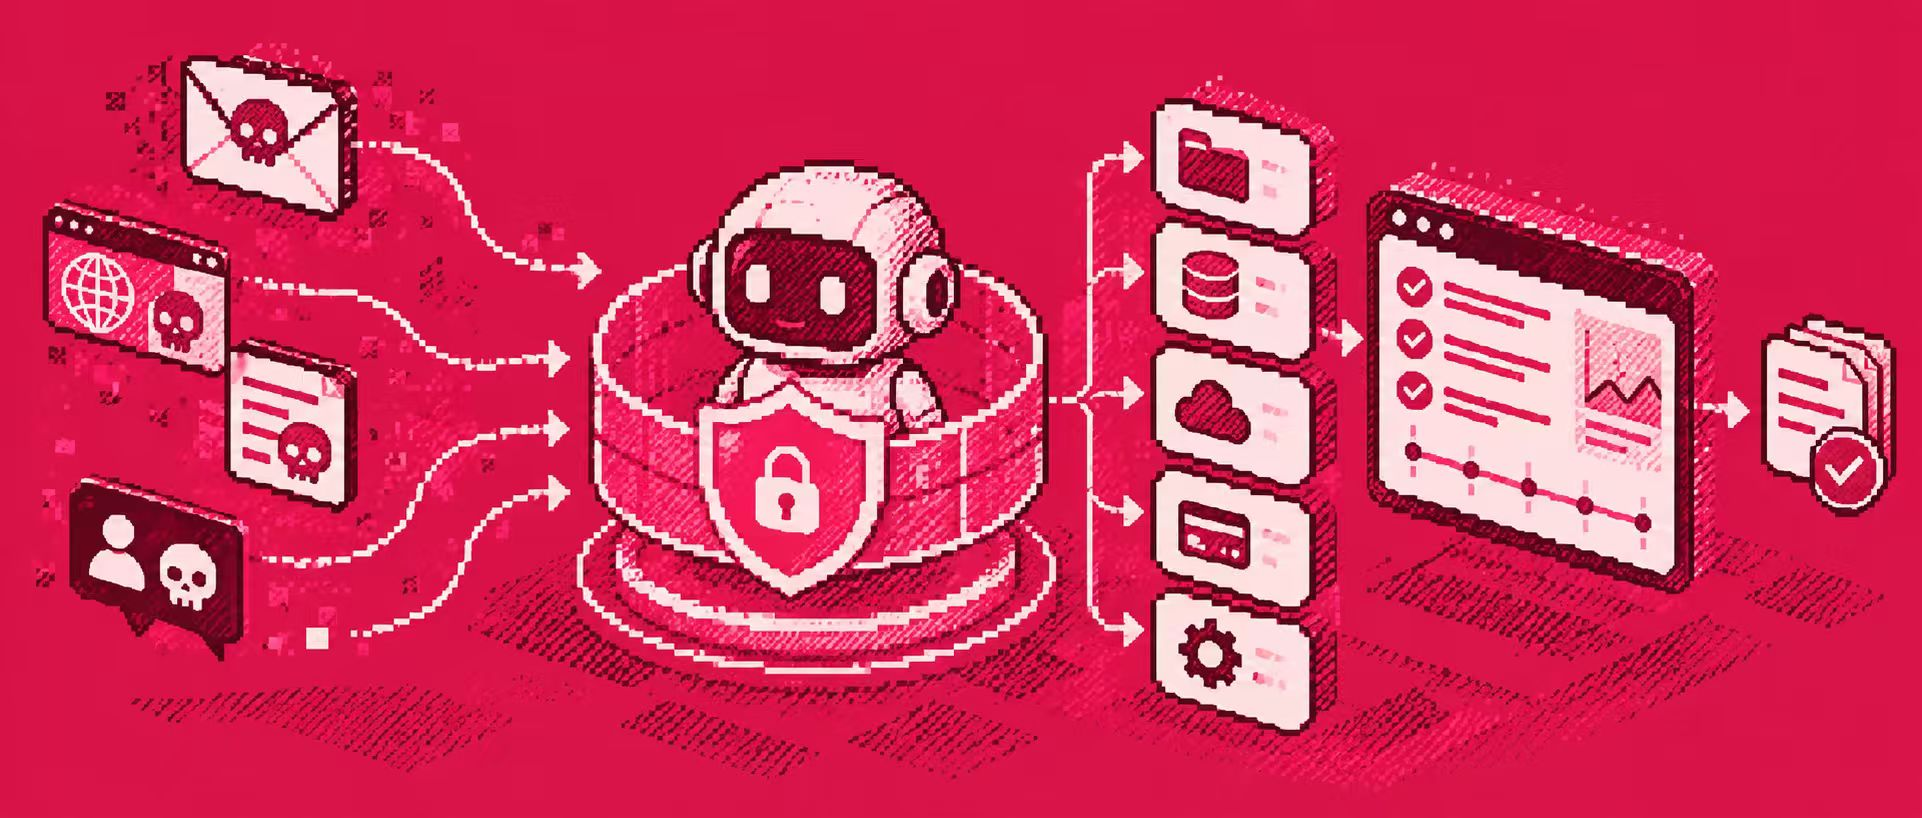
يُجري فريق البحث تقييمًا على مجموعة متنوعة من معايير أمان الوكلاء. في الإعدادات ذات الصلة ضمن اختبار DecodingTrust-Agent، خفضت هذه الطريقة متوسط معدل نجاح الهجوم من 45.6% إلى 10.0%، مع خسارة في المنفعة تقدر بحوالي 3.3 نقطة مئوية؛ وفي إعدادات التقييم المحددة ضمن AgentDojo، انخفض معدل نجاح الهجوم إلى 0.0%، بينما بلغت منفعة المهام العادية 82.8%. تُظهر هذه النتائج أن تخصيص آليات الأمان بناءً على النموذج والمجال يمكن أن يحسن التوازن بين الأمان ومنفعة المهام. ومع ذلك، لا يزال أداء الأمان يعتمد على نوع الهجوم، وبيئة المهمة، ونطاق التقييم. يوسع هذا العمل دور إطار التشغيل (Harness) من تنفيذ المهام إلى إدارة المخاطر، ويستكشف كيفية تمكين الوكلاء من الالتزام بالحدود الأمنية المناسبة أثناء إنجاز المهام.
6. Doc 2 Harness
عنوان الورقة البحثية:
Doc2Harness: تقييم النماذج اللغوية الكبيرة في هندسة إطار التشغيل طويل المدى لوكلاء البرمجة
الورقة البحثية والتفسير التفصيلي:
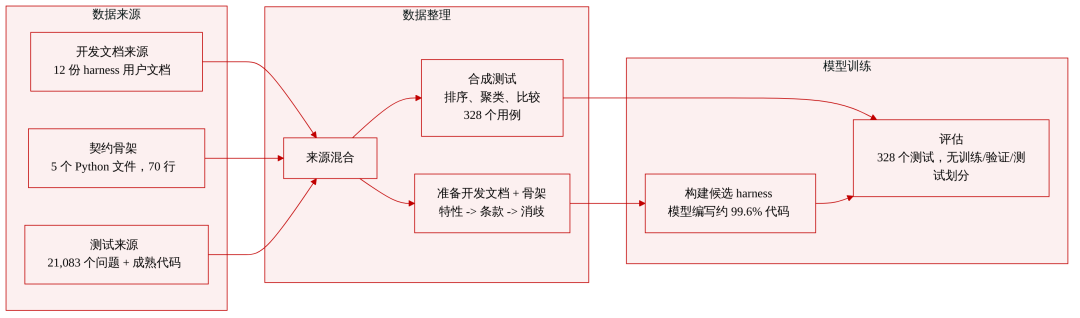
يقترح الباحثون Doc2Harness بهدف تقييم قدرة النماذج اللغوية الكبيرة المباشرة على بناء إطار تشغيل كامل للوكلاء من الناحية الهندسية. عادةً ما تختبر الأبحاث السابقة أداء الوكلاء في مهام ضمن أطر تشغيل مصممة مسبقًا، لكنها نادرًا ما تختبر قدرة النموذج على بناء إطار تنفيذ قابل للتشغيل بشكل مستقل بناءً على وثائق التطوير واتفاقيات الواجهة. صُمم تقييم Doc2Harness على مرحلتين: أولاً، يولد النموذج المرشح إطار التشغيل المرشح بناءً على عقود الواجهة ووثائق التطوير؛ ثانياً، يقوم فريق البحث بتشغيل هذا الإطار في بيئة معزولة، ويتحقق من مدى تطابق سلوكه الفعلي مع المتطلبات من خلال معلومات قابلة للملاحظة مثل طلبات النموذج، وملفات القرص الصلب، ورموز إنهاء العملية، ومخرجات الأوامر.
قام فريق البحث بتقييم 19 نموذجاً رائداً باستخدام هذا المعيار، حيث أجرى كل نموذج ثلاث عمليات بناء مستقلة لـ 328 حالة اختبار. أظهرت النتائج أن أفضل نموذج أداءً، وهو GPT-6 Astra، حقق معدل نجاح بنسبة 53.05%، بينما كان أضعف نموذج بنسبة 27.44%؛ وحتى أفضل نموذج أداءً لم يجتز ما يقرب من نصف حالات الاختبار. تركزت مشاكل الفشل بشكل أساسي في الوظائف التي تتطلب تنفيذها عبر وحدات متعددة، وفي تقسيم المسؤوليات بين الوحدات المختلفة. تشير الدراسة إلى أن قدرة النموذج على توليد الكود لا تعني بالضرورة أنه يمتلك القدرة الهندسية الكاملة لبناء بنية تحتية تشغيلية معقدة. يوفر Doc2Harness معيار تقييم حاسمًا لقياس القدرة على هندسة إطار التشغيل طويل المدى، كما يوفر مرجعًا لتحسين قدرة البناء التلقائي لأطر الوكلاء في المستقبل.
7. Harness²
عنوان الورقة البحثية:
Harness²: توظيف إطار تشغيل الوكلاء بشكل تكراري لعالم مفتوح
الورقة البحثية والتفسير التفصيلي:
عندما يواجه الوكلاء مهام حقيقية تتغير باستمرار ويصعب تعريفها مسبقًا، غالبًا ما تجد أطر التشغيل التقليدية المعتمدة على التصميم البشري والإعدادات الثابتة صعوبة في التكيف في الوقت المناسب. لمعالجة هذه المشكلة، تقترح الدراسة Harness²، في محاولة لتمكين الوكلاء ليس فقط من إكمال المهام، بل أيضًا من تحسين أطر تشغيلهم الذاتية أثناء عملية التنفيذ. تبني هذه الطريقة مستويين تكراريين مترابطين: التكرار على مستوى المهمة، من خلال عملية "اقتراح – استكشاف – تركيب"، يقترح تعديلات مرشحة على الإطار للمهمة الحالية، ويجري اختبارات مقارنة، ثم يقرر ما إذا كان سيعتمد التعديلات بناءً على مسارات التنفيذ الفعلية ومخرجات المهمة؛ أما التكرار على مستوى الإطار، فيستخلص تجارب قابلة لإعادة الاستخدام من هذه التعديلات، ويحدث تدريجيًا طريقة تحسين الأطر المستقبلية. حتى في غياب إجابة قياسية تحدد صحة المهمة بشكل مباشر، يمكن للنظام تقديم أساس لتعديل الإطار من خلال مقارنة أداء التنفيذ تحت إعدادات مختلفة.
أجرى فريق البحث التقييم على ثلاثة معايير متخصصة وأربعة إعدادات تجمع بين النماذج والأطر. أظهرت التجارب أن تحسين الإطار في خطوة واحدة يمكن أن يعزز أداء GLM-5 و Gemini 3.5 Flash في معايير متعددة: بزيادة تصل إلى 11.5 نقطة في WorkBuddy-Bench، وزيادة 4.5 نقاط في JobBench، وزيادة 11.8 نقطة مئوية في LAB؛ ومع زيادة ميزانية التكرار على مستوى المهمة، يمكن أن يتسع نطاق تحسن الأداء بشكل أكبر. تكمن أهمية Harness² في محاولته ربط "إكمال المهمة الحالية" مع "تراكم الخبرات وتحسين المهام اللاحقة"، مما يحول إطار التشغيل من إعداد لمرة واحدة إلى نظام تشغيل قادر على التكيف المستمر مع مهام جديدة، ويوفر أيضًا منظورًا جديدًا للتحسين الذاتي للوكلاء في البيئات المفتوحة.
8. Self-Evolving Agent Harness
عنوان الورقة البحثية:
إطار تشغيل الوكلاء ذو التطور الذاتي
الورقة البحثية والتفسير التفصيلي:
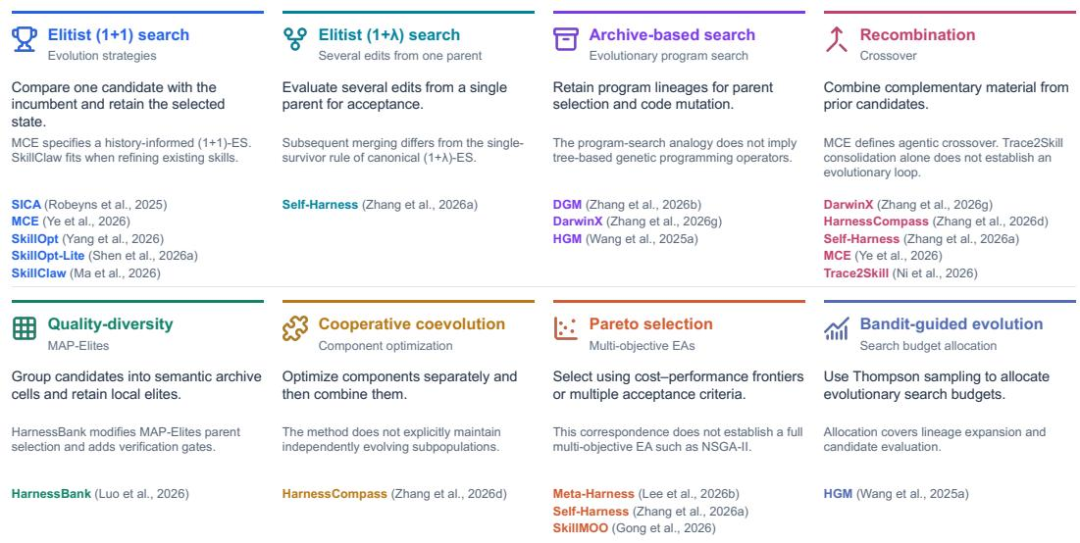
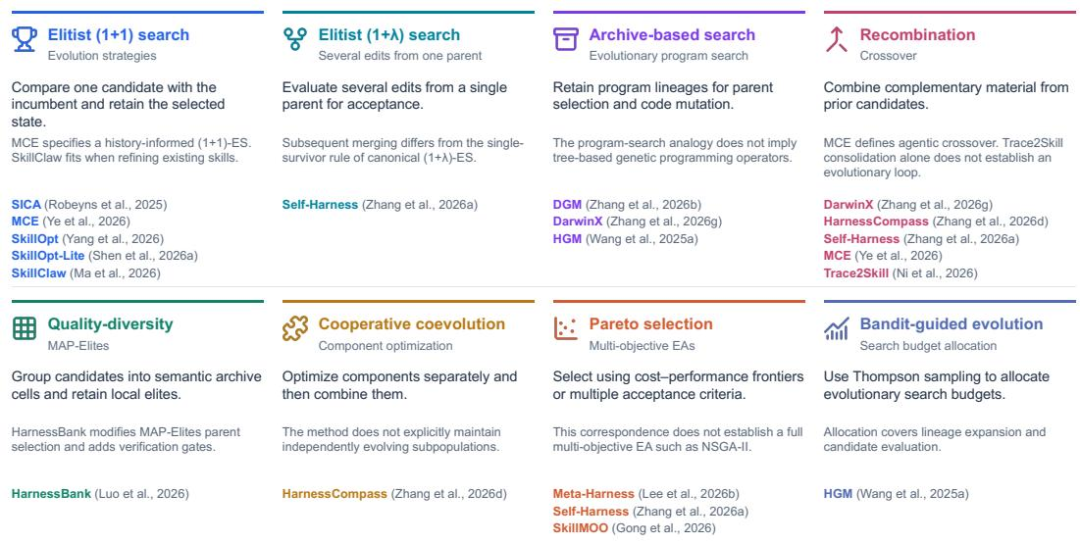
إذا كانت الأبحاث السابقة تركز على كيفية تصميم إطار العمل (Harness)، أو التحكم في الإجراءات، أو تحسين أداء المهام بشكل تكراري، فإن هذا البحث يطرح سؤالاً أكثر شمولية: هل يمكن لإطار العمل أن يشكل آلية للتحديث الذاتي المستمر عندما يكون الوكيل بحاجة إلى التشغيل على المدى الطويل؟ يُعرّف البحث «التطور الذاتي» بأنه عملية تنقيح مستمرة مدفوعة بالتغذية الراجعة: حيث يمكن للنظام، دون تغيير أوزان النموذج الأساسي، تعديل المطالبات (Prompts)، والذاكرة، وسير العمل، والمكونات القابلة للتنفيذ بناءً على الخبرة المكتسبة أثناء التنفيذ، مع الاحتفاظ بالتعديلات المقبولة للاستخدام في العمليات المستقبلية. لا تقتصر العناصر القابلة للتعديل على الوحدات الفردية فحسب، بل تمتد لتشمل الأدوات والأكواد، ومنطق التحكم على مستوى المستودعات، وعلاقات التكوين بين الإضافات والمكونات المختلفة. وفي الوقت نفسه، يؤكد البحث على أن اقتراح التعديلات، والحكم على فعاليتها، واتخاذ قرار بشأن اعتمادها رسمياً، هي ثلاث مراحل يجب معالجتها بشكل منفصل، ولا ينبغي اعتبار التعديل ذا قيمة طويلة الأجل بناءً على تحسن الأداء في مهمة واحدة فقط.
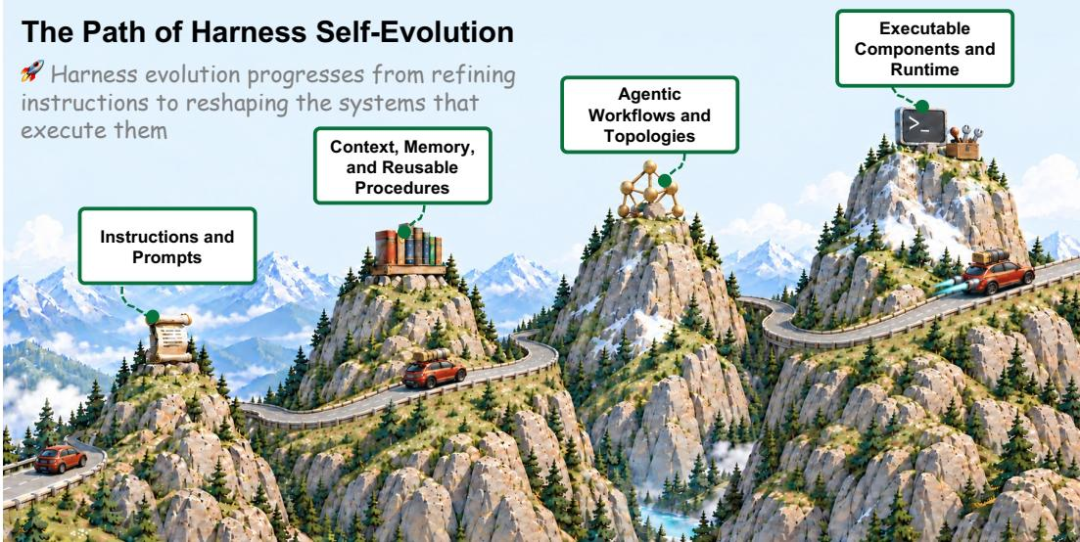
على المستوى النظري، يجمع الورقة البحثية بين التحسين التطوري والتعلم المستمر في إطار PAC لتحليل مشاكل التعميم والانحدار في الأداء التي قد تواجهها أطر العمل عند تحديثها باستمرار. كما تناقش، تحت افتراضات محددة، حدود التعميم المتوقعة، وحدود الاحتفاظ المرتبطة بميزانية الانحدار التاريخي، وقواعد قبول التعديلات المرشحة بناءً على بيانات تحقق مستقلة وجديدة تماماً. وعلى عكس المقارنة البسيطة للدرجات في معيار معين، يركز هذا البحث بشكل أكبر على كيفية احتفاظ إطار العمل بالخبرات الفعالة أثناء التكرارات المتعددة، مع تقليل الإفراط في الملاءمة (Overfitting)، والنسيان، وتدهور الأداء في المهام القديمة. كما يناقش الورقة البحثية تغييرات توزيع المهام، والانحياز في أدوات التقييم، وقضايا النشر المتعلقة بالموثوقية العلمية، والسلامة المادية، والمساءلة التنظيمية، مشيرة إلى أن التحقق المستمر والحماية المستقلة للأمان لا يزالان ضروريين. والاتجاه الذي يرسمه البحث هو أن إطار العمل لم يعد مجرد هيكل برمجي ثابت مبني حول النموذج، بل قد يصبح نظاماً قادراً على تراكم التغذية الراجعة، وتعديل نفسه بحذر، والخضوع للفحص المستمر.