Command Palette
Search for a command to run...
من الجزيئات الشبيهة بالأدوية إلى المركبات النوعية تجاه الأهداف، تستخدم جامعة بيتسبرغ الأمريكية البحث بالبصمات الجزيئية لتسريع اكتشاف الأدوية المستهدفة
يعتبر اكتشاف الأدوية التقليدية مهمة صعبة للغاية، حيث يتمثل هدفها الأساسي في تحديد جزيئات ذات خصائص مثالية محددة وقادرة على استهداف مواقع محددة ضمن فضاء كيميائي ضخم. من الفكرة البحثية الأولى وحتى الحصول على الموافقة النهائية لطرح الدواء في السوق، تتجاوز تكلفة تطوير دواء جديد 2.6 مليار دولار وتستغرق أكثر من 12 عامًا. ويتمثل أحد التحديات الجوهرية في كيفية البحث بفعالية ضمن فضاء كيميائي ضخم يضم من 10^23-10^60 جزيئًا، من أجل العثور على مركبات تتمتع في آن واحد بالفعالية البيولوجية المستهدفة، والخصائص الفيزيائية الكيميائية، وقابلية التصنيع.
في السنوات الأخيرة، أتاحت الذكاء الاصطناعي التوليدي إمكانيات جديدة لتصميم الجزيئات. فمن خلال تعلم بنية الجزيئات وخصائصها الموجودة، تستطيع النماذج التوليدية استكشاف الفضاء الكيميائي المحتمل واقتراح جزيئات مرشحة تتمتع بخصائص فيزيائية كيميائية أو سمات نشاط بيولوجي محددة. ومع ذلك، يظل تحويل الجزيئات التي يولدها النموذج إلى مركبات ذات بنية كيميائية صالحة، ومتاحة فعليًا، ولها نشاط بيولوجي حقيقي، مشكلة مهمة تواجه هذا المجال.
في هذا السياق، اقترح فريق بحثي من جامعة بيتسبرغ في ولاية بنسلفانيا الأمريكية مسارًا لاكتشاف المركبات الدوائية الرائدة التوليدي الشامل الطيف (Full-Spectrum Generative Lead Discovery، FSGLD)، وهو نهج فعال مدفوع بالتعلم العميق لتحديد المركبات الدوائية الرائدة. النواة الأساسية لـ FSGLD هي نموذج DRUG-GAN متعدد المقاييس، القادر على توجيه اكتشاف الجزيئات الدوائية عبر النماذج التوليدية في ثلاثة سيناريوهات مختلفة، تشمل:
(1) توليد مركبات عشوائية شبيهة بالأدوية؛
(2) توليد مركبات ذات خصوصية للهدف؛
(3) توليد سلاسل مركبات ذات خصوصية للهدف تتشارك في بنية كيميائية مشتركة.
في التقييم الذي أُجري على ثلاثة أهداف تختلف خصائصها الدوائية، أظهر FSGLD إمكانات تطبيقية جيدة في تحديد المركبات المرشحة ذات الخصوصية للهدف. علاوة على ذلك، وضع الباحثون مسارًا حسابيًا لحسابات التكامل الحراري (TI)، قلّل وقت الحساب بنسبة 80% إلى 90% مع الحفاظ على دقة الحساب.
نُشرت النتائج البحثية ذات الصلة بعنوان «A Full-Spectrum Generative Lead Discovery (FSGLD) pipeline via DRUG-GAN: A multiscale method for drug-like/target-specific compound library generation» في Science Advances.
أبرز نقاط البحث:
-
لا يقتصر مسار FSGLD على استخدام النماذج التوليدية لتصميم مركبات شبيهة بالأدوية وذات خصوصية للهدف فحسب، بل يمكنه أيضًا إجراء فرز وتحقق منهجي وفعال للمركبات المرشحة
-
طور الباحثون إطارًا عمليًا وقابلًا للتوسع، من المتوقع أن يقلل الوقت والتكلفة المطلوبين لاكتشاف الأدوية قبل السريري
-
المركبات التي يتم توليدها عبر هذا المسار ليست مجرد جزيئات مرشحة على المستوى النظري فحسب، بل تتمتع بإمكانية إجراء التحقق التجريبي الإضافي، ويمكن أن تحقق قيمة عملية للباحثين الأكاديميين والمتخصصين في صناعة الأدوية
عنوان الورقة:
https://www.science.org/doi/full/10.1126/sciadv.aei5257
مجموعة البيانات: مجموعات بيانات مختلفة لثلاثة سيناريوهات تطبيقية
صمم FSGLD ثلاثة سيناريوهات تطبيقية لمهام مختلفة لاكتشاف المركبات الرائدة، ولذلك اعتمد مجموعات بيانات واستراتيجيات تدريب مختلفة.
بالنسبة إلى السيناريو I، جمع الباحثون 7,002 دواء من قاعدة بيانات DrugBank (https://go.drugbank.com/) استنادًا إلى قواعد Lipinski الخمس مع فرز التنوع، لبناء مجموعة بيانات المركبات الشبيهة بالأدوية.
بالنسبة إلى مجموعة الجزيئات الطُعُم، استخدم الباحثون برنامج Open Babel لحساب الوزن الجزيئي (MW) ومعامل التوزيع بين الدهون والماء (logP) لـ 19,212,639 جزيئًا من المجموعة الفرعية الشبيهة بالأدوية في قاعدة بيانات ZINC. بعد ذلك، استخدم الباحثون برنامجًا تم تطويره داخليًا لاختيار 284,552 مركبًا من ZINC تكون أوزانها الجزيئية وقيم logP الأقرب إلى مركبات DrugBank. بعد ذلك، باستخدام برنامج SYBYL-X 2.1.1، تم تجميع هذه المركبات عنقوديًا على أساس البصمات الجزيئية (FP) لزيادة تنوعها البنيوي إلى أقصى حد. أخيرًا، اختار الباحثون 9998 جزيئًا لبناء مجموعة الجزيئات الطُعُم.
لتدريب والتحقق من المميّز لـ dcGAN، استخدم الباحثون طريقة التحقق المتقاطع بعشر طيات ([75])، وقسموا جميع الجزيئات الشبيهة بالأدوية المحددة (7002) والجزيئات الطُعُم (9998) إلى مجموعة تدريب ومجموعة اختبار.
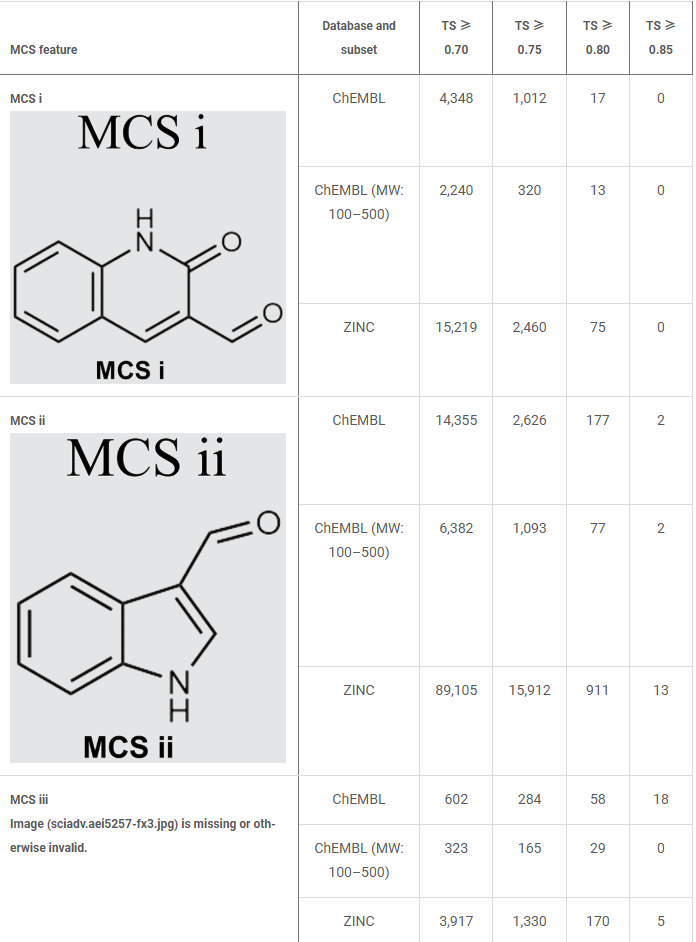
لتوليد المركبات المنحازة للهدف في السيناريوهين II و III، جمع الباحثون من قاعدة بيانات ChEMBL 1,896 مركبًا نشطًا لـ CB2 (Ki/IC50 أقل من 100 نانومولار) و2996 مركبًا غير نشط لـ CB2 (Ki/IC50 أكبر من أو يساوي 100 نانومولار) لتدريب نموذج cdcGAN. علاوة على ذلك، أجرى الباحثون فحصًا يدويًا للبنية الكيميائية لمركبات CB2 النشطة التي تم جمعها، وحددوا أكثر ثلاثة أكبر هياكل فرعية مشتركة (MCS) شيوعًا، كما هو موضح في الجدول التالي:
أثناء تدريب النموذج، تم تحويل جميع الجزيئات باستخدام برنامج Open Babel 2.3.1 إلى بصمات جزيئية من نوع MACCS (168 بت). لإجراء مزيد من التحقق، حصل الباحثون على البنية البلورية بالأشعة السينية لـ CB1، وبنوا نموذج تماثل لـ CB2.
إطار FSGLD: DRUG-GAN هو المحور
جوهر FSGLD هو DRUG-GAN، والفكرة الرئيسية فيه ليست توليد البنية الجزيئية الكاملة مباشرة، بل تعلم توزيع بصمات الجزيئات، وتوليد بصمات ذات خصائص محددة، ثم استخدامها كشرط بحث لاسترجاع مركبات حقيقية متشابهة بنيويًا من قواعد بيانات كيميائية كبيرة. وفيما يلي نظرة عامة على سير العمل:
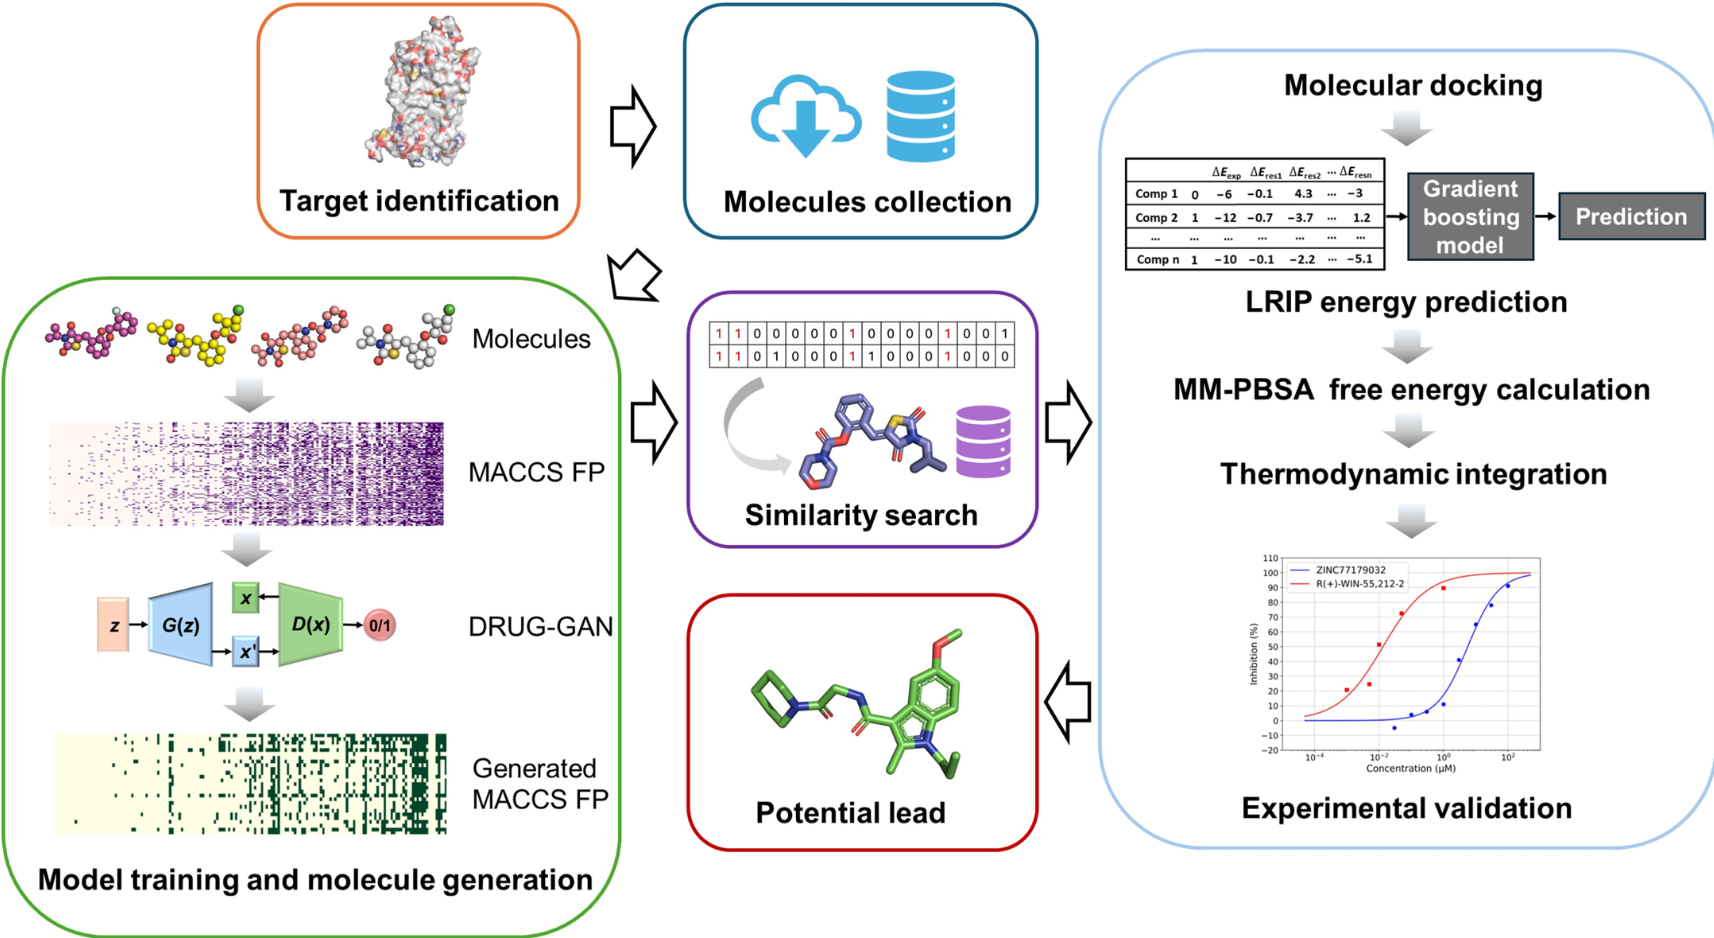
ويختلف هذا التصميم عن النماذج التوليدية التقليدية القائمة على سلاسل SMILES أو الرسوم البيانية الجزيئية. يمكن لبصمات MACCS الجزيئية وصف الخصائص البنيوية للجزيئات بصيغة مدمجة، وهي مناسبة للتعلم من مجموعات بيانات محدودة نسبيًا. ولكن لأن بصمات الجزيئات لا يمكن أن ترتبط بعلاقة توحيد فريدة مع جزيء واحد، ولا يمكن تحويلها مباشرة إلى بنى جزيئية صالحة كيميائيًا، فإن البصمات المولّدة بواسطة DRUG-GAN تحتاج إلى مطابقة تشابه إضافية مع قواعد بيانات مثل ChEMBL وZINC للحصول على مركبات مرشحة فعلية.
من حيث بنية النموذج، اعتمد الباحثون على الشبكة العصبية التلافيفية العميقة (DCNN) لبناء المُميّز، واستكشفوا أربع بنى رئيسية من DCNN، هي: LeNet-5 وAlexNet وZFNet وVGGNet.
وبناءً على أهداف الاكتشاف المختلفة، صُمم DRUG-GAN لثلاثة سيناريوهات تطبيقية.
يعتمد السيناريو I على dcGAN القياسي، باستخدام بصمات الجزيئات الشبيهة بالأدوية من DrugBank كعينات حقيقية، ويتعلم توزيع خصائص الجزيئات الشبيهة بالأدوية. ينطلق المولّد من ضوضاء عشوائية لتوليد بصمات جزيئية جديدة، ثم يجري بحثًا قائمًا على التشابه في قاعدة بيانات ZINC للعثور على المركبات المقابلة. يُستخدم هذا السيناريو بشكل رئيسي لاستكشاف الفضاء الكيميائي ذي الخصائص الشبيهة بالأدوية.
يُدخل السيناريو II مزيدًا من المعلومات الخاصة بالهدف، باستخدام شبكة توليدية خصومية شرطية cdcGAN. يستخدم النموذج الربيطات النشطة وغير النشطة لـ CB2 كفئتين من بيانات التدريب، ويتعلم خصائص بصمات الجزيئات المرتبطة بنشاط CB2، ثم يولّد بصمات ذات انحياز نحو هدف CB2. بعد ذلك، يستخدم الباحثون البصمات المولّدة كشرط بحث لاسترجاع مركبات مرشحة من قواعد بيانات ChEMBL وZINC، محققًا التوسع من استكشاف غير متحيز للجزيئات الشبيهة بالأدوية نحو اكتشاف موجّه نحو الهدف.
أما السيناريو III فيعزز بشكل أكبر قابلية التحكم في تصميم الجزيئات. أدخل الباحثون طبقة قناع (Mask Layer) في المولّد، وتحديداً من خلال طبقة Lambda لتثبيت مواضع البصمة الجزيئية المقابلة لـ MCS المحددة مسبقًا، بحيث تحتفظ البصمات المولّدة بالخصائص البنيوية المحددة، بينما يُسمح لمواضع الخصائص الأخرى بالتغير. بهذه الطريقة، يستطيع النموذج توليد سلسلة من المركبات تجمع بين انحياز هدف CB2 وخصائص هيكلية محددة، مما يوفر الدعم لتوسيع نطاق المركبات الناجحة ولتحسين المركبات الرائدة لاحقًا.
بعد توليد المركبات المرشحة، يُنشئ FSGLD أيضًا خط سير عمل للاختيار الحسابي المتدرج. يُقيَّم أولاً ارتباط الجزيئات المرشحة بالمستقبل الهدف من خلال الإرساء الجزيئي، ثم يُجرى الاختيار باستخدام دالة تقييم LRIP الخاصة بالهدف، بعدها تُجرى محاكاة الديناميكيات الجزيئية (MD)، وحسابات طاقة الربط الحرة MM-PBSA، وحسابات التكامل الثيرموديناميكي (TI). لا تنتقل إلى المرحلة التالية إلا المركبات التي تجتاز اختيار المرحلة الحالية. في النهاية، يجري الباحثون التحقق التجريبي من الجزيئات المرشحة ذات الأولوية الأعلى، مما يُكوّن خط سير عمل متكاملًا من التوليد، والبحث، والاختيار الحسابي، إلى التقييم التجريبي.
النتائج: أداء جيد في تقييم ثلاثة أهداف ذات خصائص دوائية مختلفة
قيّم الفريق التجريبي أداء النموذج من خلال ثلاثة سيناريوهات:
السيناريو I: توليد مركبات شبيهة بالأدوية
أجرى الباحثون مقارنة شاملة بين DRUG-GAN وثلاثة نماذج توليدية منشورة—ORGAN وOR(W)GAN وORGANIC—على خمسة أبعاد: التفرد (Uniqueness)، والجدة (Novelty)، والتنوع (Diversity)، والتشابه (Similarity)، والصلاحية (Validity).
كما هو موضح في الجدول التالي، في فضاء بصمة MACCS، تفوّق DRUG-GAN على النماذج التوليدية الأخرى المستخدمة كمرجع في عدة مؤشرات رئيسية. على وجه الخصوص، وصلت درجات التفرد والجدة لدى DRUG-GAN إلى 1.00، محققة أداءً مثاليًا. وهذا يعني أن جميع بصمات الجزيئات المولّدة مختلفة عن بعضها البعض، ولم تظهر أي منها في بيانات التدريب. بلغت درجة التنوع 0.73، وهي قريبة من أداء ORGAN (0.77) وORGANIC (0.76)، وفي الوقت نفسه أعلى من OR(W)GAN (0.63). علاوة على ذلك، كان متوسط التشابه بين بصمات الجزيئات المولّدة بواسطة DRUG-GAN و7002 من الأدوية المرجعية هو الأدنى، إذ بلغ 0.25 فقط. ويوضح هذا أن النموذج قادر على توليد بصمات جزيئية ذات اختلافات بنيوية واضحة مع الحفاظ على الخصائص الشبيهة بالأدوية.
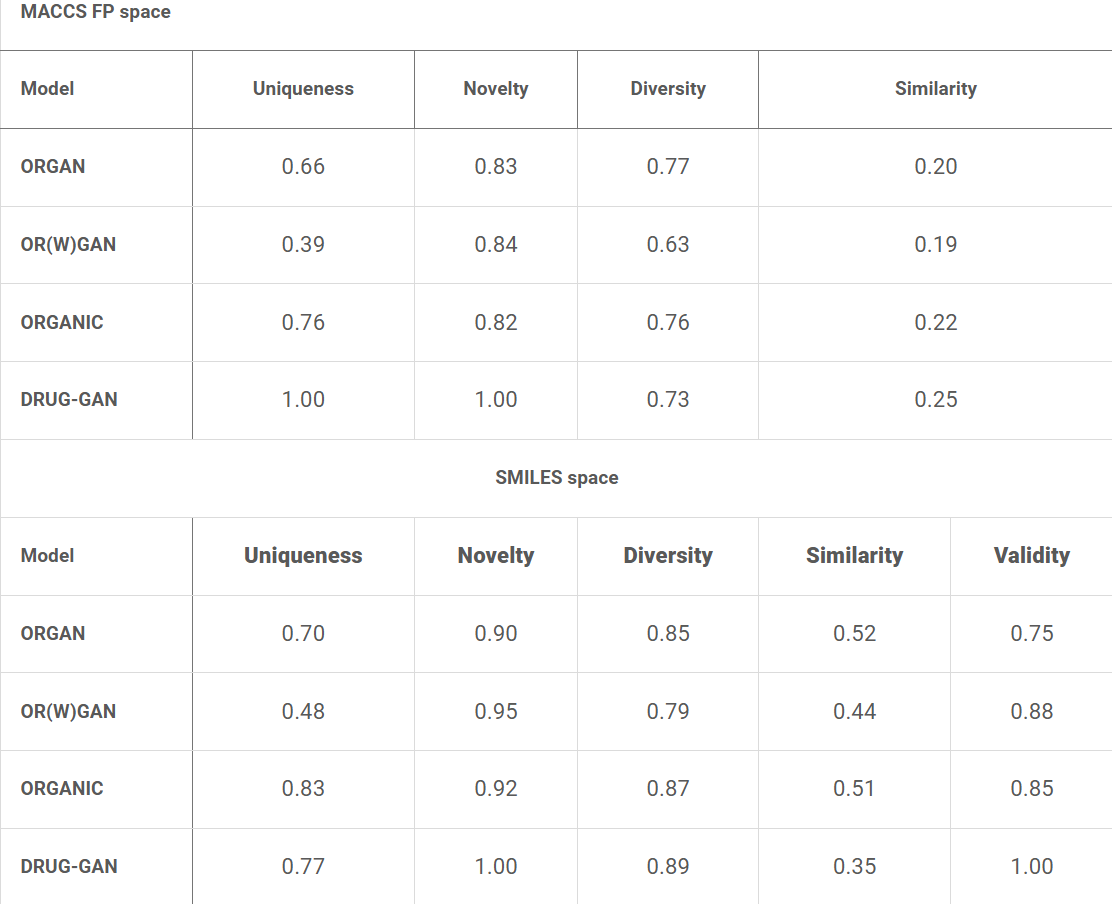
بما يتوافق مع نتائج التقييم في فضاء FP، أظهر DRUG-GAN أداءً ممتازًا في فضاء SMILES أيضًا. حافظت درجة الجِدّة لـ DRUG-GAN على 1.00، مما يشير إلى أن جميع الجزيئات المفكوكة الترميز لم تظهر في مجموعة بيانات التدريب. وكما هو متوقع، وبسبب إمكانية فك ترميز بصمات جزيئية مختلفة متعددة إلى نفس البنية الجزيئية، انخفضت درجة التفرد من 1.00 في فضاء FP إلى 0.77 في فضاء SMILES. ومع ذلك، ظل تفرد DRUG-GAN أعلى من ORGAN وOR(W)GAN، وأقل قليلًا من ORGANIC فقط. وفي الوقت نفسه، حافظ DRUG-GAN أيضًا على تنوع عالٍ، حيث بلغت درجة التنوع 0.89، بينما كانت التشابهات بين الجزيئات المُولَّدة والأدوية المرجعية منخفضة نسبيًا، بدرجة 0.35. وهذا يتوافق مع الهدف التصميمي للنموذج المتمثل في توسيع الفضاء الكيميائي دون المساس بالمعقولية الكيميائية.
لتقييم هذه النتائج بشكل أعمق، حلل الباحثون أيضًا 2252 دواءً معتمدًا من إدارة الغذاء والدواء الأمريكية (FDA)، يتراوح وزنها الجزيئي (MW) بين 100 و1000 Da. كانت متوسطات الوزن الجزيئي (MW)، واللوغاريتم العشري لمعامل التوزيع بين الدهون والماء (logP)، والمساحة السطحية القطبية الطوبولوجية (TPSA) لهذه الأدوية المعتمدة 358.0 Da و2.8 و89.3 Ų على التوالي. أظهرت الجزيئات التي تم استرجاعها بواسطة DRUG-GAN خصائص مشابهة لهذه الخصائص الدوائية، حيث بلغ متوسط وزنها الجزيئي 382.9 Da، ومتوسط logP 2.0، ومتوسط TPSA 76.0 Ų. تشير هذه البيانات إلى أن الجزيئات التي استرجعها DRUG-GAN تمتلك وزنًا جزيئيًا إجماليًا أعلى قليلًا مقارنة بالأدوية المعتمدة من FDA، لكنها أقل قطبية نسبيًا، مما يعكس خصائص فيزيوكيميائية مواتية محتملة.
السيناريو II: توليد مركبات خاصة بالهدف
بالإضافة إلى توليد مركبات مرشحة ذات خصائص دوائية، يمتلك DRUG-GAN أيضًا القدرة على توليد مركبات خاصة بالهدف. لإظهار هذه القدرة، أجرى الباحثون دراسة باستخدام مستقبل الكانابينويد 2 (CB2) كمثال.
من بين 186 مركبًا من ChEMBL بلغ تشابهها مع البصمات الجزيئية المُولَّدة 85% أو أكثر (TS ≥ 0.85)، كان وزن 169 مركبًا جزيئيًا (MW) بين 100 و500 Da، وقد أُبلغ عن 104 من هذه المركبات في تجارب النشاط البيولوجي كروابط ذات نشاط CB2، وثوابت تثبيط (Ki) أقل من 10 μM. يشير غنى الجزيئات ذات قيم Ki المنخفضة بين المركبات المسترجعة إلى أن استعلامات البصمات الجزيئية المُولَّدة بواسطة DRUG-GAN قادرة على استرجاع أنواع هياكل كيميائية معروفة بنشاطها تجاه CB2 من قواعد بيانات النشاط البيولوجي المرتبطة بالهدف المطلوب بشكل فعال. بالإضافة إلى ذلك، استرجع الباحثون 161 مركبًا من قاعدة بيانات ZINC، حيث بلغ TS بينها وبين استعلامات البصمات الجزيئية المُولَّدة بواسطة DRUG-GAN 0.85 أو أكثر.
بعد ذلك، أجرى الباحثون الإرساء الجزيئي للمركبات المسترجعة مع مستقبلي CB1 وCB2 على حدة للتنبؤ بألفة ارتباطها، وكانت النتائج كما في الشكل أدناه:
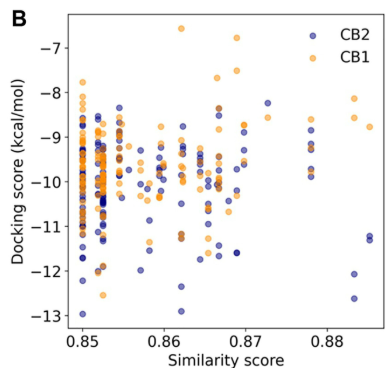
بشكل عام، أظهرت المركبات المسترجعة بواسطة استعلامات البصمات الجزيئية المُولَّدة بواسطة DRUG-GAN قدرة ارتباط متوقعة أفضل تجاه CB2، إذ بلغ متوسط درجات إرسائها مع مستقبل CB2 −10.10 kcal/mol، وهو أفضل من متوسط الدرجات لجزيئات الطعم المستخدمة في تدريب المُميِّز في السيناريو I والبالغ −8.29 kcal/mol. وبعد إجراء مقارنة مزدوجة لدرجات إرساء كل مركب مسترجع، وجد الباحثون بشكل إضافي أن هذه المركبات أظهرت بشكل عام تفضيلًا للارتباط بـ CB2، حيث كان ارتباط عدد كبير منها بـ CB2 أفضل من ارتباطها بـ CB1.
السيناريو III: توليد سلسلة مركبات خاصة بالهدف
في السيناريو الثالث، أدخل الباحثون ثلاثة MCS محددة مسبقًا في المُولِّد، لتوليد مركبات مرشحة لـ CB2 ذات قيود هيكلية محددة عبر طبقة القناع.
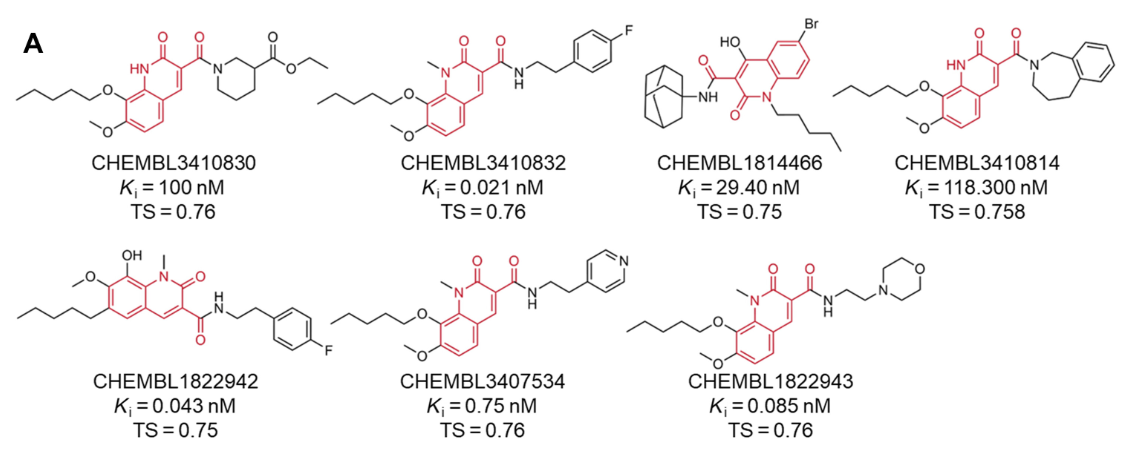
MCS i: نواة الكينولين ثنائي الكيتون
بالنسبة إلى MCS i، استرجع الباحثون من قاعدة بيانات ChEMBL وحددوا 49 مركبًا تحتوي على البنية الفرعية المحددة مسبقًا، ويكون TS بينها وبين استعلامات البصمات الجزيئية المُولَّدة ≥ 0.75. كما هو موضح في الشكل أدناه، أُبلغ عن 7 مركبات ذات نشاط عالٍ تجاه CB2 (Ki أقل من 10 μM).
في قاعدة بيانات ZINC، استرجع الباحثون وحددوا 32 مركبًا تحتوي على البنية الفرعية MCS i، ويكون TS ≥ 0.75. تُظهر بعض المركبات المرشحة التمثيلية وقيم TS المقابلة لها في الشكل أدناه:
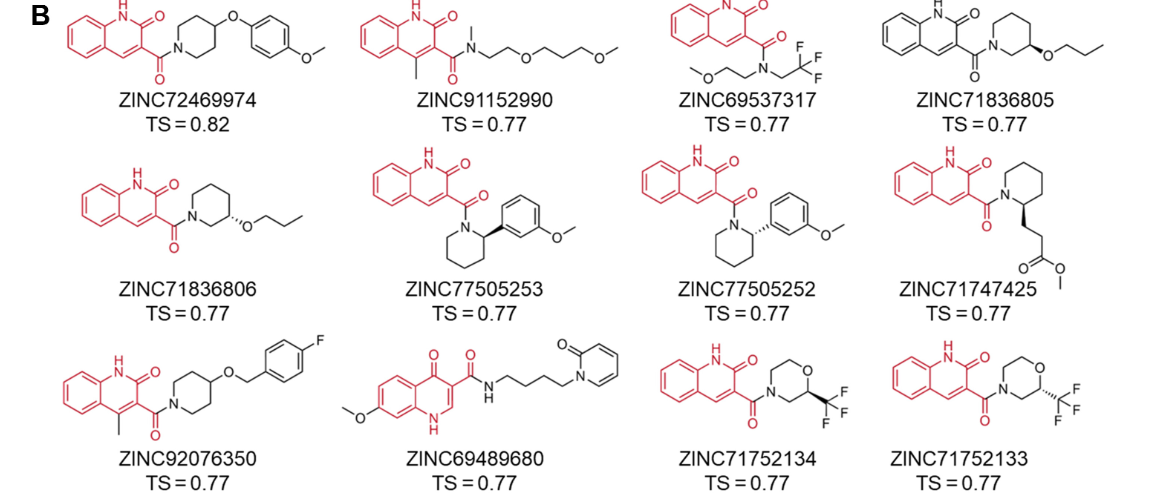
أظهر معظم هذه المركبات المرشحة درجات إرساء جزيئية متوقعة أفضل مع CB2 مقارنة بـ CB1، مما يشير إلى أنها قد تمتلك تفضيلًا للارتباط بـ CB2 في ترتيب أولويات المركبات المرشحة القائم على الإرساء الجزيئي.
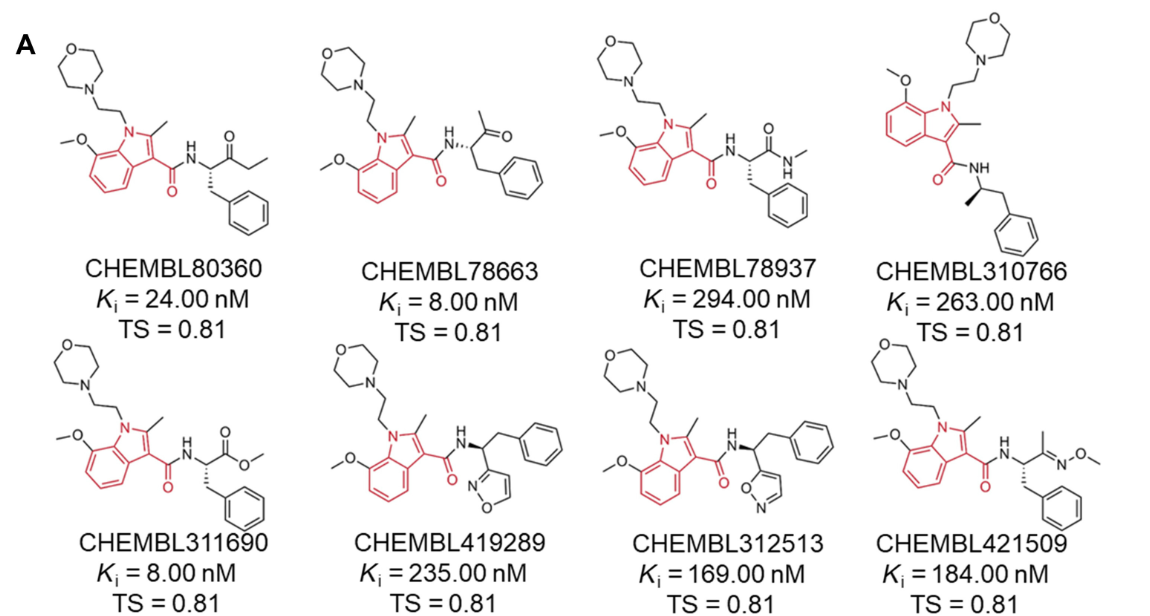
MCS ii: نواة إندول كاربوكساميد
بالنسبة إلى MCS ii، استرجع الباحثون من قاعدة بيانات ChEMBL وتأكدوا من 24 مركبًا تحتوي على البنية الفرعية المحددة مسبقًا، والتي يبلغ TS ≥ 0.80 بينها وبين استعلام البصمة الجزيئية المُولَّدة. من بين هذه المركبات، أظهر 8 مركبات ألفة ربط قوية لـ CB2 (كما هو موضح أدناه)، مما يؤكد بشكل أكبر أن استراتيجية DRUG-GAN المقيدة بالهيكل فعّالة في استرجاع أنواع البنى الكيميائية المرتبطة بـ CB2.
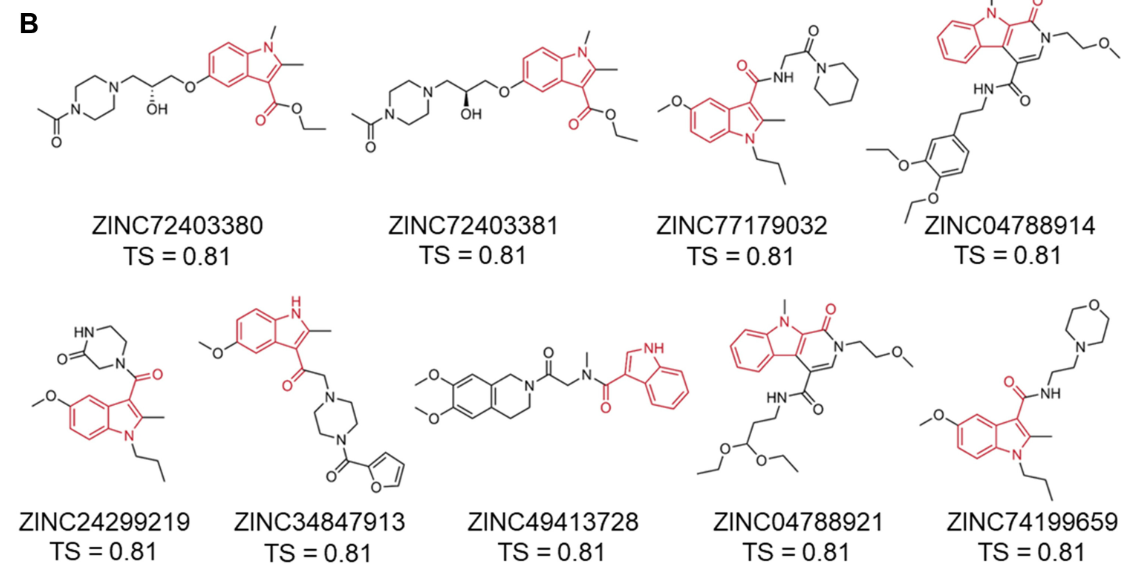
في قاعدة بيانات ZINC، اكتشف الباحثون 9 مركبات تحتوي على البنية الفرعية MCS ii، مع TS ≥ 0.80 (كما هو موضح أدناه). وبشكل مشابه للمركبات المرشحة في MCS i، تمتلك معظم هذه المركبات درجات ربط تنبؤية أفضل مع CB2 مقارنة بـ CB1، مما يشير إلى إمكانية إجراء فحص مستهدف لـ CB2 بشكل أعمق.
MCS iii: هيكل إندول-سلفوناميد
بالنسبة إلى MCS iii، استرجع الباحثون في البداية 165 مركبًا من قاعدة بيانات ChEMBL عند TS ≥ 0.75. ومع ذلك، من خلال تحليل البصمة الجزيئية FP2، تم التأكد في النهاية من احتواء مركبين فقط على البنية الفرعية المطابقة تمامًا لـ MCS iii (كما هو موضح أدناه).
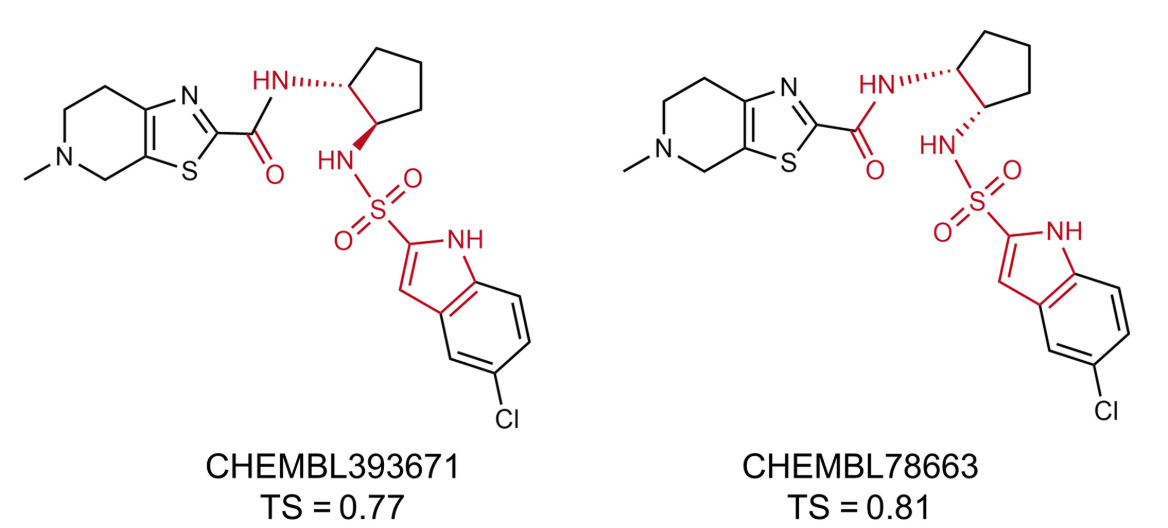
علاوة على ذلك، في قاعدة بيانات ZINC، لم تجتز جميع المركبات المسترجعة عند TS ≥ 0.75 التحقق، أي لم يتم تأكيد احتواء أي مركب على البنية الفرعية المطابقة تمامًا لـ MCS iii.
تشير النتائج المجمعة إلى أن استراتيجية DRUG-GAN المقيدة بالهيكل يمكنها، مع الحفاظ على السمات البنيوية الكيميائية المرتبطة بـ CB2، توسيع الفضاء الكيميائي الذي تمثله روابط التدريب، واكتشاف مركبات مرشحة جديدة مختلفة بنيويًا.
خاتمة
لإعطاء الأولوية في اختيار المركبات المرشحة الواعدة، يستخدم FSGLD سير عمل هرميًا لتقييم المركبات المسترجعة، يشمل الربط الجزيئي، وتقييم LRIP الخاص بالهدف، ومحاكاة الديناميكا الجزيئية (MD)، وحسابات طاقة الربط الحرة MM-PBSA، وحسابات التكامل الحراري، مع إجراء تحقق تجريبي لبعض المركبات المرشحة. ومن خلال دمج هذه الأساليب التكاملية في سير عمل موحد، وضع FSGLD إطارًا بحثيًا عمليًا لإعطاء الأولوية للمركبات المرشحة الريادية وتوفير أساس للتقييمات التجريبية اللاحقة.
مع التطور المستمر لطرق التنبؤ بهيكل البروتينات وطرق الطي المشترك، يتوقع الباحثون أن تتحسن دقة إطار FSGLD ومتانته ومدى نطاقه تباعًا. ستقوم الأبحاث المستقبلية بتقييم DRUG-GAN وFSGLD في نطاق أوسع من عائلات الأهداف، بما في ذلك القنوات الأيونية والمستقبلات النووية، مع إدخال استراتيجيات متقدمة للتعلم من عينات قليلة والتعلم من مجموعات بيانات صغيرة، لتحسين أداء النماذج في سيناريوهات محدودية البيانات.
المراجع: