Command Palette
Search for a command to run...
دقة التعريف في التعلم بدون أمثلة تبلغ 95.4%؛ معهد ماساتشوستس للتكنولوجيا وآخرون يقترحون نموذج CLaC لتحقيق محاذاة بين هياكل المواد واللغة عبر الوسائط المتعددة

تُعدّ مهمة اكتشاف المواد من المهام الأساسية، وتتمثل في انتقاء المواد المرشحة ذات الأداء المستهدف من بين فضاء كيميائي وهيكلي هائل. في السنوات الأخيرة، حققت الشبكات العصبية الرسومية (Graph Neural Networks) تقدماً ملحوظاً في مهام مثل التنبؤ بخصائص المواد وتوليد الهياكل، وذلك من خلال تعلم البنية الذرية ثلاثية الأبعاد للبلورات. ومع ذلك، تعتمد هذه النماذج عادةً على تسميات أو شروط عددية محددة مسبقاً للخصائص، مما يصعب عليها فهم متطلبات المواد الموصوفة بلغة طبيعية بشكل مباشر؛ على الرغم من أن النماذج اللغوية الكبيرة تتقن معالجة النصوص، إلا أنها تفتقر إلى تمثيل دقيق للبنية المكانية للبلورات وخصائصها الفيزيائية.
إن الجمع بين البنية البلورية واللغة الطبيعية يوفر مساراً جديداً لاكتشاف المواد. لكن حجم قواعد البيانات البلورية الحالية محدود، كما تركز الأدبيات الأكاديمية على عدد قليل من المواد الشائعة، مما يؤدي إلى نقص في العلاقات الكافية بين الأوصاف النصية وخصائص المواد، وهذا يعيق فعالية تدريب النماذج متعددة الوسائط.
لمعالجة هذه المشكلة، اقترح باحثون من معهد ماساتشوستس للتكنولوجيا (MIT)، ومعهد أولسان للعلوم والتكنولوجيا (UNIST) في كوريا الجنوبية، وجامعة إلينوي في أوربانا شامبين (UIUC)، ومختبر MIT-IBM Watson للذكاء الاصطناعي، نموذج اللغة-البلورات التبايني (Contrastive Language-Crystals، CLaC). يقوم هذا النموذج بتوليد روايات تركيبية تستند إلى خصائص المواد باستخدام النماذج اللغوية الكبيرة، ومن خلال التعلم التبايني، يربط بين البنية البلورية واللغة الطبيعية في فضاء تمثيلي مشترك. أظهرت التجارب أن نموذج CLaC يتفوق بشكل واضح على النماذج المدربة مباشرة على نصوص الأدبيات الأكاديمية في مهام فهم المواد دون عينات تدريبية (Zero-shot) ومهام استرجاع المواد الموجهة بلغة طبيعية.
تم نشر نتائج البحث ذات الصلة تحت عنوان "توسيع نطاق تعلم تمثيلات المواد متعددة الوسائط باستخدام الروايات التركيبية" (Scaling multimodal materials representation learning with synthetic narratives) في مجلة Nature Communications.
رابط الورقة البحثية:
https://www.nature.com/articles/s41467-026-76378-7#Sec10
بيانات زوجية مكوّنة من 126,000 مجموعة بلورة-نص، لتوسيع تغطية الدلالات اللغوية للمواد
لتدريب نموذج متعدد الوسائط للبلورات، يجب أولاً إنشاء علاقة مقابلة بين البنية البلورية واللغة الطبيعية. على الرغم من أن قواعد بيانات المواد الحالية قد جمعت كميات كبيرة من البنى البلورية والخصائص المحسوبة، إلا أن النصوص ذات الصلة متناثرة بشكل أساسي في الأوراق الأكاديمية، وتركز على عدد قليل من المواد المدروسة جيداً. وهذا يجعل من الصعب تغطية تنوع البنى البلورية، كما لا يمكن ضمان احتواء النصوص على معلومات كاملة حول خصائص المواد.
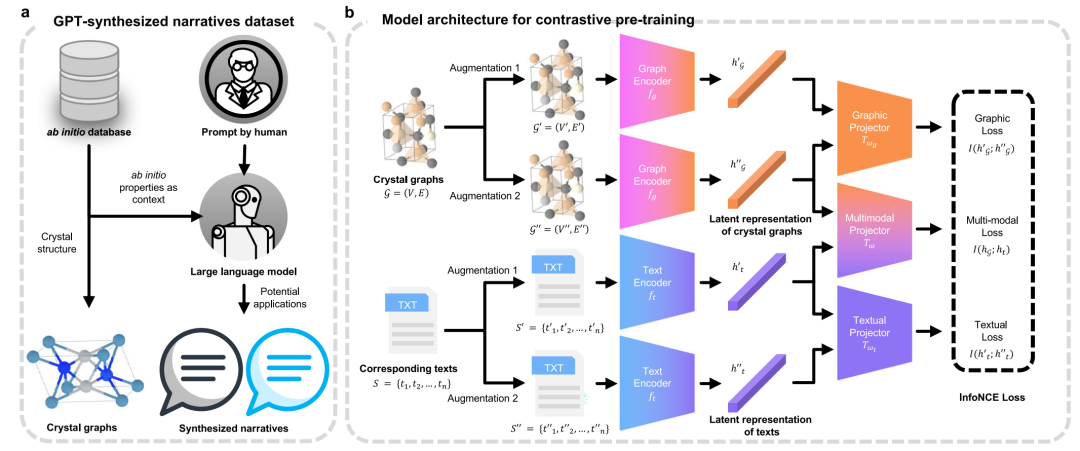
ولهذا السبب، اعتمدت هذه الدراسة على قاعدة بيانات Materials Project كأساس، حيث جمعت حوالي 126,000 مجموعة بيانات لمواد بلورية، وقامت ببناء هياكل رسومية بلورية وأوصاف لغوية طبيعية لكل منها. تم تحويل البنى البلورية إلى بيانات رسومية باستخدام أداة Jarvis-tools، لتمثيل البنية ثلاثية الأبعاد عبر الذرات وتفاعلاتها. أما بالنسبة للنصوص، فقد استخدمت مجموعة بيانات الروايات التركيبية المطورة مسبقاً بواسطة فريق البحث باستخدام GPT، حيث تقوم النماذج اللغوية الكبيرة بتوليد نصوص وصفية بناءً على الخصائص المحسوبة في قاعدة بيانات المواد.
على عكس التحويل البسيط للصيغ الكيميائية أو التكوين العنصري إلى نص، تستند الروايات التركيبية إلى الخصائص المحسوبة للمواد، وتشمل معلومات حول الميزات الهيكلية، والخصائص الفيزيائية، والسلوك الوظيفي، والتطبيقات المحتملة. على سبيل المثال، يتم توليد أوصاف تتضمن الميزات الفيزيائية ذات الصلة ومعلومات التطبيق بناءً على بيانات معروفة مثل التكوين، والفجوة النطاقية، والكثافة لنوع معين من البلورات، مما ينشئ علاقة مقابلة بين البنية البلورية ودلالات مواد أكثر ثراءً.
للتحقق من فعالية الروايات التركيبية، قام الباحثون أيضاً ببناء مجموعة بيانات مقارنة مستمدة من الأدبيات الأكاديمية. باستخدام الصيغ الكيميائية كمعايير بحث، استخرجوا فقرات ذات صلة من النص الكامل لحوالي 4 ملايين ورقة علمية، وحصلوا في النهاية على حوالي 400,000 زوج من بيانات المواد والجمل باللغة الطبيعية، لكنها غطت فقط حوالي 400 مركب غير عضوي. بالمقارنة، فإن عدد أنواع البلورات المختلفة المغطاة بواسطة الروايات التركيبية المولدة بواسطة GPT يعادل حوالي 300 ضعف تلك المغطاة ببيانات الأدبيات الأكاديمية.
تم استخدام فئتي بيانات النص على حدة لتدريب نسخة CLaC-Synthetic (الإصدار المستند إلى الروايات التركيبية) ونسخة CLaC-Paper (الإصدار المستند إلى الأدبيات الأكاديمية)، لمقارنة تأثير مصادر البيانات المختلفة على أداء النموذج. تم تقسيم مجموعات البيانات بنسبة 8:1:1 إلى مجموعات تدريب، وتحقق، واختبار.
دمج الشبكات العصبية الرسومية مع النماذج اللغوية لتحقيق محاذاة بين البنية البلورية واللغة الطبيعية
استلهم نموذج CLaC منهج التعلم التبايني في مجال اللغة البصرية من نموذج CLIP، ومن خلال التعلم المشترك للبنى البلورية والأوصاف النصية، يقوم بربط نوعي المعلومات في فضاء تمثيلي مشترك، مما يتيح للنموذج حساب التشابه الدلالي بين المواد واللغة الطبيعية.
يعتمد نموذج CLaC على بنية مشفر مزدوج (Dual-Encoder)، تتكون من مشفر للرسوم البيانية البلورية، ومشفر للنص، ووحدة إسقاط متعددة الوسائط. مسؤول عن استخراج معلومات مثل التكوين الذري، وبيئة التنسيق المحلية، والبنية الهندسية ثلاثية الأبعاد؛ بينما يعالج مشفر النص الأوصاف الطبيعية المتعلقة بخصائص المواد، والميزات الوظيفية، ومتطلبات التطبيق. يتم تحويل كلا النوعين من المعلومات إلى متجهات، ثم تدخل إلى فضاء كامن موحد عبر وحدة الإسقاط، مما ينشئ علاقة مقابلة بين البنية البلورية ودلالات النص.
في جانب ترميز البنية البلورية، اعتمدت هذه الدراسة شبكة PaiNN (شبكة عصبية للتفاعل الذري القابل للاستقطاب - Polarizable Atom Interaction Neural Network)، والتي تتعلم العلاقات المكانية بين الذرات من خلال آلية نقل الرسائل المتغيرة (Equivariant Message Passing)، مما يلتقط البيئة الذرية المحلية مع الحفاظ على المعلومات الهندسية. كما تم إدخال CGCNN ونموذج الجهد الذري المسبق التدريب ORB كنماذج مقارنة.
أما بالنسبة لمشفر النص، فقد تمت مقارنة نماذج لغوية مسبقاً مدربة مثل SciBERT، و MatSciBERT، و OPT-125M، و Galactica-125M، والتي تشمل معماريات الترميز ثنائي الاتجاه والتلقائي (Autoregressive). بناءً على نتائج التجارب اللاحقة، اعتمد الباحثون في النهاية مزيج PaiNN مع Galactica-125M كمجموعة المشفرات الرئيسية.
الأساس في CLaC هو التعلم التبايني عبر الوسائط المتعددة. أثناء التدريب، تُعتبر المخططات البلورية والوصف النصي لنفس المادة أزواجاً موجبة، بينما تشكل التوليفات بين هياكل المواد المختلفة ونصوصها أزواجاً سالبة. من خلال دالة الخسارة التباينية InfoNCE، يعمل النموذج على زيادة تشابه المتجهات للأزواج الصحيحة وتقليل التشابه بين العينات غير المتطابقة، مما يتعلم تدريجياً العلاقات بين البنية البلورية، والخصائص الفيزيائية، واللغة الطبيعية.
نظراً لمحدودية بيانات الأزواج، أضافت هذه الدراسة أيضاً التعلم التبايني داخل الوسائط، مما يمكّن النموذج من التعرف على التمثيلات البنيوية المختلفة لنفس البلورة، وعلى الأوصاف النصية المختلفة لنفس المادة. في هذا السياق، يتم تعزيز بيانات مخططات البلورات عن طريق اضطراب مواقع الذرات وإجهاد الشبيكة بنسبة 0–5%؛ أما النصوص فتُعالج عن طريق الحذف العشوائي وإعادة ترتيب الجمل لتوليد نسخ مختلفة، مع احتمال 50% للاحتفاظ بكل جملة. تعزز هذه الأساليب من متانة النموذج تجاه التغيرات البنيوية الطفيفة واختلافات الصياغة النصية. لم يلجأ الباحثون إلى استبدال العناصر ضمن نفس العائلة الكيميائية، لأن ذلك قد يغير البيئة التنسيقية، والبنية الإلكترونية، والخصائص الفعلية للمادة.
خلال عملية التدريب المسبق، يتم تدريب مشفر مخططات البلورات من الصفر، بينما تُهيأ مشفرات النص بأوزان مُدربة مسبقاً. يستخدم النموذج مساحة تضمين مشتركة بـ 512 بُعداً، ومُحسّن AdamW، بمعدل تعلم قدره 2×10⁻⁵، وحجم دفعة فعالة يبلغ 256، ولمدة تصل إلى 5 دورات تدريبية كحد أقصى.
بعد إكمال التدريب المسبق، يمكن لـ CLaC تحويل الاستعلامات باللغة الطبيعية إلى متجهات، ومقارنة تشابهها مع المتجهات البلورية المحسوبة مسبقاً في قاعدة بيانات المواد، مما يتيح تصفية المواد المرشحة ذات الخصائص المستهدفة، دون الحاجة إلى إعادة تدريب النموذج لكل خاصية. ومع ذلك، لا يقوم CLaC نفسه بتوليد الهياكل البلورية مباشرة؛ ودوره الرئيسي هو بناء جسر بين اللغة والبنية البلورية، مما يدعم التصميم العكسي للمواد في المراحل اللاحقة.
من فهم المواد بدون أمثلة إلى الاسترجاع باللغة الطبيعية، التحقق من فعالية التعلم عبر الوسائط المتعددة
لتقييم أداء CLaC، صمم الباحثون عدة تجارب بدون أمثلة (Zero-shot)، تركز على فحص قدرة النموذج على فهم البلورات، والاسترجاع باللغة الطبيعية، وتمثيل الخصائص الفيزيائية، مع مقارنته بنماذج أساسية مثل النموذج غير المدرب، و Gemma-3-1b-it، و CLaC-Paper.
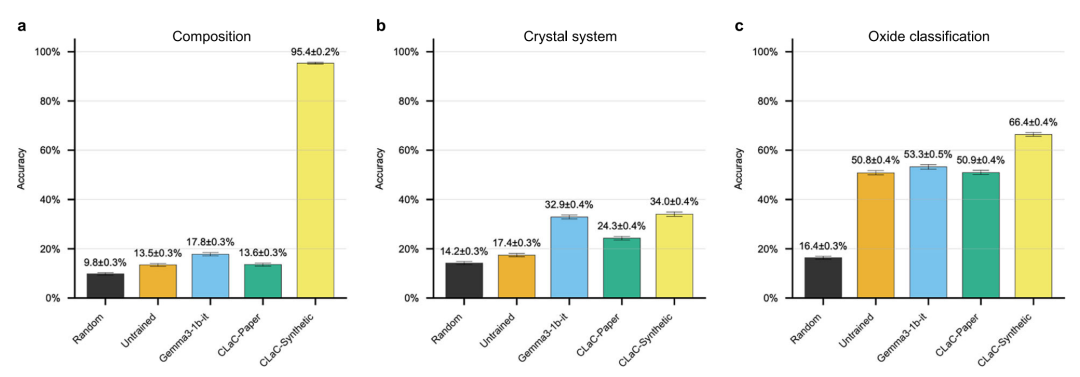
أولاً، في تجارب الفهم متعدد الوسائط بدون أمثلة، يجب على النموذج اختيار الوصف الصحيح من بين عدة نصوص مرشحة بناءً على البنية البلورية، بما يشمل ثلاث مهام: تصنيف التركيب العنصري، والنظام البلوري، ونوع الأكاسيد. أظهرت النتائج أن دقة CLaC-Synthetic في تصنيف التركيب العنصري بلغت 95.4% ± 0.2%، وهو أعلى بكثير من دقة Gemma-3-1b-it البالغة 17.8% و CLaC-Paper البالغة 13.6%؛ كما بلغت دقة تصنيف الأكاسيد 66.4% ± 0.4%، متفوقةً أيضاً على النماذج الأخرى.
ومع ذلك، بلغت دقة CLaC-Synthetic في تصنيف النظام البلوري 34.0% ± 0.4% فقط، وهي قريبة من دقة Gemma-3-1b-it البالغة 32.9%. قد يعزى ذلك إلى عدم التوازن في توزيع بيانات الأنظمة البلورية وحجم الدفعات التدريبي الصغير، مما يشير إلى أن فهم النموذج لا يزال محدوداً بالنسبة للميزات الهندسية الدقيقة مثل التناظر البلوري.
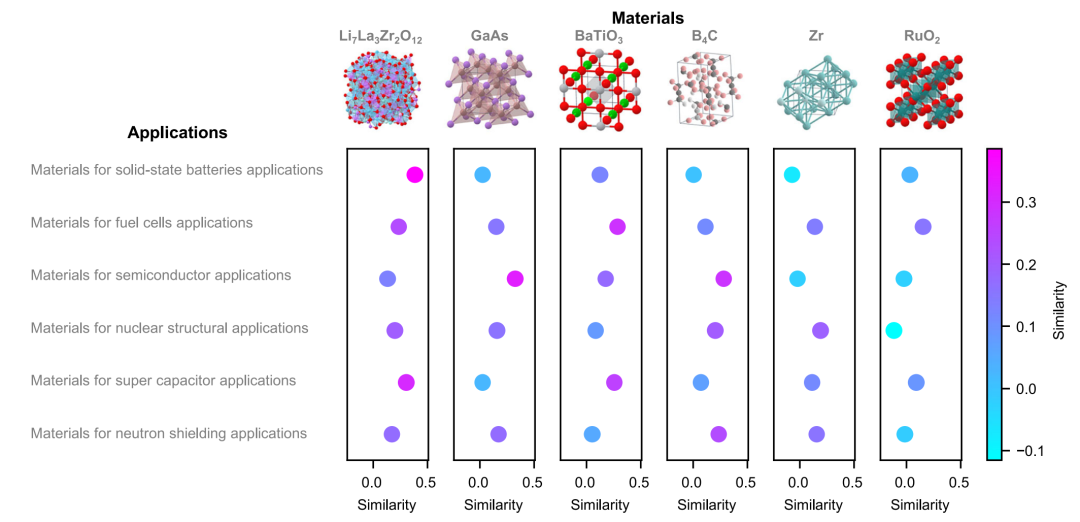
اختار الباحثون أيضاً ست مواد نموذجية مثل Li₇La₃Zr₂O₁₂، و GaAs، و BaTiO₃، بالإضافة إلى ست فئات من سيناريوهات التطبيق مثل البطاريات الصلبة، وأشباه الموصلات، والمكثفات الفائقة، لتحليل التشابه بين أوصاف المواد والتطبيقات. أظهرت النتائج أن النموذج قادر على تحديد الارتباطات النموذجية مثل Li₇La₃Zr₂O₁₂ مع البطاريات الصلبة، و GaAs مع أشباه الموصلات، و RuO₂ مع المكثفات الفائقة، مما يدل على أن تمثيلات النموذج تتضمن معرفة معينة حول وظائف المواد وتطبيقاتها.
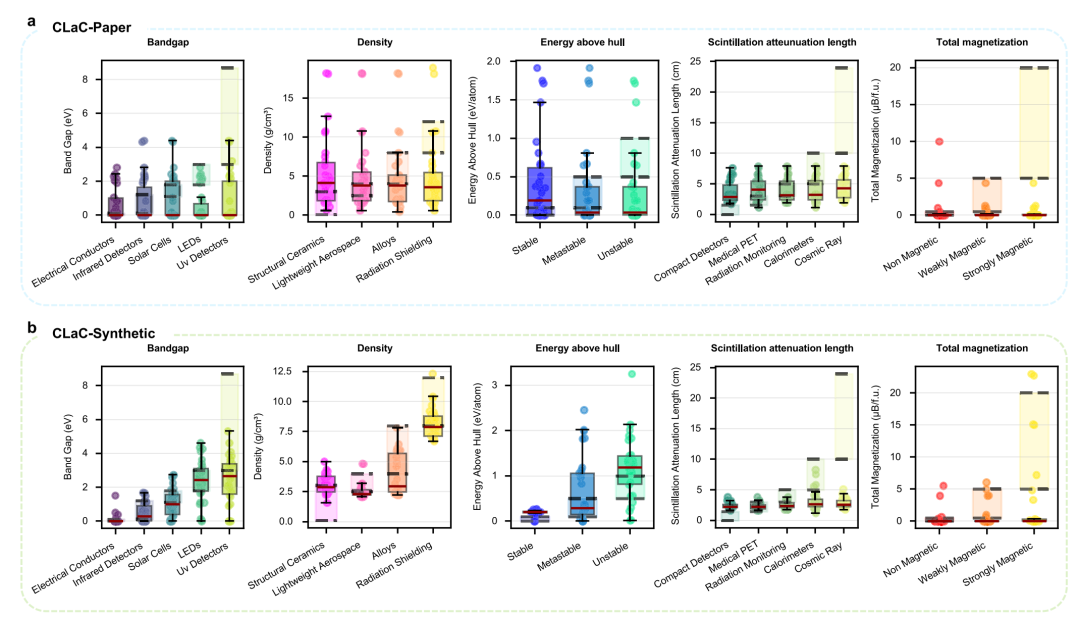
في تجارب التصميم العكسي بدون أمثلة، عكس الباحثون اتجاه التنبؤ بالخصائص التقليدي، فقاموا باسترجاع المواد المرشحة بناءً على وصف باللغة الطبيعية للأداء المستهدف. شملت التجارب خمس خصائص: فجوة النطاق، والكثافة، وفرق طاقة الغلاف المحدب، وطول التوهج وميضياً، والمغنطة الكلية. لكل استعلام، يسترجع النموذج أعلى 30 مادة تشابهاً، ويتم قياس الفرق بين الخصائص الحقيقية والقيم المستهدفة باستخدام متوسط الخطأ المطلق (MAE).
أظهرت النتائج أن يتفوق CLaC-Synthetic على الأساس العشوائي في استرجاع الخصائص الخمس جميعها. حيث بلغ متوسط الخطأ المطلق لاسترجاع فجوة النطاق 0.641 eV، وهو أقل من 1.185 eV للاسترجاع العشوائي؛ وللكثافة، بلغ 0.799 g/cm³ مقارنة بـ 2.148 g/cm³؛ ولطول التوهج وميضياً، بلغ 1.033 cm مقارنة بـ 2.697 cm. بينما كان الأداء العام لـ CLaC-Paper قريباً من الاختيار العشوائي، مما يدل على أن السرد التخليقي المولد بناءً على الخصائص المحسوبة أكثر ملاءمة لبناء العلاقة بين اللغة وخصائص المواد من النص المستخرج مباشرة من الأدبيات الأكاديمية.
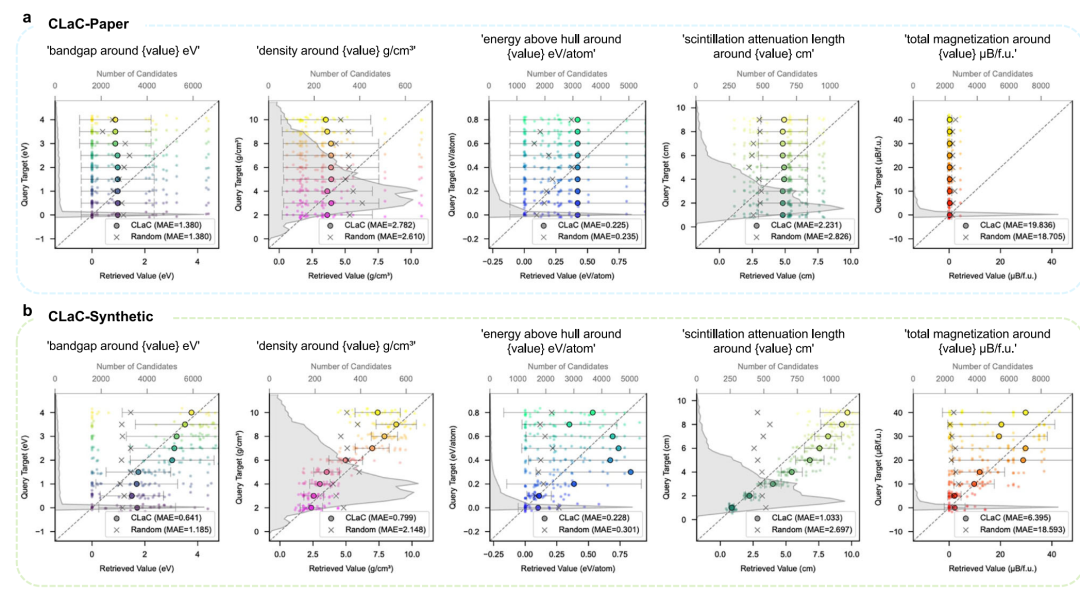
بالإضافة إلى القيم الدقيقة، اختبرت الدراسة أيضاً أوصافاً نوعية مثل «فجوة نطاق عالية، وكثافة منخفضة، ومغناطيسية قوية». وأظهرت النتائج أن توزيع خصائص المواد المسترجعة بواسطة CLaC-Synthetic يتغير تبعاً للدلالة الاستعلامية، فعلى سبيل المثال، عند التحول من فجوة نطاق منخفضة إلى فجوة نطاق عالية، تزداد فجوة النطاق للمواد المرشحة بشكل متوافق. في المقابل، يصعب على CLaC-Paper تكوين هذا التمييز، مما يشير إلى أن السرد الاصطناعي يساعد النموذج على فهم العلاقة بين الأوصاف النوعية والخصائص الفيزيائية الفعلية.
في التحقق التطبيقي، اتخذ الباحثون استخلاص الإلكتروليتات الصلبة للبطاريات كمثال، حيث أجروا عمليات بحث بناءً على معايير المواد المحتوية على الليثيوم وفجوة النطاق العالية. احتوت جميع المواد المرشحة ضمن أفضل 30 مرتبة على عنصر الليثيوم، وبلغ متوسط فجوة النطاق لديها 3.23 إلكترون فولت. وقد تم تحديد Li₆PClO₅، الذي احتل المرتبة الرابعة، كمادة مرشحة محتملة في دراسات أخرى، كما تم تحضير Li₄SiO₄، الذي احتل المرتبة التاسعة، كفيلم إلكتروليت صلب. ومع ذلك، نظراً لأن بيانات التدريب لا تتضمن معلومات عن الموصلية الأيونية، لا يمكن للنتائج الحالية إثبات استيفاء هذه المواد لجميع متطلبات الأداء للإلكتروليتات الصلبة.
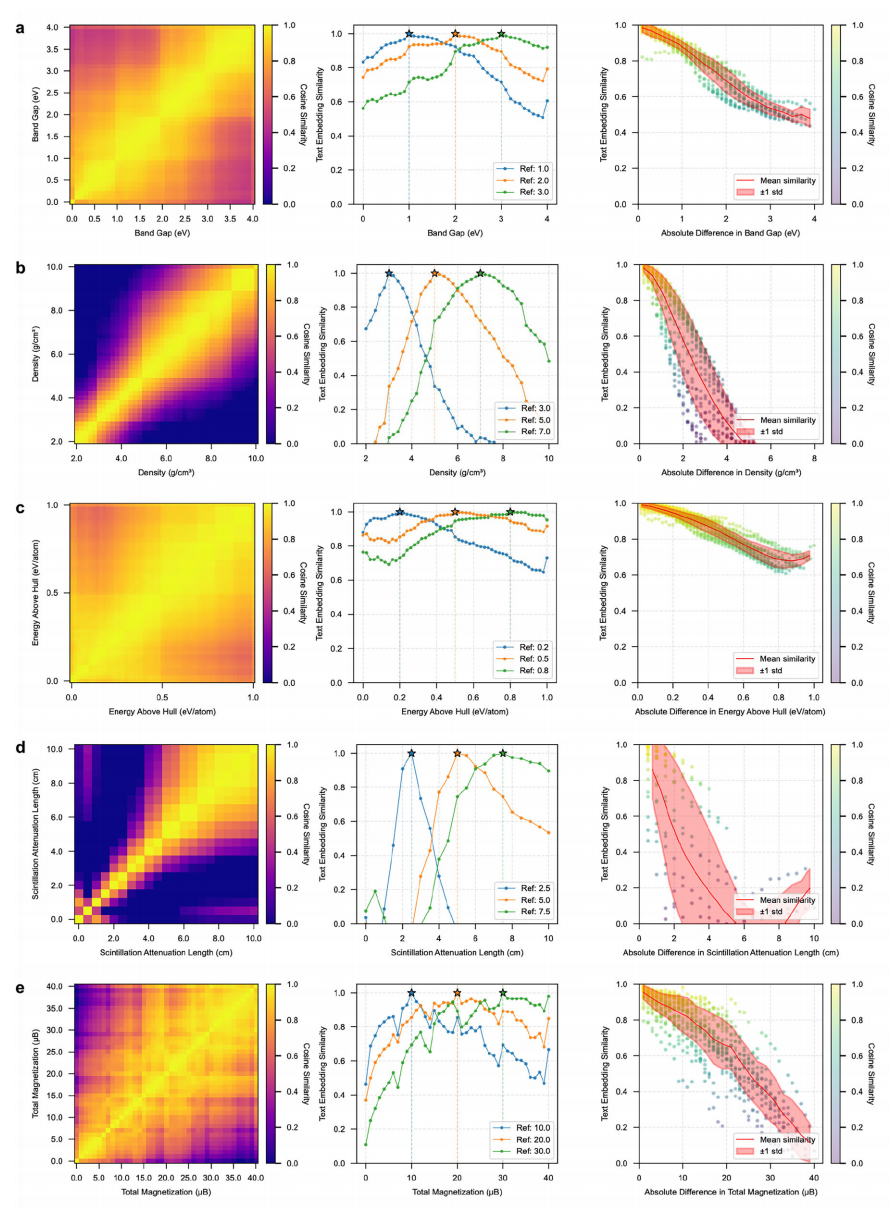
ولتحليل كيفية فهم النموذج للمعلومات الرقمية، فحصت الدراسة بشكل أعمق استمرارية الخصائص في فضاء تضمين النصوص. أظهرت النتائج أن تشابه المتجهات في CLaC-Synthetic ينخفض تدريجياً مع زيادة الاختلاف في القيم الرقمية للخصائص. فعلى سبيل المثال، باستخدام فجوة نطاق 2.0 إلكترون فولت كمرجع، عندما تزداد قيمة الاستعلام إلى 4.0 إلكترون فولت، ينخفض تشابه جيب التمام من 1.0 إلى حوالي 0.65، مما يدل على قدرة النموذج على التعبير عن العلاقات الكمية للكميات الفيزيائية. حيث ينخفض تشابه الكثافة وطول تخميد الوميض بسرعة أكبر، مما يتوافق مع دقة استرجاع أعلى؛ بينما يتغير فرق طاقة الغلاف المحدب بشكل أكثر اعتدالاً، مما يؤدي إلى خطأ استرجاع أكبر. بالمقارنة، لم يُظهر كل من CLaC-Paper و Galactica-125M غير المحاذاة عبر الوسائط علاقات رقمية مستمرة واضحة.
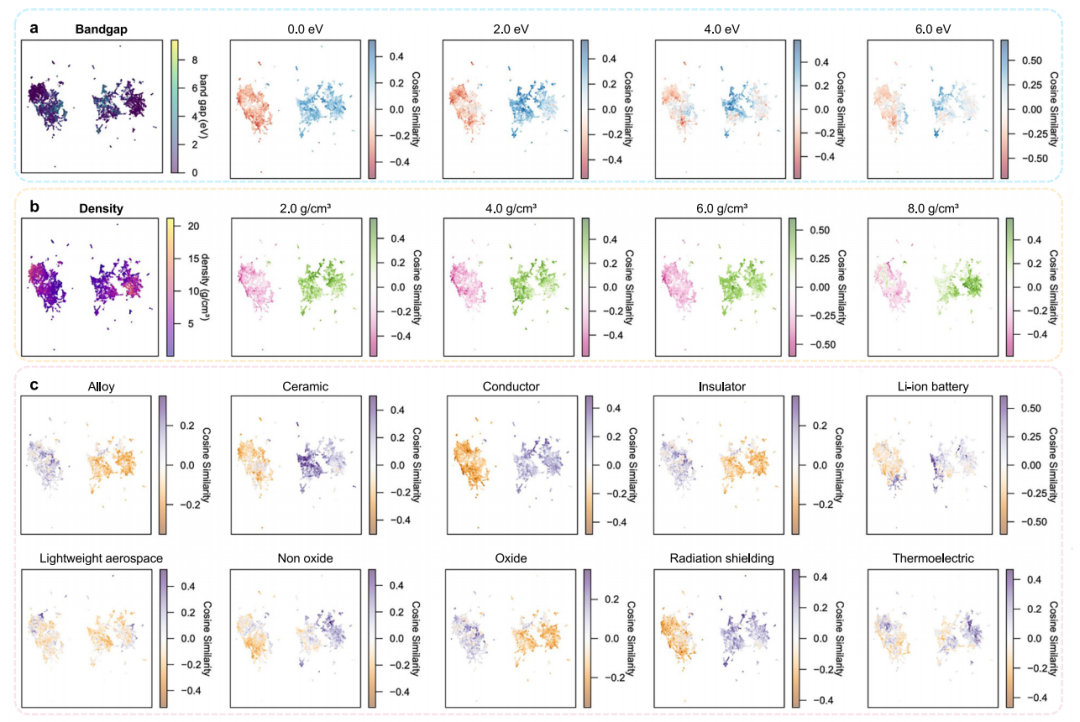
أخيراً، قام الباحثون بتصور الفضاء الكامن لكل من البنية البلورية وتمثيل النص باستخدام UMAP. على الرغم من أن الوسائط تشكل عناقيد نسبية الاستقلالية، إلا أن علاقات الجوار للمواد تتطابق بشكل كبير: حوالي 57% من أقرب 50 جاراً في فضاء الرسم البياني البلوري تظهر أيضاً ضمن أقرب 50 جاراً في فضاء النص، وهي نسبة أعلى بكثير من 0.4% في الحالات العشوائية. بالإضافة إلى ذلك، تظهر الخصائص الفيزيائية مثل فجوة النطاق والكثافة توزيعات منتظمة، كما تقابل الأوصاف مثل «سيراميك»، «موصل»، و«بطارية ليثيوم أيون» مناطق بلورية مختلفة، مما يؤكد قدرة النموذج على التمثيل عبر الوسائط لخصائص المواد وفئات وظائفها.
كلمة أخيرة
تُظهر أبحاث CLaC أن المفتاح في التعلم متعدد الوسائط للمواد البلورية لا يكمن فقط في حجم البيانات، بل أيضاً في إمكانية إقامة علاقة مقابلة دقيقة بين خصائص المواد واللغة الطبيعية. من خلال توليد سرد اصطناعي استناداً إلى الخصائص الحسابية، حقق CLaC أداءً يتفوق على النماذج المدربة على نصوص الأدبيات في فهم المواد دون أمثلة (Zero-shot) والاسترجاع الموجه باللغوي. ومع ذلك، لا يزال النموذج قصيراً في مهام البنية الدقيقة مثل تحديد النظام البلوري، ويصعب عليه حالياً التعامل مع أنظمة معقدة مثل المواد متعددة البلورات، والهياكل المعيبة، والأطر المعدنية العضوية، كما لا يمكنه توليد هياكل بلورية جديدة مباشرة. في المستقبل، تظل كيفية تحسين دقة البيانات الاصطناعية، وتوسيع نطاق تطبيق النموذج للمواد المعقدة، ودمج الاسترجاع اللغوي مع توليد البلورات والتحقق الفيزيائي، تحديات يجب حلها لجعل هذه النماذج قابلة للتطبيق في تصميم المواد العملي.