HyperAI
Command Palette
Search for a command to run...
Papers
최신 AI 트렌드를 파악할 수 있도록 매일 업데이트되는 최첨단 AI 연구 논문
개의 논문
KV 캐시 스티어링을 이용한 소형 언어 모델에서의 추론 유도
NeuralOS: 신경망 생성 모델을 이용한 운영 체제 시뮬레이션
CLiFT: 컴퓨트 효율적이고 적응형 라이트 필드 토큰을 위한 압축 기법
시스템-오브-시스템 모델링 및 최적화: 다모드 이동성의 통합 프레임워크
전체 원자 확산 변환기: 분자와 재료의 통합 생성 모델링
OST-Bench: 온라인 공간-시간 장면 이해에서 MLLM의 능력 평가
추적 가능한 증거 강화 시각적 근거 추론: 평가 및 방법론
MIRIX: LLM 기반 에이전트를 위한 다중 에이전트 메모리 시스템
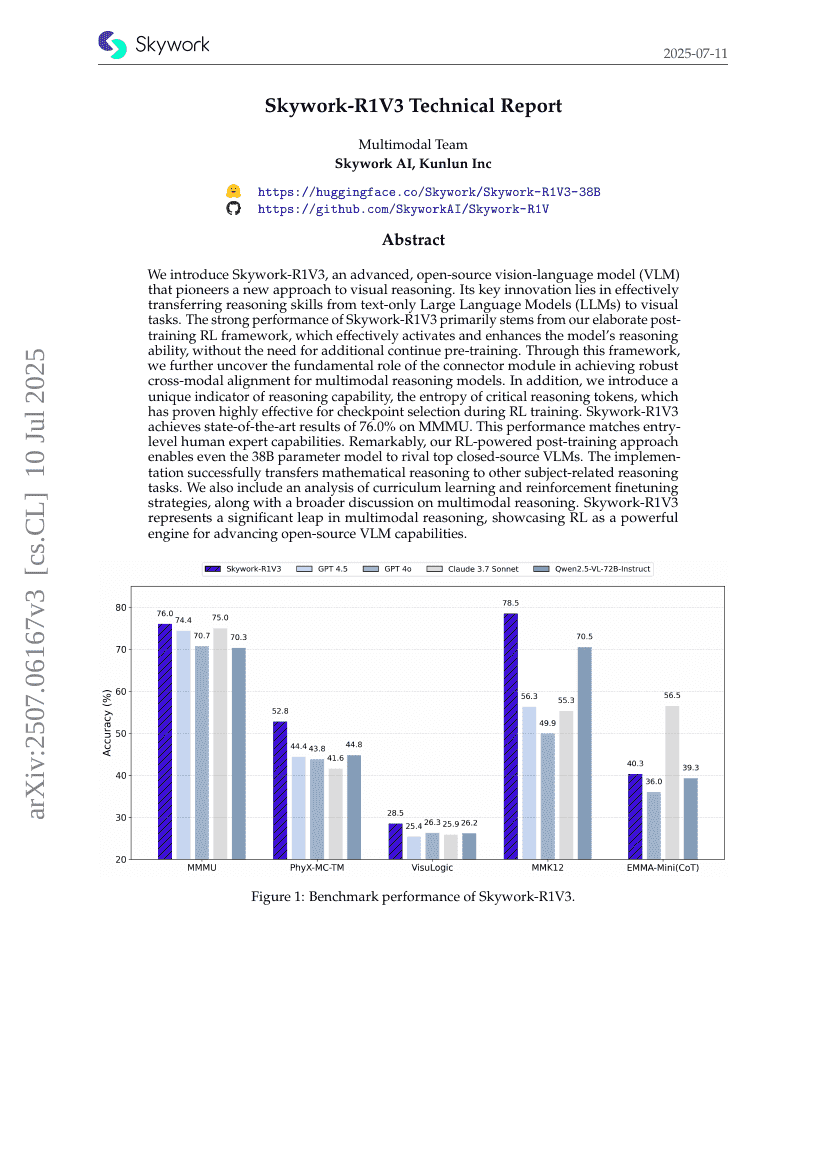
Skywork-R1V3 기술 보고서
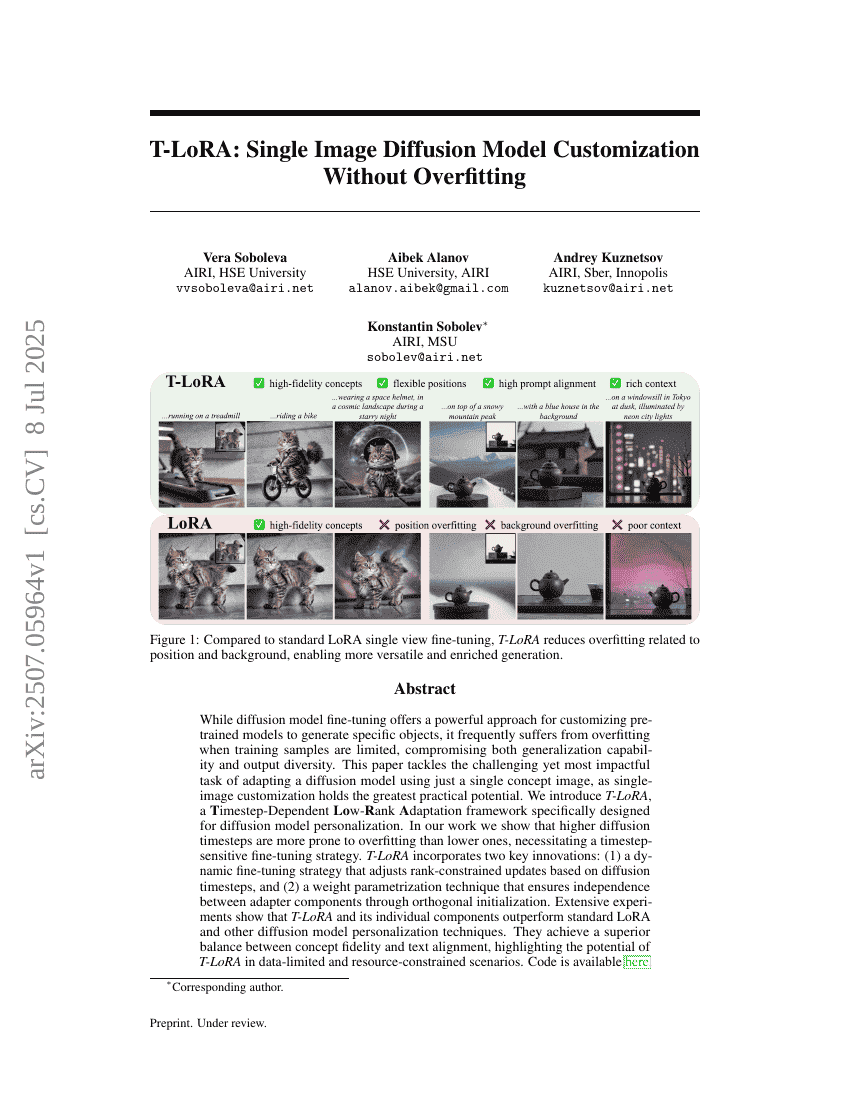
T-LoRA: 단일 이미지 확산 모델의 과적합 없이 맞춤화
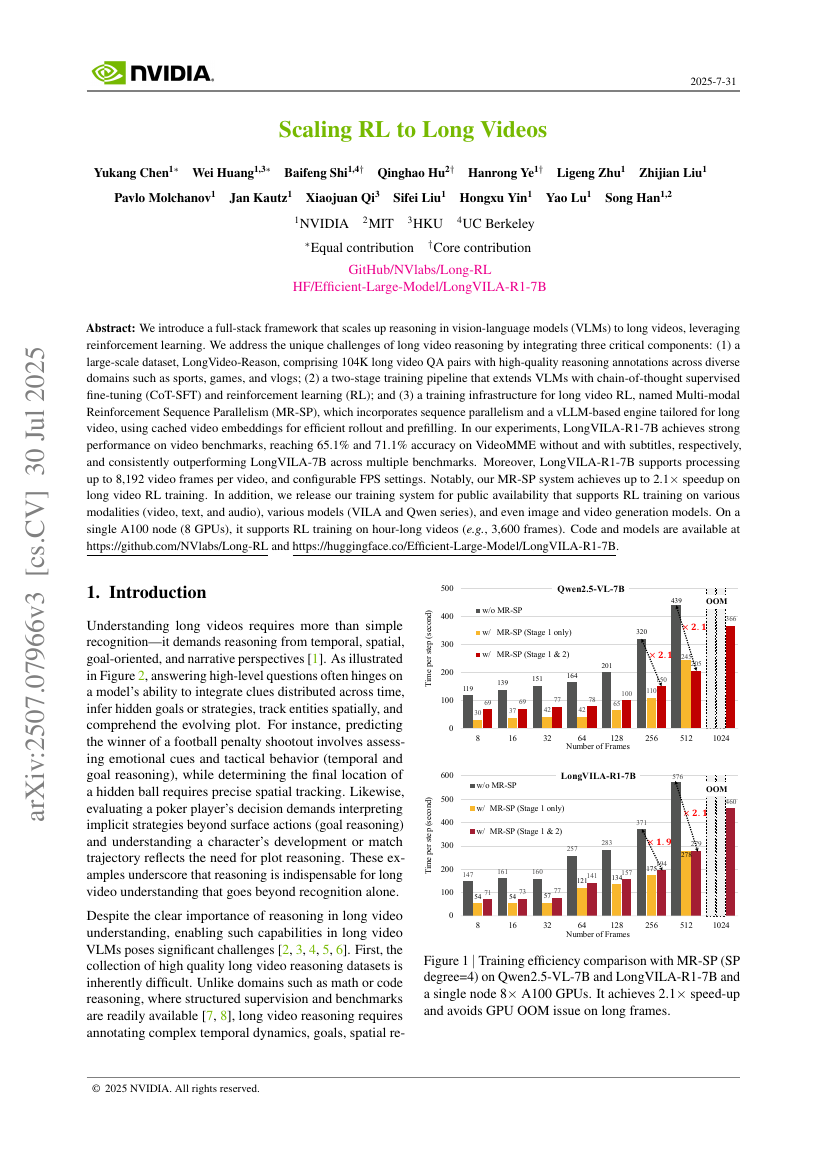
장기 비디오에 RL 확장
세계 모델에 대한 비평
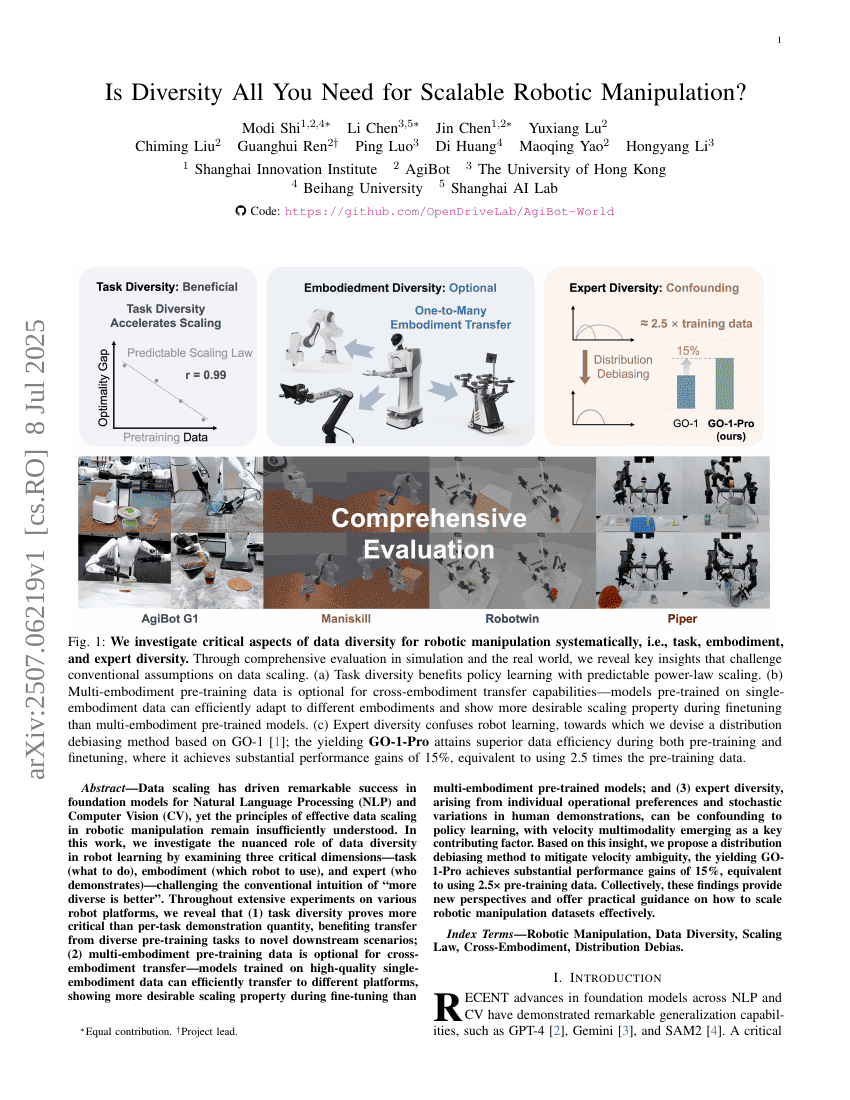
다양성만으로 대규모 로봇 조작이 가능할까요?
Nile-Chat: 이집트 언어 모델의 아랍 문자와 라틴 문자에 대한 연구
GTA1: GUI 테스트 시간 스케일링 에이전트
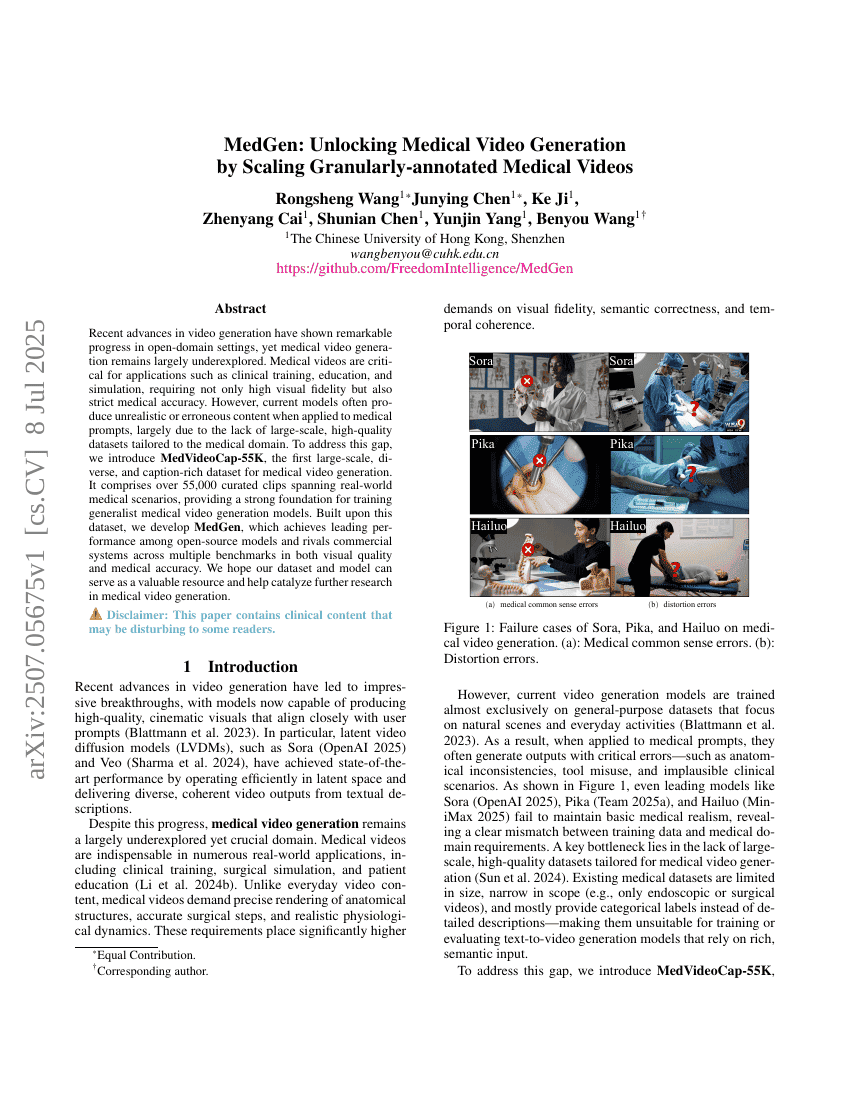
MedGen: 의학 비디오 생성을 위한 세부 주석이 달린 의학 비디오의 확장
RLVER: 검증 가능한 감정 보상으로 공감하는 에이전트를 위한 강화 학습
사용자 중심 지리 경험: 계획, 탐색, 및 동적 적응을 향상시키는 LLM 기반 프레임워크
PLAME: 사전 학습된 언어 모델을 활용한 향상된 단백질 다중 시퀀스 정렬 생성
CriticLean: Critic-Guided Reinforcement Learning for Mathematical Formalization
StreamVLN: SlowFast 컨텍스트 모델링을 통한 스트리밍 시각-언어 탐색
OmniPart: 의미 분리와 구조적 일체감을 활용한 부품 인식 3D 생성
SingLoRA: 단일 행렬을 사용한 저순위 적응
잠재적 추론에 대한 조사
에이전트 KB: 다양한 분야의 경험을 활용한 에이전틱 문제 해결
ChipSeek-R1: 계층적 보상 주도 강화 학습을 통한 인간을 능가하는 RTL 생성
MedGemma 기술 보고서
BMMR: 대규모 양방언어 다중모드 다학문적 추론 데이터셋
事전 학습된 정책 구분자는 일반 보상 모델입니다.
DreamVLA: 포괄적인 세계 지식을 바탕으로 꾸민 시각-언어-행동 모델
4DSloMo: 고속 장면의 비동기 캡처를 위한 4차원 재구성
마스킹 언어 모델링으로 인코더를 사전 학습해야 하는가?