Command Palette
Search for a command to run...
医薬品類似分子から標的特異的化合物へ、米国ピッツバーグ大学が分子フィンガープリント検索で標的薬物発見を加速
従来の医薬品発見は極めて挑戦的な作業であり、その核心的な目標は、膨大な化学空間の中で、特定の望ましい性質を持ち、特定の標的に作用できる分子を同定することである。初期の研究構想から最終的な上市承認まで、一款の新薬の開発コストは26億米ドルを超え、期間は12年以上かかる。その根本的な課題の一つは、10^23~10^60個の分子を含む膨大な化学空間を効率的に探索し、標的生物活性、物理化学的性質および合成可能性を同時に備えた化合物を見つけることにある。
近年、生成型人工知能は分子設計に新たな可能性をもたらした。既存の分子の構造と性質を学習することで、生成モデルは潜在的な化学空間を探索し、特定の物理化学的性質や生物活性特性を持つ候補分子を提案できる。しかし、モデルが生成した分子を、化学構造として有効で、実際に入手可能であり、かつ真の生物活性を持つ化合物へとどう変換するかは、依然としてこの分野が直面する重要な問題である。
この背景のもと、米国ペンシルベニア州ピッツバーグ大学の研究チームは、フルスペクトラム生成型リード化合物発見(Full-Spectrum Generative Lead Discovery,FSGLD)パイプラインを提案した。これは深層学習駆動の効率的な医薬品リード化合物同定手法である。 FSGLD の核はマルチスケール DRUG-GAN モデルであり、3つの異なるシナリオにおいて、生成モデルによる医薬品分子発見を導くことができる。以下を含む:
(1)ランダムな類薬性化合物の生成;
(2)標的特異性を持つ化合物の生成;
(3)共通の化学構造を持つ標的特異的化合物群の生成。
薬理学的特性が異なる3つの標的に対する評価において、FSGLD は標的特異的候補化合物の同定において良好な応用可能性を示した。さらに、本研究では熱力学積分(TI)計算用の計算フローも構築し、計算精度を維持しつつ、計算時間を80%~90%短縮した。
関連する研究成果は「A Full-Spectrum Generative Lead Discovery (FSGLD) pipeline via DRUG-GAN: A multiscale method for drug-like/target-specific compound library generation」というタイトルで Science Advances に掲載された。
研究のポイント:
-
FSGLD パイプラインは、生成モデルを用いて類薬性および標的特異性を持つ化合物を設計できるだけでなく、候補化合物を体系的かつ効率的にスクリーニング・検証できる
-
研究者らは実用的かつ拡張性のある枠組みを構築し、前臨床医薬品発見に必要な時間とコストの低減が期待される
-
本パイプラインにより生成された化合物は、理論上の候補分子に留まるものではなく、さらなる実験検証の実現可能性を備えており、学術研究者や製薬業界従事者に実質的な価値をもたらすことができる
論文URL:
https://www.science.org/doi/full/10.1126/sciadv.aei5257
データセット:3つの応用シナリオに対する異なるデータセット
FSGLD は異なるリード化合物発見タスク向けに3つの応用シナリオを設計しており、 それに応じて異なるデータセットと学習戦略を採用した。
シナリオIについて、 研究者らは Lipinski の5則に基づき多様性スクリーニングを組み合わせ、DrugBank データベース(https://go.drugbank.com/) から7,002種の薬剤を収集し、類薬性化合物データセットを構築した。
デコイ分子セットについて、研究者らは Open Babel を用いて、ZINC データベースの類薬性子集に属する19,212,639個の分子の分子量(MW)および脂水分配係数(logP)を計算した。続いて、研究者らは独自開発したプログラムを用いて、その中から分子量および logP 値が DrugBank 化合物に最も近い284,552種の ZINC 化合物を選別した。次に、SYBYL-X 2.1.1 ソフトウェアを用い、分子指紋(FP)に基づいてこれらの化合物をクラスタリングし、構造多様性を最大限に高めた。最終的に、研究者らは9998種の分子を選択し、デコイ分子セットを構築した。
dcGAN の判別器の訓練と検証のため、研究者らは10折交差検証法([75])を採用し、選択されたすべての類薬性分子(7002種)およびデコイ分子(9998種)を訓練セットとテストセットに分割した。
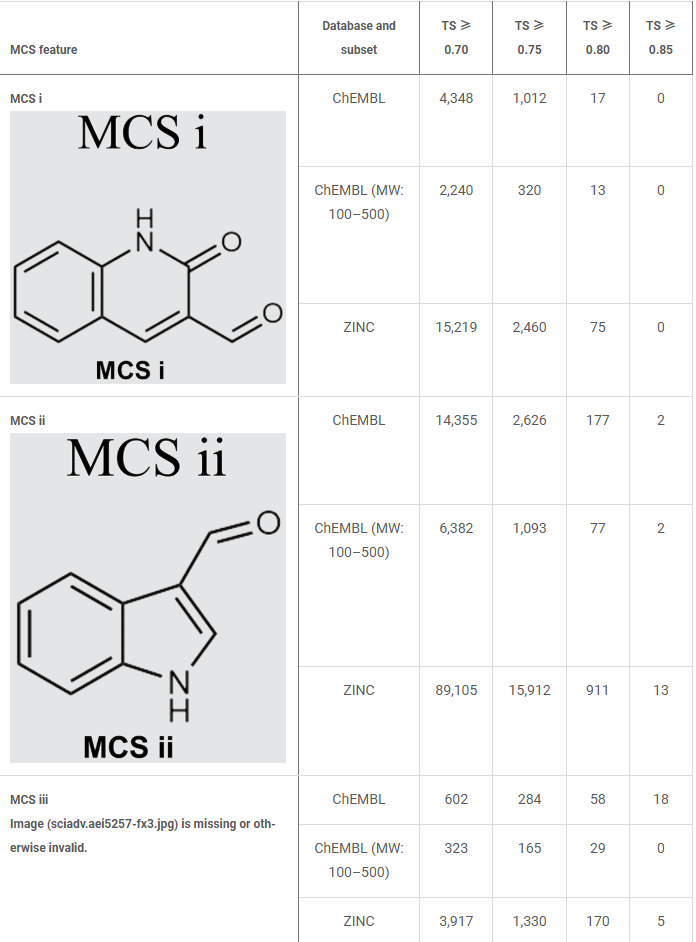
シナリオIIおよびシナリオIIIにおける標的指向型化合物の生成について、 研究者らは ChEMBL データベースから1,896種の CB2 活性化合物(Ki/IC50 が100 nM未満)および2996種の CB2 非活性化合物(Ki/IC50 が100 nM以上)を収集し、cdcGAN モデルの訓練に使用した。さらに、研究者らは収集した CB2 活性化合物の化学構造についても人手で確認し、うち最も一般的な3つの最大共通部分構造(MCS)を特定した。以下の表に示す通りである:
モデルの訓練過程において、すべての分子は Open Babel 2.3.1 バージョンのソフトウェアを用いて MACCS 分子指紋(168ビット)に変換された。さらなる検証を行うために、研究者らは CB1 の X線結晶構造を取得し、CB2 の相同モデルを構築した。
FSGLD フレームワーク:DRUG-GAN を中核として
FSGLD の中核は DRUG-GAN であり、その重要な着想は、完全な分子構造を直接生成するのではなく、分子指紋の分布を学習し、特定の特徴を持つ指紋を生成し、それをクエリ条件として大型化学データベースから構造が類似する実化合物を検索することである。その流程概要は以下の通り:
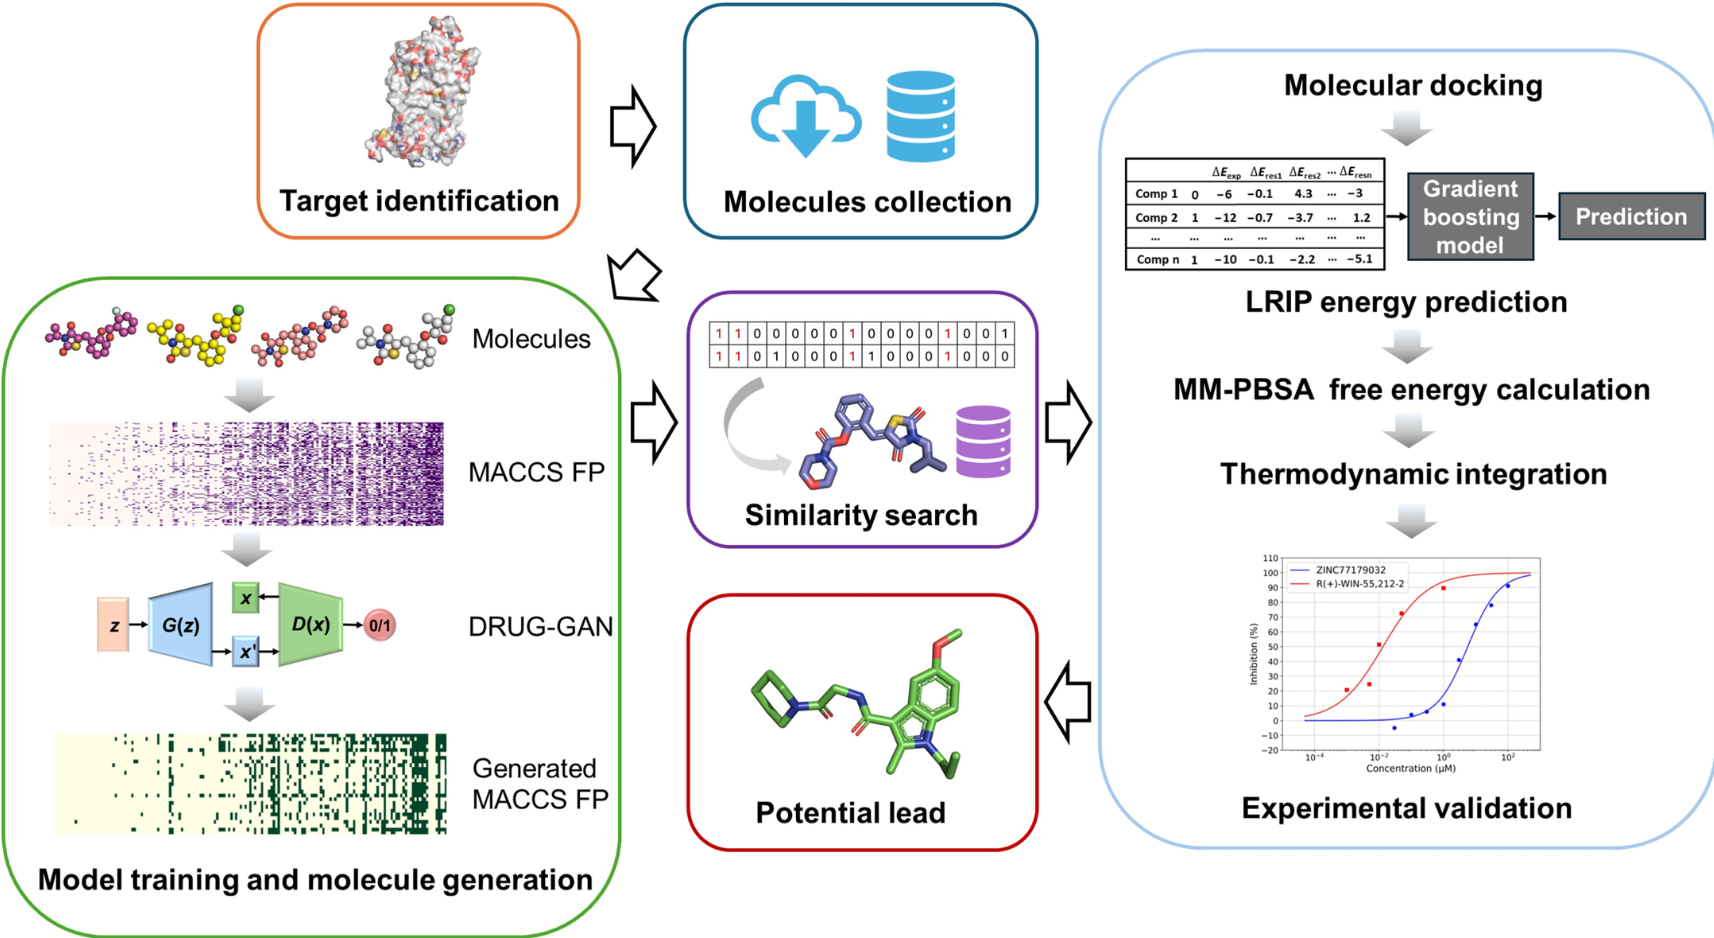
この設計は、従来の SMILES 文字列または分子グラフに基づく生成モデルとは異なる。MACCS 分子指紋は、分子の構造的特徴をコンパクトな形式で記述でき、比較的限られたデータセットからの学習に適している。しかし、分子指紋は単一の分子と一意な写像関係を確立できず、化学的に有効な分子構造へ直接変換することもできない。したがって、DRUG-GAN が生成した指紋は、ChEMBL や ZINC などのデータベースとの類似性マッチングをさらに経て、初めて実在する候補化合物を得られる。
モデルアーキテクチャの観点から、研究者は識別器を構築するために深層畳み込みニューラルネットワーク(DCNN)を採用し、LeNet-5、AlexNet、ZFNet、VGGNet の4つの主要な DCNN アーキテクチャを探索した。
異なる発見目標に応じて、DRUG-GAN は3つの応用シナリオとして設計された。
シナリオ I は標準的な dcGAN を採用し、DrugBank 中の類薬性分子指紋を実サンプルとして、類薬性分子の特徴分布を学習する。 生成器はランダムノイズから出発して新たな分子指紋を生成し、相似性検索により ZINC データベースから対応化合物を探す。このシナリオは主に、類薬性特徴を持つ化学空間を探索するために用いられる。
シナリオ II は標的特異性情報をさらに導入し、条件付き生成対抗ネットワーク cdcGAN を採用する。 モデルは CB2 活性配体と非活性配体を2種類の訓練データとして、CB2 活性に関連する分子指紋特徴を学習し、CB2 標的指向性を持つ指紋を生成する。その後、研究者は生成指紋をクエリ条件として ChEMBL および ZINC データベースから候補化合物を検索し、無偏の類薬性分子探索から標的指向型発見への拡張を実現する。
シナリオ III は分子設計の制御可能性をさらに高める。 研究者は生成器にマスク層(Mask Layer)を導入し、具体的には Lambda 層によって事前定義された MCS に対応する分子指紋特徴ビットを固定する。これにより、生成された指紋は指定された構造特徴を保持しつつ、他の特徴ビットの変化を許す。この方法により、モデルは CB2 標的指向性と特定の骨格特徴を兼ね備えた化合物群を生成でき、ヒット化合物の拡張および後続のリード化合物最適化を支える。
候補化合物の生成後、FSGLD は階層的な計算スクリーニング流程も確立した。 まず分子ドッキングによって候補分子と標的受容体の結合状態を評価し、次に標的特異的な LRIP スコア関数を用いてスクリーニングし、さらに分子動力学(MD)シミュレーション、MM-PBSA 結合自由エネルギー計算、熱力学積分(TI)計算を実施する。現在の段階のスクリーニングを通過した化合物のみが、次の工程へ進める。最終的に、研究者は優先度の高い候補分子について実験検証を行い、生成、検索、計算スクリーニングから実験評価に至る完全な流程を形成した。
成果:3種類の薬理学的特徴が異なる標的の評価でいずれも良好な性能を示す
実験者は3つのシナリオを通じてモデルの性能を評価した:
シナリオ I:類薬性化合物の生成
研究者は、唯一性(Uniqueness)、新規性(Novelty)、多様性(Diversity)、類似性(Similarity)、有効性(Validity)の5つの観点から、DRUG-GAN と3つの公表済み生成モデル——ORGAN、OR(W)GAN、ORGANIC——を包括的に比較した。
以下の表のように、MACCS FP 空間では、DRUG-GAN はベンチマークとして使用された他の生成モデルに対し、複数の主要指標で優れている。特に、DRUG-GAN の唯一性と新規性のスコアはいずれも 1.00 に達し、満点の成績を収めた。これは、生成されたすべての分子指紋が互いに異なり、いずれも訓練データには現れていないことを意味する。その多様性スコアは 0.73 であり、ORGAN(0.77)および ORGANIC(0.76)の性能に近く、同時に OR(W)GAN(0.63)を上回っている。さらに、DRUG-GAN が生成した分子指紋と 7002 個の参照薬物との平均類似度は最も低く、わずか 0.25 であった。これは、このモデルが類薬性特徴を保ちつつ、明確な構造差異を持つ分子指紋を生成できることを示している。
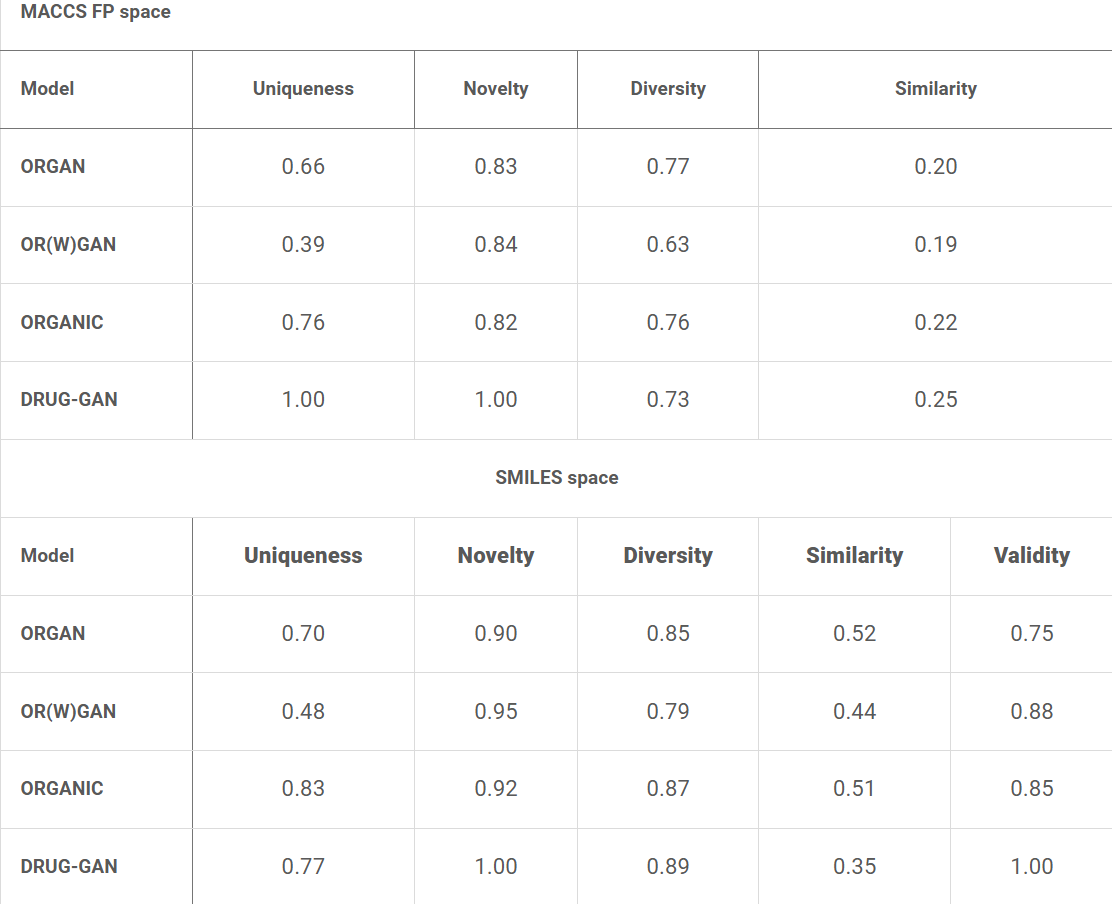
FP空間の評価結果と一致して、DRUG-GANはSMILES空間でも優れた性能を示した。DRUG-GANの新規性スコアは依然として1.00に保たれており、デコードされたすべての分子が訓練データセットに含まれていないことを示している。予想されていたように、複数の異なる分子指紋が同一の分子構造にデコードされる可能性があるため、唯一性スコアはFP空間の1.00からSMILES空間の0.77に低下した。それでも、DRUG-GANの唯一性はORGANおよびOR(W)GANより高く、ORGANICよりわずかに低いだけである。同時に、DRUG-GANは高い多様性も維持しており、スコアは0.89に達した。一方、生成分子と参照薬物との間の類似性は比較的低く、スコアは0.35であった。これは、化学的合理性を犠牲にすることなく化学空間を拡張するという、このモデルの設計目標と一致している。
これらの結果をさらに評価するために、研究者らは分子量(MW)が100~1000 Daの範囲にある米国食品医薬品局(FDA)に承認された医薬品2252種も分析した。これらの承認済み医薬品の平均分子量(MW)、脂水分配係数の対数値(logP)、トポロジカル極性表面積(TPSA)は、それぞれ358.0 Da、2.8、89.3 Ųであった。DRUG-GANによって検索された分子も、それに近い類薬性特性を示し、平均分子量は382.9 Da、平均logPは2.0、平均TPSAは76.0 Ųであった。これらのデータは、FDA承認薬と比較して、DRUG-GANが検索した分子は全体的に分子量がやや大きいが、極性は比較的低く、潜在的に有利な物理化学的特性を示すことを示している。
シナリオ II:標的特異的化合物の生成
DRUG-GANは、類薬性を有する候補化合物の生成に加えて、標的特異的化合物を生成する能力も備えている。 この能力を示すため、研究者らはカンナビノイド受容体2(CB2)を例として研究を行った。
生成された分子指紋との類似性が85%以上(TS ≥ 0.85)である186個のChEMBL化合物のうち、169個の化合物の分子量(MW)は100~500 Daの間であった。そのうち104個の化合物は、生物活性試験でCB2活性を有するリガンドとして報告されており、阻害定数(Ki)は10 μM未満であった。検索された化合物における低Ki値分子の濃縮は、DRUG-GANが生成した分子指紋クエリが、標的に関連する生物活性データベースから、CB2活性を有することが知られている化学構造タイプを効果的に検索できることを示している。さらに、研究者らはZINCデータベースからも161個の化合物を検索し、それらとDRUG-GANが生成した分子指紋クエリとのTSはいずれも0.85以上であった。
その後、研究者らは検索された化合物についてCB1およびCB2受容体と分子ドッキングを行い、結合親和性を予測した。結果は以下の図に示す通り:
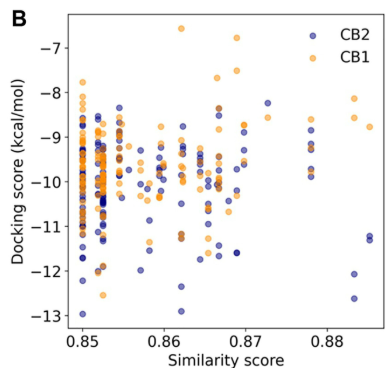
全体的に、DRUG-GANによって生成された分子フィンガープリントクエリから検索された化合物は、CB2に対して良好な予測結合能力を示した。CB2受容体との分子ドッキングスコアの平均値は−10.10 kcal/molであり、シナリオIの判別器訓練に使用されたデコイ分子の平均値−8.29 kcal/molよりも優れていた。各検索化合物のドッキングスコアをペア比較した後、研究者らはさらに、これらの化合物が全体的にCB2への結合選好性を示すことを明らかにした。その相当数の化合物は、CB1に対する結合能力よりもCB2に対する予測結合能力が優れていた。
シナリオIII:標的特異的化合物シリーズ生成
シナリオIIIにおいて、研究者らは3つの事前定義されたMCSを生成器に導入し、マスク層を介して特定の骨格制約を持つCB2候補化合物を生成した。
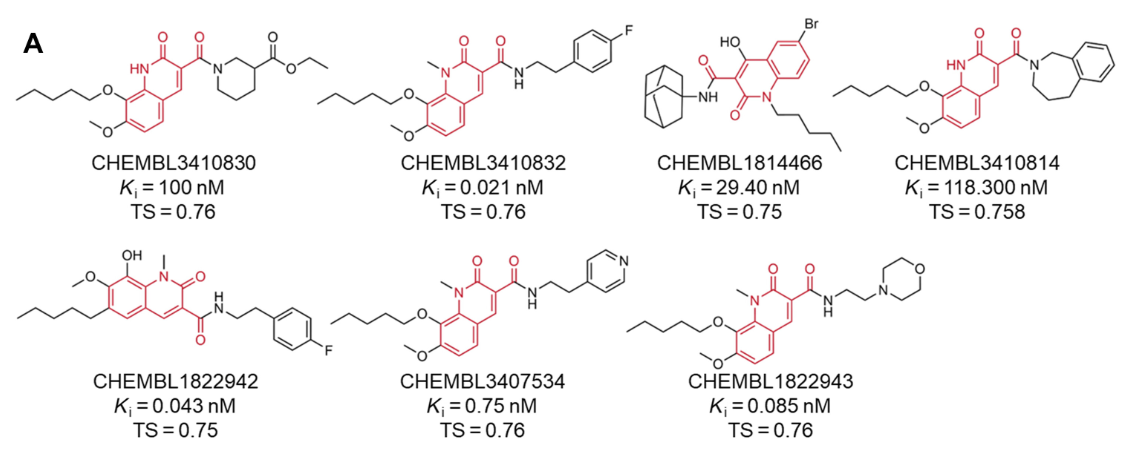
MCS i:キノリンジオン中核構造
MCS iについて、研究者らはChEMBLデータベースから、事前定義された部分構造を含み、生成された分子フィンガープリントクエリとのTSが0.75以上の49の化合物を検索して確認した。以下の図に示すように、7つの化合物は高いCB2活性(Kiが10 μM未満)が報告されている。
ZINCデータベースでは、研究者がMCS iの部分構造を含み、TS ≥ 0.75の32の化合物を検索・確認した。代表的な候補化合物の一部と対応するTS値を以下の図に示す:
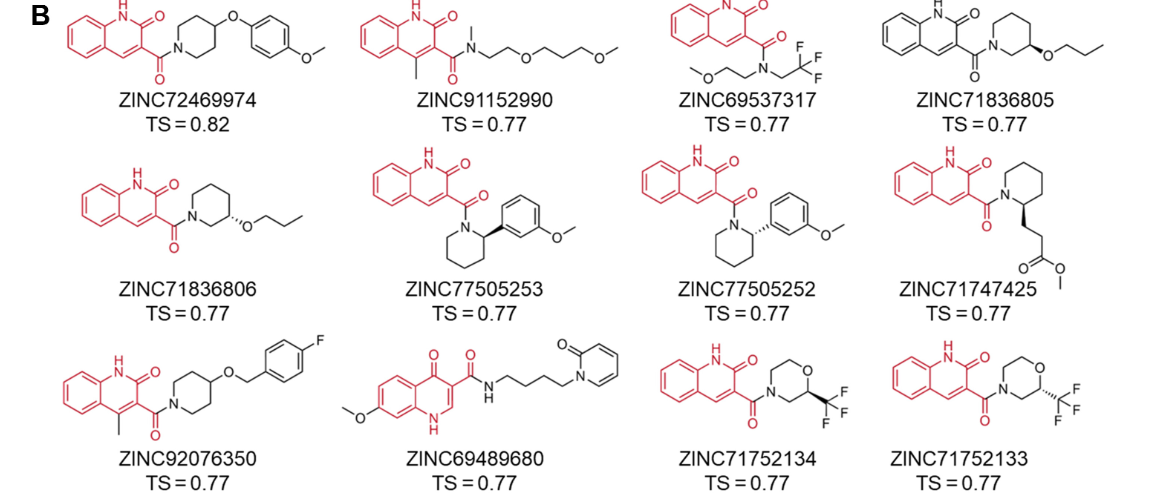
これらの候補化合物の多くは、CB2に対する予測分子ドッキングスコアがCB1に対するドッキングスコアよりも良好であり、分子ドッキングに基づく候補化合物の優先順位付けにおいて、CB2結合選択性を示す可能性がある。
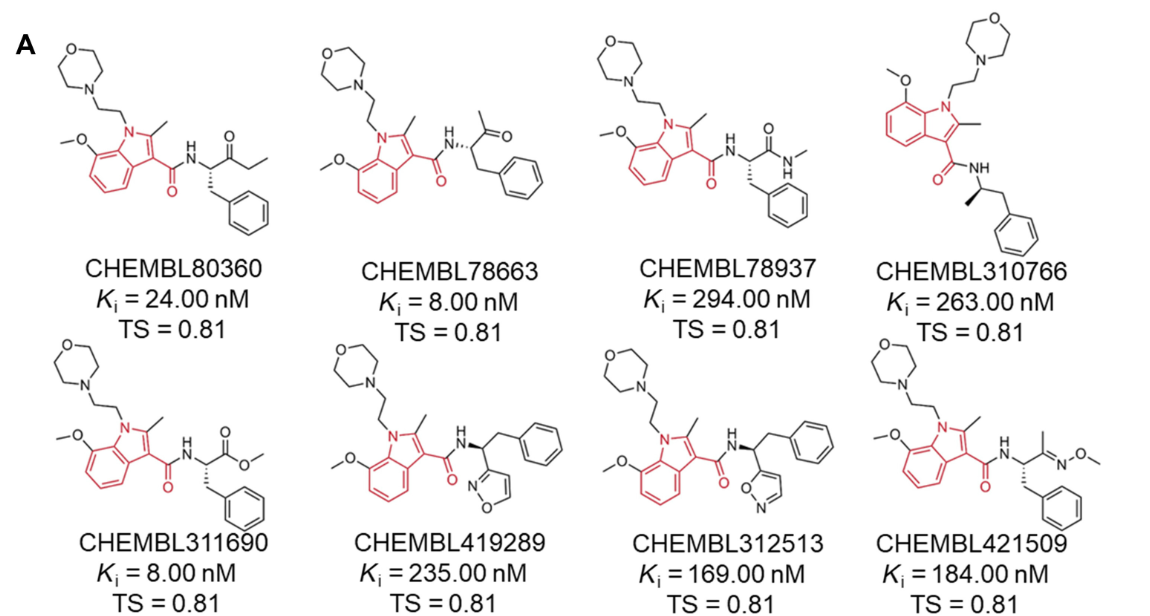
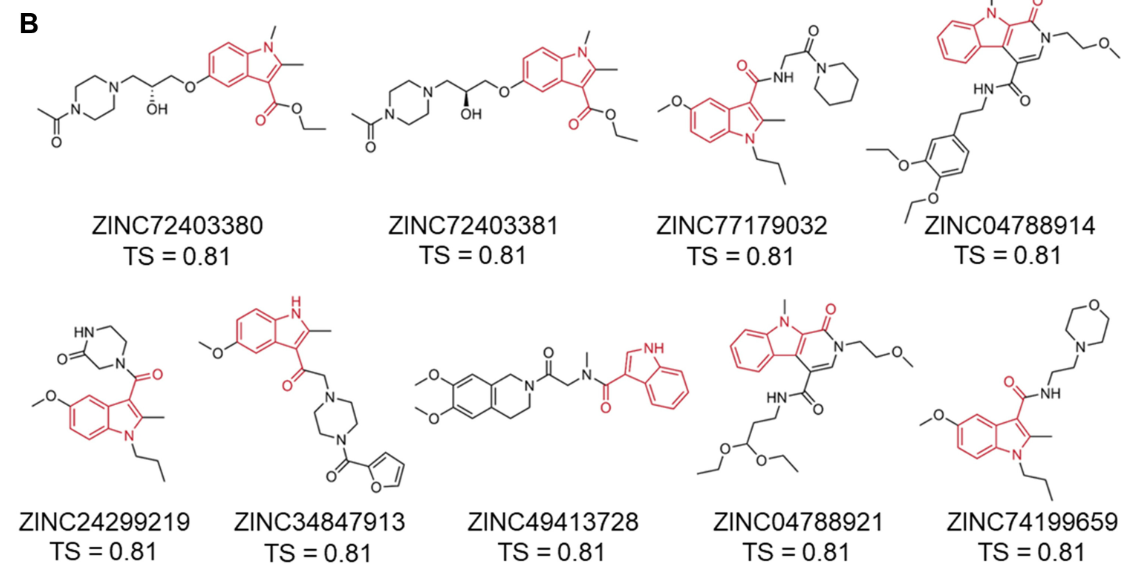
MCS ii:インドールカルボキサミドコア構造
MCS ii について、研究者らは ChEMBL データベースから、所定のサブ構造を含み、生成された分子指紋クエリとの TS ≥ 0.80 の化合物を 24 件検索・確認した。このうち 8 件の化合物は強い CB2 結合親和性を示し(下図)、骨格制約型 DRUG-GAN 戦略が CB2 関連の化学構造タイプを効果的に検索できることをさらに実証した。
ZINC データベースでは、研究者らは MCS ii サブ構造を含み、TS ≥ 0.80 の 9 件の化合物を発見した(下図)。MCS i の候補化合物と同様に、これらの化合物の多くでも、CB2 に対する予測分子ドッキングスコアが CB1 に対するドッキングスコアを上回り、CB2 標的スクリーニングをさらに進める可能性を示している。
MCS iii:インドールスルホンアミド骨格
MCS iii について、研究者らは当初、TS ≥ 0.75 の条件で ChEMBL データベースから 165 件の化合物を検索した。しかし、FP2 分子指紋分析により、最終的には完全に一致する MCS iii サブ構造を含む化合物は 2 件のみ確認された(下図)。
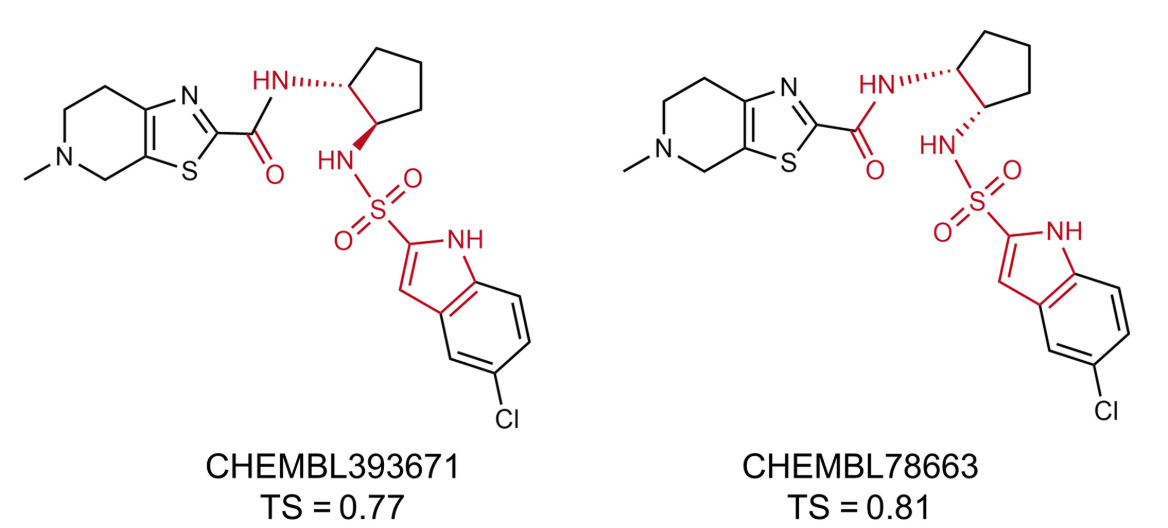
さらに、ZINC データベースでは、TS ≥ 0.75 の検索化合物はすべて検証を通過せず、完全に一致する MCS iii サブ構造を含む化合物は確認されなかった。
総合的な結果は、骨格制約型 DRUG-GAN 戦略が、CB2 関連の化学構造的特徴を保持しつつ、拡張された学習リガンドが代表する化学空間を探索し、構造的に異なる新しい候補化合物を発見できることを示している。
結語
有望な候補化合物を優先的にスクリーニングするために、FSGLD は、分子ドッキング、標的特異的 LRIP スコアリング、分子動力学(MD)シミュレーション、MM-PBSA 結合自由エネルギー計算、熱力学的積分計算を含み、検索された化合物を評価する階層的ワークフローを採用し、一部の候補化合物に対して実験的検証も実施した。これらの相補的な手法を統一されたワークフローに統合することで、FSGLD は候補リード化合物の優先スクリーニングを行い、その後の実験評価のための根拠を提供する実用的な研究フレームワークを確立した。
タンパク質構造予測および共折畳み手法の進展に伴い、研究者らは FSGLD フレームワークの精度、頑健性、適用範囲もそれに応じて向上すると見込んでいる。今後の研究では、DRUG-GAN および FSGLD を、イオンチャネルや核内受容体などを含むより広い標的ファミリーでさらに評価し、同時に先進的な少サンプル学習および少データセット学習戦略を導入することで、データが限られたシナリオにおけるモデルの性能をさらに向上させる。
参考文献: