Command Palette
Search for a command to run...
ゼロショット認識精度95.4%、MITらがCLaCモデルを提案し、材料構造と言語のクロスモーダルアライメントを実現

材料発見の重要な課題の一つは、膨大な化学・構造空間から目標性能を持つ候補材料を選別することである。近年、グラフニューラルネットワーク(GNN)は結晶の三次元原子構造を学習することで、材料物性の予測や構造生成などのタスクにおいて顕著な進展を遂げている。しかし、これらのモデルは通常、事前に定義された属性ラベルや数値条件に依存しており、自然言語で記述された材料の要件を直接理解することは困難である。大規模言語モデル(LLM)はテキスト処理に長けているものの、結晶の空間構造やその物理的性質に対する正確な表現能力を欠いている。
結晶構造と自然言語の結合は、材料発見に新たなアプローチを提供するが、既存の結晶データベースの規模は限定的であり、学術文献は少数の人気材料に偏っている。また、テキスト記述と材料物性の間には十分な対応関係が不足しており、これがマルチモーダルモデルの学習効果を制約している。
この課題に対し、マサチューセッツ工科大学(MIT)、韓国科学技術院(UNIST)、イリノイ大学アーバナ・シャンペーン校(UIUC)、MIT-IBM Watson AI Lab などの機関の研究チームは、対照言語-結晶モデル(Contrastive Language-Crystals、CLaC)を提案した。このモデルは、大規模言語モデルを用いて材料物性に基づく合成ナラティブを生成し、対照学習を通じて結晶構造と自然言語を共有表現空間へマッピングする。 実験の結果、学術文献のテキストのみを用いて学習したモデルと比較して、CLaCはゼロショット材料理解および自然言語による材料検索タスクにおいて明らかな優位性を示した。
関連する研究成果は「Scaling multimodal materials representation learning with synthetic narratives」というタイトルで、Nature Communications誌に掲載された。
論文リンク:
https://www.nature.com/articles/s41467-026-76378-7#Sec10
12.6万組の結晶-テキストペアデータにより、材料セマンティクスのカバレッジを拡大
結晶マルチモーダルモデルの訓練には、まず結晶構造と自然言語間の対応関係を構築する必要がある。既存の材料データベースには大量の結晶構造と計算物性が蓄積されているが、関連するテキストは主に学術論文に散在しており、研究が十分に進んだ少数の材料に集中している。そのため、多様な結晶構造をカバーすることができず、テキストが完全な材料物性情報を含んでいる保証もない。
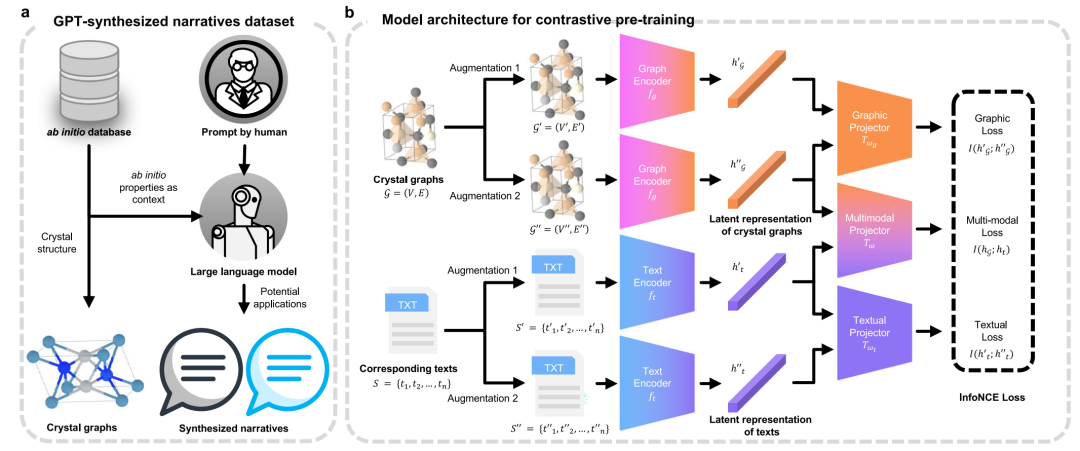
そこで、本研究ではMaterials Projectデータベースを基盤とし、約12.6万件の結晶材料データを収集した。 そして、結晶グラフ構造と自然言語記述をそれぞれ構築した。結晶構造はJarvis-toolsツールを用いてグラフデータに変換され、原子とその相互作用によって三次元構造を表現する。テキスト部分には、研究者らが以前開発したGPT合成ナラティブデータセットを採用し、材料データベース内の計算物性に基づき大規模言語モデルによって記述的テキストを生成した。
化学式や元素組成を単純にテキストに変換するのとは異なり、合成ナラティブは材料の計算物性に基づいており、構造的特徴、物理的性質、機能的挙動、潜在的応用などの情報を含んでいる。例えば、ある結晶の組成、バンドギャップ、密度などの既知データに基づき、対応する物理的特徴や応用情報を含む記述を生成することで、結晶構造とより豊かな材料セマンティクスとの対応関係を確立する。
合成ナラティブの効果を検証するため、研究者らは学術文献対照データセットも構築した。化学式を検索条件として、約400万件の科学論文の全文から関連段落を抽出し、最終的に約40万組の材料-自然言語文ペアデータを得たが、これらは約400種類の無機化合物のみをカバーしていた。 これに対し、GPT合成ナラティブがカバーする異なる結晶種の数は、学術文献データの約300倍であった。
2種類のテキストデータは、それぞれCLaC-Synthetic(合成ナラティブ版)とCLaC-Paper(学術文献版)の訓練に使用され、異なるデータソースがモデル性能に与える影響を比較した。データセットは訓練集、検証集、テスト集に8:1:1の割合で分割された。
グラフニューラルネットワークと言語モデルの結合により、結晶構造と自然言語の整合を実現
CLaCは、視覚-言語分野でのCLIPの対照学習手法を参考にし、 結晶構造とテキスト記述を連合学習することで、両情報を共有表現空間へマッピングし、モデルが材料と自然言語間の意味的類似度を計算できるようにした。
CLaCは、結晶グラフエンコーダ、テキストエンコーダ、マルチモーダル投影モジュールからなるデュアルエンコーダアーキテクチャを採用している。 結晶グラフエンコーダは、原子組成、局所的な配位環境、三次元幾何構造などの情報を抽出する役割を担い、テキストエンコーダは材料物性、機能的特徴、応用要件などの自然言語記述を処理する。これらの情報はそれぞれベクトルへ変換された後、投影モジュールを通じて統一された潜在空間へ入り、結晶構造とテキスト意味間の対応関係を確立する。
結晶構造のエンコーディングにおいて、本研究ではPaiNN(Polarizable Atom Interaction Neural Network)グラフニューラルネットワークを採用し、等変メッセージパッシング機構を通じて原子間の空間関係を学習する。これにより、局所的な原子環境を捉えつつ幾何情報を保持する。また、比較対象としてCGCNNおよび事前学習された原子間ポテンシャルモデルORBを導入した。
テキストエンコーダについては、SciBERT、MatSciBERT、OPT-125M、Galactica-125Mなどの事前学習済み言語モデルを比較した。これらは双方向エンコーディングと自己回帰型の2つのアーキテクチャを含んでいる。後続の実験結果を踏まえ、研究者らは最終的にPaiNNとGalactica-125Mを主要なエンコーダの組み合わせとして採用した。
CLaC の中核はクロスモーダル対照学習である。 学習時、同一材料の結晶図とテキスト記述は正例ペアとして扱われ、異なる材料間の構造とテキストの組み合わせは負例ペアとして構成される。モデルは InfoNCE 対照損失関数を通じて、正しいペアのベクトル類似度を高め、不一致サンプル間の類似度を下げることで、結晶構造、物理的性質、自然言語間の関係を段階的に学習する。
ペアリングデータの有限性を考慮し、本研究ではモーダル内対照学習も導入し、モデルが同一結晶の異なる構造表現や、同一材料の異なるテキスト記述を識別できるようにした。 その際、結晶図は原子位置の摂動および 0~5% の格子ひずみによるデータ拡張が行われる。テキストについては、ランダムな削除と文順のシャッフルにより異なるバージョンを生成し、各文の保持確率は 50% とした。これらの手法は、軽微な構造変化やテキスト表現の差異に対するモデルの頑健性を高める。研究者らは同族元素の置換を採用しなかった。これは、材料の配位環境、電子構造、実際の特性を変化させる可能性があるためである。
事前学習プロセスにおいて、結晶図エンコーダはゼロから学習され、テキストエンコーダは事前学習済み重みで初期化された。モデルは 512 次元の統合埋め込み空間、AdamW オプティマイザを使用し、学習率は 2×10⁻⁵、有効バッチサイズは 256、最大 5 エポックまで訓練される。
事前学習完了後、CLaC は自然言語クエリをベクトルに変換し、材料データベースで事前計算された結晶ベクトルとの類似度比較を行うことで、目標特性を持つ候補材料を抽出できる。 これにより、各特性ごとにモデルを再学習する必要がなくなる。ただし、CLaC 自体は結晶構造を直接生成するわけではなく、その主な役割は言語と結晶構造間の関連性を確立し、後続の材料逆設計を支援することにある。
ゼロショット材料理解から自然言語検索まで、クロスモーダル学習効果の検証
CLaC の性能を評価するため、研究者らは複数のゼロショット実験を設計し、モデルの結晶理解、自然言語検索、物理的性質の表現能力を重点的に検証した。また、未学習モデル、Gemma-3-1b-it、CLaC-Paper などのベースラインと比較を行った。
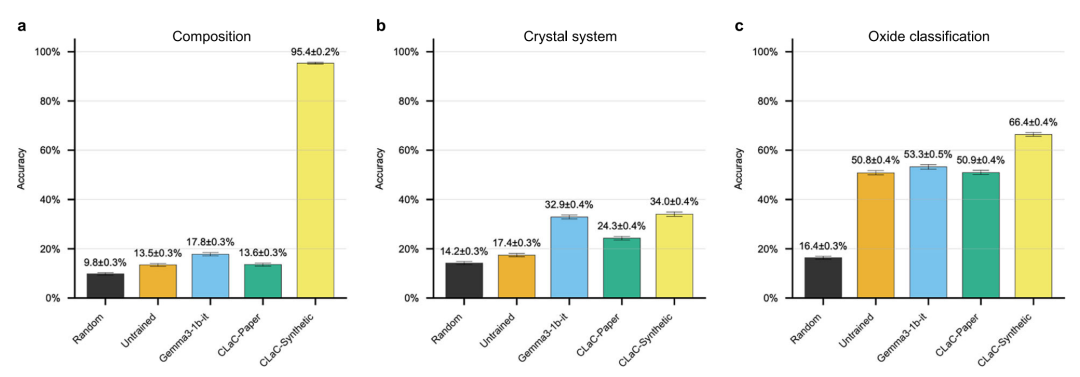
まず、ゼロショットマルチモーダル理解実験では、モデルが結晶構造に基づき、複数の候補テキストから正しい記述を選択する必要がある。この実験は、元素構成、晶系、酸化物タイプに関する 3 種類のタスクを含む。結果として、CLaC-Synthetic は元素構成分類において 95.4% ± 0.2% の精度を達成し、 Gemma-3-1b-it の 17.8% や CLaC-Paper の 13.6% を著しく上回った。酸化物分類の精度も 66.4% ± 0.4% に達し、他のモデルよりも優れている。
ただし、CLaC-Synthetic の晶系分類における精度は 34.0% ± 0.4% に留まり、Gemma-3-1b-it の 32.9% とほぼ同等であった。これは、晶系データの分布の偏りや訓練バッチサイズが小さいことと関連している可能性があり、結晶対称性などの微細な幾何学的特徴に対するモデルの理解が依然として限定的であることを示唆している。
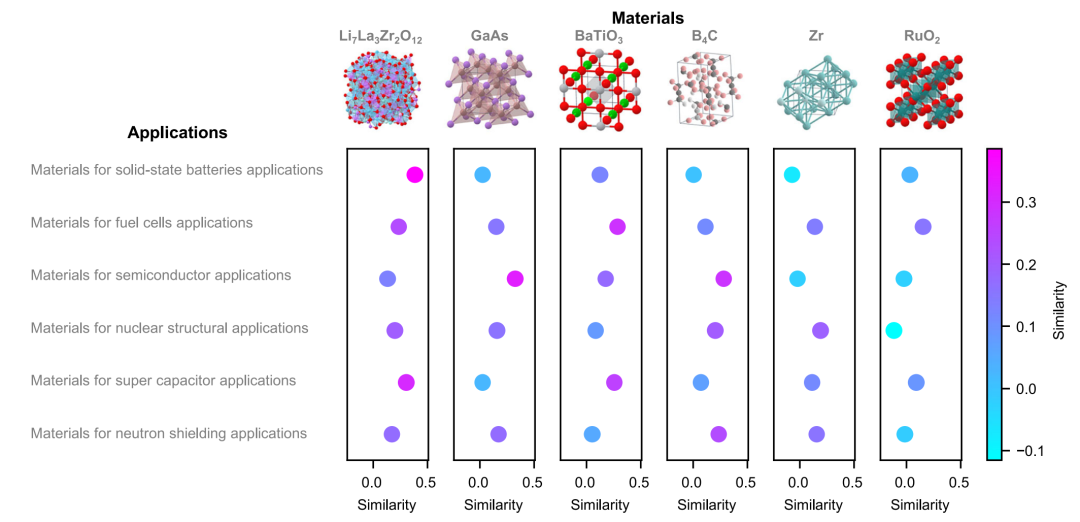
研究者らはさらに、Li₇La₃Zr₂O₁₂、GaAs、BaTiO₃ など 6 種類の代表的な材料と、全固体電池、半導体、スーパーキャパシタなど 6 種類の応用シナリオを選択し、材料と応用記述間の類似度を分析した。 結果では、モデルは Li₇La₃Zr₂O₁₂ と全固体電池、GaAs と半導体、RuO₂ とスーパーキャパシタなどの典型的な関連を識別できることが示され、その表現には一定の材料機能および応用知識が含まれていることが明らかになった。
ゼロショット逆設計実験では、研究者らは従来の特性予測の方向を反転させ、目標性能の自然言語記述に基づいて候補材料を検索した。実験は、バンドギャップ、密度、凸包エネルギー差、シンチレーション減衰長さ、総磁化の 5 つの特性を対象とする。各クエリに対し、モデルは類似度が最も高い上位 30 種類の材料を検索し、平均絶対誤差(MAE)を用いて実際の特性値と目標値の差異を測定する。
結果として、CLaC-Synthetic は 5 つの特性検索すべてにおいてランダムベースラインを上回った。 そのうち、バンドギャップ検索の平均絶対誤差は 0.641 eV で、ランダム検索の 1.185 eV より低い。密度検索ではそれぞれ 0.799 g/cm³ と 2.148 g/cm³ であった。シンチレーション減衰長さ検索ではそれぞれ 1.033 cm と 2.697 cm であった。一方、CLaC-Paper の全体的なパフォーマンスはランダム選択に近い結果となり、計算特性に基づいて生成された合成記述は、学術文献から直接抽出したテキストよりも、言語と材料特性間の対応関係の確立に有利であることを示している。
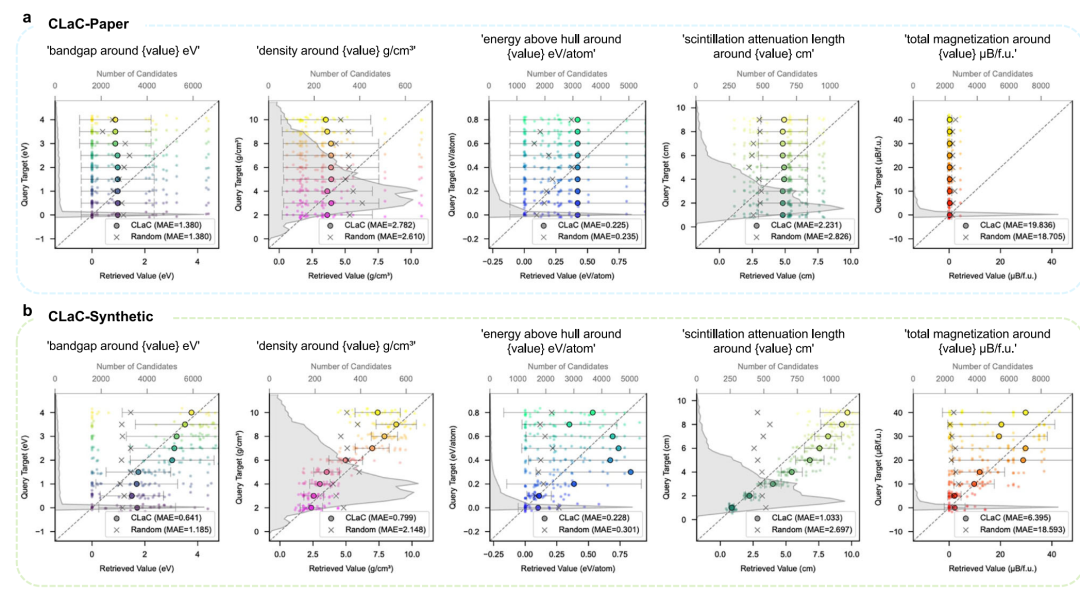
正確な数値に加えて、本研究では「大きなバンドギャップ、低い密度、強い磁性」といった定性的な記述もテストした。その結果、CLaC-Syntheticが検索する材料の属性分布はクエリの意味に応じて変化することが判明した。 例えば、低いバンドギャップから高いバンドギャップへとシフトすると、候補材料のバンドギャップもそれに応じて大きくなる。一方、CLaC-Paperはこの種の区別を形成することが難しく、合成された記述がモデルによる定性的記述と実際の物理的属性との関係の理解を助けることを示している。
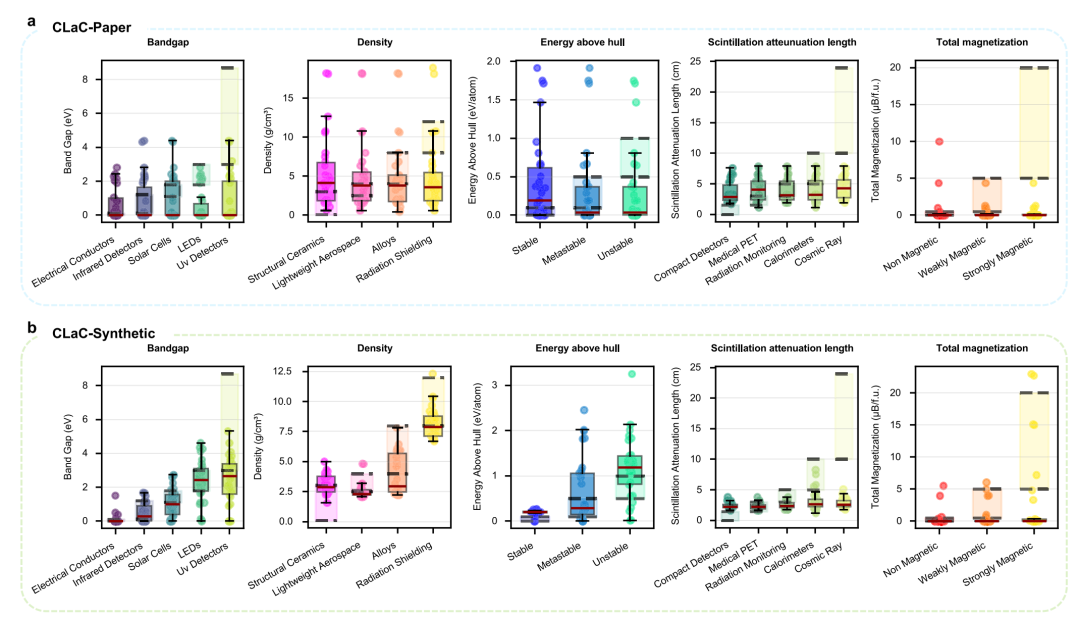
応用検証では、研究者らは全固体電池電解質のスクリーニングを例にとり、リチウム含有材料と高いバンドギャップという条件で検索を行った。上位30件の候補材料はすべてリチウム元素を含み、平均バンドギャップは3.23 eVであった。そのうち、第4位の Li₆PClO₅ は他の研究で潜在的な候補材料として既に識別されており、第9位の Li₄SiO₄ も固体電解質薄膜として作製された実績がある。ただし、学習データにイオン伝導度の情報が含まれていないため、既存の結果だけではこれらの材料が固体電解質のすべての性能要件を満たしていることを証明できない。
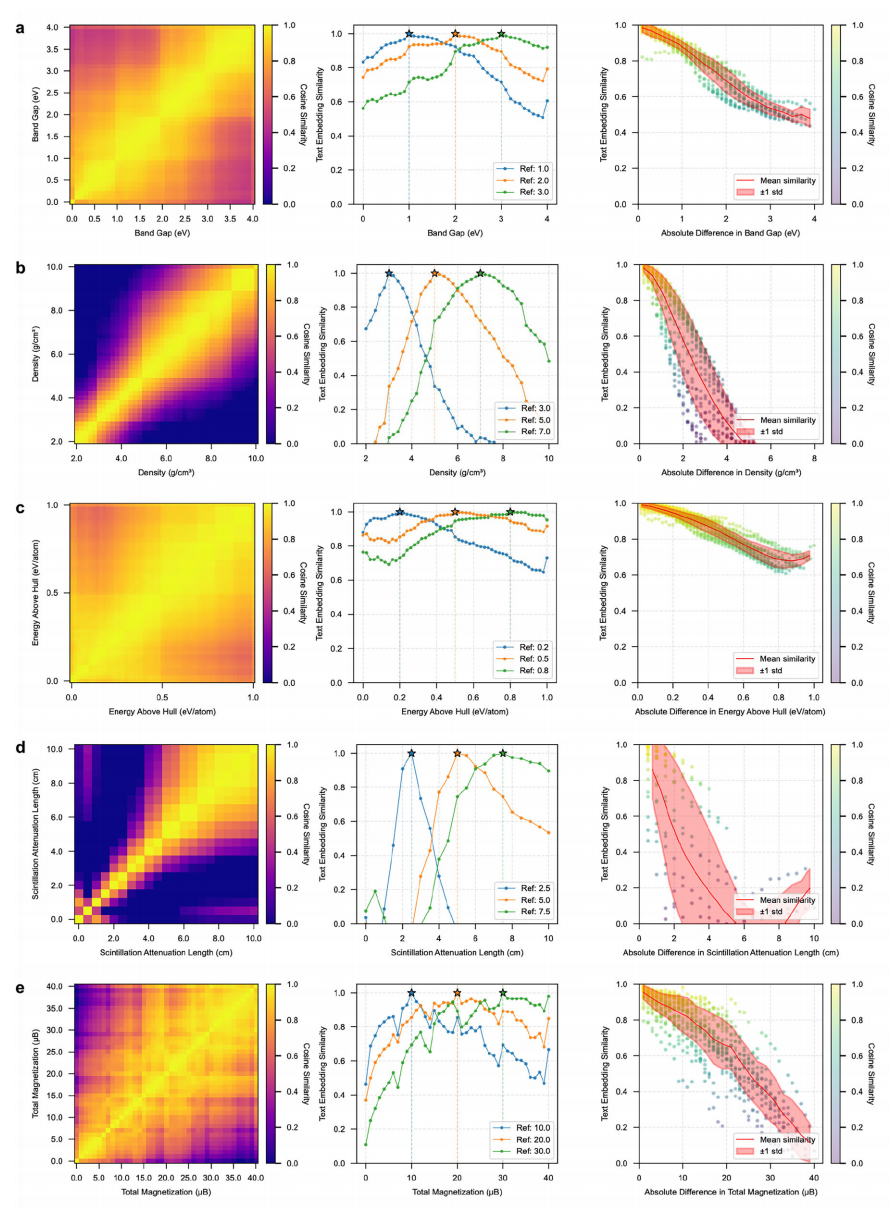
モデルが数値情報をどのように理解するかを分析するため、本研究ではさらにテキスト埋め込み空間における属性の連続性を検討した。結果は、CLaC-Synthetic のベクトル類似性が属性数値の差の拡大に伴い徐々に低下することを示した。例えば、2.0 eV のバンドギャップを基準として、クエリ値が4.0 eVまで増加すると、コサイン類似性は1.0から約0.65まで低下し、モデルが物理量の大小関係を表現できることを示している。このうち、密度とシンチレーション減衰長の類似性の低下は速く、対応する検索精度が高い。凸包エネルギー差の変化は比較的緩やかで、検索誤差も大きい。これに対し、CLaC-Paper とクロスモーダルアライメントを行っていない Galactica-125M のいずれも、明確な連続的な数値関係を示さなかった。
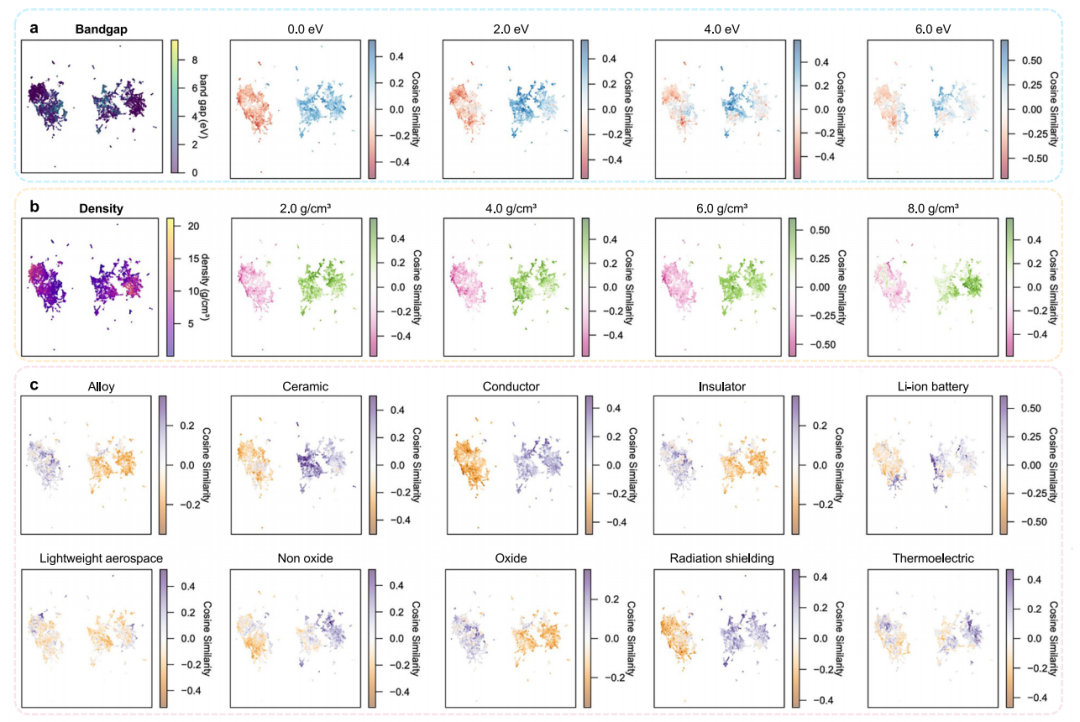
最後に、研究者らは UMAP を用いて結晶構造とテキスト表現の潜在空間を可視化した。 2つのモダリティはそれぞれ相対的に独立したクラスタを形成しているが、その材料の近傍関係は非常に一致している。結晶グラフ空間で最も近い50個の近傍のうち、平均して57%もがテキスト空間で対応する最も近い50個の近傍にも出現しており、ランダムな場合の0.4%を大幅に上回っている。さらに、バンドギャップや密度などの物理的属性は規則的な分布を示し、「セラミックス」「導体」「リチウムイオン電池」といった記述も異なる結晶領域に対応しており、モデルの材料属性および機能カテゴリに対するクロスモーダルな表現能力をさらに検証している。
結びに
CLaC の研究は、結晶材料のマルチモーダル学習の鍵はデータの規模だけでなく、材料属性と自然言語との間に正確な対応関係を構築できるかどうかにあることを示した。計算属性に基づいて合成記述を生成することにより、CLaC はゼロショットの材料理解と言語誘導検索において、文献テキストで訓練されたモデルよりも優れた性能を達成した。しかし、モデルには結晶系の識別などの微細構造タスクにおいて依然として不十分であり、多結晶、欠陥構造、金属有機構造体(MOF)などの複雑な系の処理も現状では困難であり、新たな結晶構造を直接生成することもできない。将来、合成データの精度をどのように向上させ、複雑な材料に対するモデルの適用範囲を拡大し、言語検索と結晶生成、物理検証をいかに結合させるかは、こうしたモデルが実際の材料設計に進出するために解決すべき課題である。