Command Palette
Search for a command to run...
超1億種の低分子量化合物に対して8億枚の予測質量スペクトルを生成するCornell大学の「AIMe」:化学則・断片化経路推論・ニューラルネットワーク学習を統合
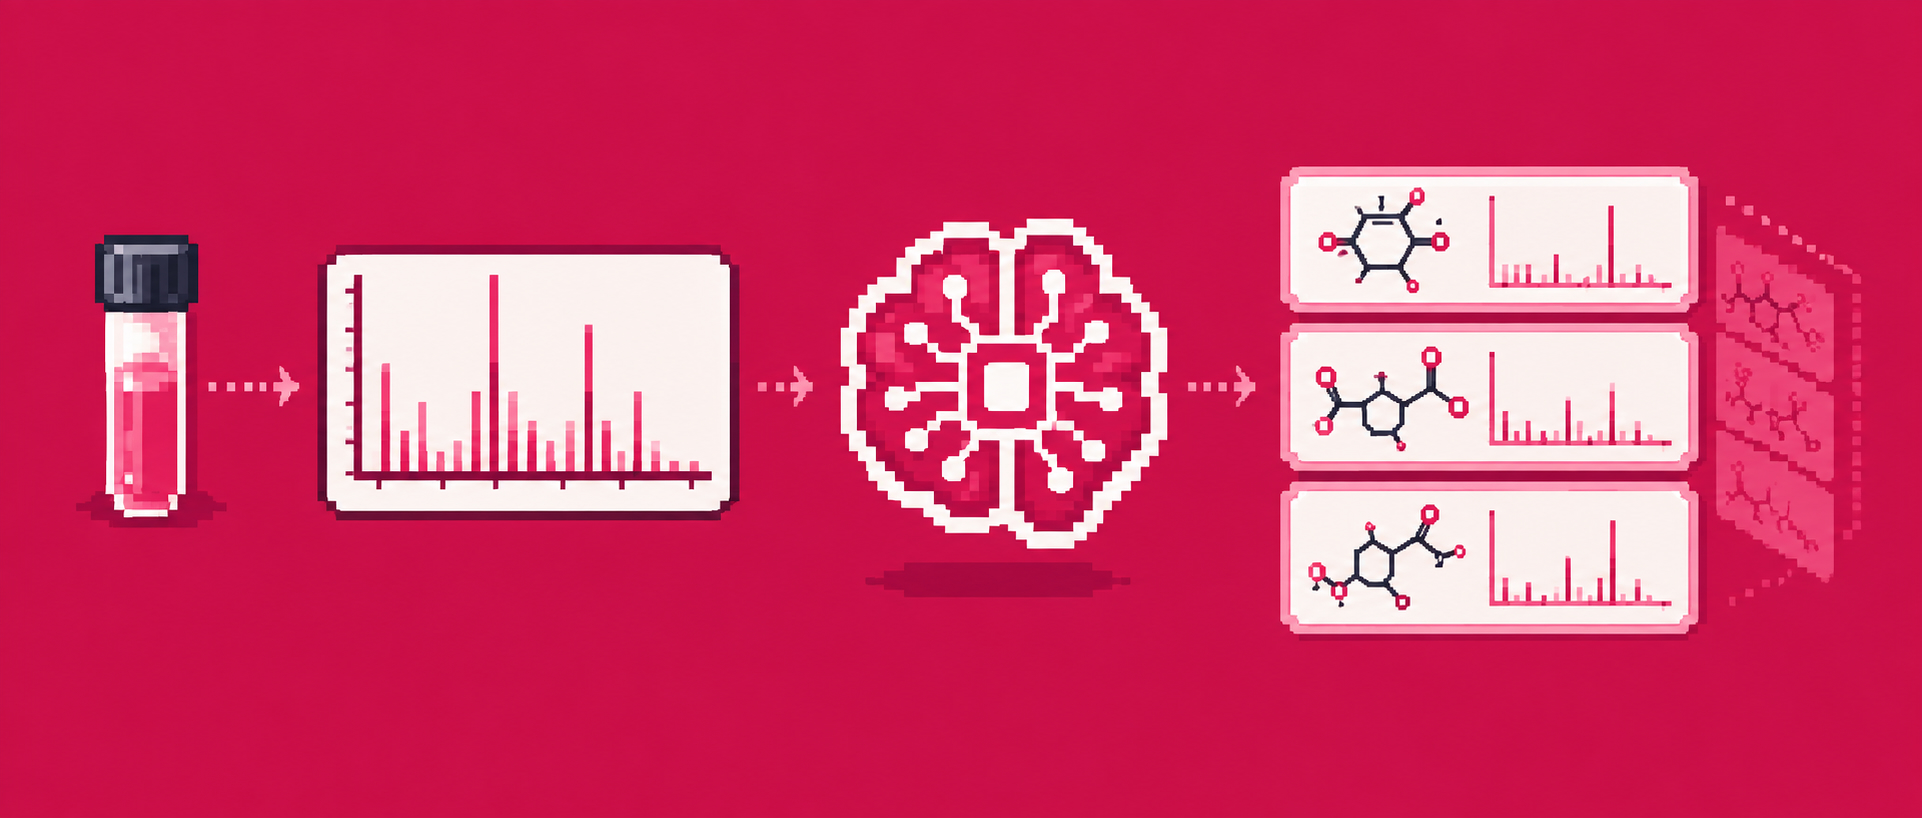
代謝omics研究において、質量分析装置は複雑な生試料から多数の低分子量シグナルを検出できますが、シグナルを検出することは第一歩に過ぎず、真に困難なのはそれらがどの分子に対応するかを決定することです。現在利用可能な実験参照スペクトルライブラリでカバーされている既知化合物は1%未満であり、そのため典型的な複雑な生試料では、代謝物の80%以上が未だ同定されていません。同時に、低分子構造空間はDNAやタンパク質よりもはるかに複雑であり、同じ分子式であっても多くの異なる構造が存在し、標準物質と参照スペクトルライブラリの継続的な拡張だけでは、この膨大な化学的空間を網羅するのは難しい。
この問題に対処するため、コーネル大学の研究チームは、低分子量質量分析のためのマルチエージェントニューロシンボリックAIフレームワークである「AI Molecule Explorer(AIMe)」を開発しました。 その中心的モデルであるDeepMS²Reasonerは、化学則、フラグメンテーション経路推論、およびニューラルネットワーク学習を組み合わせており、分子構造を出発点として化学結合切断や水素移動などのフラグメンテーション過程をシミュレートし、対応するMS²スペクトルを予測します。これにより、AIMeは従来の「実験質量スペクトル―参照スペクトルライブラリ」という直接マッチングを超え、未知の質量スペクトルをより大きな分子構造空間内で関連候補を探します。
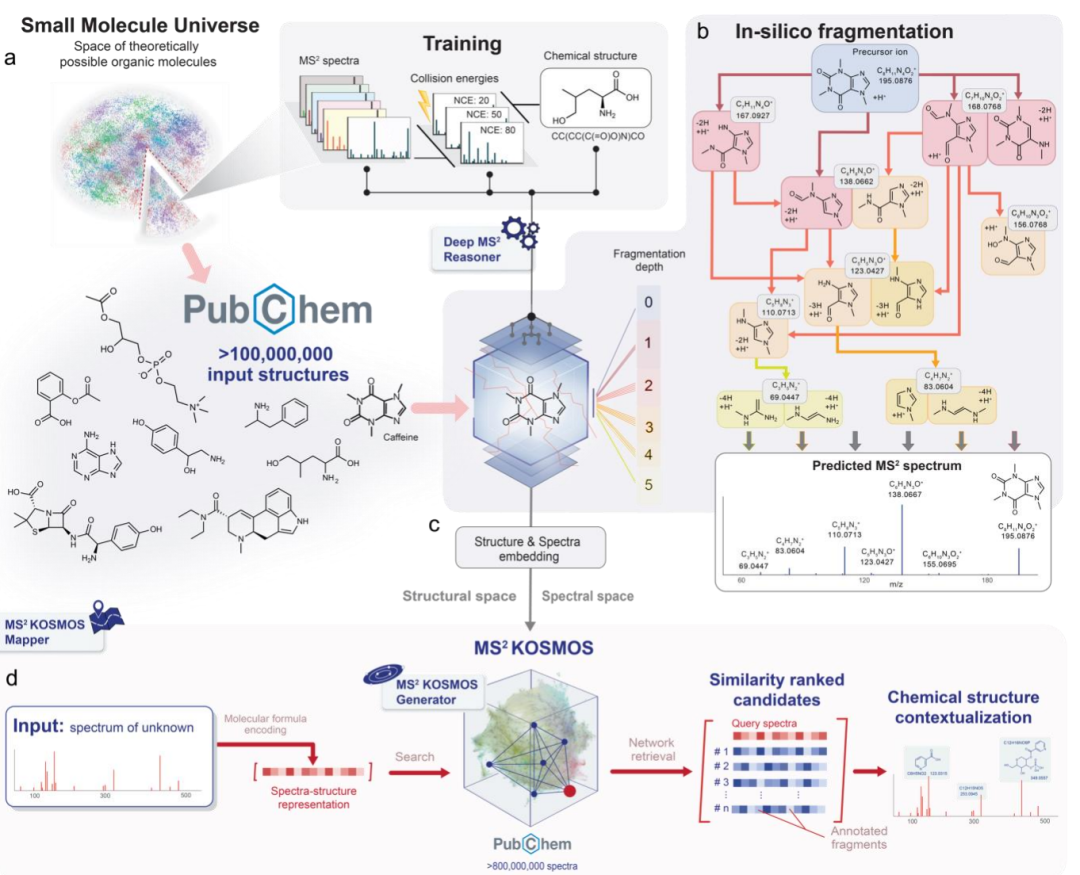
このような能力を既知の低分子空間へ拡大するために、研究チームはさらにMS²KOSMOSを構築し、PubChem内の1億種類以上の低分子に対して8億枚を超える予測MS²スペクトルを生成し、 検索可能な質量スペクトル空間を実験スペクトルライブラリと比較して約3桁拡大させました。ある一つの未知質量スペクトルに対し、AIMeは単なる候補分子だけでなく、対応するフラグメンテーション経路も提示し、具体的な質量ピークを可能性のある断片分子式および構造に関連付けます。その後、研究チームはマウス腸内細菌叢関連代謝物およびGNPS大規模質量データを用いて、その未知低分子解析ならびにデータベースレベル注釈機能を検証しました。
関連研究成果は、「Charting the small-molecule universe from mass spectra with neuro-symbolic AI」(ニューロシンボリックAIによる質量スペクトルからの低分子宇宙のマッピング)というタイトルで、プレプリントプラットフォームbioRxivに掲載されました。
論文を見る:
https://www.biorxiv.org/content/10.64898/2026.08.05.743095v1
実験質量スペクトルから数億サイズの低分子空間へ
AIMeで使用されるデータは主に以下の3つのタスクを担当しています:質量スペクトル予測モデルの訓練、検索可能な低分子空間の構築、そして実サンプルにおける解析能力の評価。
DeepMS²Reasonerの訓練データはNIST 2020 タンデム質量スペクトルデータベース由来です。 研究チームはプロトン化イオン[M+H]⁺および脱プロトン化イオン[M−H]⁻のMS²スペクトルを残し、金属含有化合物および構造的情報が不完全な標本を除き、質量スペクトルピークと分子構造を一様に処理しました。データは完全InChIKeyに基づき、80%のトレーニングセット、10%バリデーションセット、10%テストセットに分けられました。構造重複の影響を減らすため、最終評価時にはトレーニング分子とのMorganフィンガープリントTanimoto類似度が1.0となるテスト分子も除外されました。
モデルの外側一般化能力はCASMI 2022およびMassSpecGymという二つの独立したデータセットによって検査され、これらのいずれもトレーニングには参加していませんでした。構造検索実験ではさらに難易度を上げ、各実験質量スペクトルについて実際の構造に加え、最大49個の質量が近くかつ構造が似ているPubChem分子をノイズ項目として追加しました。 CASMIについては、厳格な全異性体テストも設計されており、同一分子式を持つすべてのPubChem異性体を候補に加えた結果、合計約250万枚の候補質量スペクトルに関わることになりました。
モデル訓練完了後、調査範囲はPubChem中の既知低分子へと拡大しました。m/z<1000の1億超の有機化合物に対して、AIMeは陽イオンモード・陰イオンモードそれぞれにおいて4種類の衝突エネルギーの下でMS²スペクトルを予測し、8億枚を超える予測質量スペクトルを生成し、それをMS²KOSMOSとして整理することで、後の未知質量スペクトルの検索基盤を提供しました。
実際の応用は大きく分けて2組のデータを対象としています。一つ目は無菌(GF)マウスおよび完全腸内細菌叢を持つ非特異的原虫(SPF)マウスの糞便メタボームからのものであり、そこから既存の標準物質やスペクトルライブラリでは同定できないが相対的に高濃度な微生物依存型シグナル111件を選択しました。もう一つはGNPS公開質量スペクトルデータベースからのもので、電荷状態や分子量といった条件でのフィルタリングを経て、計7,144,480件のコンセンサスMS²スペクトルが大規模検索に入りました。
モデルに分子の「どのように壊れるか」を学ぶさせる
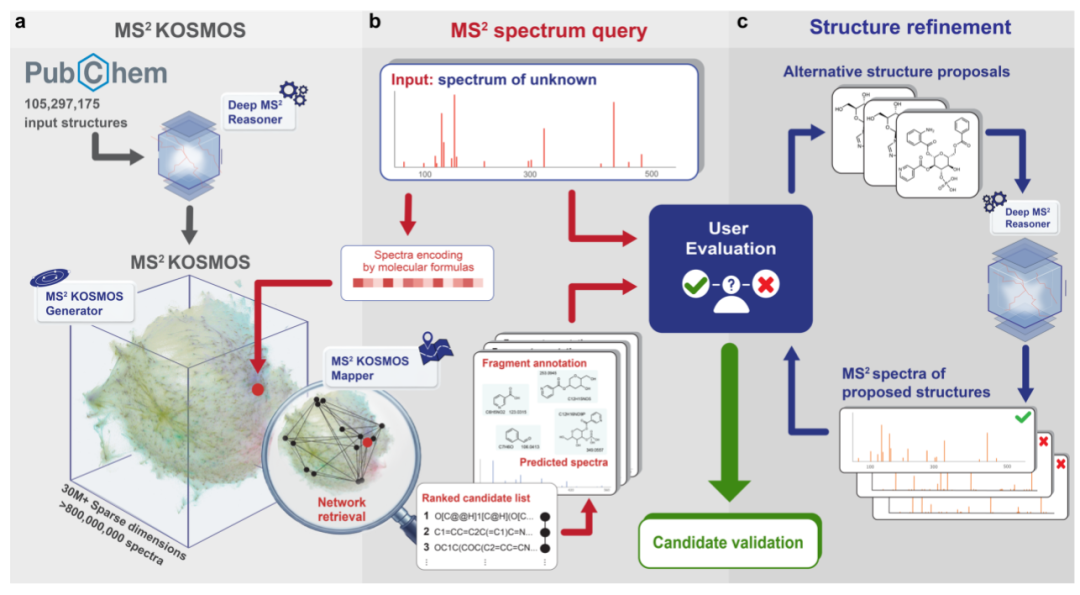
AIMeは互いに連携する3つのモジュールで構成されています: DeepMS²Reasonerは分子構造からMS²スペクトルおよびフラグメンテーション経路を予測することを担当し;MS²KOSMOSGeneratorはこのモデルを呼び出して大規模化学構造に対する予測を行い、検索可能なMS²KOSMOSを構築し;MS²KOSMOSMapperは実験上の未知質量スペクトルを取り扱い、MS²KOSMOSの中から潜在的に関連する分子および構造的近傍領域を見つけ出すことを担います。大規模予測を事前に終えておくことで、実際問い合わせ時に必要な計算量は絞り込まれた候補構造のみを対象とした微細な演算となります。
その中で、DeepMS²Reasoner がシステム全体の質量スペクトル予測能力を決定します。 これは、「ある分子に対してどのピークが存在し、ピークの強度はどれくらいか」という情報を直接的に学習するのではなく、前駆子イオンから始めて崩壊過程を一歩ずつシミュレートし、ダイナミックに有向非巡回グラフ(DAG)を構築します。グラフ内のノードは異なるフラグメントを表し、エッジは具体的な崩壊反応に対応しています。モデルは線状結合の切断、環状結合の切断、および除去という3つのメカニズムを考慮し、電荷の変化と水素移動も記録します。さらに、崩壊の深さを事前に制限しないため、複数の段階的な結合開裂や環開裂、異性化を経て初めて形成されるような複雑なフラグメントも表現することができます。
どの崩壊経路を選択するかについては、ニューラルネットワークコンポーネントであるALEA(行動尤度推定アドバイザー)が判断を担当します。 ALEAはGraphormerアーキテクチャを採用しており、現在のフラグメントにおける原子、化学結合、環構造、水素状態に加え、衝突エネルギー、装置の種類、付加イオンなどの実験条件下で、各崩壊反応および「崩壊終了」に対する確率を割り当てます。その後、DeepMS²Reasoner はこれらの確率を崩壊経路上で伝播させ、各フラグメントで最終的に蓄積された「終了確率」に基づいて対応する質量スペクトルのピーク強度を取得します。
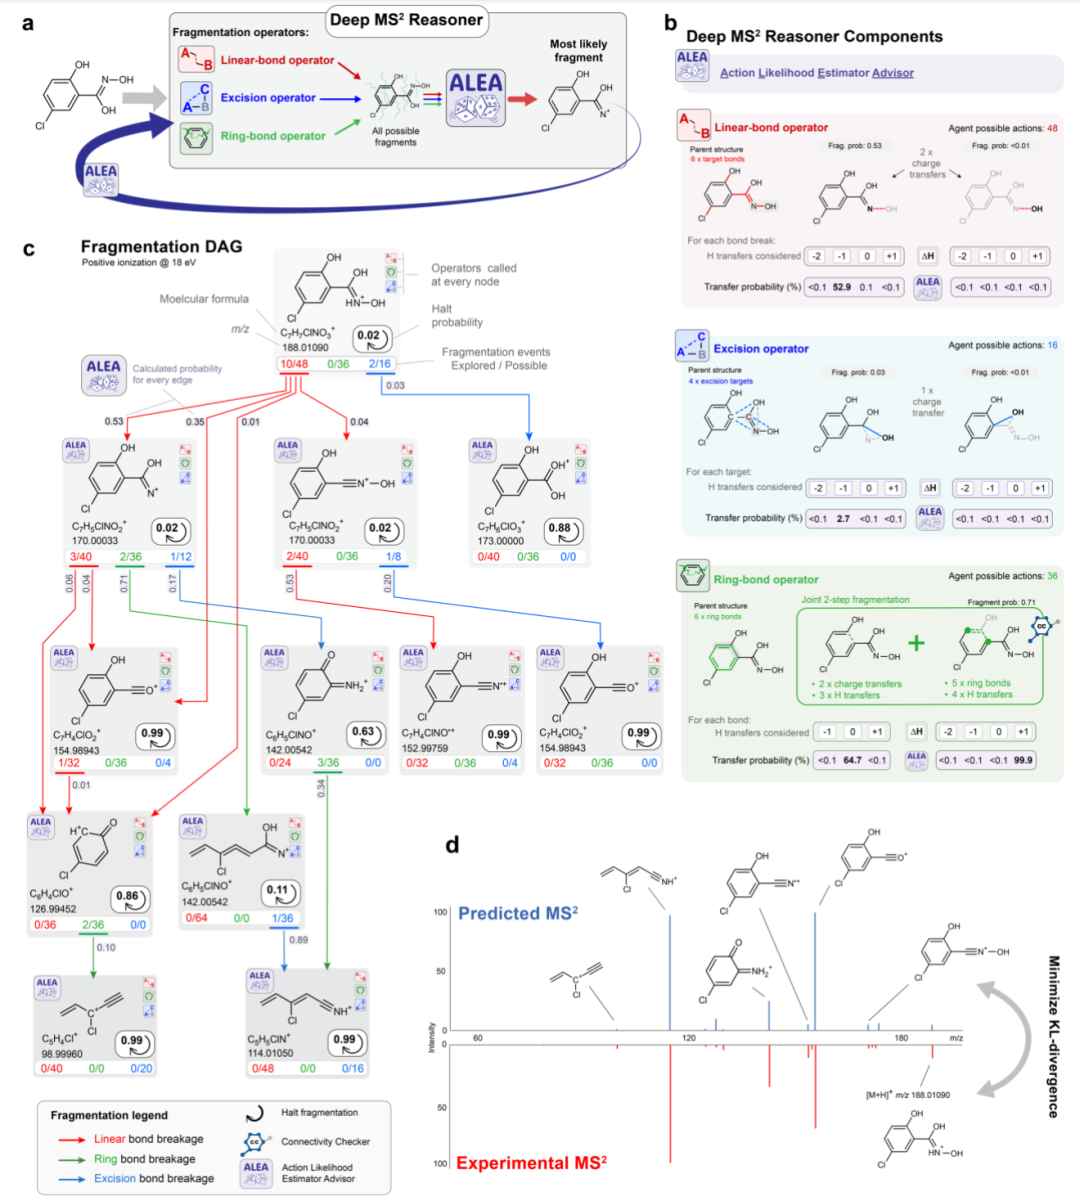
ニューラルネットワークはどの経路が起こりやすいかを判断し、化学則はどのような経路が可能かどうかを制約します。それぞれの崩壊ステップの後、システムは分子間の接続関係や水素収支といった化学的要件をチェックし、不合理な崩壊計算は次の工程に進みません。また、同じ構造および化学状態を持つフラグメントは統合され、重複検索が削減されます。確率が非常に低い分岐については展開を行わないため、分子の複雑さが増すにつれて爆発的に増加するすべての崩壊経列挙による計算コストを防ぐことができます。
トレーニングにおいて、パラメータ学習の対象となるのは主に ALEA です。その他の崩壊操作や化学的妥当性の判定はすべて決定的ルールによって行われます。モデルはKLダイバージェンスを用いて予測スペクトルと実測スペクトルの差異を評価すると同時に正則化制約を導入し、複数のメカニズムが同じスペクトルピークを説明できる場合でも、より単純な線状結合の開裂を優先するように誘導します。トレーニングではコース学習手法を採用し、小さく崩壊経路が簡単な分子から始め、次第により大きく複雑な化合物を加えていくことで、モデルがまず移転可能な局所的な崩壊法則を習得できるようにしています。
DeepMS²Reasoner が解決するのは「構造からの質量スペクトル予測」であり、MS²KOSMOS はさらに「数億個の分子の中からどのように探索するか」という課題に対処します。 MS²KOSMOS Generator は、各予測スペクトルをフラグメント元素組成からなるスパースベクターとして表し、逆インデックスを作成します。未知の質量スペクトルに対し、システムは何億もの分子を一つずつ比較する必要はなく、まず照会スペクトルと共有するフラグメント元素組成を持つ候補を検索し、次に MS²KOSMOS Mapper によって実際の衝突エネルギー等の実験条件に基づき候補の質量スペクトルを再度予測して順位付けを行い、対応する崩壊DAGと共に返却します。
予測質量スペクトルから未知分子の同定へ
本研究ではまず最も基礎的な質量スペクトル予測タスクを通じて DeepMS²Reasoner を検証しました。NIST 2020 の独立テストセットにおいて、予測スペクトルと実測スペクトルの平均コサイン類似度は 0.83 に達し、中央値は 0.89 でした。他の対抗モデルの平均値は 0.61〜0.75 の範囲にとどまりました。完全に独立した CASMI 2022 および MassSpecGym データセットにおいても、DeepMS²Reasoner の平均コサイン類似度はそれぞれ 0.67 と 0.59 であり、いずれも参加モデルの中で最高の成績を残しました。CASMI の例を見ると、サンプルの 40%超において、DeepMS²Reasoner はいかなる対抗モデルよりも実結果に近い予測スペクトルを提供していました。
単に質量スペクトルを予測することと比較して、さらに困難なタスクは逆に実測スペクトルから正しい分子を探し出すことです。本調査では真の構造体を多数の近傍質量かつ構造的似通った候補分子とともに配置して検索を行いました。CASMI の全異性体テストにおいて、DeepMS²Reasoner の Top-1、Top-10、Top-50 の精度はそれぞれ 35.6%、64.4%、79.8% となり、特に Top-1 および Top-10 では第2位のFraGNNet よりも10ポイント以上の差をつけて優位性を示しました。
モデルが多段崩壊処理を行う能力についても特定の分子を用いて確認されました。ビオチンを例にとると、DeepMS²Reasoner の予測スペクトルと実測スペクトルのコサイン類似度は 0.88 に達しました。 一部の主なフラグメントは一度の結合切断だけで形成できず、官能基の脱落、環開裂、さらなる分解など連続的過程を経なければなりません。しかしこのモデルはそれらのフラグメントに対応する多段的な経路を示し、衝突エネルギーの変動に応じて異なる程度の崩壊状況を予測することが可能です。
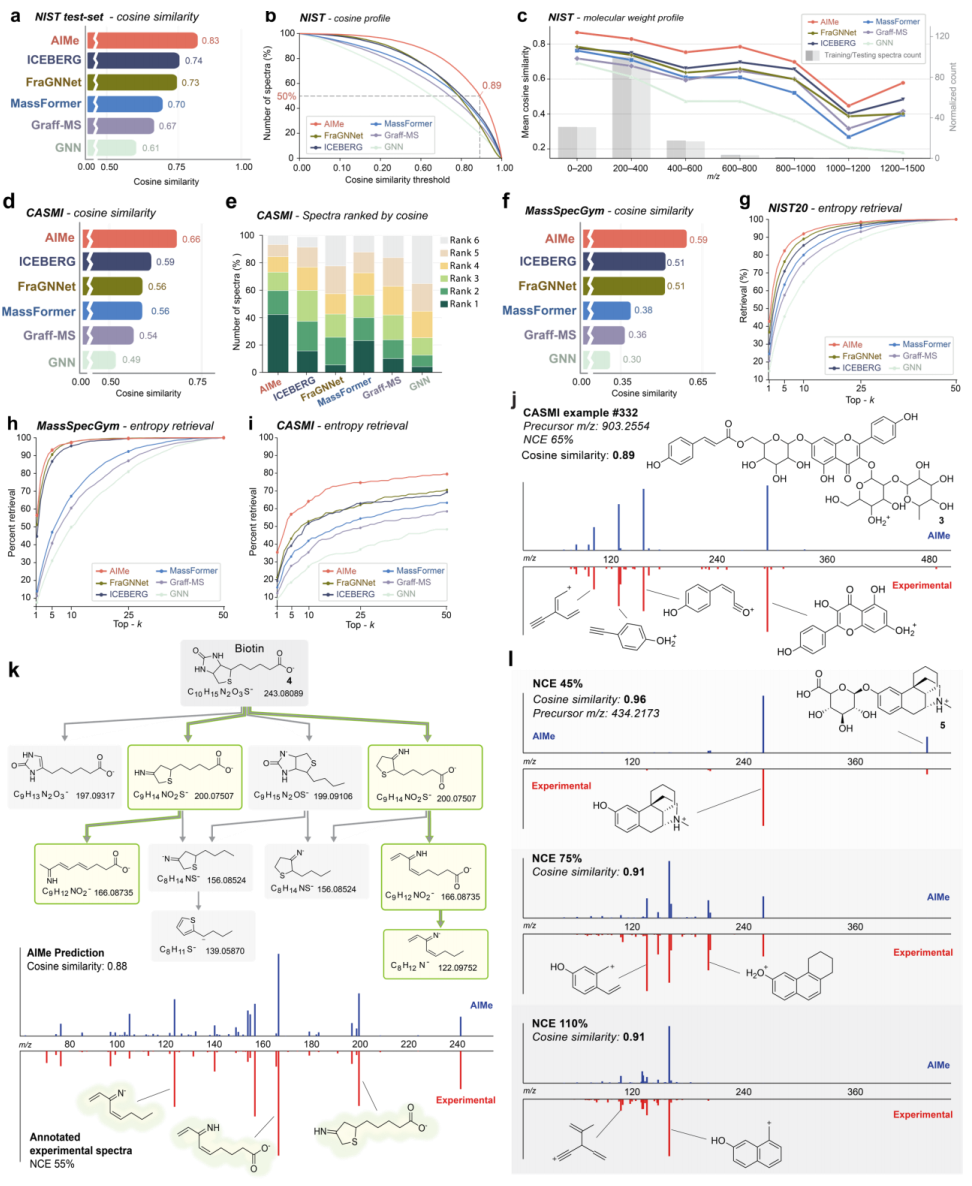
DeepMS²Reasoner の質量スペクトル予測パフォーマンス
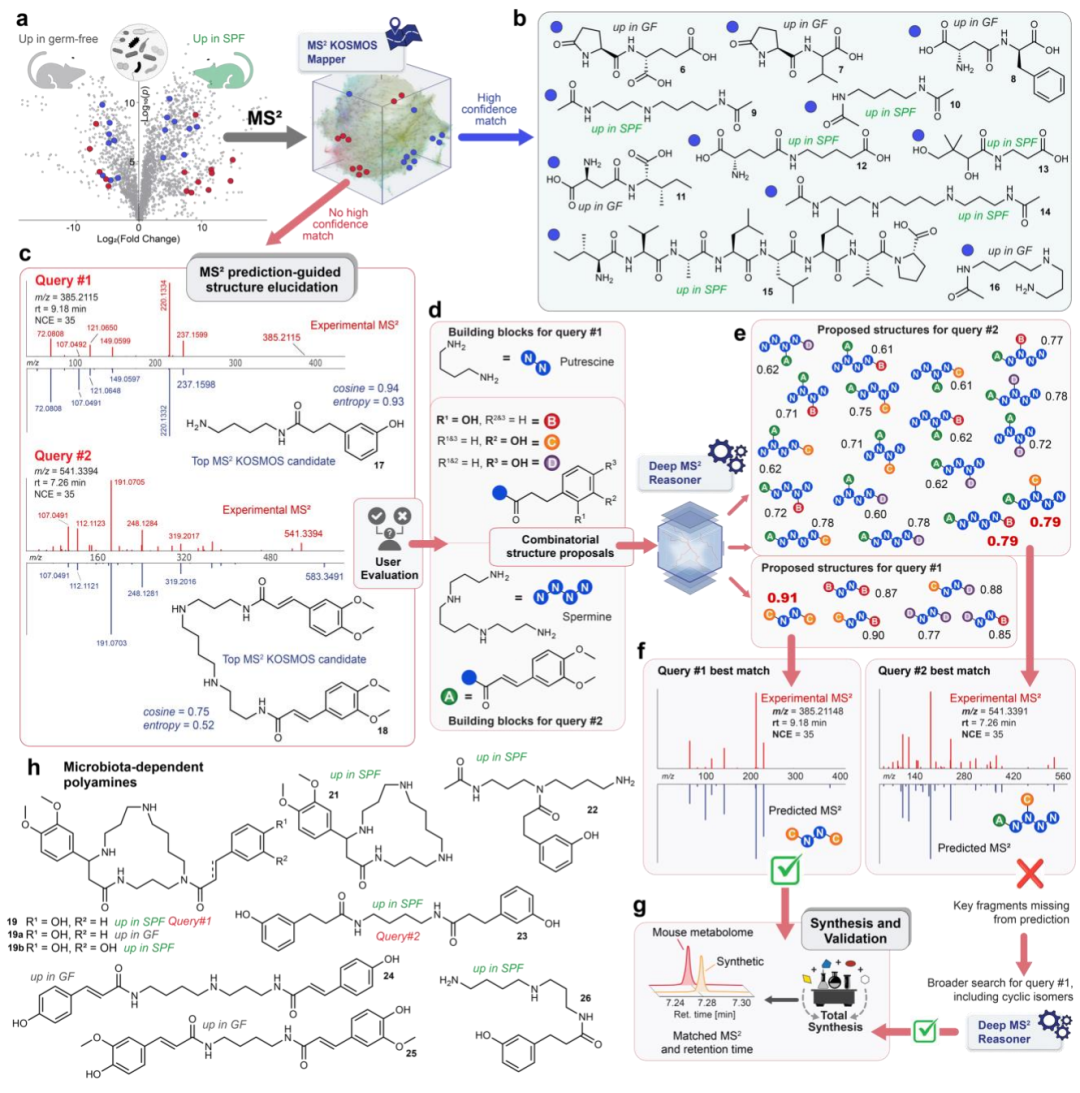
その後、本研究ではAIMeを実際の未知代謝物の解明に応用しました。マウス代謝組に含まれる111種類の未特定微生物叢依存型シグナルのうち、約三分の一程度が既知化合物との間で高い一致を見出し、残りは記述されていない新規構造体に該当する可能性が高いことが分かりました。
研究者はさらに2つの不明物質を選択し、その構造解明を行った。AIMeが提示したフラグメント構造に基づき、複数の候補分子を組み合わせ、これらの候補のMS/MSスペクトルを予測して実験結果と比較した。ある不明物質において、最適な初期候補のコサイン類似度はすでに0.79に達していたものの、依然として実験で得られた重要なフラグメントの一部が欠けていたため、研究チームは環状構造を検討し続け、最終的に希少なマクロサイクルポリアミン誘導体を特定した。化学合成を行い保持時間とMS/MSスペクトルを比較することで、両方の候補構造が検証され、これにはこれまでマウスやヒトでの報告例がなかった多胺構造も含まれていた。さらなる検索により、関連する多種類の代謝物がヒト由来サンプルにも存在することが示された。
最後に、本研究ではAIMeをGNPSデータベース内の714万以上のエントロピーマススペクトルへ拡張しました。コサイン類似度の閾値を0.7とした場合、約269万個の質量スペクトルが注釈付き候補を得ており、これはクエリ総数の約三分の一にあたります。閾値を0.8まで引き上げてもなお、約127万件の高類似度注釈が増加し、これに対応するのはGNPS内で以前から注釈付けされていなかった2600万以上のオリジナル質量スペクトルです。このように、AIMeの適用範囲は単一分子の質量スペクトル予測から、データベース規模の不確定物質へのアノテーションへと拡大されました。
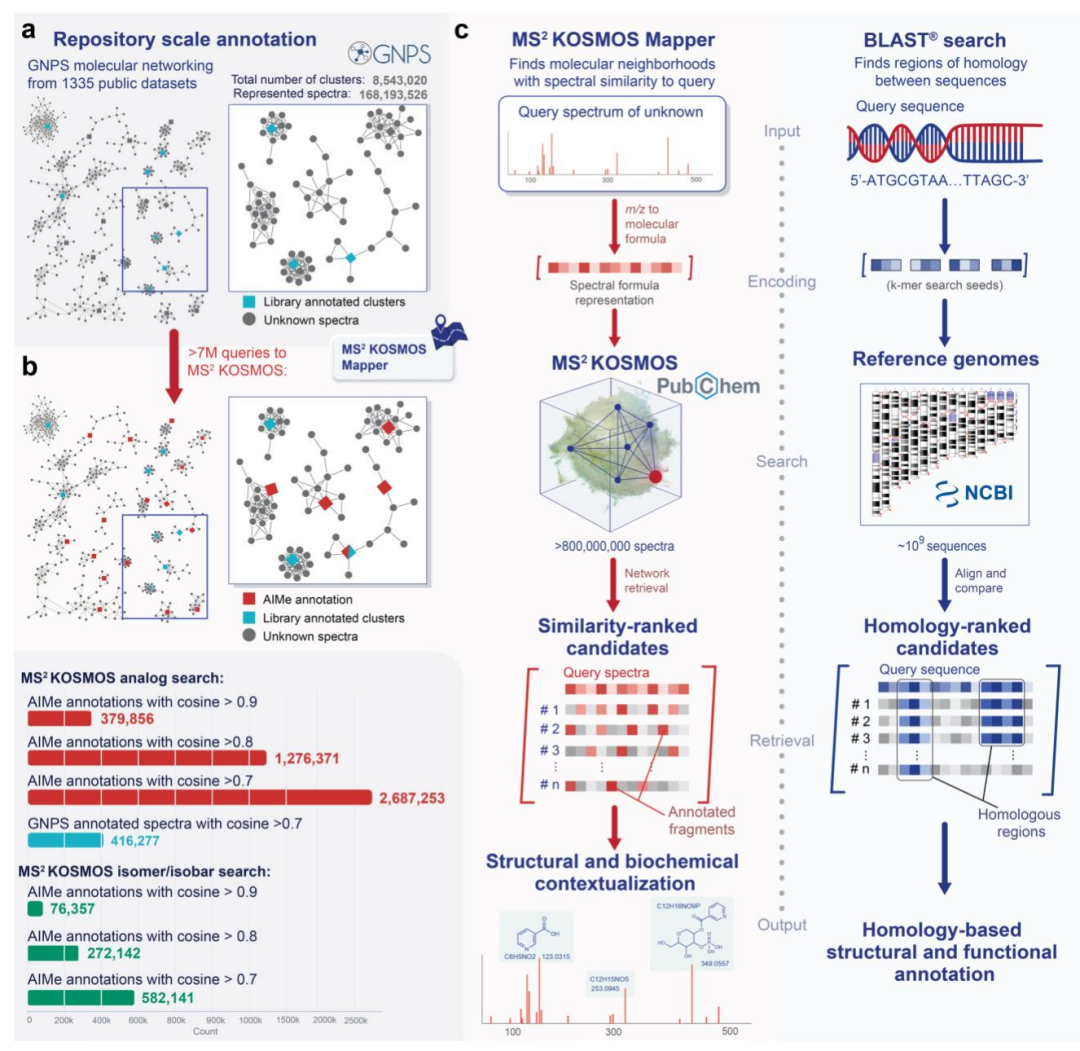 *GNPSデータベースにおけるAIMeの大規模な注釈結果*
これらの結果は、小分子構造同定が完全に自動化されたことを意味しません。分子量が大きくなるにつれて可能な断片化経路が明らかに増加するため、またトレーニングデータ中の大分子のカバレッジが相対的に不十分であることから、DeepMS²Reasonerの予測性能は低下します。より重要なのは、MS/MSのみでは通常、最終的な構造確認を行うのに不十分だということです。メタボロミクスにおける標準に従い、保持時間、核磁気共鳴(NMR)、または純粋試料などの独立的証拠がない場合には、AIMeによって提供される結果は主にレベル3のアノテーションに分類され、その役割は候補範囲の絞り込み、構造仮説の提案および断片根拠の説明に近いものであり、最終の確認には依然として実証が必要です。
最後に
AIMeの意義は、質量スペクトルの予測精度をさらに高めることだけでなく、未知の小分子の解析方法を変革しようとする点にあります。従来、研究者たちは未知の質量スペクトルを目の前にすると、限られた規模の実験用スペクトルライブラリの中で直接的な一致を探すしかありませんでした。一方、AIMeはまずモデルを用いて既知の小分子空間を検索可能な予測質量スペクトル空間に変換し、その後フラグメント構造や断片化経路を活用しながら段階的に候補範囲を狭めていきます。現在でもそれは純粋試料やNMRといった実験的検証に取って代わるものではありませんが、「参照スペクトルが存在しない」という理由で追跡困難だった多数のシグナルに対して、さらに深く調査できる可能性をもたらしています。
メタボロミクスの観点から見れば、これは単純に一連のスペクトルライブラリエントリーを増やすよりも重要です:未知の質量スペクトルはもはや「マッチング成功」「マッチング失敗」の二択ではなく、構造仮説の立案とその検証の出発点となりつつあります。