HyperAI
Command Palette
Search for a command to run...
Papers
Articles de recherche en IA de pointe mis à jour quotidiennement pour vous aider à suivre les dernières tendances en IA
articles
SmallThinker : Une famille de modèles de langage à grande échelle efficaces entraînés nativement pour le déploiement local
Reconstruction de l'intelligence spatiale 4D : Un état de l'art
Rep-MTL : Déverrouiller le pouvoir de la salience des tâches au niveau de la représentation pour l'apprentissage multi-tâches
ARC-Hunyuan-Video-7B : Compréhension structurée des vidéos du monde réel en courte durée
Optimisation de politique renforcée agente
Spécification de correction auto : atténuer le piratage de récompense en contexte par une révision au moment des tests
PRIX : Apprendre à planifier à partir de pixels bruts pour le pilotage autonome en boucle complète
Chat avec l'IA : La tournure surprenante de la communication vidéo en temps réel passant d'un humain à une IA
MMBench-GUI : Cadre d'évaluation hiérarchique pour les agents GUI multiplateformes
Recherche profonde avec diffusion en temps de test
La géométrie de la quantification des LLM : GPTQ comme l'algorithme du plan le plus proche de Babai
MedIQA : Un modèle fondamental évolutif pour l'évaluation de la qualité des images médicales basée sur les prompts
OS-MAP : Jusqu'où peuvent aller les agents utilisant l'ordinateur en termes de largeur et de profondeur ?
Optimisation de la politique budgétaire hiérarchique pour le raisonnement adaptatif
Captain Cinema : Vers la génération de courts métrages
LAPO : L'optimisation adaptative de la politique par l'intégration de l'efficacité du raisonnement
MUR : Raisonnement guidé par l'incertitude de la quantité de mouvement pour les grands modèles linguistiques
∇NABLA : Attention Adaptative par Bloc aux Voisinages
Optimisation de la politique des séquences de groupe
SafeWork-R1 : Coévolution de la sécurité et de l'intelligence en vertu de la loi AI-45
Découpler la connaissance et le raisonnement dans les LLM : Une exploration basée sur la théorie des deux systèmes cognitifs
Réf. : Form -- Réduction des prioris humains dans la vérification formelle logicielle évitable avec le renforcement par apprentissage dans les modèles de langage à grande échelle : Une étude préliminaire sur Dafny
RAVine : Évaluation alignée sur la réalité pour la recherche agente
Peut un domaine aider les autres ? Une étude centrée sur les données sur le raisonnement multi-domaines par apprentissage par renforcement
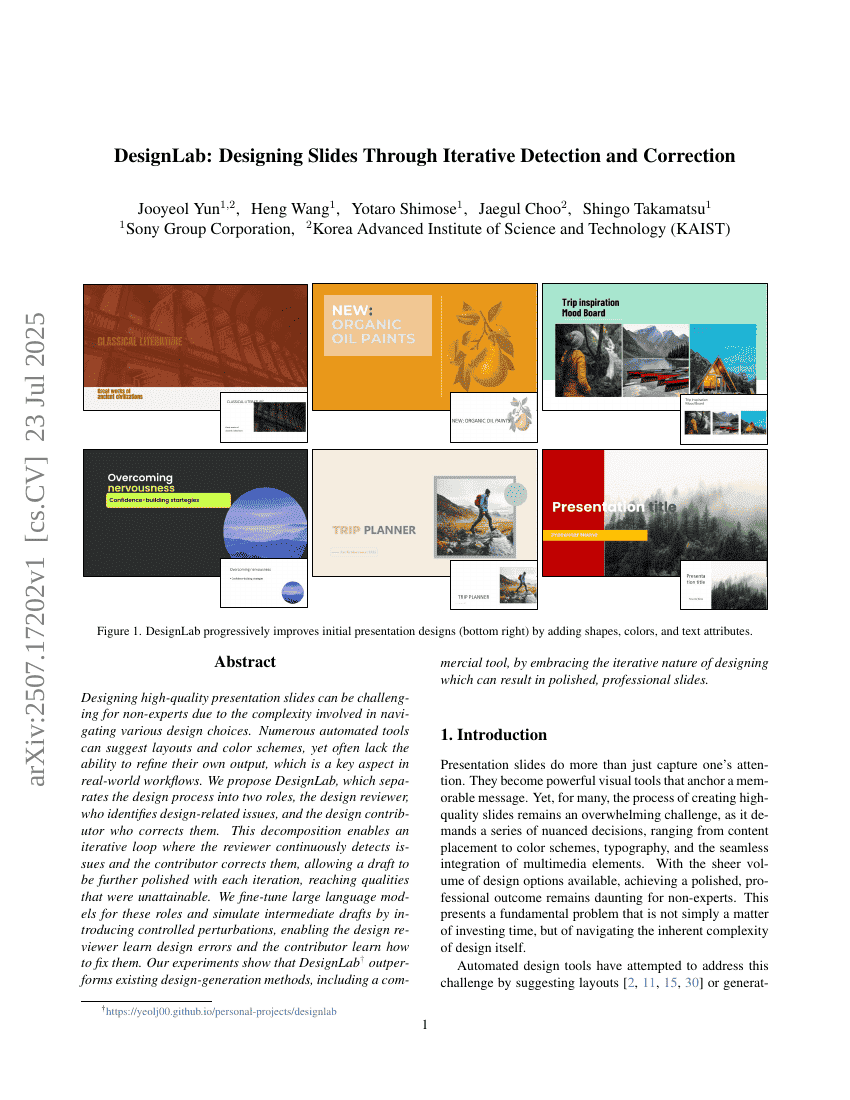
DesignLab : Conception de diapositives par détection et correction itératives
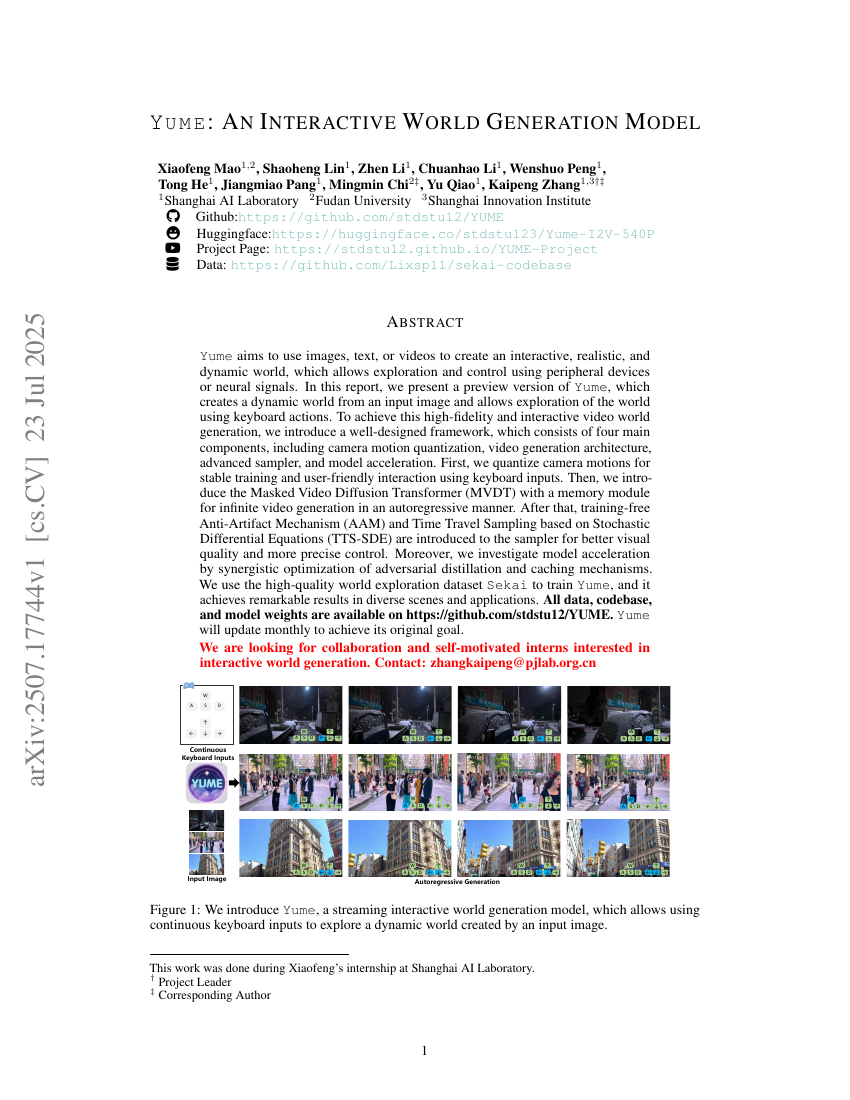
Yume : Un modèle de génération de monde interactif
Pixels, Motifs, mais pas de Poésie : Voir le Monde comme les Humains
Construction d'un MLLM ophtalmique pour la collaboration diagnostic-positionnelle par le raisonnement en chaîne cognitive clinique
HySafe-AI : Cadre d'analyse architectural de sécurité hybride pour les systèmes d'intelligence artificielle : Une étude de cas
Zebra-CoT : Un jeu de données pour le raisonnement multimodal vision-langage intercalé
Apprentissage par renforcement semi-off-policy pour le raisonnement lent vision-langage
Suréchantillonner ce qui compte : un échantillonnage latent adaptatif par région pour des transformateurs de diffusion accélérés