Command Palette
Search for a command to run...
Précision De La Reconnaissance En zero-shot Atteignant 95,4 % : Le MIT Et Ses Partenaires Proposent Le Modèle CLaC Pour Réaliser Un Alignement Multimodal Entre La Structure Des Matériaux Et Le Langage

Une tâche importante de la découverte des matériaux consiste à sélectionner des candidats possédant des performances cibles au sein d’un vaste espace chimique et structurel. Ces dernières années, les réseaux de neurones sur graphes ont réalisé des progrès significatifs dans des tâches telles que la prédiction des propriétés des matériaux et la génération de structures, en apprenant à partir de la structure atomique tridimensionnelle des cristaux. Cependant, ces modèles reposent généralement sur des étiquettes de propriétés prédéfinies ou des conditions numériques, et peinent à comprendre directement les besoins en matériaux décrits en langage naturel ; les grands modèles de langage, bien qu’ils excellent dans le traitement du texte, manquent d’une représentation précise de la structure spatiale des cristaux et de leurs propriétés physiques.
L’association de la structure cristalline et du langage naturel offre une nouvelle perspective pour la découverte des matériaux. Toutefois, la taille limitée des bases de données cristallines existantes et la concentration de la littérature académique sur quelques matériaux populaires créent un manque de correspondance suffisante entre les descriptions textuelles et les propriétés des matériaux, ce qui limite l’efficacité de l’entraînement des modèles multimodaux.
Face à ce problème, des chercheurs du MIT, de l’Institut UNIST (Ulsan National Institute of Science and Technology), de l’Université de l’Illinois à Urbana-Champaign, du MIT-IBM Watson AI Lab, et d’autres institutions ont proposé le modèle Contrastif Langage-Cristaux (Contrastive Language-Crystals, CLaC). Ce modèle utilise des grands modèles de langage pour générer des narratifs synthétiques basés sur les propriétés des matériaux, et cartographie, grâce à l’apprentissage contrastif, les structures cristallines et le langage naturel dans un espace de représentation partagé. Les expériences montrent que, par rapport aux modèles entraînés directement sur des textes issus de la littérature académique, CLaC présente des avantages évidents dans les tâches de compréhension des matériaux en zéro-shot et de récupération de matériaux guidée par le langage naturel.
Les résultats de ces travaux de recherche, intitulés « Scaling multimodal materials representation learning with synthetic narratives », ont été publiés dans Nature Communication.
Lien de l’article :
https://www.nature.com/articles/s41467-026-76378-7#Sec10
126 000 paires données cristal-texte, élargissant la couverture sémantique des matériaux
Pour entraîner des modèles multimodaux de cristaux, il est nécessaire d’établir d’abord une correspondance entre la structure cristalline et le langage naturel. Bien que les bases de données de matériaux existantes aient accumulé un grand nombre de structures cristallines et de propriétés calculées, les textes associés sont principalement dispersés dans les articles académiques et se concentrent sur un petit nombre de matériaux bien étudiés. Ils couvrent difficilement une grande diversité de structures cristallines et ne garantissent pas que les textes contiennent des informations complètes sur les propriétés des matériaux.
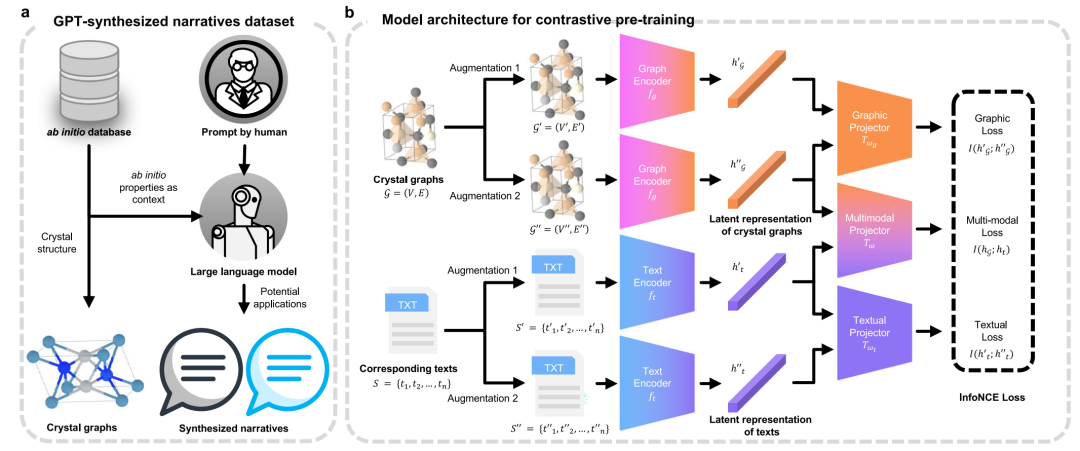
Pour y remédier, cette étude s’est appuyée sur la base de données Materials Project pour collecter environ 126 000 données de matériaux cristallins, en construisant séparément des structures sous forme de graphes cristallins et des descriptions en langage naturel. Les structures cristallines ont été converties en données de graphes à l’aide de l’outil Jarvis-tools, représentant la structure tridimensionnelle par les atomes et leurs interactions ; pour la partie textuelle, le jeu de données de narratifs synthétiques GPT, développé précédemment par les chercheurs, a été utilisé, générant des textes descriptifs à partir des propriétés calculées des matériaux dans la base de données via des grands modèles de langage.
Contrairement à une simple conversion des formules chimiques ou de la composition élémentaire en texte, les narratifs synthétiques s’appuient sur les propriétés calculées des matériaux et couvrent des informations telles que les caractéristiques structurelles, les propriétés physiques, les comportements fonctionnels et les applications potentielles. Par exemple, à partir de données connues telles que la composition, le gap de bande et la densité d’un certain cristal, le modèle génère des descriptions incluant les caractéristiques physiques correspondantes et les informations d’application, établissant ainsi une correspondance entre la structure cristalline et une sémantique des matériaux plus riche.
Pour valider l’efficacité des narratifs synthétiques, les chercheurs ont également construit un jeu de données de contrôle basé sur la littérature académique. En utilisant les formules chimiques comme critères de recherche, ils ont extrait des paragraphes pertinents du texte intégral d’environ 4 millions d’articles scientifiques, obtenant finalement environ 400 000 paires données matériau-phrase en langage naturel, mais ne couvrant qu’environ 400 composés inorganiques. En comparaison, le nombre de types de cristaux différents couverts par les narratifs synthétiques GPT est environ 300 fois supérieur à celui des données issues de la littérature académique.
Les deux types de données textuelles ont été utilisés pour entraîner respectivement CLaC-Synthetic (version narratifs synthétiques) et CLaC-Paper (version littérature académique), afin de comparer l’impact de différentes sources de données sur les performances du modèle. Les jeux de données ont été divisés en ensembles d’entraînement, de validation et de test selon un ratio de 8:1:1.
Combinaison des réseaux de neurones sur graphes et des modèles de langage pour aligner la structure cristalline et le langage naturel
CLaC s’inspire des méthodes d’apprentissage contrastif de CLIP dans le domaine vision-langage, en apprenant conjointement la structure cristalline et la description textuelle pour mapper les deux types d’informations dans un espace de représentation partagé, permettant au modèle de calculer la similarité sémantique entre les matériaux et le langage naturel.
CLaC adopte une architecture à double encodeur, composée d’un encodeur de graphes cristallins, d’un encodeur de texte et d’un module de projection multimodale. L’encodeur de graphes cristallins est chargé d’extraire des informations telles que la composition atomique, l’environnement de coordination locale et la géométrie tridimensionnelle, tandis que l’encodeur de texte traite les descriptions en langage naturel concernant les propriétés des matériaux, les caractéristiques fonctionnelles et les besoins d’application. Après conversion respective en vecteurs, ces deux types d’informations entrent dans un espace latent unifié via le module de projection, établissant une correspondance entre la structure cristalline et la sémantique du texte.
En ce qui concerne l’encodage de la structure cristalline, cette étude utilise le réseau de neurones sur graphes PaiNN (Polarizable Atom Interaction Neural Network), qui apprend les relations spatiales entre les atomes grâce à un mécanisme de propagation de messages équivariants, capturant les environnements atomiques locaux tout en préservant les informations géométriques. CGCNN et le modèle de potentiel interatomique pré-entraîné ORB ont été introduits comme contrôles.
Pour l’encodeur de texte, plusieurs modèles de langage pré-entraînés ont été comparés, notamment SciBERT, MatSciBERT, OPT-125M et Galactica-125M, couvrant deux types d’architectures : l’encodage bidirectionnel et l’auto-régression. En combinant les résultats des expériences ultérieures, les chercheurs ont finalement retenu la combinaison PaiNN et Galactica-125M comme principaux encodeurs.
Le cœur de CLaC est l'apprentissage contrastif inter-modal. Lors de l'entraînement, les graphes de cristaux et les descriptions textuelles d'un même matériau sont considérés comme des paires positives, tandis que les combinaisons structure-texte de matériaux différents constituent des paires négatives. Grâce à la fonction de perte contrastive InfoNCE, le modèle augmente la similarité vectorielle des paires correctes et diminue celle des paires non correspondantes, apprenant ainsi progressivement les relations entre la structure cristalline, les propriétés physiques et le langage naturel.
Compte tenu de la rareté des données appariées, cette étude a également intégré un apprentissage contrastif intra-modal, permettant au modèle d'identifier différentes représentations structurelles d'un même cristal ainsi que différentes descriptions textuelles d'un même matériau. Les graphes de cristaux sont augmentés par perturbation des positions atomiques et par une déformation du réseau cristallin de 0 à 5 % ; les textes sont variés par suppression aléatoire et permutation de l'ordre des phrases, avec une probabilité de conservation de 50 % pour chaque phrase. Ces méthodes améliorent la robustesse du modèle face aux légères variations structurelles et aux différences d'expression textuelle. Les chercheurs n'ont pas opté pour la substitution d'éléments de la même famille, car cela pourrait modifier l'environnement de coordination, la structure électronique et les propriétés réelles des matériaux.
Lors du pré-entraînement, l'encodeur de graphes de cristaux est entraîné depuis zéro, tandis que l'encodeur de texte est initialisé avec des poids pré-entraînés. Le modèle utilise un espace d'embedding conjoint de 512 dimensions, l'optimiseur AdamW, un taux d'apprentissage de 2×10⁻⁵, une taille de lot effective de 256 et un maximum de 5 époques.
Une fois le pré-entraînement terminé, CLaC peut convertir des requêtes en langage naturel en vecteurs et les comparer par similarité aux vecteurs de cristaux pré-calculés dans une base de données de matériaux, afin de filtrer les candidats possédant les propriétés cibles, sans avoir à réentraîner le modèle pour chaque propriété. Toutefois, CLaC ne génère pas directement de structures cristallines ; son rôle principal est d'établir un lien entre le langage et la structure cristalline, soutenant ainsi la conception inverse de matériaux en aval.
De la compréhension des matériaux en zero-shot à la recherche en langage naturel : validation de l'apprentissage inter-modal
Pour évaluer les performances de CLaC, les chercheurs ont conçu plusieurs expériences en zero-shot, axées sur les capacités du modèle en matière de compréhension cristalline, de recherche en langage naturel et de représentation des propriétés physiques, en les comparant à des modèles non entraînés, ainsi qu'aux modèles de référence Gemma-3-1b-it et CLaC-Paper.
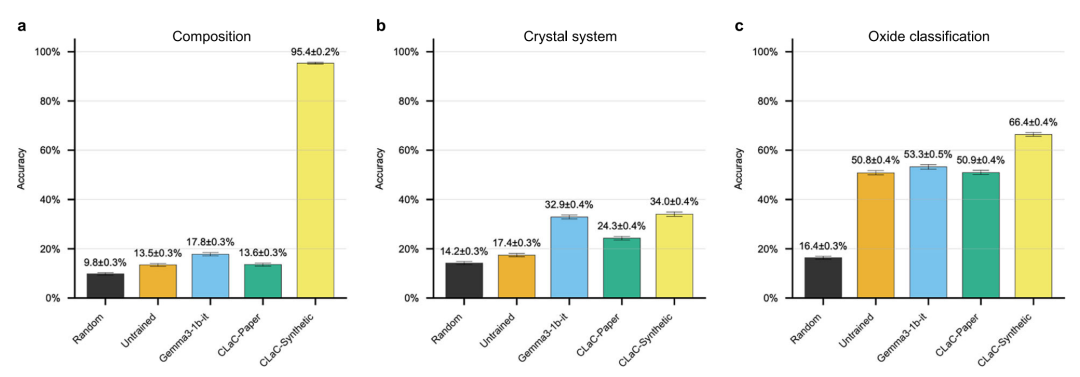
Premièrement, dans l'expérience de compréhension multimodale en zero-shot, le modèle doit sélectionner la description correcte parmi plusieurs textes candidats en se basant sur la structure cristalline, couvrant trois types de tâches : composition élémentaire, système cristallin et type d'oxyde. Les résultats montrent que CLaC-Synthetic atteint une précision de 95,4 % ± 0,2 % dans la classification de la composition élémentaire, nettement supérieure aux 17,8 % de Gemma-3-1b-it et aux 13,6 % de CLaC-Paper ; la précision de la classification des oxydes atteint 66,4 % ± 0,4 %, surpassant également les autres modèles.
Cependant, la précision de CLaC-Synthetic dans la classification des systèmes cristallins n'est que de 34,0 % ± 0,4 %, proche des 32,9 % de Gemma-3-1b-it. Cela pourrait être dû à une distribution déséquilibrée des données des systèmes cristallins et à une petite taille de lot d'entraînement, indiquant que la compréhension du modèle des caractéristiques géométriques fines, telles que la symétrie cristalline, reste limitée.
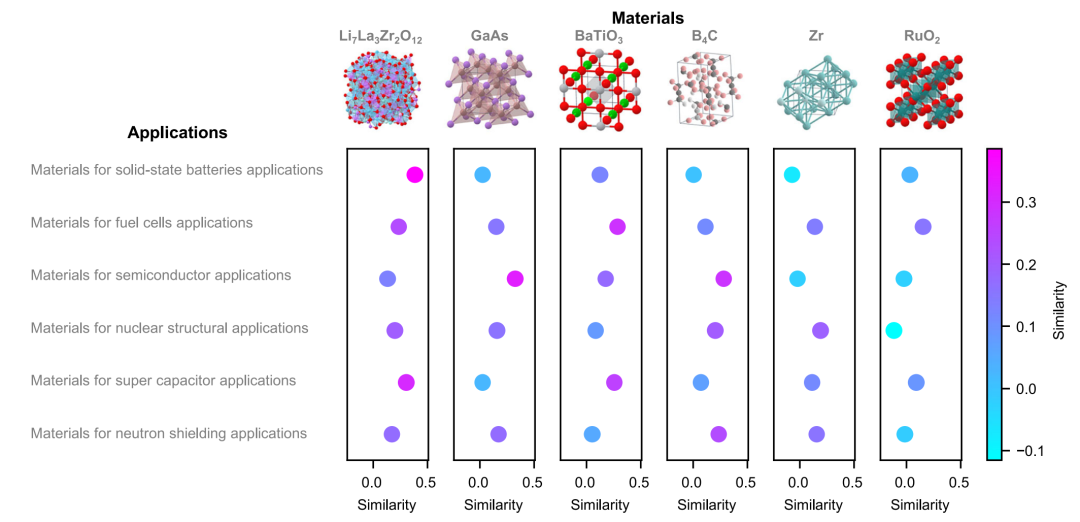
Les chercheurs ont également sélectionné six matériaux typiques, tels que Li₇La₃Zr₂O₁₂, GaAs et BaTiO₃, ainsi que six catégories de scénarios d'application, comme les batteries à état solide, les semi-conducteurs et les supercondensateurs, pour analyser la similarité entre les descriptions des matériaux et des applications. Les résultats montrent que le modèle peut identifier des associations typiques telles que Li₇La₃Zr₂O₁₂ avec les batteries à état solide, GaAs avec les semi-conducteurs et RuO₂ avec les supercondensateurs, ce qui indique que sa représentation contient certaines connaissances sur les fonctions des matériaux et leurs applications.
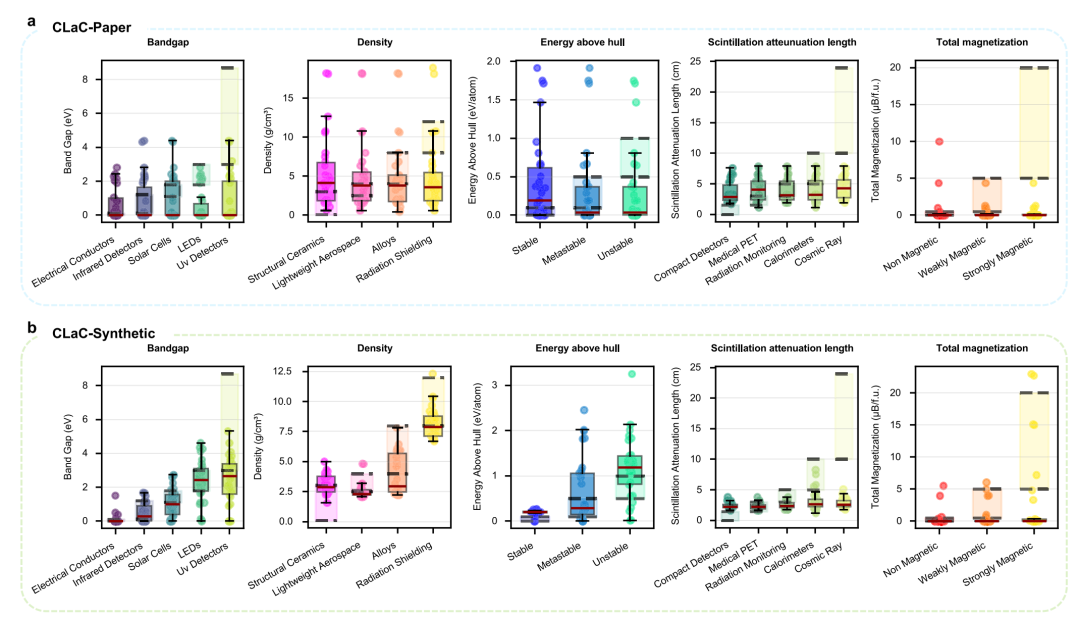
Dans l'expérience de conception inverse en zero-shot, les chercheurs ont inversé la direction de la prédiction traditionnelle des propriétés, en recherchant des matériaux candidats sur la base de descriptions en langage naturel des performances cibles. L'expérience porte sur cinq propriétés : le gap de bande, la densité, la différence d'énergie d'enveloppe convexe, la longueur d'atténuation de scintillation et l'aimantation totale. Pour chaque requête, le modèle récupère les 30 matériaux les plus similaires et mesure l'écart entre leurs propriétés réelles et les valeurs cibles via l'erreur absolue moyenne (MAE).
Les résultats montrent que CLaC-Synthetic surpasse la base aléatoire pour la récupération des cinq propriétés. L'erreur absolue moyenne pour la récupération du gap de bande est de 0,641 eV, inférieure aux 1,185 eV de la récupération aléatoire ; pour la densité, les erreurs sont respectivement de 0,799 g/cm³ et 2,148 g/cm³ ; pour la longueur d'atténuation de scintillation, elles sont respectivement de 1,033 cm et 2,697 cm. La performance globale de CLaC-Paper est proche d'une sélection aléatoire, ce qui suggère que les récits synthétiques générés sur la base de propriétés calculées favorisent davantage l'établissement de correspondances entre le langage et les propriétés des matériaux que les textes extraits directement de la littérature académique.
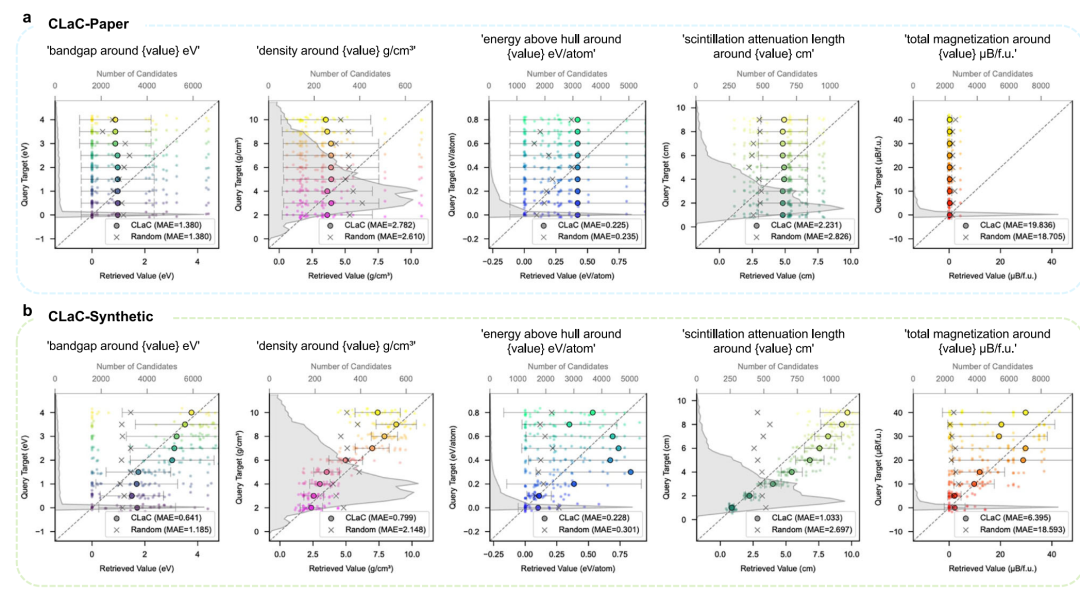
Outre les valeurs numériques précises, l'étude a également testé des descriptions qualitatives telles que « large bande interdite, faible densité, magnétisme fort ». Il a été constaté que la distribution des propriétés des matériaux récupérés par CLaC-Synthetic varie en fonction de la sémantique de la requête, par exemple, lorsque la bande interdite passe de faible à élevée, la bande interdite des matériaux candidats augmente également de manière correspondante ; en revanche, CLaC-Paper a du mal à établir une telle distinction, ce qui indique que les descriptions synthétiques aident le modèle à comprendre la relation entre les descriptions qualitatives et les propriétés physiques réelles.
Dans la validation applicative, les chercheurs ont pris le tri des électrolytes pour batteries à l'état solide comme exemple, en effectuant des recherches basées sur des matériaux contenant du lithium et des conditions de large bande interdite. Les 30 premiers candidats contiennent tous du lithium, avec une bande interdite moyenne de 3,23 eV. Parmi eux, le Li₆PClO₅, classé quatrième, a déjà été identifié comme candidat potentiel dans d'autres études, et le Li₄SiO₄, classé neuvième, a également été préparé sous forme de film d'électrolyte solide. Cependant, comme les données d'entraînement ne contiennent pas d'informations sur la conductivité ionique, les résultats actuels ne peuvent pas encore prouver que ces matériaux satisfont à toutes les exigences de performance des électrolytes solides.
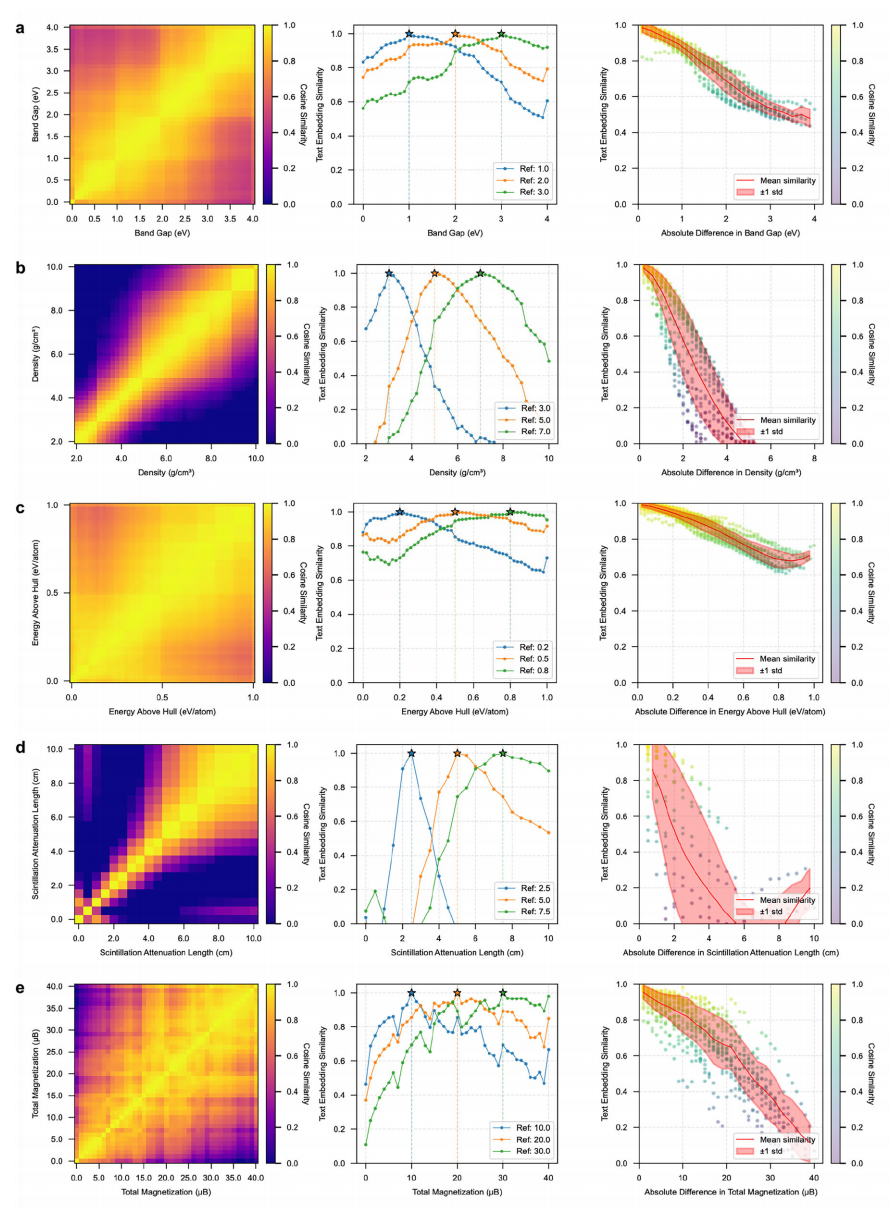
Pour analyser la manière dont le modèle comprend les informations numériques, l'étude a examiné plus avant la continuité des propriétés dans l'espace d'incorporation textuel. Les résultats montrent que la similarité vectorielle de CLaC-Synthetic diminue progressivement à mesure que la différence numérique des propriétés augmente. Par exemple, en prenant une bande interdite de 2,0 eV comme référence, lorsque la valeur de la requête augmente jusqu'à 4,0 eV, la similarité cosinus diminue de 1,0 à environ 0,65, ce qui indique que le modèle peut exprimer les relations de grandeur des quantités physiques. La similarité de la densité et de la longueur d'atténuation de scintillation diminue plus rapidement, correspondant à une précision de recherche plus élevée ; la variation de la différence d'énergie de l'enveloppe convexe est relativement douce, et l'erreur de recherche est plus grande. En comparaison, ni CLaC-Paper ni Galactica-125M, qui n'a pas subi d'alignement intermodal, ne présentent de relation numérique continue claire.
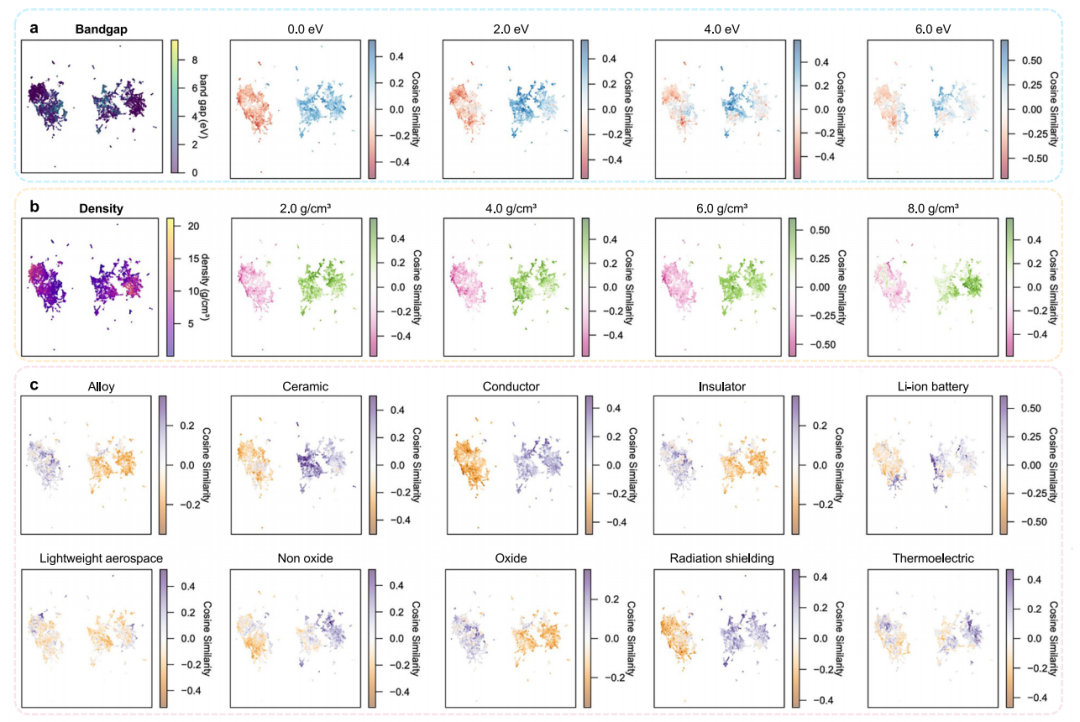
Enfin, les chercheurs ont utilisé UMAP pour visualiser l'espace latent des structures cristallines et des représentations textuelles. Bien que les deux modalités forment des clusters relativement indépendants, leurs relations de voisinage de matériaux sont très cohérentes : parmi les 50 voisins les plus proches dans l'espace des graphes cristallins, en moyenne 57 % apparaissent également parmi les 50 voisins les plus proches correspondants dans l'espace textuel, bien au-delà des 0,4 % dans le cas aléatoire. De plus, les propriétés physiques telles que la bande interdite et la densité présentent des distributions régulières, et des descriptions telles que « céramique », « conducteur » et « batterie lithium-ion » correspondent à différentes régions cristallines, ce qui confirme davantage la capacité du modèle à effectuer une représentation intermodale des propriétés des matériaux et des catégories fonctionnelles.
En conclusion
L'étude CLaC montre que la clé de l'apprentissage multimodal des matériaux cristallins ne réside pas seulement dans l'échelle des données, mais aussi dans la capacité à établir une correspondance précise entre les propriétés des matériaux et le langage naturel. En générant des descriptions synthétiques basées sur les propriétés calculées, CLaC a obtenu de meilleures performances que les modèles entraînés sur des textes de littérature dans la compréhension zéro-shot des matériaux et la récupération guidée par le langage. Cependant, le modèle présente encore des lacunes dans des tâches de structure fine telles que la reconnaissance des systèmes cristallins, et il est actuellement difficile de traiter des systèmes complexes tels que les polycristaux, les structures défectueuses et les réseaux métallo-organiques, sans parler de la génération directe de nouvelles structures cristallines. À l'avenir, améliorer la précision des données synthétiques, étendre la portée du modèle aux matériaux complexes et combiner la récupération linguistique avec la génération de cristaux et la validation physique restent des problèmes à résoudre pour que ces modèles parviennent à la conception pratique des matériaux.