Command Palette
Search for a command to run...
Von drug-like Molekülen Zu Zielspezifischen Verbindungen: Die University of Pittsburgh in Den USA Nutzt Molekülfingerabdruck-Abfragen, Um Die Zielgerichtete Wirkstoffentwicklung Zu Beschleunigen
Traditionelle Wirkstoffentdeckung ist eine äußerst anspruchsvolle Aufgabe, deren Kernziel darin besteht, in einem riesigen chemischen Raum Moleküle zu identifizieren, die bestimmte ideale Eigenschaften aufweisen und auf bestimmte Targets wirken können. Von der ersten Forschungsidee bis zur endgültigen Zulassung kostet die Entwicklung eines neuen Arzneimittels mehr als 2,6 Milliarden US-Dollar und dauert mehr als 12 Jahre. Eine der grundlegenden Herausforderungen besteht darin, in einem riesigen chemischen Raum mit 10²³–10⁶⁰ Molekülen effizient zu suchen, um Verbindungen zu finden, die gleichzeitig die gewünschte biologische Aktivität, physikochemische Eigenschaften und Synthesierbarkeit aufweisen.
In den letzten Jahren hat generative künstliche Intelligenz neue Möglichkeiten für das Moleküldesign eröffnet. Durch das Erlernen von Strukturen und Eigenschaften vorhandener Moleküle können generative Modelle den potenziellen chemischen Raum erkunden und Kandidatenmoleküle mit bestimmten physikochemischen oder biologischen Aktivitätsmerkmalen vorschlagen. Doch wie die von Modellen generierten Moleküle in chemisch valide, praktisch verfügbare und tatsächlich biologisch aktive Verbindungen überführt werden können, bleibt eine wichtige Herausforderung in diesem Bereich.
Vor diesem Hintergrund hat ein Forschungsteam der University of Pittsburgh in Pennsylvania, USA, eine Pipeline zur Full-Spectrum Generative Lead Discovery (FSGLD) vorgestellt, eine effiziente, tiefenlernbasierte Methode zur Identifizierung von Wirkstoff-Leadverbindungen. Das Kernstück von FSGLD ist ein multiskaliges DRUG-GAN-Modell, das in drei verschiedenen Szenarien die Entdeckung von Wirkstoffmolekülen durch generative Modelle steuern kann, darunter:
(1)Erzeugung zufälliger drug-like-Verbindungen;
(2)Erzeugung von target-spezifischen Verbindungen;
(3)Erzeugung von target-spezifischen Serienverbindungen mit gemeinsamer chemischer Struktur.
In der Bewertung an drei Targets mit unterschiedlichen pharmakologischen Eigenschaften zeigte FSGLD ein gutes Anwendungspotenzial bei der Identifizierung target-spezifischer Kandidatenverbindungen. Darüber hinaus etablierte das Team einen Berechnungsworkflow für thermodynamische Integration (TI), der die Berechnungszeit bei gleichbleibender Genauigkeit um 80–90 % verkürzte.
Die Ergebnisse wurden unter dem Titel „A Full-Spectrum Generative Lead Discovery (FSGLD) pipeline via DRUG-GAN: A multiscale method for drug-like/target-specific compound library generation“ in Science Advances veröffentlicht.
Forschungshöhepunkte:
-
Die FSGLD-Pipeline kann nicht nur mit generativen Modellen drug-like- und target-spezifische Verbindungen entwerfen, sondern auch Kandidatenverbindungen systematisch und effizient screenen und validieren
-
Die Forschenden haben einen praktikablen und skalierbaren Rahmen geschaffen, der den für die präklinische Wirkstoffentdeckung erforderlichen Zeit- und Kostenaufwand senken kann
-
Die über diese Pipeline generierten Verbindungen sind keine rein theoretischen Kandidatenmoleküle, sondern für eine experimentelle Validierung geeignet und können akademischen Forschenden sowie Fachleuten in der Pharmabranche einen konkreten Mehrwert bieten
Link zum Paper:
https://www.science.org/doi/full/10.1126/sciadv.aei5257
Datensätze: Unterschiedliche Datensätze für drei Anwendungsszenarien
FSGLD wurde für drei verschiedene Szenarien der Lead-Entdeckung konzipiert, daher wurden unterschiedliche Datensätze und Trainingsstrategien eingesetzt.
Für Szenario I sammelten die Forschenden anhand der Lipinski-Regel der Fünf und unter Berücksichtigung der Diversität 7.002 Wirkstoffe aus der DrugBank-Datenbank(https://go.drugbank.com/), um einen Datensatz drug-like-Verbindungen zu erstellen.
Für das Dekoy-Molekülset berechneten die Forschenden mit Open Babel das Molekulargewicht (MW) und den lipophilischen Verteilungskoeffizienten (logP) von 19.212.639 Molekülen aus dem drug-like Subset der ZINC-Datenbank. Anschließend filterten sie mit einem intern entwickelten Programm 284.552 ZINC-Verbindungen heraus, deren MW- und logP-Werte den DrugBank-Verbindungen am nächsten kamen. Danach wurden diese Verbindungen mit der Software SYBYL-X 2.1.1 auf Basis von Molekülfingerabdrücken (FP) geclustert, um deren strukturelle Diversität zu maximieren. Schließlich wählten die Forschenden 9.998 Moleküle aus, um das Dekoy-Molekülset zu erstellen.
Um den Diskriminator von dcGAN zu trainieren und zu validieren, teilten die Forschenden alle ausgewählten drug-like-Moleküle (7.002) und Dekoy-Moleküle (9.998) mittels 10-fach Kreuzvalidierung ([75]) in Trainings- und Testdatensätze auf.
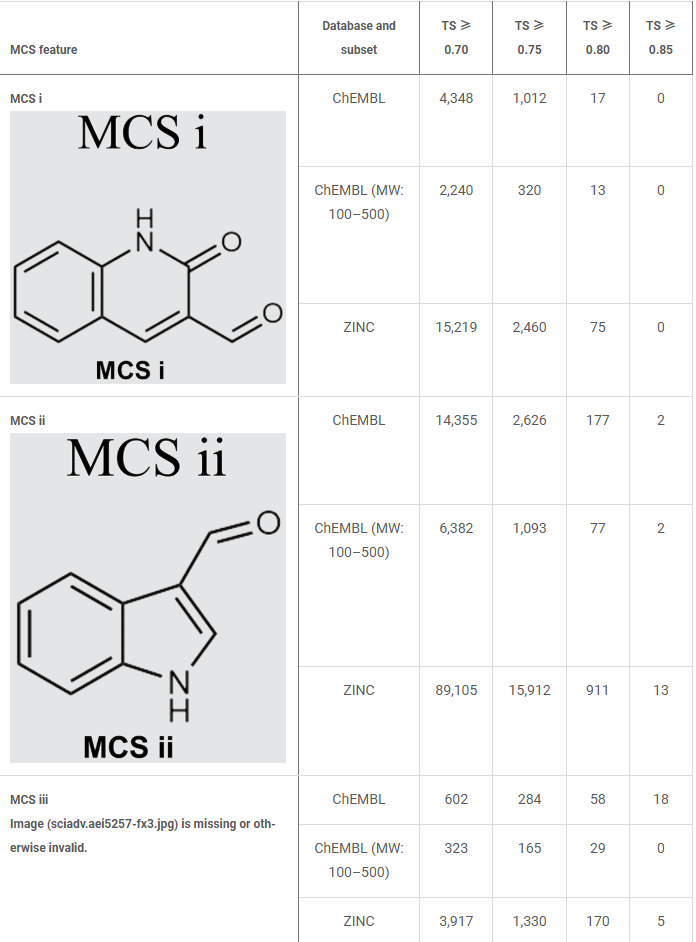
Für die Generierung target-spezifischer Verbindungen in Szenario II und III sammelten die Forschenden 1.896 CB2-aktive Verbindungen (Ki/IC50 < 100 nM) und 2.996 CB2-inaktive Verbindungen (Ki/IC50 ≥ 100 nM) aus der ChEMBL-Datenbank, um das cdcGAN-Modell zu trainieren. Darüber hinaus prüften die Forschenden die chemischen Strukturen der gesammelten CB2-aktiven Verbindungen manuell und identifizierten die drei häufigsten maximalen gemeinsamen Substrukturen (MCS), wie in der folgenden Tabelle dargestellt:
Während des Modelltrainings wurden alle Moleküle mit Open B
FSGLD 框架:以 DRUG-GAN 为核心
FSGLD 的核心是 DRUG-GAN,其关键思路并非直接生成完整分子结构,而是学习分子指纹的分布,生成具有特定特征的指纹,再将其作为查询条件,从大型化学数据库中检索结构相似的真实化合物,其流程概览如下所示:
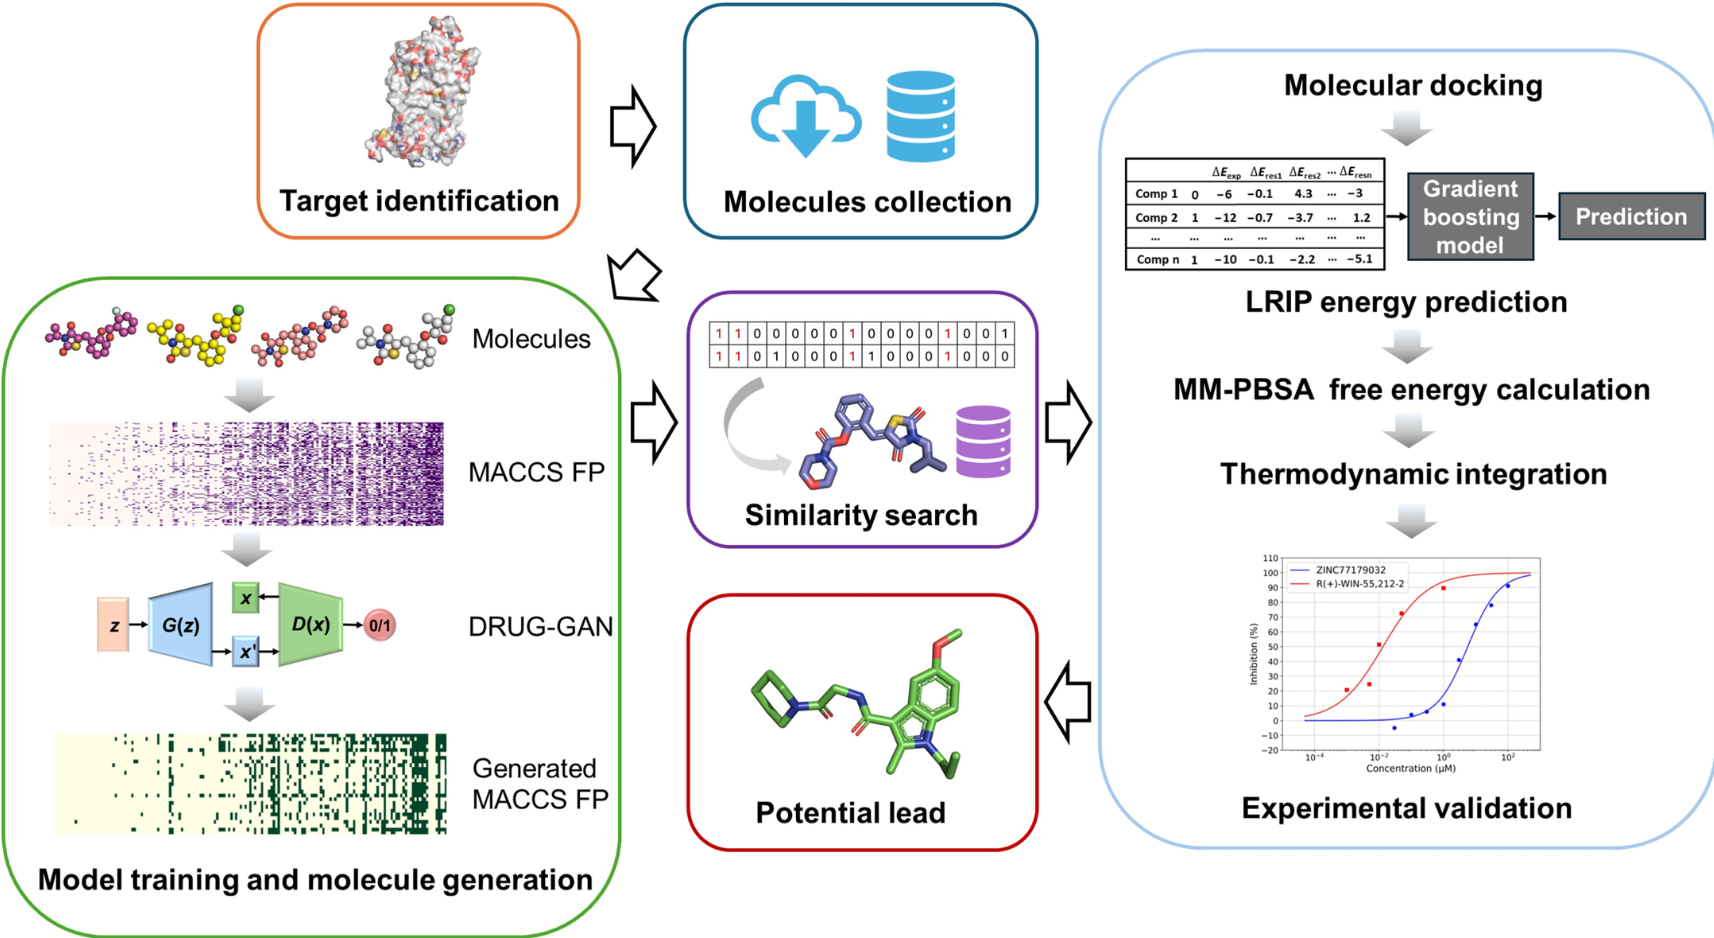
这一设计与传统基于 SMILES 字符串或分子图的生成模型有所不同。MACCS 分子指纹能够以紧凑的形式描述分子的结构特征,适合从相对有限的数据集中学习。但由于分子指纹无法与单一分子建立唯一映射关系,也不能直接转换为化学有效的分子结构,因此,DRUG-GAN 生成的指纹需要进一步与 ChEMBL、ZINC 等数据库进行相似性匹配,才能获得实际的候选化合物。
从模型架构来看,研究人员采用深度卷积神经网络(DCNN)构建判别器,并索了四种主要的 DCNN 架构,分别为 LeNet-5、AlexNet、ZFNet 和 VGGNet。
根据不同的发现目标,DRUG-GAN 被设计为三种应用场景。
场景 I 采用标准 dcGAN,以 DrugBank 中的类药性分子指纹作为真实样本,学习类药性分子的特征分布。 生成器从随机噪声出发,生成新的分子指纹,再通过相似性检索从 ZINC 数据库中寻找对应化合物。这一场景主要用于探索具有类药性特征的化学空间。
场景 II 进一步引入靶点特异性信息,采用条件生成对抗网络 cdcGAN。 模型以 CB2 活性和非活性配体作为两类训练数据,学习与 CB2 活性相关的分子指纹特征,进而生成具有 CB2 靶点偏向性的指纹。随后,研究人员以生成指纹为查询条件,从 ChEMBL 和 ZINC 数据库中检索候选化合物,实现从无偏的类药性分子探索向靶点导向型发现的拓展。
场景 III 则进一步提高了分子设计的可控性。 研究人员在生成器中引入掩码层(Mask Layer),具体通过 Lambda 层固定预定义 MCS 对应的分子指纹特征位,使生成的指纹保留指定结构特征,同时允许其他特征位发生变化。通过这一方式,模型能够生成兼具 CB2 靶点偏向性和特定骨架特征的化合物系列,为命中化合物扩展及后续先导化合物优化提供支持。
在候选化合物生成之后,FSGLD 还建立了分层计算筛选流程。 首先通过分子对接评估候选分子与目标受体的结合情况,再利用靶点特异性LRIP评分函数进行筛选,随后开展分子动力学(MD)模拟、MM-PBSA结合自由能计算和热力学积分(TI)计算。只有通过当前阶段筛选的化合物,才能进入下一环节。最终,研究人员对优先级较高的候选分子开展实验验证,形成从生成、检索、计算筛选到实验评估的完整流程。
成果:在三类药理学特征各异的靶点评估中均表现良好
实验人员通过三种场景评估模型的表现:
场景 I:生成类药性化合物
研究人员从唯一性(Uniqueness)、新颖性(Novelty)、多样性(Diversity)、相似性(Similarity)和有效性(Validity)五个维度,对 DRUG-GAN 与三种已发表的生成式模型——ORGAN、OR(W)GAN 和 ORGANIC——进行了全面比较。
如下表,在 MACCS FP 空间中,DRUG-GAN 在多项关键指标上均优于作为基准的其他生成式模型。尤其是,DRUG-GAN 的唯一性和新颖性得分均达到1.00,取得了满分表现。这意味着所有生成的分子指纹彼此不同,且均未出现在训练数据中。其多样性得分为0.73,与 ORGAN(0.77)和 ORGANIC(0.76)的表现接近,同时高于 OR(W)GAN(0.63)。此外,DRUG-GAN 生成的分子指纹与 7002 个参考药物之间的平均相似性最低,仅为 0.25。这表明,该模型能够在保留类药性特征的同时,生成具有明显结构差异的分子指纹。
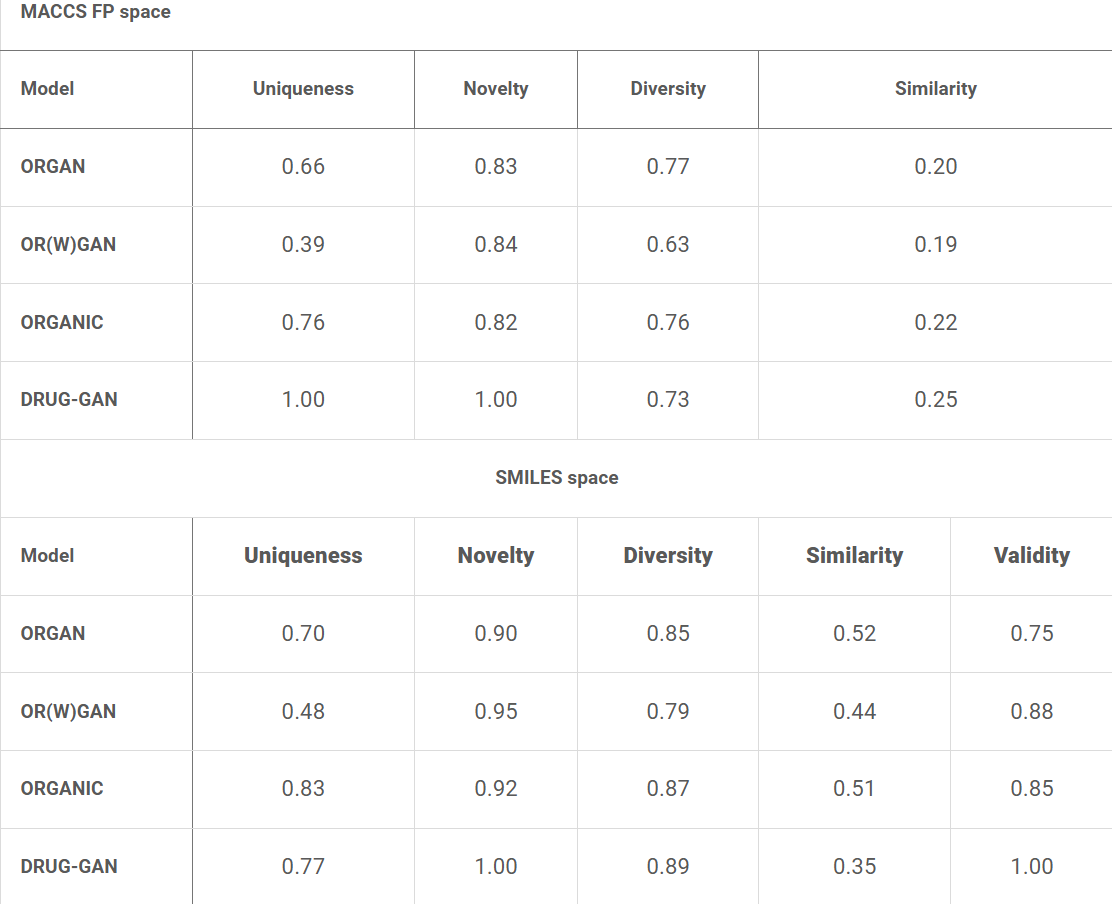
Mit den Bewertungsergebnissen im FP-Raum übereinstimmend zeigt DRUG-GAN auch im SMILES-Raum eine hervorragende Leistung. Der Neuheitsgrad von DRUG-GAN bleibt bei 1.00, was zeigt, dass alle dekodierten Moleküle nicht im Trainingsdatensatz vorkommen. Wie erwartet sinkt der Einzigartigkeitswert aufgrund der Möglichkeit, dass mehrere unterschiedliche Molekülfingerabdrücke in dieselbe Molekülstruktur dekodiert werden können, von 1.00 im FP-Raum auf 0.77 im SMILES-Raum. Dennoch bleibt die Einzigartigkeit von DRUG-GAN höher als bei ORGAN und OR(W)GAN und liegt nur knapp unter ORGANIC. Gleichzeitig bewahrt DRUG-GAN eine hohe Diversität mit einem Wert von 0.89, während die Ähnlichkeit zwischen den generierten Molekülen und Referenzarzneimitteln mit 0.35 relativ niedrig ist. Dies steht im Einklang mit dem Designziel des Modells, den chemischen Raum zu erweitern, ohne chemische Plausibilität zu opfern.
Um diese Ergebnisse weiter zu bewerten, analysierten die Forscher außerdem 2252 von der U.S. Food and Drug Administration (FDA) zugelassene Arzneimittel mit Molekulargewichten (MW) im Bereich von 100 bis 1000 Da. Die mittleren Molekulargewichte (MW), LogP-Werte (Logarithmus des Lipid/Wasser-Verteilungskoeffizienten) und topologischen polaren Oberflächen (TPSA) dieser zugelassenen Arzneimittel betragen 358.0 Da, 2.8 bzw. 89.3 Ų. Die von DRUG-GAN abgerufenen Moleküle weisen ähnliche drug-like Eigenschaften auf, mit einem mittleren Molekulargewicht von 382.9 Da, einem mittleren LogP von 2.0 und einer mittleren TPSA von 76.0 Ų. Diese Daten zeigen, dass die von DRUG-GAN abgerufenen Moleküle im Vergleich zu den FDA-zugelassenen Arzneimitteln insgesamt ein etwas höheres Molekulargewicht, aber eine relativ niedrigere Polarität aufweisen, was auf potenziell günstige physikalisch-chemische Eigenschaften hindeutet.
Szenario II: Zielprotein-spezifische Verbindungsgenerierung
Neben der Generierung von Kandidatenverbindungen mit drug-like Eigenschaften ist DRUG-GAN auch in der Lage, zielprotein-spezifische Verbindungen zu generieren. Um diese Fähigkeit zu demonstrieren, untersuchten die Forscher den Cannabinoid-Rezeptor 2 (CB2) als Beispiel.
Unter 186 ChEMBL-Verbindungen, deren Ähnlichkeit zu den generierten Molekülfingerabdrücken 85 % oder mehr betrug (TS ≥ 0.85), lagen 169 Verbindungen mit Molekulargewichten (MW) zwischen 100 und 500 Da; von diesen wurden 104 Verbindungen in Bioaktivitätsexperimenten als CB2-aktive Liganden mit Inhibitionskonstanten (Ki) kleiner als 10 μM berichtet. Die Anreicherung von Molekülen mit niedrigem Ki-Wert unter den abgerufenen Verbindungen zeigt, dass die von DRUG-GAN generierten Molekülfingerabdruck-Abfragen wirksam chemische Strukturtypen mit bekannter CB2-Aktivität aus zielproteinbezogenen Bioaktivitätsdatenbanken abrufen können. Darüber hinaus wurden 161 Verbindungen aus der ZINC-Datenbank abgerufen, deren TS-Werte gegenüber den von DRUG-GAN generierten Molekülfingerabdruck-Abfragen jeweils 0.85 oder höher betrugen.
Anschließend dockten die Forscher die abgerufenen Verbindungen an die CB1- und CB2-Rezeptoren an, um ihre Bindungsaffinität vorherzusagen; die Ergebnisse sind in der folgenden Abbildung dargestellt:
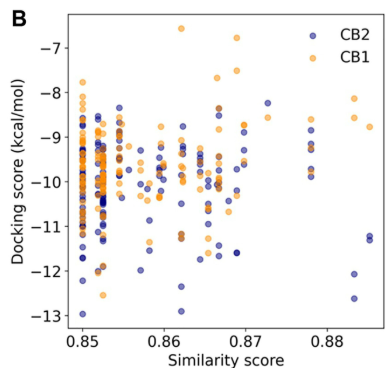
Im Allgemeinen zeigten die Verbindungen, die über von DRUG-GAN generierte Molekül-Fingerprint-Abfragen abgerufen wurden, eine gute vorhergesagte Bindungsfähigkeit an CB2; ihr durchschnittlicher molekularer Docking-Score gegenüber dem CB2-Rezeptor betrug −10,10 kcal/mol und war damit besser als der Durchschnittswert von −8,29 kcal/mol der Decoy-Moleküle, die für das Training des Discriminators in Szenario I verwendet wurden. Nach paarweisen Vergleichen der Docking-Scores für jede abgerufene Verbindung stellten die Forscher außerdem fest, dass diese Verbindungen insgesamt eine Bindungspräferenz für CB2 aufwiesen, wobei ein erheblicher Teil der Verbindungen eine bessere vorhergesagte Bindungsfähigkeit an CB2 als an CB1 zeigte.
Szenario III: Generierung von zielspezifischen Serienverbindungen
In Szenario III führten die Forscher drei vordefinierte MCS in den Generator ein, um über Maskierungsschichten CB2-Kandidatenverbindungen mit spezifischen Gerüstbeschränkungen zu generieren.
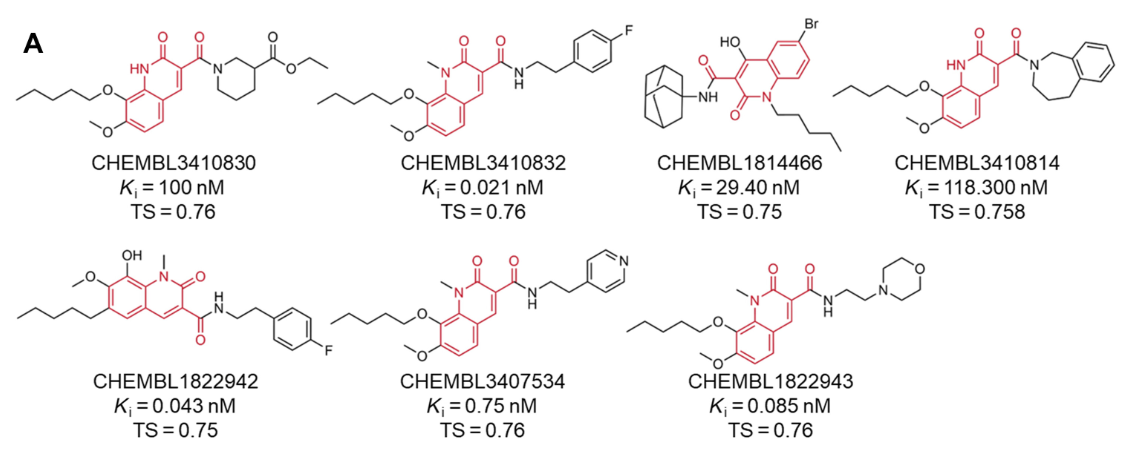
MCS i: Chinolindion-Kernstruktur
Für MCS i haben die Forscher 49 Verbindungen aus der ChEMBL-Datenbank abgerufen und bestätigt, die die vordefinierte Substruktur enthalten und einen TS-Wert ≥ 0,75 gegenüber den generierten Molekül-Fingerprint-Abfragen aufweisen. Wie in der folgenden Abbildung dargestellt, wurde für 7 Verbindungen eine hohe CB2-Aktivität (Ki kleiner als 10 μM) berichtet.
In der ZINC-Datenbank suchten und identifizierten die Forscher 32 Verbindungen, die die MCS-i-Substruktur enthalten und TS ≥ 0,75 aufweisen; einige repräsentative Kandidatenverbindungen und ihre entsprechenden TS-Werte sind in der folgenden Abbildung dargestellt:
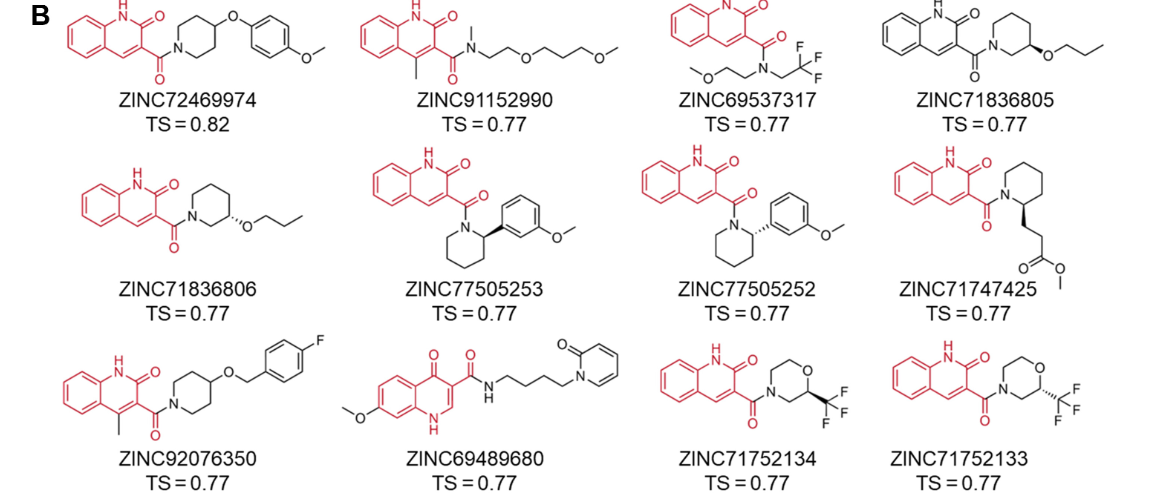
Die meisten dieser Kandidatenverbindungen erzielen bessere vorhergesagte Andock-Scores für CB2 als für CB1, was darauf hindeutet, dass sie bei einer Priorisierung von Kandidatenverbindungen auf Basis des molekularen Dockings möglicherweise eine Bindungspräferenz für CB2 aufweisen.
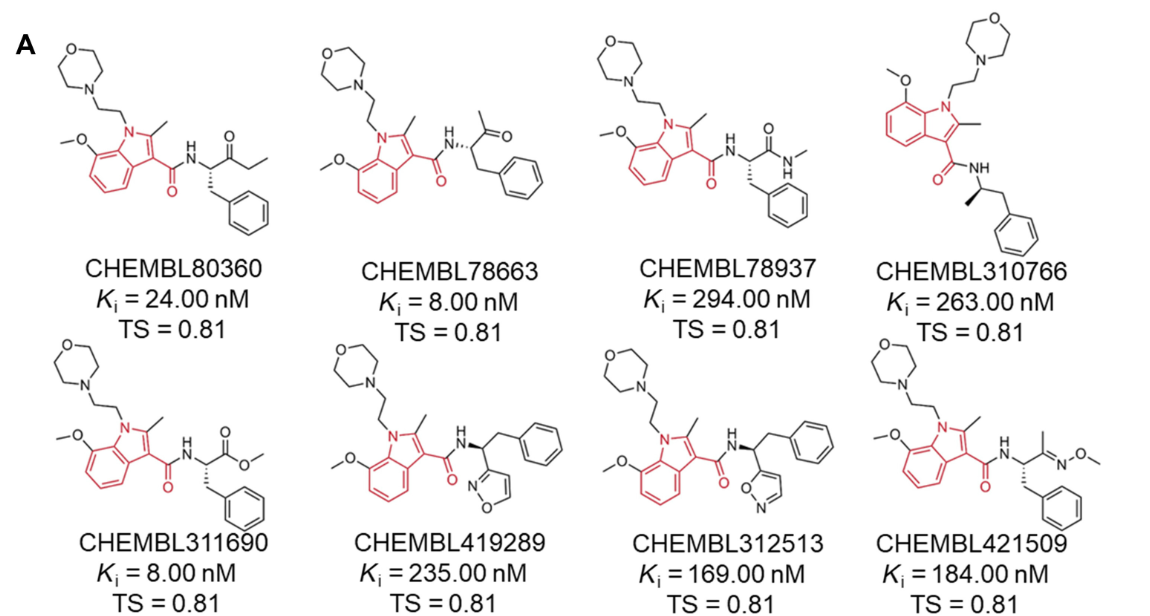
MCS ii: Indolcarboxamid-Kernstruktur
Für MCS ii haben die Forscher aus der ChEMBL-Datenbank 24 Verbindungen abgerufen und bestätigt, die die vordefinierte Substruktur enthielten und eine TS ≥ 0,80 im Vergleich zur generierten Molekülfingerabdruck-Abfrage aufwiesen. Von diesen zeigten 8 Verbindungen eine starke CB2-Bindeaffinität (wie unten gezeigt), was weiter belegt, dass die gerüstbeschränkte DRUG-GAN-Strategie CB2-bezogene chemische Strukturtypen wirksam abrufen kann.
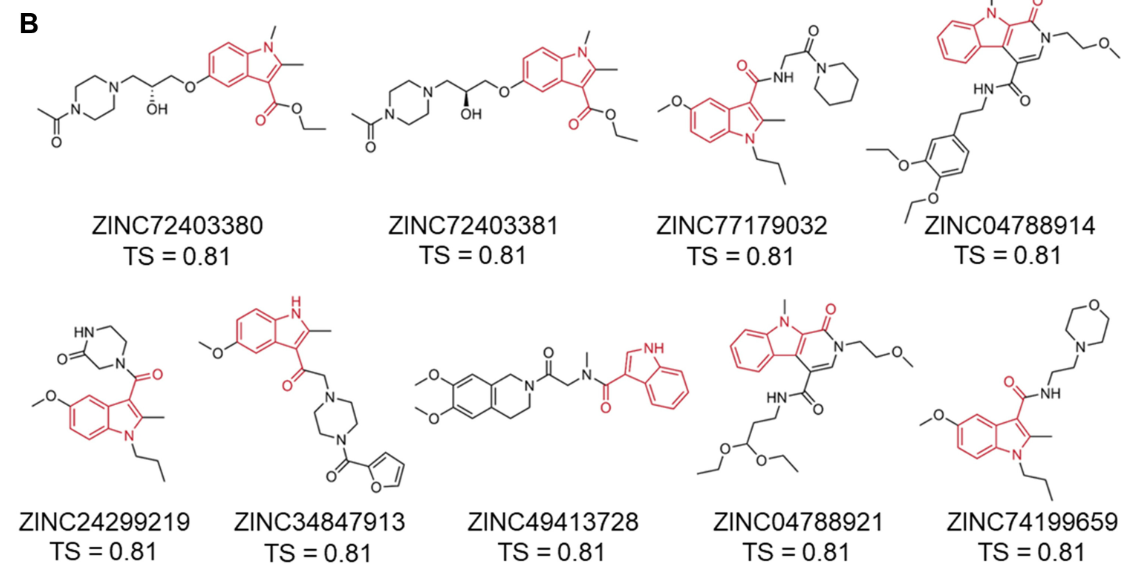
In der ZINC-Datenbank fanden die Forscher 9 Verbindungen, die die MCS-ii-Substruktur enthielten und TS ≥ 0,80 aufwiesen (wie unten gezeigt). Ähnlich wie bei den Kandidatenverbindungen für MCS i waren die vorhergesagten molekularen Docking-Scores dieser Verbindungen für CB2 in der Regel besser als die Docking-Scores für CB1, was darauf hindeutet, dass sie das Potenzial für ein weiteres CB2-gerichtetes Screening besitzen.
MCS iii: Indolsulfonamid-Gerüst
Für MCS iii haben die Forscher zunächst 165 Verbindungen aus der ChEMBL-Datenbank unter der Bedingung TS ≥ 0,75 abgerufen. Durch die FP2-Molekülfingerabdruckanalyse wurden jedoch letztlich nur 2 Verbindungen als vollständig mit der MCS-iii-Substruktur übereinstimmend bestätigt (wie unten gezeigt).
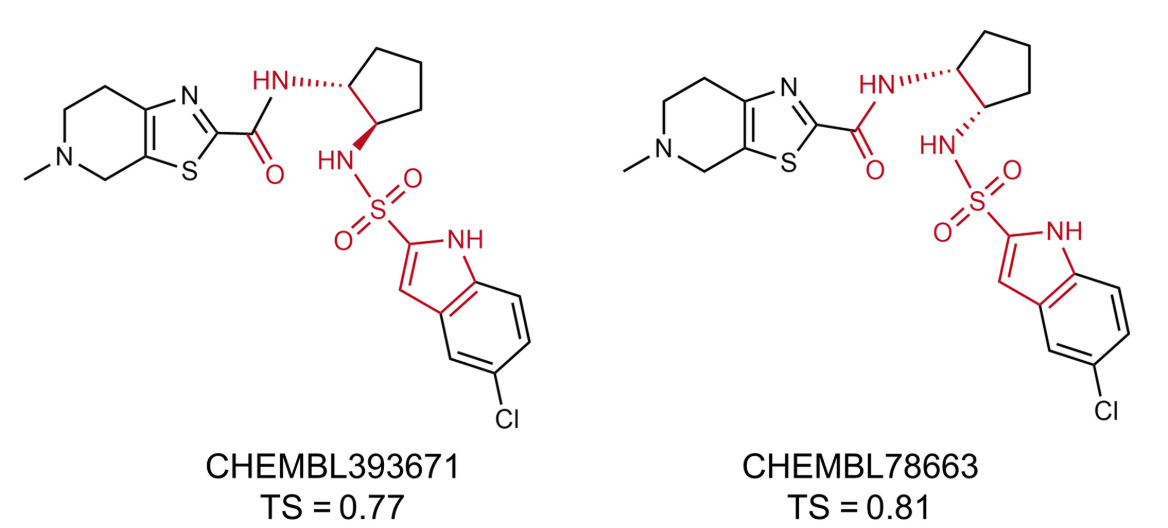
Darüber hinaus bestanden in der ZINC-Datenbank alle abgerufenen Verbindungen mit TS ≥ 0,75 die Validierung nicht, d. h. keine Verbindung wurde als vollständig mit der MCS-iii-Substruktur übereinstimmend bestätigt.
Die Gesamtergebnisse zeigen, dass die gerüstbeschränkte DRUG-GAN-Strategie CB2-bezogene chemische Strukturmerkmale beibehält und gleichzeitig den chemischen Raum der Trainingsliganden erweitert, sodass neue Kandidatenverbindungen mit strukturellen Unterschieden entdeckt werden können.
Fazit
Um potenzielle Kandidatenverbindungen priorisiert zu identifizieren, nutzt FSGLD einen hierarchischen Workflow zur Bewertung der abgerufenen Verbindungen, einschließlich molekularem Docking, zielspezifischen LRIP-Scores, Molekulardynamik-(MD)-Simulationen, MM-PBSA-Berechnungen der Bindungsfreien Energie und thermodynamischen Integrationsberechnungen; außerdem werden experimentelle Validierungen für einige Kandidatenverbindungen durchgeführt. Durch die Integration dieser komplementären Methoden in einen einheitlichen Workflow stellt FSGLD einen pragmatischen Forschungsrahmen bereit, um Kandidaten-Leitverbindungen priorisiert auszuwählen und eine Grundlage für nachfolgende experimentelle Bewertungen zu schaffen.
Mit der kontinuierlichen Weiterentwicklung von Methoden zur Proteinstrukturvorhersage und Ko-Faltung erwarten die Forscher, dass sich die Genauigkeit, Robustheit und Anwendbarkeit des FSGLD-Rahmens entsprechend verbessern werden. Künftige Studien werden DRUG-GAN und FSGLD in einem breiteren Spektrum von Zielfamilien bewerten, darunter Ionenkanäle und nukleäre Rezeptoren, und fortgeschrittene Strategien für Few-Shot-Learning und Small-Dataset-Learning einführen, um die Leistung der Modelle in datenarmen Szenarien weiter zu verbessern.
Literatur: