Command Palette
Search for a command to run...
从检索到生成:融合外部知识与参数化知识用于医学问答
从检索到生成:融合外部知识与参数化知识用于医学问答
Lei Li Yingying Zhang Xiao Zhou Xian Wu
摘要
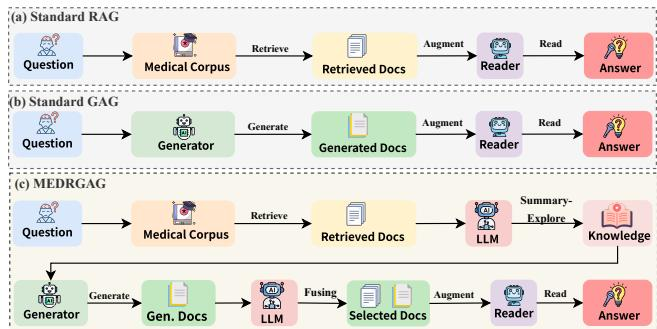
医学问答(QA)需要对领域特定知识的广泛获取。一个有前景的方向是通过从医学语料库中检索到的外部知识或存储在模型参数中的参数化知识来增强大语言模型(LLMs)。现有方法通常分为两类:检索增强生成(RAG),将模型推理建立在外部检索的证据之上;以及生成增强生成(GAG),仅依赖模型的内部知识生成上下文文档。然而,RAG 常常受到噪声或不完整检索的困扰,而 GAG 由于无约束的生成,容易受到幻觉或不准确信息的影响。这两种问题都会误导推理并损害答案的可靠性。为应对这些挑战,我们提出了 MedRGAG,一种统一的检索–生成增强框架,将外部知识与参数化知识无缝融合用于医学问答。MedRGAG 包含两个关键模块:知识引导的上下文补全(KGCC),指导生成器生成背景文档以补充检索所揭示的缺失知识;以及知识感知的文档选择(KADS),自适应地选择检索文档与生成文档的最优组合,形成简洁而全面的证据以支持答案生成。在五个医学问答基准上的大量实验表明,MedRGAG 相较于 MedRAG 实现了 12.5% 的提升,相较于 MedGENIE 获得了 4.5% 的增益,凸显了融合检索与生成在知识密集型推理中的有效性。我们的代码和数据已公开发布于 https://anonymous.4open.science/r/MedRGAG 。
一句话总结
中国人民大学与腾讯 Jarvis Lab 提出 MedRGAG,这是一种面向医学问答的统一检索生成增强框架,它集成知识引导上下文补全和知识感知文档选择,用参数化生成补充噪声检索,在五个医学问答基准上较 MedRAG 提升 12.5%。
核心贡献
-
MedRGAG 是面向医学问答的统一检索生成增强框架,它将外部检索证据与大语言模型生成的参数化知识相结合,以降低对噪声检索和幻觉生成的依赖。
-
知识引导上下文补全利用检索揭示的知识缺口,引导生成互补背景文档;知识感知文档选择自适应地选取检索文档和生成文档,以形成用于答案生成的简明证据。
-
在五个医学问答基准和多种阅读器架构上的实验表明,相对于强基线有一致提升,包括较 MedRAG 提升 12.5%,较 MedGENIE 提升 4.5%,并且代码和数据均已公开。
引言
大语言模型可以提升医学问答效果,但其参数化知识有限,可能生成看似合理但事实错误的答案,这在临床场景中风险尤为突出。既有方法通常依赖检索增强生成,其检索文档可能存在噪声或不完整;或依赖生成增强生成,其合成上下文可能引入幻觉;而现有混合方法尚未完全解决这些互补局限。作者提出 MedRGAG,一种统一检索与生成框架,将外部医学证据与模型生成的背景知识结合,使用知识引导上下文补全填补缺失信息,并执行知识感知文档选择,为答案生成构建更可靠证据。
数据集
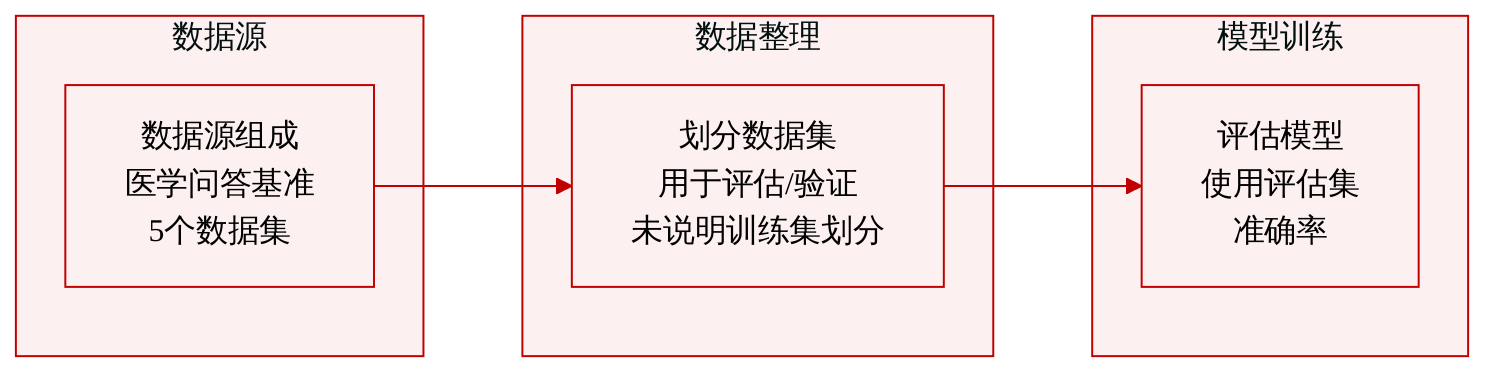
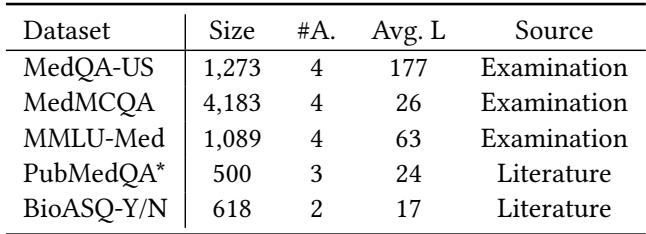
- 作者使用五个广泛使用的医学问答基准:MedQA、MedMCQA、MMLU-Med、PubMedQA* 和 BioASQ-Y/N。
- 所有基准均被转换为多选题问答任务,每个问题包含两个到四个候选答案。
- 论文在 Table 2 中总结了数据集统计信息,并在 Appendix B 中提供更多细节,但所提供文本未指定确切的子集大小、来源划分或过滤规则。
- 数据用于评估,在标准评估实践中,准确率被报告为主要性能指标。
- 所提供摘录中未描述训练划分、混合比例、裁剪策略或元数据构建。
方法
MedRGAG 被表述为面向医学多选题问答的多证据阅读器。给定问题 q 和答案集合 A={a1,…,a∣A∣},基础阅读器模型 Mr 基于内部参数和任务特定提示生成答案:
a^=Mr(q,Pr∣θr).由于这种表述仅依赖参数化知识,该方法结合检索增强生成与生成增强生成。在检索增强生成中,语料库 C={d1,…,d∣C∣} 和检索器 R 提供外部证据:
Dr={d1r,…,dkr}=R(q,C∣θR),阅读器随后预测答案为:
a^=Mr(q,Dr,Pr∣θr).在生成增强生成中,生成器 Mg 产生定制背景文档:
Dg={d1g,…,dkg}=Mg(q,Pg∣θg),阅读器随后预测答案为:
a^=Mr(q,Dg,Pr∣θr).所提框架通过三个顺序阶段统一上述两个方向。参考框架图:
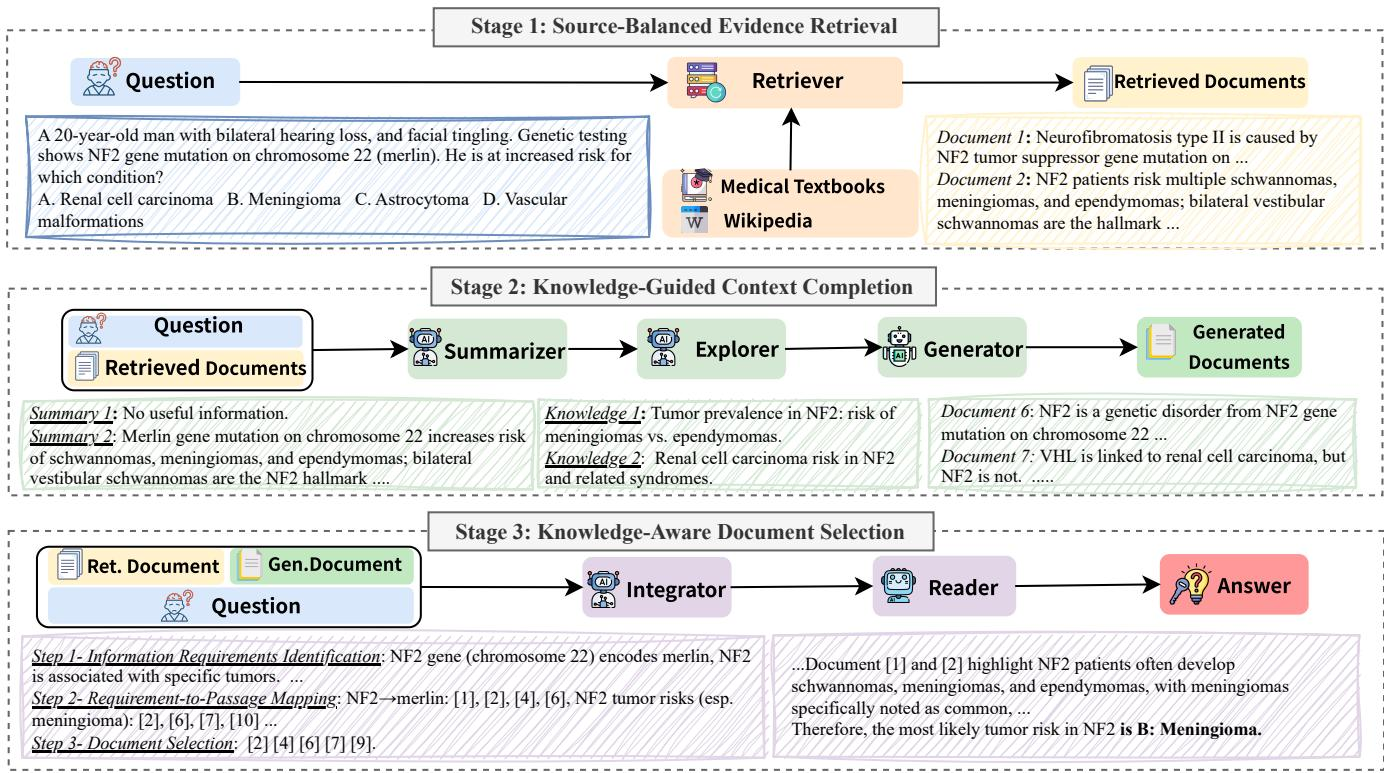
第一阶段是来源均衡证据检索。系统不将所有医学语料合并为一个大型来源并从统一池中检索,而是将多个异构来源视为独立语料 {C1,C2,…,Cs}。这可防止检索偏向规模较大或反复出现的信息源。对于给定问题 q,检索器从每个语料中独立选择固定数量的顶部文档,并将它们并入中间候选集合:
D~r=i=1⋃sR(q,Ci∣θR).这种均衡选择会产生更多样的候选池。随后系统应用重排序模型,即 MedCPT Reranker,它联合编码问题和每个候选文档,分配细粒度相关性分数。排名最高的文档被保留为检索证据集合 Dr。
第二阶段是知识引导上下文补全。其目的是修复检索证据中的缺口和噪声。检索文档可能只覆盖医学问题的部分方面,其中一些还可能不相关或具有误导性。该模块通过三个推理步骤处理检索证据。首先,摘要器针对问题从每个检索文档中提取有用知识。如果文档不包含有用信息,模型会输出一个控制信号,表示未发现有用信息。该步骤在保留简洁且问题相关摘要的同时过滤噪声。
其次,探索器模型 Me 评估摘要证据,并识别回答该问题仍缺失的重要知识:
K={k1,…,km}=Me(q,Ds,Pe∣θe),其中 Ds 表示摘要证据,K 是缺失知识点集合。被标记为无有用信息的文档会在探索前排除,以避免浪费推理能力。
第三,生成器 Mg 以每个缺失知识点为条件生成背景文档:
dig=Mg(q,ki,Pg∣θg).这会产生一组互补文档。如果缺失知识点数量 m 小于目标生成文档数量 k,系统会直接从问题生成更多背景文档。这提供了更广泛上下文,并减少对狭窄知识片段的过拟合。该阶段输出为生成证据集合 Dg。
第三阶段是知识感知文档选择。检索文档和生成文档都合并到候选池 Dr∪Dg。简单拼接所有候选会增大输入长度,并可能用冗余或噪声内容稀释有用信息。因此,集成器模型 Mi 执行知识感知选择。集成器首先识别问题所必需的关键知识组件。然后将每个候选文档映射到一个或多个组件,并将不相关文档归入非有用组。最后选择一组紧凑文档,使其共同覆盖所需知识组件,同时尽量减少冗余。形式上,最终证据集合为:
Df=Mi(q,Dr∪Dg,Pi∣θi).阅读器模型随后接收问题以及选定证据,并生成最终答案:
a^=Mr(q,Df,Pr∣θr).实验
实验在多个医学多选题问答基准上评估 MedRGAG,并将其与直接回答、检索增强、生成增强基线进行比较。主要结果、消融实验和性能分析表明,将检索证据与生成的医学知识结合,比单独依赖任一来源更有效;知识引导上下文补全和自适应文档选择对于组装有用推理上下文很重要。额外分析和案例研究进一步表明,更强的生成器和辅助语言模型可提升上下文质量,而自适应选择会平衡检索证据与生成证据,从而支持更准确的医学推理。
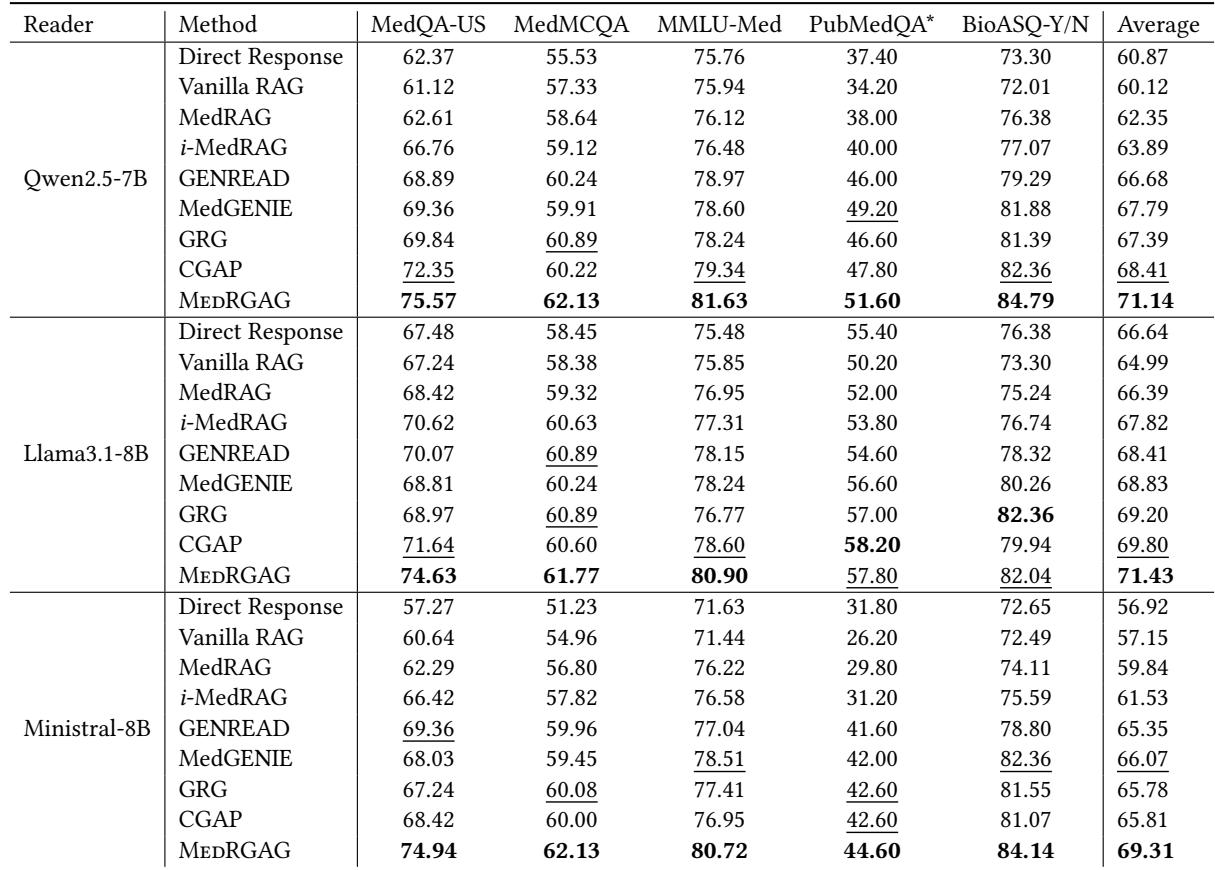
在所评估的医学问答设置中,MedR-GAG 取得最高平均准确率,并持续优于直接回答、检索增强和生成增强基线。与标准检索增强方法相比,它明显提升性能,说明生成知识有助于覆盖缺失信息。其自适应文档选择还能平衡检索证据与生成证据,在更少文档下保持准确率。自适应文档选择在减少文档数量的同时保持较强准确率,并保留有用检索证据。检索文档与生成文档具有互补性,生成段落提供缺失解释,检索段落支持事实细节。
所评估的医学问答套件结合了基于考试和基于文献的基准,均以多选题任务表示。考试类数据集通常有更多选项和更长题干,文献类数据集规模较小且使用更短提示和更少选项。准确率是用于评估答案正确性的主要指标。基准组合覆盖考试式问题和文献式问题。考试类数据集具有更长题干,通常为四个候选答案。文献类数据集使用更短提示和更少答案选项,包括二元问题。
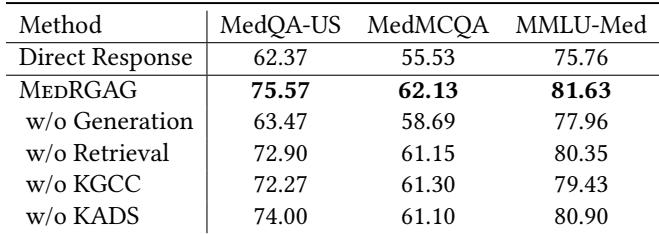
消融结果显示,与直接回答和每个简化变体相比,完整系统在三个医学问答数据集上均取得最高分数。移除生成模块造成最大下降,说明生成文档提供了特别有用的问题特定知识;移除检索也会降低准确率,表明外部证据仍然重要。禁用知识引导补全或自适应文档选择会进一步降低性能,证实这些模块有助于构建和选择信息丰富的上下文。完整系统在 MedQA-US、MedMCQA 和 MMLU-Med 上优于直接回答和所有消融变体。在测试的消融中,移除生成造成最大相对准确率下降。移除检索也降低性能,说明检索证据有助于推理。移除知识引导补全或自适应选择会降低准确率,支持目标上下文补全和证据过滤的价值。
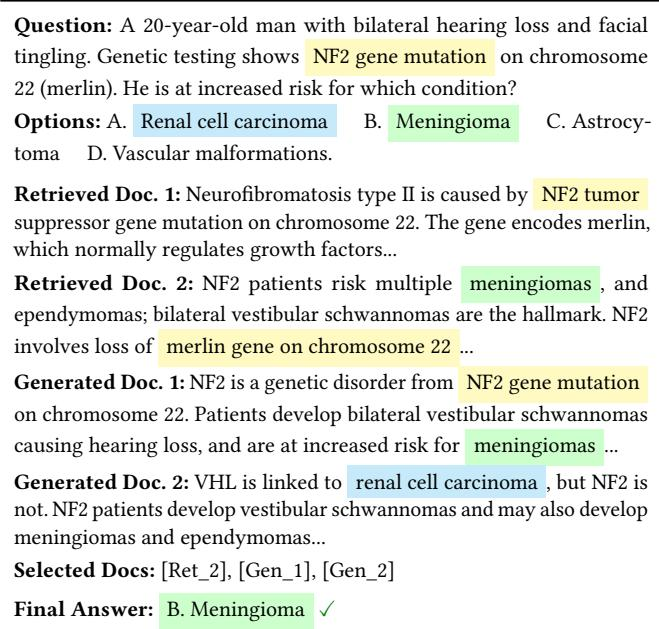
案例研究表明,检索文档可以提供关于 NF2 基因突变的部分证据,但可能遗漏关键疾病关联;生成文档则补充缺失推理上下文。生成段落阐述 NF2 相关肿瘤风险,并将其与相关综合征区分,有助于排除干扰项。结合选定检索证据和生成证据支持正确答案,即脑膜瘤。检索证据识别 NF2 和肿瘤风险,但解释不完整。生成证据通过添加疾病上下文并排除相关综合征来丰富推理。自适应选择结合检索段落和生成段落以得到正确答案。
实验评估了由考试型和文献型多选题基准组成的医学问答套件,使用准确率将 MedR-GAG 与直接回答、检索增强、生成增强基线、消融变体以及一个代表性证据案例进行比较。结果表明,MedR-GAG 取得最佳整体性能;消融实验确认,生成的问题特定知识、检索到的事实证据、知识引导补全和自适应文档选择都对推理质量有实质贡献。案例研究进一步说明,检索段落和生成段落具有互补性,检索文档提供事实锚点,生成文档补充缺失解释并帮助过滤干扰项。