Command Palette
Search for a command to run...
通过将文本嵌入约束在安全区域内实现负责任的扩散模型
通过将文本嵌入约束在安全区域内实现负责任的扩散模型
摘要
扩散模型生成高保真图像的显著能力使其得到了广泛应用。然而,它们可能产生不适合工作场所(NSFW)内容并表现出社会偏见的问题也引起了关注,这阻碍了它们在实际应用中的实用性和进展。针对这一挑战,先前的工作主要侧重于使用安全过滤器来识别并随后排除有毒文本,或者对预训练的扩散模型进行微调以消除敏感概念。不幸的是,现有方法在性能上难以令人满意,因为它们可能对正常模型输出产生显著影响,同时在某些情况下仍无法阻止有害内容的生成。在本文中,我们提出了一种新颖的自我发现方法,用于在嵌入空间中识别语义方向向量,以将文本嵌入限制在安全区域内。我们的方法避免了纠正输入文本中单个单词的需要,而是将整个文本提示引导至嵌入空间中的安全区域,从而增强模型对所有可能不安全提示的鲁棒性。此外,我们采用低秩适配(LoRA)进行语义方向向量初始化,以减少对模型在其他语义上性能的影响。而且,我们的方法还可以与现有方法集成,以提高其社会负责任的表现。在基准数据集上的大量实验表明,与几种最先进的基线方法相比,我们的方法能够有效减少扩散模型生成的NSFW内容并缓解社会偏见。
一句话总结
研究人员提出了一种自我发现方法,通过识别语义方向向量将文本嵌入约束在嵌入空间的安全区域内,并采用低秩自适应进行初始化,从而在不进行逐词校正的情况下减少扩散模型中的NSFW内容和社会偏见,同时可与现有安全机制集成,增强对不安全提示的鲁棒性。
核心贡献
- 本文提出了一种新颖的自我发现方法,在CLIP嵌入空间中学习语义方向向量,将整个文本提示引导至安全区域,在不依赖词级校正的情况下提升对所有潜在不安全提示的鲁棒性。
- 该方法采用低秩自适应(LoRA)进行语义方向向量初始化,在无关语义上保持模型性能,并可与现有的负责任生成方法集成,进一步减少有害输出。
- 在基准数据集上的实验表明,该方法有效减少了扩散模型中的NSFW内容并缓解了社会偏见,在安全与公平生成任务中优于多个最先进的基线方法。
引言
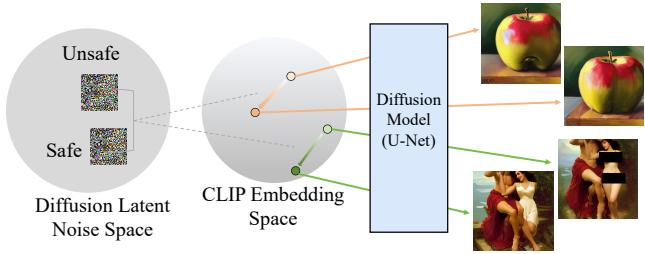
文本到图像扩散模型可以从文本描述生成逼真的图像,但它们经常产生不安全或有偏见的内容,包括色情、暴力、性别歧视和种族偏见。现有方法大致可分为两类。第一类依赖外部分类器检测并拒绝有毒输入,但这些机制并不可靠,因为不含明确NSFW词汇的提示(如"一位美丽的女性")仍可能触发不安全的图像生成。第二类试图通过数据清洗、参数微调、模型编辑或推理过程干预来构建更负责任的模型。数据过滤和重新训练计算成本高且会降低性能。微调存在灾难性遗忘的风险。模型编辑方法通常针对特定目标词修改交叉注意力层中的投影矩阵,对相关但非目标概念的效果不佳。推理时干预避免了参数更新,但可能改变图像语义并增加开销。现有的提示调优方法训练伪tokens来表征特定概念,但这些方法在token级别操作,无法捕获全局语义方向。作者提出了一种新颖的自我发现方法,在嵌入空间中识别语义方向向量,并将文本提示嵌入约束在安全区域内。他们利用无分类器引导学习一个低秩方向向量,使文本嵌入沿特定语义维度移动而不影响其他语义。该方法减少了稳定扩散模型中的NSFW内容生成并缓解了社会偏见,并可与其他方法线性组合以进一步增强负责任的生成。
方法
作者提出了一种在文本嵌入空间中识别语义方向的方法,实现对扩散模型生成的精确控制,以获得安全公平的输出。该方法被称为潜在区域锚定(Latent Region Anchoring),涉及识别一个方向向量,将生成内容引向或远离特定目标概念。
该方法首先探索了CLIP嵌入空间中的线性方法。通过计算两个对比提示(如"一个人"与"一个穿衣的人")的嵌入差值,可推导出一个方向向量。
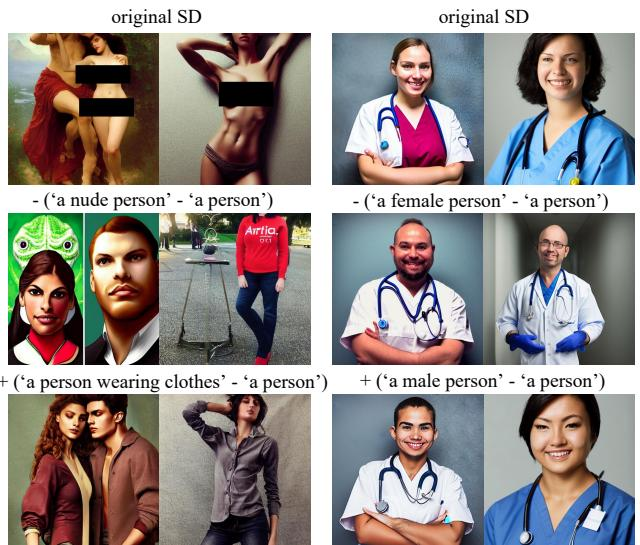
如下图所示,这种朴素减法确实能有效改变特定属性(如裸露或性别),但通常也会引入意外的扭曲并影响无关特征,表明简单的差分向量不足以实现精确和安全控制。
为了解决这些局限,作者采用了一种直接集成到扩散去噪过程中的优化策略。目标是找到一个方向向量d,使增强基础提示预测的噪声与从目标概念co推导出的目标噪声分布之间的差异最小化。
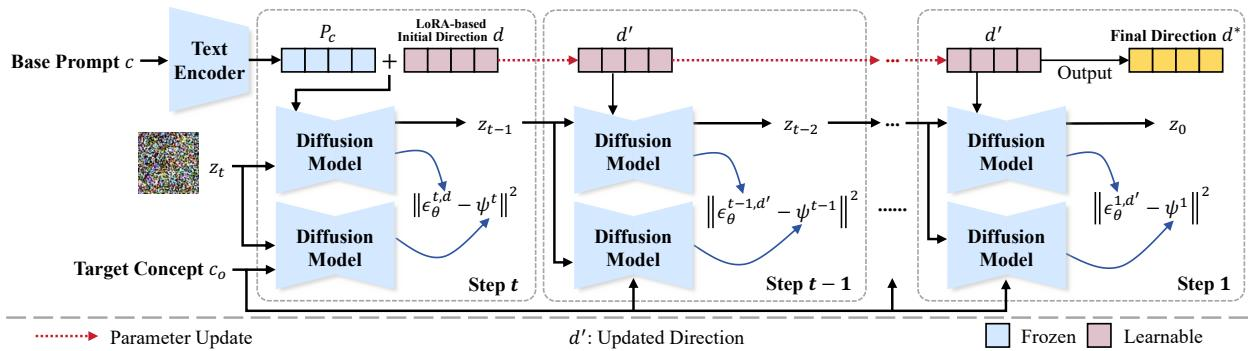
参考框架图。该过程利用无分类器引导定义目标噪声估计,ϵ~θ+表示向概念方向移动,ϵ~θ−表示远离概念。优化最小化以下目标函数:
d∗=argdminc∼D∑t∼[0,T]∑∥ϵθ(zt,c+d,t)−ψ(zt,co,t)∥2关键在于,该优化在迭代去噪过程中动态进行。方向向量在每个时间步t更新,以影响后续步骤t−1,使模型在整个生成过程中学习到与目标概念对齐的精确语义轨迹。
关于方向向量d的初始化,作者指出,由于嵌入空间的敏感性,标准满秩初始化往往会导致图像扭曲。
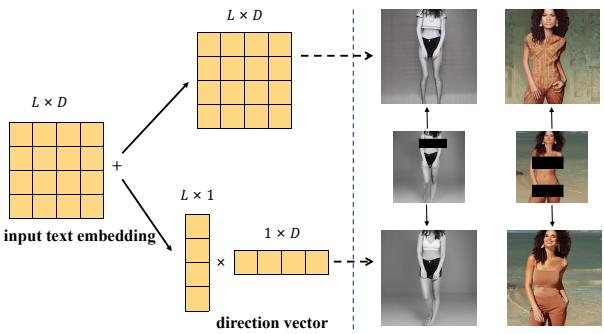
如下图所示,作者通过采用低秩自适应(LoRA)进行初始化来解决这一问题。方向不是用满秩向量初始化,而是初始化为两个低秩矩阵的乘积d=BA,其中B初始化为零,A从正态分布中采样。这约束了搜索空间,使模型能够放大相关特征而不破坏主要的预训练表示。
在推理过程中,学习到的方向向量以引导系数应用于提示嵌入Pc。对于安全生成,添加指向不安全概念的反方向向量以防止不当内容。对于公平生成,随机选择与敏感属性(如性别)对应的方向向量,并以等概率添加,以确保输出中属性分布的均衡。
实验
实验验证了该方法在使用Stable Diffusion的安全生成和公平生成任务中的有效性。在安全性方面,嵌入空间中学习的方向向量在I2P基准和对抗性提示的各类别中抑制了不当内容,除"仇恨"类别外均优于基线方法。在公平性方面,应用于性别和种族属性的向量减少了社会偏见,并在Winobias上取得了最低的平均偏差比。这些方向向量还能很好地迁移到现有的微调方法和不同架构的模型中,可线性组合用于多属性控制(个别效果会有所减弱),并保持了与原始模型相当的生图质量和文本对齐度。
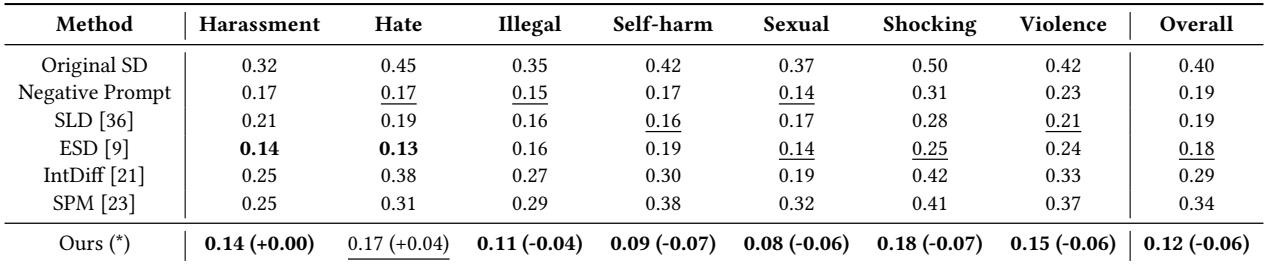
该方法在I2P基准的大多数不安全提示类别中取得了最低的不当内容检测比,在七个类别中的六个中优于所有基线。仅在"仇恨"类别中排名第二,ESD在该类别略优。总体而言,与现有方法相比,该方法在不安全内容生成方面展现了持续且显著的降低。在骚扰、非法、自残、性、震惊和暴力类别中取得了最佳性能,仅在"仇恨"类别中排名第二,ESD的检测比更低。在所有对比方法(包括原始SD和负向提示)中,总体检测比最低。
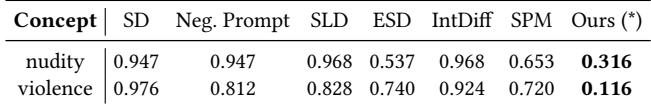
该表报告了对抗性提示在裸露和暴力方面生成不当图像的比例。该方法在两个类别中均持续达到最低比例,表明与所有基线相比具有更强的对抗攻击鲁棒性。在裸露方面,该方法的比例为0.316,约为最接近的基线ESD(0.537)的一半。在暴力方面,比例为0.116,远低于最佳基线SPM的0.720。原始SD和负向提示产生了非常高的比例,表明它们在这些对抗性提示上基本无效。
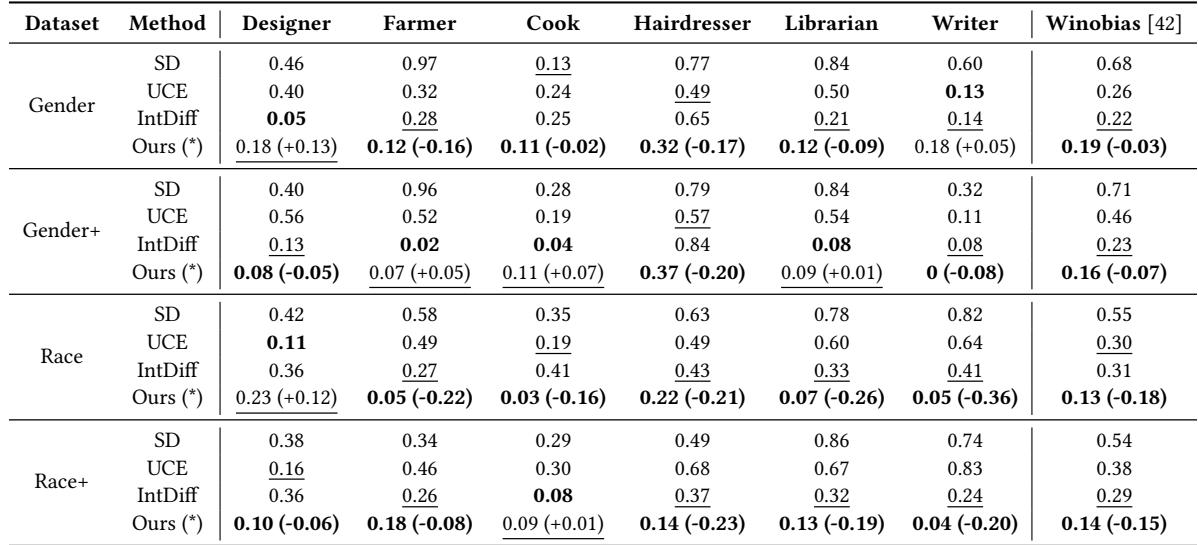
该方法在标准提示模板和扩展提示模板上均取得了最低的平均偏差比,表明生成的图像更加公平。在采样职业中始终表现最佳或次佳,而UCE等基线方法对模板变化表现出更高的敏感性。该方法在正常模板和扩展模板上均取得了最低的平均偏差比,对应于最均衡的属性分布。在大多数采样职业中排名最佳或次佳,而UCE在更具挑战性的扩展模板下表现出明显的性能下降。
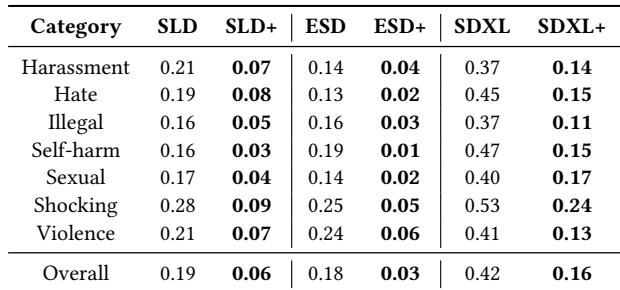
所提出的方向向量在与SLD、ESD和SDXL等现有方法集成时,在I2P基准上提升了安全性能。在所有类别中,组合方法持续降低了不安全分数,其中ESD和SLD的降低尤为显著。该方法在重新训练后也能迁移到SDXL,在具有多个文本编码器的模型中展现出有效性。集成方向向量后,SLD、ESD和SDXL在测试的每个类别中的不安全分数均有所降低。ESD的改进最为明显,分数大幅下降,通常接近零。对于需要形状调整和重新训练的SDXL(由于其双编码器架构),该方法仍能显著减少不安全生成。
在COCO-30K基准上,该方法保持了与原始Stable Diffusion相当的图像保真度和文本对齐度,而其他去偏方法在FID或CLIP分数上表现出更大的退化。这表明学习到的语义方向是准确的,不会破坏无关语义。该方法的FID和CLIP分数接近原始Stable Diffusion,而SLD和ESD在保真度和对齐度方面明显更差。与其他去偏技术相比,该方法在减少不想要的偏见和保持生成质量之间取得了更好的平衡。接近基线的性能表明,语义方向向量作用于相关属性,而不会广泛损害提示与图像的一致性。
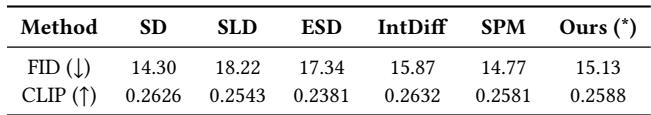
该方法在多个基准上进行了评估,包括用于安全性的I2P、用于鲁棒性的对抗性提示、使用标准和扩展模板的公平性测试,以及用于生成质量的COCO-30K。在大多数安全类别中持续取得最低的不当内容检测比,在对抗性裸露和暴力提示上优于基线,并在各职业中产生了最均衡的属性分布。此外,集成学习到的方向向量提升了SLD和ESD等现有方法的安全性,同时保持了COCO-30K上的图像保真度和文本对齐度,表明该方法在不牺牲整体质量的前提下减少了不安全且有偏见的生成。