Command Palette
Search for a command to run...
基于逆强化学习的社交媒体行为同质性:以 Reddit 为例的实证研究
基于逆强化学习的社交媒体行为同质性:以 Reddit 为例的实证研究
Lanqin Yuan Philipp J. Schneider Marian-Andrei Rizoiu
摘要
在线社区在塑造社会话语和影响现实世界的集体行为方面发挥着关键作用。人们倾向于与具有相似特征和观点的人建立联系,这一现象被称为同质性(homophily),它在回音室的形成中起着关键作用,而回音室进一步加剧了极化与分裂。现有研究在线社区同质性的工作通常采用基于内容或邻接关系的方法进行推断,例如构建显式交互网络或执行主题分析。这些方法在交互网络难以构建的平台上效果不佳,且无法捕捉平台内用户交互的复杂本质。本文提出了一种量化用户同质性的新方法。我们首先利用逆强化学习(IRL)框架推断用户的策略,随后将这些策略作为行为同质性的度量。我们将该方法应用于 Reddit,开展了跨越六年、涵盖 590 万次交互的案例研究,展示了该方法如何揭示不同社区之间差异化的行为模式和用户角色。我们进一步将行为同质性度量与传统基于内容的同质性进行对比验证,为分析社交媒体动态及其更广泛的社会影响提供了一种强有力的方法。我们发现,用户在讨论完全不同的主题(如足球与电子竞技)时,可能表现出高度相似的行为模式(高行为同质性但低主题同质性);此外,Reddit 上存在一类用户,其目的似乎专门在于反驳他人。
一句话总结
悉尼理工大学与洛桑联邦理工学院的研究人员提出使用逆强化学习来推断用户策略,将其作为行为同质性的度量,并应用于六年内 590 万次 Reddit 互动,发现用户可以在不相关主题上表现出高度行为同质性,并识别出一类主要行为是表达不同意的用户。
核心贡献
- 一种基于逆强化学习的方法从层级式 Reddit 讨论中推断用户策略,并将其作为行为同质性的度量,在缺乏显式交互网络时仍可捕捉用户行为。
- 该方法被应用于覆盖多个 subreddits 的六年期案例研究,研究 590 万次 Reddit 互动,揭示出不同的行为模式和用户角色,包括不相关主题上的高行为相似性,以及围绕不同意的参与。
- 将行为同质性度量与传统基于主题的同质性进行比较,结果显示二者基本一致,同时揭示了不同主题之间的行为相似性以及塑造参与度的共识机制。
引言
社交媒体平台塑造公共话语、信息流动,甚至金融市场,但它们的在线社区通常包含宏观层面网络分析难以捕捉的细粒度个体行为。在 Reddit 等平台上,用户在层级式、匿名的 subreddits 中互动,却没有显式的关注关系,这使得基于社交联系、话题标签或主题相似性的传统同质性度量信息量不足。作者使用逆强化学习从用户动作中推断隐藏的奖励策略,这些动作包括发帖、回复以及在嵌套讨论中达成一致。他们使用学习到的策略来定义行为同质性度量,并研究 Reddit 社区,为在常规社交关系数据不可用时研究参与模式、极化和社区动态提供了一条路径。
数据集
-
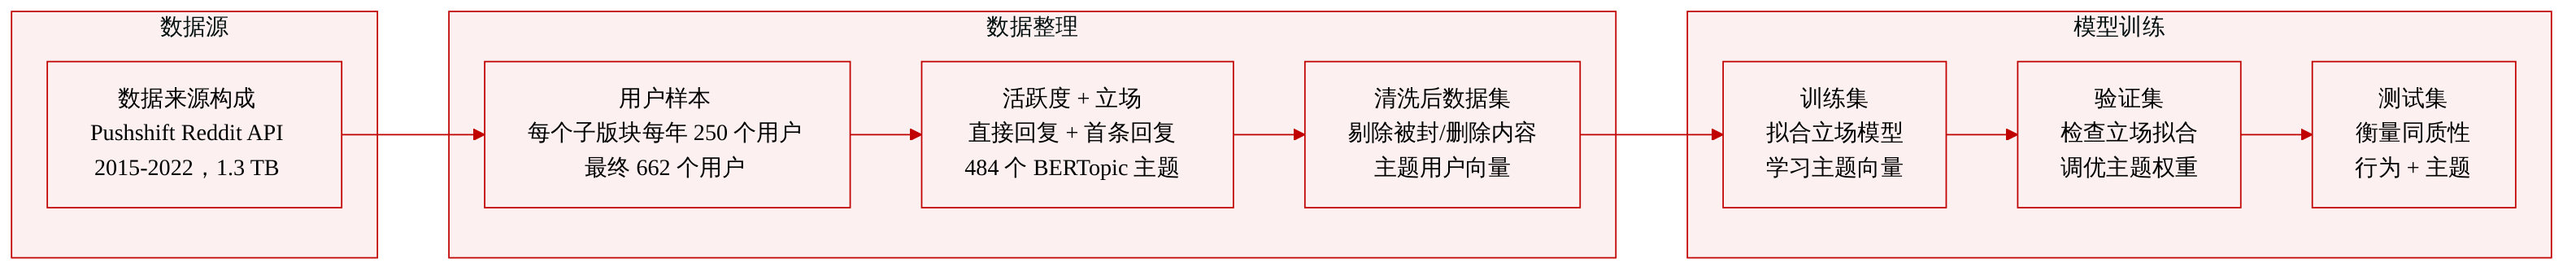
作者将 Reddit 作为主要数据来源,并使用 Pushshift Reddit API 收集数据。原始语料库包含 1.3 TB 压缩文本,覆盖 2015 年 1 月 1 日至 2022 年 1 月 1 日的所有 Reddit 数据。
-
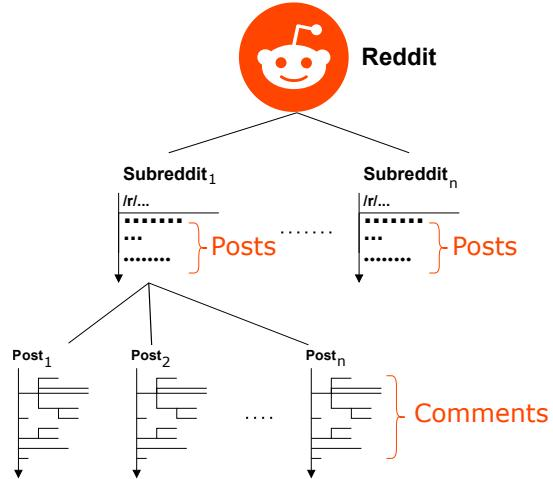
他们从 Reddit 的层级结构出发,该结构包含 subreddits、帖子、根评论和嵌套回复。该结构用于定义直接用户活动和间接交互结构。
-
作者构建了涵盖通用兴趣社区以及争议性或小众社区的种子 subreddit 集合。他们不使用公开不可获得的 subreddit 订阅。相反,他们根据用户在 Reddit 范围内的评论活跃度,将用户最活跃的 subreddit 定义为主 subreddit。
-
在用户采样方面,作者按每个种子 subreddit 每年的活跃度对用户排序,其中活跃度指发帖或评论。他们为每个 subreddit 每年加入最活跃的 50 名用户,并从年度排名的每个四分位随机抽取 50 名用户,因此每个 subreddit 每年产生 250 名用户。
-
为降低识别主 subreddit 的成本,他们从初始用户集中随机抽取三分之一,形成包含 6,000 名用户的中间子集。从该子集中,他们识别出 1,331 个不同的主 subreddit。他们选择拥有最多主用户的 15 个主 subreddit,并从每个中抽取 45 名用户,以匹配所选最小 subreddit 的规模。
-
删除被封禁用户和账户已删除用户后,最终用户数据集包含 662 名用户。
-
对于每位入选用户,作者提取直接活动,包括创建的主题帖、根评论和回复。他们还提取间接活动,并限于 Reddit 嵌套评论图中与用户动作直接相连的一级后代回复或响应。
-
来自已删除账户或被暂停发布帖子的内容被标记为不可用。在预处理过程中,为避免下游分析中的噪声,会省略受此类缺失数据影响的用户。
-
作者使用三种类别为评论回复交互添加立场标签:同意、中性和反对。在此标注步骤中,他们使用 DEBAGREEMENT 数据集,该数据集包含来自五个 subreddits 的已标注父评论和回复对:r/BlackLivesMatter、r/Brexit、r/climate、r/democrats 和 r/Republican。分类时将父评论文本和回复文本拼接。
-
他们还使用 BERTopic 构建基于主题的数据集组件。从采样的帖子中,他们得到 484 个不同主题,并用观察期内的主题使用频率向量表示每位用户。
-
最终数据集结合了 Reddit 活动日志、入选用户标识、主 subreddit 分配、直接与间接交互记录、立场标签和主题频率向量。作者使用该数据集度量行为同质性,并构建基于主题的同质性基线。
方法
作者构建了行为同质性推断框架,该框架结合社区选择、活动标注、逆强化学习和相似度打分。系统首先识别有意义的 subreddit 社区,然后选择多样化用户并收集其会话活动,接着为每次交互标注立场和主题特征,通过逆强化学习学习个性化用户策略,最后度量行为相似性和主题相似性。如下方框架图所示:
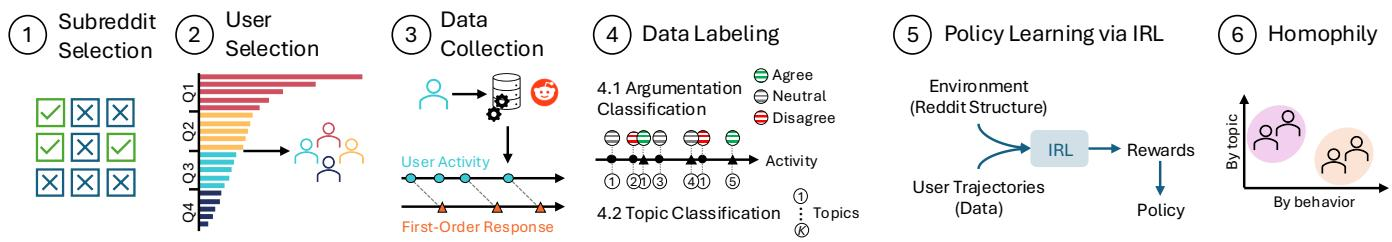
流程首先通过将在整个 Reddit 中最活跃的 subreddit 定义为用户的主 subreddit 来处理社区构建。由于 Reddit 订阅不可公开观察,这种基于活跃度的定义可作为真实社区成员身份的实际代理。该方法随后通过按种子 subreddit 内的活跃度排序并在活跃度四分位中采样来选择用户,从而确保分析不会仅限于高活跃账户。
在数据收集方面,该方法将 Reddit 活动建模为层级式会话环境。直接活动包括由用户发起的动作,例如创建主题帖、发布根评论和发布回复。间接活动捕捉由这些动作触发的一阶响应。该层级结构被视为有向无环图,其中每个动作可能有后代,且仅使用直接子响应来建模交互动态。下方 Reddit 层级图说明了该结构:
标注阶段引入两种后续用于相似性分析的特征流。第一种是论证分类,其中每条评论被分配到三种立场类别之一:同意、中性或反对。这通过在带标注的父评论-回复对微调基于 transformer 的语言模型实现。第二种是主题分类,其中主题建模方法将每项活动分配到有限集合中的某个潜在讨论主题。随后,每位用户由主题频率向量表示,后续支持基于主题的同质性度量。
核心推断模块使用最大熵深度逆强化学习从观察到的行为中恢复潜在用户奖励。该方法不假设已知奖励函数并学习最优动作,而是观察用户轨迹,并推断最能解释这些轨迹的奖励结构。每个用户被视为在 Reddit 环境中运行的独立 agent。该 agent 的轨迹包含平台上涉及该用户的事件,并映射为状态-动作特征对。环境状态包括创建初始主题帖、发布初始根评论、以同意、中性或反对方式回复、接收回复,以及参与已经活跃的讨论等类别。agent 可从等待回复、创建新主题帖、发布根评论或发布具有给定立场的回复等动作中进行选择。
状态空间包含 12 个状态,动作空间包含 6 个动作。奖励函数由神经网络参数化:
R(s)=w⊤φl(s),伴随逐层变换
φ1(s)=σ(W1s),并且对于 j∈{2,…,l},
φj(s)=σ(Wjφj−1(s)).其中,w 是权重向量,σ 是非线性激活函数,网络参数为
θ={W1,…,Wl}.奖励模型在最大熵框架下通过最大化观察到的轨迹似然进行训练。这鼓励获得一种能够解释用户行为的奖励解释,而不必对未观察偏好作出不必要的确定性假设。策略学习通过软值迭代进行,产生表示每个状态下动作分布的用户特定策略 πu。对于每位用户,所得策略可视为 12×6 矩阵,其中每行给出在给定状态下六个可能动作上的概率分布。
随后通过比较这些学习到的策略推断同质性。当两位用户在各自频繁访问的状态上的策略分布相似时,二者被视为行为相似。为了形式化这一点,该方法为用户 u 和状态 s 引入状态访问权重:
wus=∣τu∣∑k=1∣τu∣1{sk=s},其中 τu={(s1,a1),…,(s∣τu∣,a∣τu∣)} 是观察到的轨迹,1{sk=s} 是指示函数。所提出的两位用户策略之间的散度是对称加权 Kullback-Leibler 散度:
SWKL(πu,πu′)=21s∈S∑(wusDKL(πus∥πu′s)+wu′sDKL(πu′s∥πus)).该度量强调对每位用户具有行为代表性的状态,并降低稀有或含噪状态访问的影响。对于基于主题的比较,该方法从主题频率构建用户-主题向量 vu,并计算用户之间的余弦距离:
cos(vu,vu′)=1−∥vu∥∥vu′∥vu⊤vu′.总体而言,逆强化学习模块从观察到的 Reddit 轨迹中学习个性化的动作选择模式,而同质性推断模块将这些学习到的策略转换为行为相似性的量化度量,并将其与主题一致性结合,用于社区层面的分析。
实验
实验使用 Reddit 主 subreddits 沿主题维度和行为维度评估同质性。研究发现,subreddit 内部的主题一致性通常较强,而行为一致性较弱,并且可能与共同兴趣发生偏离,这由不同行为画像和社区特定参与模式所显示。进一步分析表明,主题与行为大多相关,但时间动态因用户角色而异,并凸显结合主题信号和行为信号的价值。
案例研究考察涵盖开放提问、身份支持、政治、游戏和幽默的 Reddit 社区。该研究按不同活跃度采样用户,并比较不同社区之间的主题一致性与行为趋同。相关分析表明,相似的用户行为可以跨越主题边界,而主题兴趣和参与模式在时间上表现出不同的稳定性。所考察的 subreddits 覆盖政治、社会身份、问答、游戏和幽默主题。采样设计包括来自不同活跃度四分位的用户,而不仅限于最活跃账户。行为更接近其主 subreddit 的用户,即使主题不同,也可能更接近来自另一个社区的用户。整体同质性变化随时间看起来稳定,但不同用户角色表现出不同的主题与行为模式。
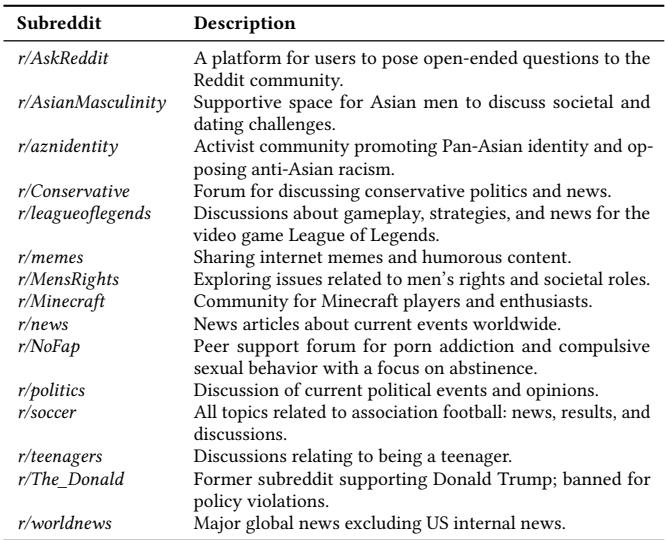
该研究评估涵盖开放提问、身份支持、政治、游戏和幽默的 Reddit 社区,并按活跃度采样用户,以比较主题一致性和行为趋同。研究发现,相似用户行为可以跨越主题边界,而主题兴趣和参与模式在时间上表现出不同稳定性。整体同质性变化保持稳定,但用户角色表现出不同的主题与行为模式。