Command Palette
Search for a command to run...
面向大型语言模型的机制设计
面向大型语言模型的机制设计
Paul Dütting Vahab Mirrokni Renato Paes Leme Haifeng Xu Song Zuo
摘要
我们研究面向人工智能生成内容的拍卖机制,重点关注广告创意生成等应用场景。在我们的模型中,智能体对随机生成内容的偏好通过大型语言模型(LLM)进行编码。我们提出了一种基于逐词元(token)操作的拍卖格式,允许基于 LLM 的智能体通过单维度出价影响内容生成。我们提出了两个理想的激励性质,并证明它们与输出聚合上的单调性条件等价。这一等价性使得即使缺乏显式的智能体估值函数,也能设计第二价格规则。我们在一个公开可用的大型语言模型上进行了演示验证。
一句话总结
Google Research 与宾夕法尼亚大学提出了一种 token-by-token 拍卖机制,用于处理广告创意等 AI 生成内容;在该机制中,agent 偏好被编码为 LLM,证明两项激励性质等价于输出聚合的单调性条件,并在不依赖显式 agent 估值函数的情况下实现二价规则设计,同时基于公开可用 LLM 的演示提供支撑。
核心贡献
- 引入了 token-by-token 拍卖框架,用于聚合多个基于 LLM 的 agent 输出,允许它们在广告创意生成等场景中通过一维出价影响随机生成内容。
- 一项稳健机制设计刻画表明,两项激励性质等价于单调输出聚合,从而可在不依赖显式 agent 估值函数的情况下启用二价支付规则;聚合函数受 KL 散度与 PPO 风格训练损失启发。
- 基于公开可用最先进 LLM 并使用 prompt tuning 的演示表明,所提出的聚合机制能够在实践中产生有前景的内容生成结果。
引言
在当今网络生态系统中,拍卖决定用户看到哪些广告和商业内容。随着 AI 生成内容变得更常见,广告主可能希望为影响 LLM 生成的输出而竞标,而不是竞标固定广告位。这一点很重要,因为 LLM 可以为聊天机器人、网页、视频和游戏创建动态且上下文感知的商业内容,但拍卖理论尚未适应这些模型表示偏好的方式。
现有工作并未直接处理这一场景。在由最高出价者选择内容的简单拍卖中,LLM 将广告主概念组合为联合输出的灵活性被浪费。LLM 也让机制设计更复杂:通过 token 级概率分布编码偏好、依赖随机采样、要求与现有模型 API 保持技术兼容,且查询成本较高。
作者提出了一种 token 拍卖模型,以每次一个 token 的方式聚合多个广告主 LLM,并使用出价作为每个模型对输出分布影响的权重。作者定义了稳健激励性质,包括支付单调性与一致聚合,并说明如何将该场景下的支付调整为二价风格。作者还设计了受 LLM 训练损失启发的聚合规则,例如 KL 散度,并证明这些机制能够产生可解释且平滑偏向不同广告主的联合广告。
方法
面向 LLM 输出聚合的 token 拍卖机制
所提出的方法将每个 LLM 建模为算法 agent,该 agent 通过下一 token 分布表达偏好。作者并未在完整生成文本上设计拍卖,而是将机制置于 token 生成层,使系统与现代自回归 LLM 推理管线保持一致。每个 agent 接收 prompt,生成下一个 token 的概率分布,并参与 token 拍卖,将这些分布合并为一个用于生成下一个 token 的聚合分布。
整体机制表示为
M=⟨q,z⟩,其中 q 是分布聚合函数,z 是支付规则。聚合函数决定在每个生成步骤中使用哪个 token 分布,而支付规则决定每个 agent 为影响被采样的 token 支付多少。
考虑拥有 token 生成函数的 n 个 LLM agent
fi:T∗→Δ(T),其中 T 是词表,Δ(T) 是 token 上概率分布的集合。在步骤 k,从当前 prompt sk−1 出发,agent i 产生偏好的 token 分布
pi=fi(sk−1).agent 提交出价
b=(b1,…,bn)∈Q+n,其中每个 bi 是一个非负标量,表示 agent 对聚合的预期影响。聚合函数将出价和 token 分布映射为新分布:
q:Q+n×Δ(T)n→Δ(T).对于固定出价,步骤 k 的聚合分布为
qk=q((b1,…,bn),(f1(sk−1),…,fn(sk−1))).下一个 token 按如下方式采样为
τk∼qk,生成文本按如下方式扩展
sk=sk−1⊕τk.由于每个 LLM 已经产生 fi(sk−1),拍卖直接作用于推理已经需要的 token 级输出,从而避免仅为计算聚合分布而增加额外的 LLM 调用。
稳健偏好建模
一个核心挑战是定义对 LLM agent 而言一个聚合分布何时优于另一个。作者认为,很难对所有可能输出分布施加完整排序。例如,如果 LLM 对两个 token 的偏好分布为 p=(0.6,0.4),那么生成分布 (0.5,0.5) 和 (0.8,0.2) 哪一个更受偏好并不总是明确,因为其中一个可能在某些 token 上减小偏差,同时增加 agent 偏好 token 上的概率。
为解决这一点,该方法使用基于稳健偏好的偏序。对于偏好分布为 pi 的 agent i,如果对于每个 token t∈T,
∣q(t)−pi(t)∣≤∣q′(t)−pi(t)∣以及
(q(t)−pi(t))(q′(t)−pi(t))≥0.则称聚合分布 q 弱稳健受偏好于 q′,记作
q⪰iq′,第一个条件要求 q 在每个 token 上对 pi 的偏差不超过 q′。第二个条件要求偏差具有相同符号,意味着两个分布相对于偏好分布在每个 token 上朝同一方向移动。因此,当 q 在逐坐标且同方向意义上更接近 agent 的偏好分布时,q 更受偏好。这样,不必假设针对所有可能输出分布的完整效用函数,同时保留有意义的部分比较。
聚合与支付模块
拍卖将输出聚合与支付分离。聚合模块产生下一 token 分布,而支付模块为每个 agent 分配每个 token 的费用。
对于每个 agent i,系统定义一个逐 token 定价函数
ζi:Q+n×Δ(T)n×T→R.如果出价为 b,token 分布为 p=(p1,…,pn),并且 token t 从 q(b,p) 中采样,那么 agent i 支付
ζi(b,p,t).agent i 的期望支付为
zi(b,p)=Et∼q(b,p)[ζi(b,p,t)].这一 token 级分解很重要,因为它对应自回归生成的阶段独立结构。支付无需比较完整生成序列;相反,它在每一步对被采样的 token 进行操作。
面向激励的聚合设计
作者关注具有简单且稳健激励性质的机制。他们提出支付单调性,要求 agent 的支付仅当聚合结果变得弱更受偏好时增加。形式上,对于 agent i,
zi(bi,b−i,p)≥zi(bi′,b−i,p)当且仅当
q(bi,b−i,p)⪰iq(bi′,b−i,p).这一条件防止一种常见的操纵激励:agent 不应能够通过降低出价或策略性错报来以更低支付获得更好的输出分布。
作者还定义聚合的一致性。如果 agent i 的两个出价在某些对手的出价下诱导严格偏好排序,那么在其他对手的出价下该排序不应反转。形式上,如果对于某些 b−i,
q(bi,b−i,p)≻iq(bi′,b−i,p),那么对于所有其他对手出价 b−i′,
q(bi,b−i′,p)⪰iq(bi′,b−i′,p).这一要求稳定 agent 对自身出价的看法,因此 agent 不会仅仅因为其他人选择的出价而不清楚自己的出价是否更优。
由这些条件可推导出一个聚焦于单调聚合函数的设计原则。如果 agent i 的更高出价总导致对 i 弱更受偏好的聚合分布,则分布聚合函数是单调的:
q(bi,b−i,p)⪰iq(bi′,b−i,p)wheneverbi≥bi′.作者证明,在支付单调性条件下,任何具有一致聚合函数的机制都可以策略性地转换为具有单调聚合函数的机制。这给出了一个设计归约:可以把注意力集中在单调聚合规则上,同时不失去主要激励结构。
两个简单聚合规则说明了这种区别。线性聚合函数为
qKL(b,p)=∑ibi∑ibipi.该规则在稳健偏好下是单调的:提高 bi 会增加混合分布中 pi 的权重。相比之下,诸如以下 log-linear 规则
lnqˉKL(t)=C+∑ibi1i∑bilnpi(t),其中 C 是归一化常数,在稳健偏好下通常不单调。尽管它自然对应某些 RLHF 风格的聚合,但单调性可能在特定 agent 对和特定偏好分布上失效。
通过稳定采样实现二价支付
一旦选择单调聚合规则,该方法便构造一个 token 级二价支付规则,灵感来自 Vickrey 拍卖中支付改善结果所需最低出价的思想。
为定义支付,作者将聚合函数诱导的随机采样表示为一个实现。固定除 agent i 出价之外的所有出价和分布。令
qt(bi)=qt(bi,b−i,p)为 token t 的概率。实现是一个确定性映射
σ(bi,r)∈T,其中 r 是外生随机变量。如果对于每个 token t,
r∼RPr[σ(bi,r)=t]=qt(bi).则该实现是有效的。
因此,随机性通过 r 进入;对于固定随机数 r,被采样的 token 是出价的确定性函数。
关键思想是根据 agent i 的偏好分布,将 token 集合划分为欠采样 token 和过采样 token。以 qt(0) 作为 agent 出价为零时的基准概率,定义
T+={t∈T:qt(0)≤pi(t)}以及
T−={t∈T:qt(0)>pi(t)}.T+ 中的 token 是 agent i 希望增加的 token,而 T− 中的 token 是相对于偏好而言出现过于频繁的 token。聚合函数的单调性对应 T+ 上的概率随 bi 弱增,且 T− 上的概率随 bi 弱减。
稳定采样实现具有特别简单的反事实结构。对于每个随机数 r,存在一个欠采样 token ur∈T+、一个过采样 token or∈T− 和一个关键出价阈值 θr,使得
σ(bi,r)=orifbi<θr,以及
σ(bi,r)=urifbi≥θr.直观上,当 agent 提高出价时,被采样的 token 可以从一个过采样 token 转变为一个欠采样 token。支付规则直接来自这一转变。如果被采样的 token 是过采样 token,则 agent 支付为零,因为对于该随机数,在出价为零的基准下同一个 token 原本也会出现。如果被采样的 token 是欠采样 token,意味着 agent 的出价跨过改善结果所需的阈值,则 agent 支付关键出价
θr.这给出了一个 token 级二价规则:agent 支付在实现出的随机数下将一个较不受偏好的 token 替换为较受偏好 token 所需的最小金额。
期望支付可以用朝向 agent 偏好分布的总变差距离减少量来表达。具体地,
zi(bi)=21∫0bi[∥q(bi)−pi∥1−∥q(b′)−pi∥1]db′.该公式表明,支付与 agent 出价使聚合分布靠近其偏好分布的程度成比例。它还提供了 Myerson 风格的刻画:经典拍卖中的分配概率在这里被总变差距离的变化所替代。
这种稳定采样设计使支付不依赖具体采样算法,只要该算法是稳定的。它还简化了 agent 的反事实推理。对于任意固定随机数 r,agent 只需比较两个可能结果:阈值以下的过采样 token 与达到或超过阈值的欠采样 token。
受 LLM 训练启发的聚合规则
作者随后提出结构对应标准 LLM 训练目标的聚合函数。其指导原则是在 agent 上定义聚合损失:
Loss(p,b,q)=i∑biρ(pi,q),其中 ρ(pi,q) 度量聚合分布 q 距离 agent i 偏好分布 pi 的程度。函数 ρ 的选择用于反映 LLM 训练中使用的损失。
受 KL 启发的聚合
对于受 KL 启发的聚合,作者考虑那些通过最小化相对于标注数据的 KL 散度训练得到模型的 agent。它们将聚合损失定义为
LOSSKL(p,b,q)=i∑bit∈T∑pi(t)lnq(t)pi(t).这是下列项的出价加权和
DKL(pi∥q).最小化该损失得到线性聚合规则
qKL(t)=∑ibi∑ibipi(t).这种聚合在稳健偏好下是单调的。它还有一个实用的采样解释:不必显式计算完整混合分布,只需按与 bi 成比例的概率选择 agent i,然后从 pi 中采样一个 token。这减少了 token 生成所需的计算,尽管支付计算可能仍需要访问所有 agent 的分布。
受 RLHF 启发的聚合
对于受 RLHF 启发的聚合,作者考虑一种场景:agent 共享同一个监督微调基座模型,但具有不同的奖励函数。按出价对奖励函数加权会导致聚合损失具有相反的 KL 方向:
LossKL(p,b,q)=i∑bit∈T∑q(t)lnpi(t)q(t).这对应于出价加权的
DKL(q∥pi).最小化得到 log-linear 聚合规则
lnqˉKL(t)=C+∑ibi1i∑bilnpi(t),其中 C 对 T 上的概率进行归一化。对于使用不同奖励信号调优的模型,这种规则是自然的聚合方式,但它在稳健偏好下通常不单调。因此,该方法揭示了一种设计权衡:受 KL 启发的线性聚合支持单调性和更简单的二价激励,而受 RLHF 启发的 log-linear 聚合更好地反映某些基于奖励的调优过程,但可能需要较弱或经过调整的激励保证。
实验
作者使用一个修改后的 LLM 实现所提出的聚合函数,该 LLM 暴露 token 分布,并通过 prompt tuning 模拟不同 agent。在联合营销和竞争虚拟品牌上的实验表明,生成的广告在定性上遵循预期偏好权重:在合作场景中,内容会偏向一个品牌、两个品牌或另一个品牌;在竞争场景中,内容会偏向单个品牌。在中间偏好水平附近偶尔出现品牌名称混淆,这表明任务特定微调可能提升可靠性。
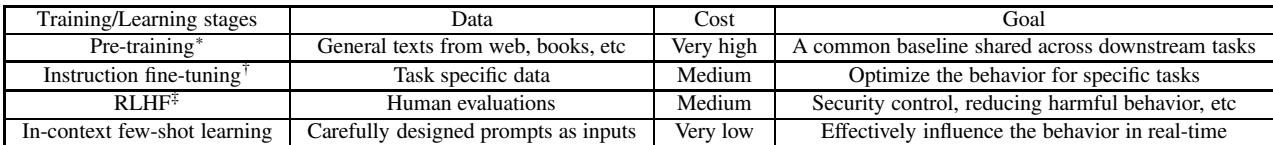
这些训练阶段涵盖从通用模型开发到更轻量的模型行为适配方式。在通用文本上的预训练成本较高,并为许多任务创建共享基线;指令微调和 RLHF 使用更有针对性的数据或人类反馈来改善特定行为并减少有害输出。基于 prompt 的学习成本最低,因为它无需额外训练即可实时改变模型行为。预训练使用广泛网络文本、书籍及类似文本,成本极高,并建立通用基线。指令微调与 RLHF 成本中等,旨在优化特定任务行为或提升安全性。上下文内少样本学习使用精心设计的 prompt,成本极低,并能实时影响行为。
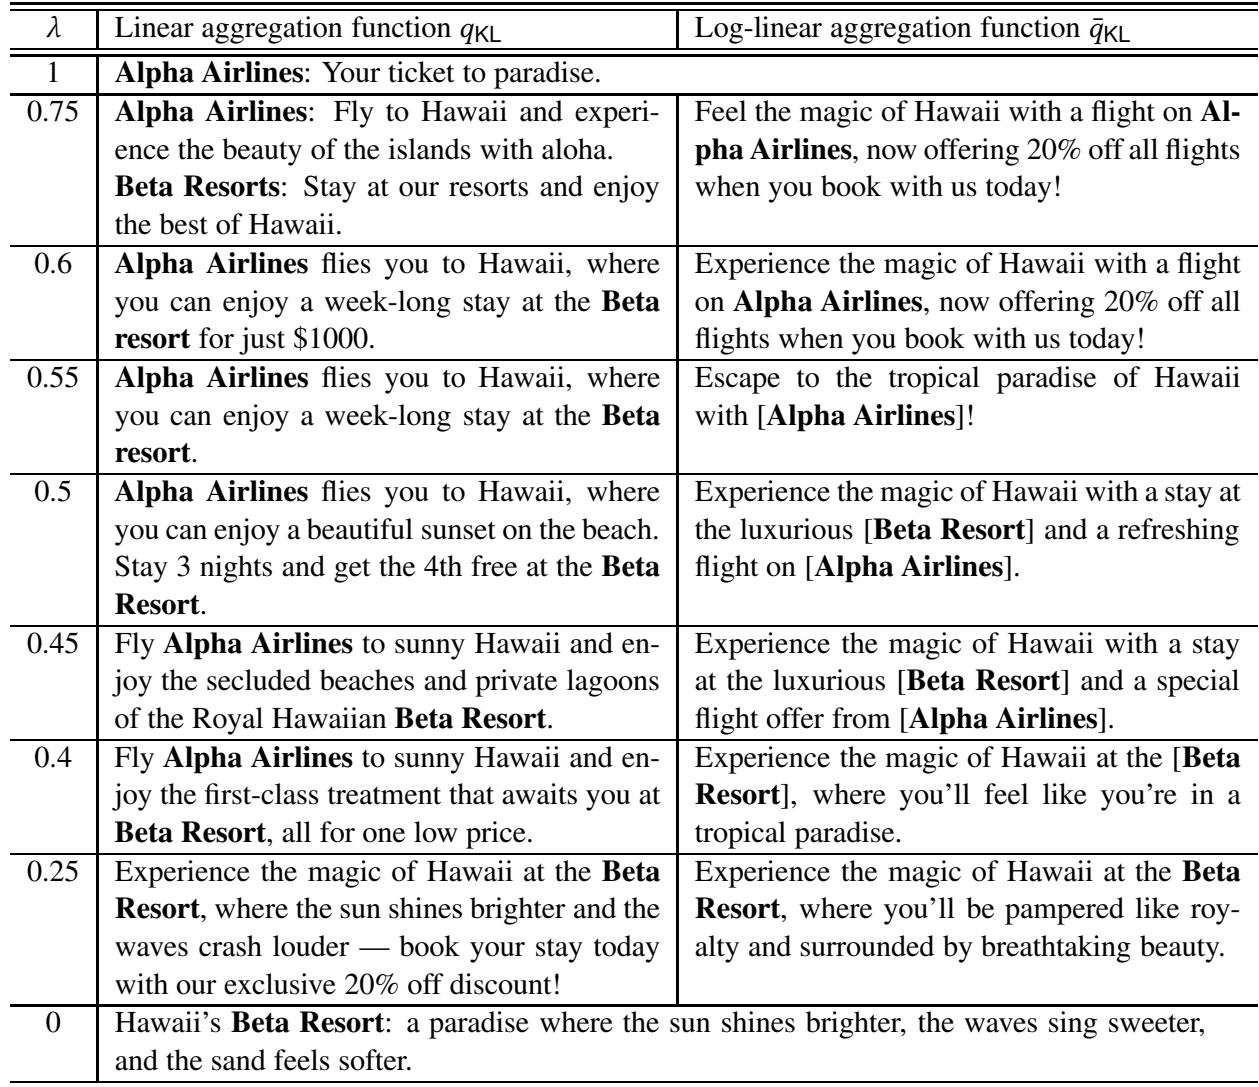
在联合营销演示中,降低聚合权重会使生成的广告从强调 Alpha Airlines,逐渐转为同时提及 Alpha Airlines 和 Beta Resort,最终转为强调 Beta Resort。这一趋势在线性和 log-linear 聚合中均出现,不过 log-linear 规则在更窄的中间范围内改变强调,并倾向于更长时间保留最初受偏好的品牌。生成结果说明聚合规则能够引导品牌突出程度,且任务特定微调可能带来改进。随着聚合权重向第二个品牌偏移,生成内容从一个品牌转向同时提及两个品牌,再转向另一个品牌。在产生组合广告之前,log-linear 聚合比线性聚合更长时间保留对 Alpha Airlines 的强调。
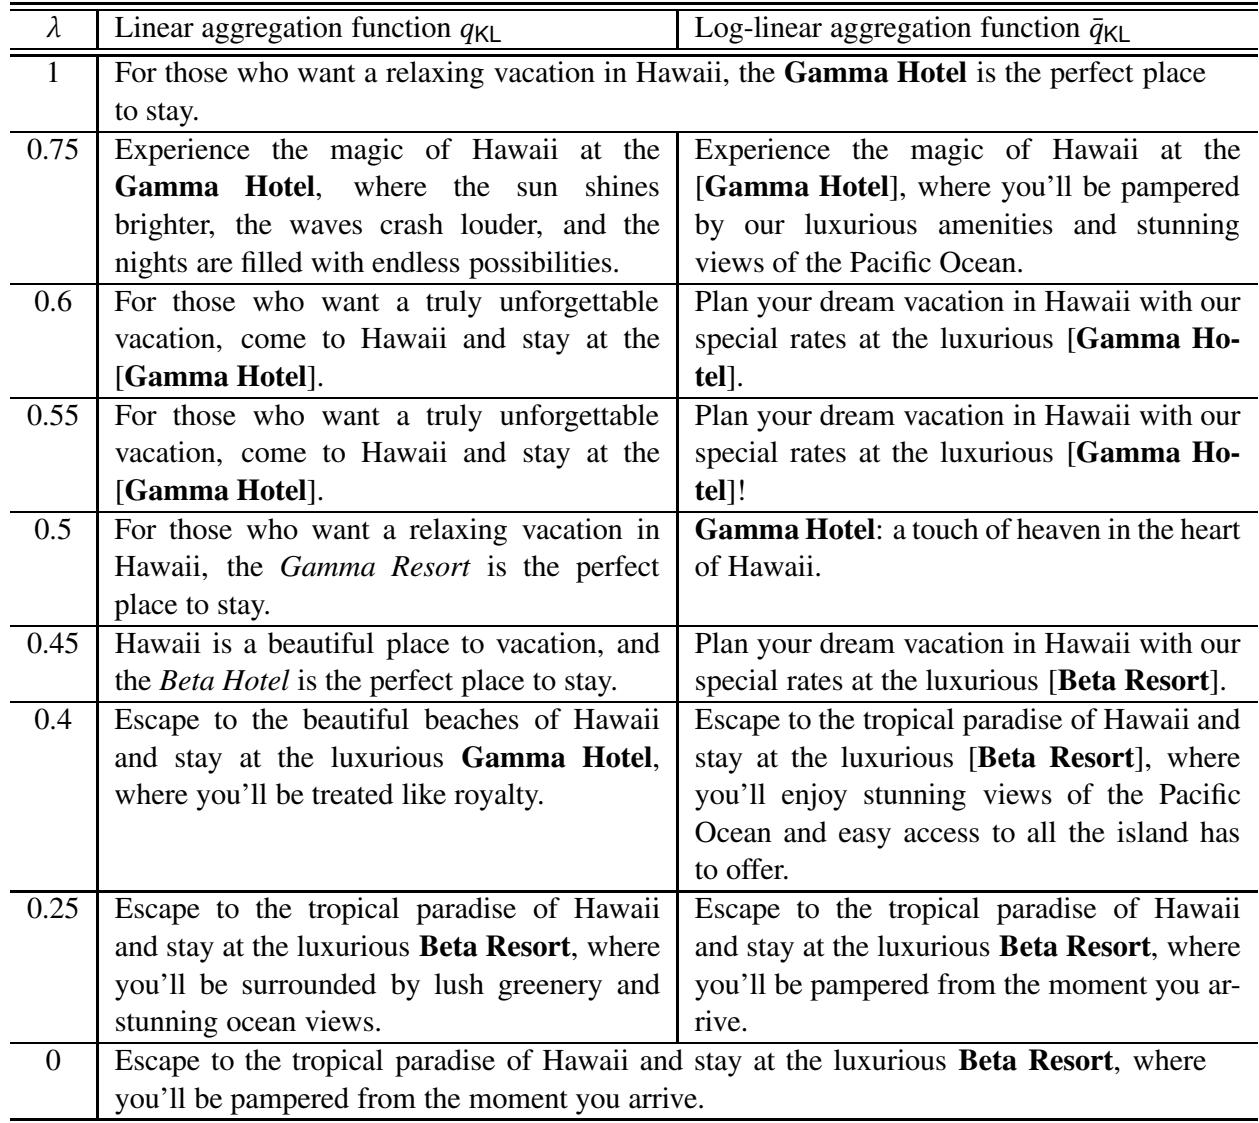
当权重从偏向第一个品牌转向偏向第二个品牌时,两种聚合函数生成的文本都会从只提及 Gamma Hotel 变为只提及 Beta Resort。竞争设置产生单品牌输出,而不是同时提及两个品牌。在转换区域附近,线性方法有时错误混合品牌名称,这表明任务特定训练可能有助于强制使用准确术语。两种聚合方法都显示从 Gamma Hotel 强调到 Beta Resort 强调的转移。竞争设置避免了在同一创意中组合两个品牌。线性聚合在切换区域附近可能混淆品牌后缀。
实验比较了用于控制生成广告的宽泛训练与适配策略,并演示聚合权重与规则如何影响品牌突出程度。联合营销输出从第一个品牌逐渐经由同时提及过渡到第二个品牌,其中 log-linear 比线性更长时间保留第一个品牌。竞争输出在权重变化时大多将品牌彼此隔离,说明聚合机制能够引导强调程度,尽管微调可能改善术语准确性和混合效果。