Command Palette
Search for a command to run...
面向下一篮子推荐的个性化马尔可夫链分解
面向下一篮子推荐的个性化马尔可夫链分解
Steffen Rendle Christoph Freudenthaler Lars Schmidt-Thieme
摘要
推荐系统是许多网站的重要组成部分。两种最流行的方法分别基于矩阵分解(MF)和马尔可夫链(MC)。MF 方法通过对观测到的用户-物品偏好矩阵进行分解来学习用户的总体偏好。另一方面,MC 方法通过学习物品上的转移图来建模序列行为,并利用该图根据用户的近期行为预测下一个动作。本文提出了一种将两种方法相结合的方法。我们的方法基于底层马尔可夫链上的个性化转移图,即为每个用户学习一个独立的转移矩阵,因此该方法总共使用一个转移立方体。由于用于估计转移的观测数据通常非常有限,我们使用成对交互模型对转移立方体进行分解,该模型是 Tucker 分解的一个特例。我们证明了所提出的因子化个性化马尔可夫链(FPMC)模型同时包含了公共马尔可夫链和普通矩阵分解模型。为了学习模型参数,我们为序列篮子数据引入了一种贝叶斯个性化排序(BPR)框架的适配版本。实验表明,FPMC 模型在性能上优于使用因子化和不使用因子化学习到的公共矩阵分解模型和非个性化马尔可夫链模型。
一句话总结
大阪大学与希尔德斯海姆大学提出 FPMC,该方法通过基于 Tucker 分解的两两交互模型对用户特定转移立方进行矩阵分解,将矩阵分解与个性化马尔可夫链统一起来,涵盖常见马尔可夫链与标准矩阵分解,并针对顺序购物篮数据改造 BPR,实验上优于这两种方法。
核心贡献
-
论文引入 FPMC,一种推荐模型,通过学习每个用户的个性化转移矩阵,将矩阵分解与马尔可夫链集成,形成能够同时捕捉通用用户兴趣和近期顺序行为的转移立方。
-
该方法通过对转移立方采用两两交互模型,即 Tucker 分解的一个特例,使个性化转移图具有实际可行性,并将贝叶斯个性化排序框架适配于从隐式顺序购物篮数据中学习。
-
该工作表明,FPMC 可以涵盖标准矩阵分解与非个性化分解马尔可夫链;同时,在真实数据上的实验显示,FPMC 在稀疏与稠密数据上均优于 MF、FMC 和非个性化 MC。
引言
推荐系统在电商和网页个性化中很重要,因为它们使用用户活动数据预测用户可能下一个购买什么,从而帮助提升销售、点击率和用户满意度。以往方法通常二选一:顺序马尔可夫链模型捕捉近期购买产生的下一个物品行为,但在所有用户之间共享一个转移模式;分解模型从全部历史中学习长期用户偏好,却忽略序列效应;在稀疏购物篮数据下,直接估计用户特定转移矩阵也不可靠。作者利用分解个性化马尔可夫链(FPMC),为每个用户分配个性化转移矩阵,并通过扩展贝叶斯个性化排序的低秩矩阵分解来估计生成的转移张量。该方法将顺序行为与用户特定偏好结合,并推广了标准马尔可夫链和矩阵分解推荐器。
数据集
-
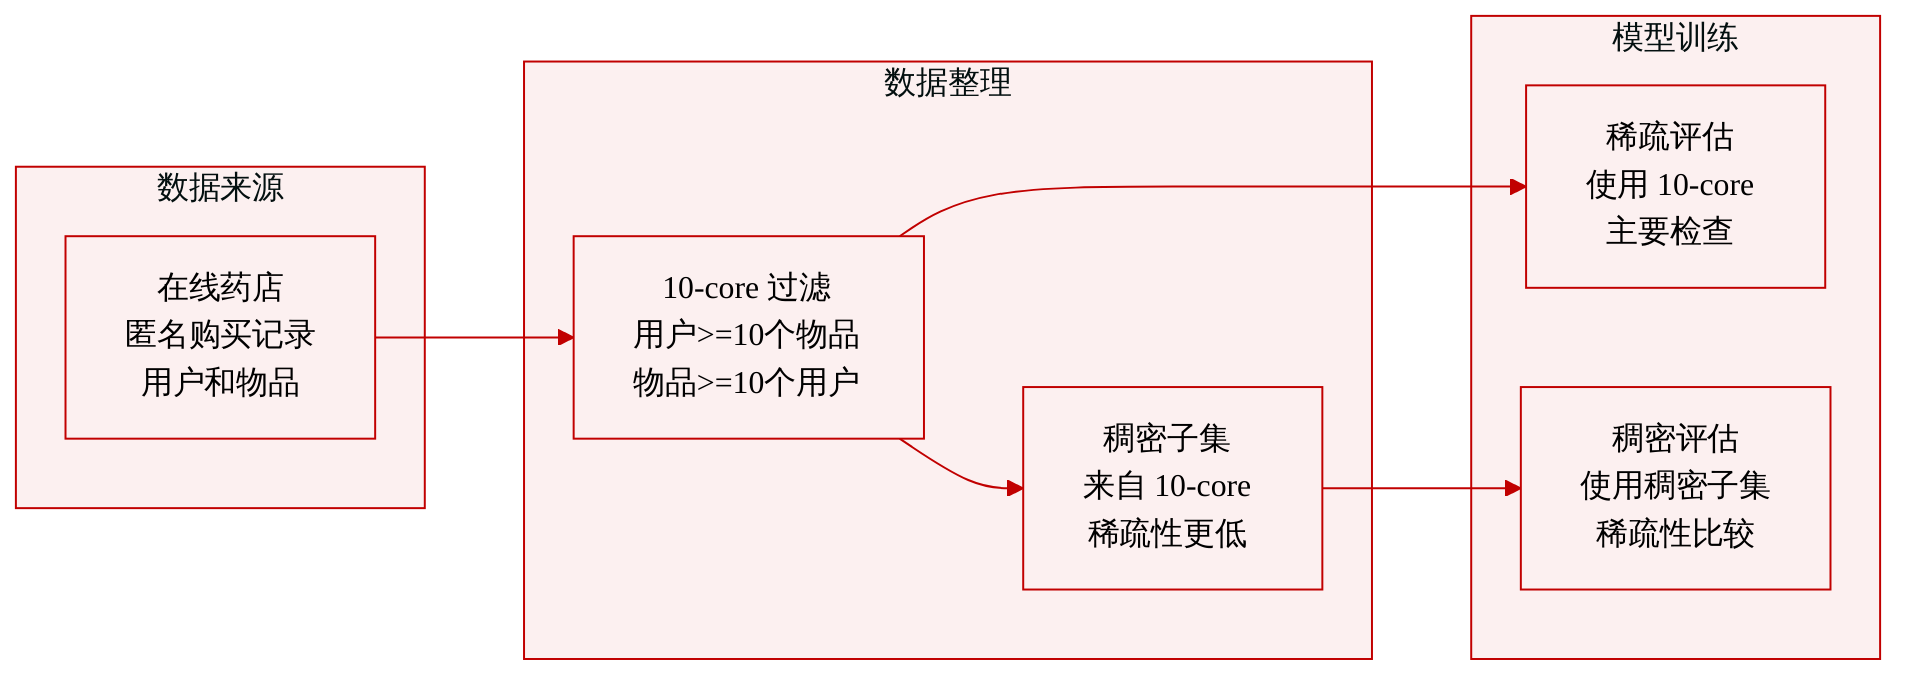
数据集是匿名网购药店购买数据。
-
主评估集是 10-core 子集,通过过滤交互来构建:
- 每个用户总共至少购买 10 个物品,并且
- 每个物品至少被 10 个用户购买。
-
作者还从 10-core 数据集创建一个更稠密的子集,以研究稀疏性对评估推荐方法的影响。
-
数据集统计量在论文表 1 中报告。
-
数据用于评估推荐器,其中 10-core 子集代表稀疏设置,更稠密子集用于比较。
-
论文除了 10-core 过滤和创建稠密子集外,没有提及裁剪、元数据构造或其他复杂预处理。
方法
作者研究从顺序集合数据中进行物品推荐。对于每个用户 u,观测到的行为是购物篮序列
Bu=(B1u,…,Btu−1u),Btu⊆I,其中 I 是物品全集,每个购物篮包含在相同相对时间步购买的若干物品。目标是在下一次访问 t 时,学习用户 u 的物品个性化排序。等价地,模型诱导一个排序
i≻u,tj⟺x^u,t,i>x^u,t,j,因此排名靠前的物品构成推荐列表。
参见下面的示例:
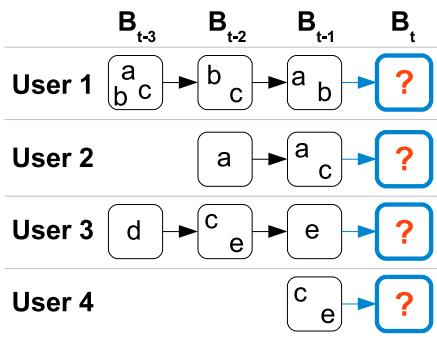
基本构建模块是适配购物篮数据的马尔可夫链。由于任意子集的状态空间为 2∣I∣,购物篮上的完整马尔可夫链不可行。因此作者在物品级建模转移,并使用一阶依赖。对任意两个物品 l 和 i,作者定义
al,i:=p(i∈Bt∣l∈Bt−1),它可以视为物品转移矩阵中的一个条目。给定前一个购物篮 Bt−1,物品 i 出现在下一个购物篮中的概率,对 Bt−1 中的所有物品取平均:
p(i∈Bt∣Bt−1)=∣Bt−1∣1l∈Bt−1∑p(i∈Bt∣l∈Bt−1).这个量可以直接排序,因此适合用于推荐,即使没有显式建模完整购物篮上的真实马尔可夫链。
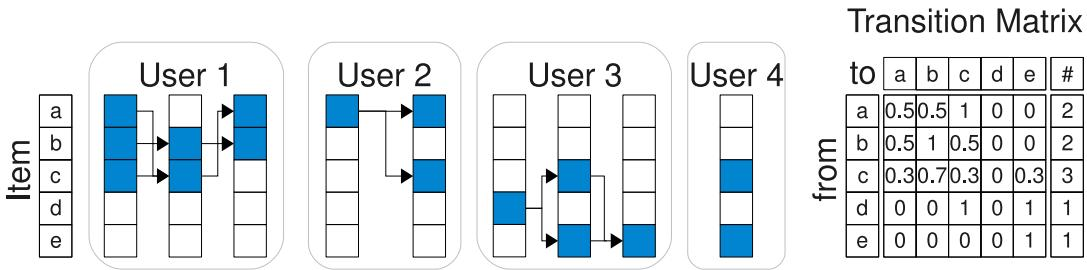
每个物品转移的最大似然估计可以通过对观测到的购物篮对计数得到:
a^l,i=∣{(Bt,Bt−1):l∈Bt−1}∣∣{(Bt,Bt−1):i∈Bt∧l∈Bt−1}∣.当加入个性化后,转移概率变为用户特定:
au,l,i:=p(i∈Btu∣l∈Bt−1u),形成三模转移张量 A∈R∣U∣×∣I∣×∣I∣。作者观察到,这种完整参数化极其稀疏。许多转移从未被观测到,已观测到的转移又常常仅基于极少计数,导致最大似然估计不可靠。由这些计数构建的转移矩阵通常稀疏,并且可能偏好热门但排序不佳的物品。下面的例子展示了通过最大似然估计得到的非个性化转移矩阵:
为了解决这个稀疏问题,作者提出分解个性化马尔可夫链(FPMC)。核心思想是用低秩近似替代完整转移张量。作者从 Tucker 风格矩阵分解开始:
A^:=C×UVU×LVL×IVI,其中 VU 捕捉用户潜在因子,VL 捕捉前一个购物篮中物品的潜在因子,VI 捕捉待预测物品的潜在因子,C 是核心张量。对于稀疏转移数据,作者使用更紧凑的两两交互形式:
a^u,l,i=⟨vuU,I,viI,U⟩+⟨viI,L,vlL,I⟩+⟨vuU,L,vlL,U⟩.每一项都有清晰解释。第一项捕捉全局用户-物品亲和度,与标准矩阵分解类似。第二项捕捉待预测物品 i 与前一个购物篮中物品 l 之间的转移亲和度。第三项捕捉涉及前一个购物篮的用户条件转移。
在给定前一个购物篮时,物品 i 的完整个性化预测为
p^(i∈Btu∣Bt−1u)=∣Bt−1u∣1l∈Bt−1u∑a^u,l,i.代入矩阵分解后得到
p^(i∈Btu∣Bt−1u)=⟨vuU,I,viI,U⟩+∣Bt−1u∣1l∈Bt−1u∑(⟨viI,L,vlL,I⟩+⟨vuU,L,vlL,U⟩).在物品排序中,(U,L) 交互项在训练目标所用的两两排序损失下保持不变。它依赖用户 u 和购物篮 Bt−1u,但不依赖正在评分的候选物品,因此在比较两个候选物品时会抵消。作者因此使用紧凑评分函数
x^u,t,i=⟨vuU,I,viI,U⟩+∣Bt−1u∣1l∈Bt−1u∑⟨viI,L,vlL,I⟩.这个紧凑形式表明,该架构是矩阵分解和分解马尔可夫链的联合扩展。第一项类似于个性化推荐组件,第二项类似于顺序转移组件。与分别训练两个模型的简单集成不同,所有潜在因子都在同一排序目标下共同学习。
训练目标是顺序贝叶斯个性化排序(S-BPR)。作者优化参数 Θ={VU,I,VI,U,VI,L,VL,I,VU,L,VL,U},使得购物篮 Btu 中实际购买的物品排名高于该购物篮中未出现的物品。使用逻辑 sigmoid σ(z),排序似然为
p(i≻u,tj∣Θ)=σ(x^u,t,i−x^u,t,j).在潜在因子上加入高斯先验后,MAP 目标变为
argΘmaxu∈U∑Bt∈Bu∑i∈Bt∑j∈/Bt∑lnσ(x^u,t,i−x^u,t,j)−λΘ∥Θ∥F2.这里 λΘ 控制正则化,损失显式比较同一用户和时间步下已观测的购物篮物品 i 与未观测候选物品 j。
由于完整四元组集合 (u,t,i,j) 太大,无法直接优化,作者使用自举采样和随机梯度下降。在每次迭代中,采样一个四元组 (u,t,i,j),其中 i 是购物篮 Btu 中的物品,j 是该购物篮中不存在的物品。然后使用采样的 S-BPR 损失梯度更新模型参数。对于标量潜在因子 θ,更新信号形式为
∂θ∂(lnσ(x^u,t,i−x^u,t,j)−λθθ2)=(1−σ(x^u,t,i−x^u,t,j))∂θ∂(x^u,t,i−x^u,t,j)−2λθθ.模型梯度将紧凑排序分数与底层因子矩阵耦合。例如,
∂vu,fU,I∂(x^u,t,i−x^u,t,j)=vi,fI,U−vj,fI,U,这意味着用户因子根据已观测候选物品和未观测候选物品之间的相对嵌入差异进行更新。与转移相关的因子接收按前一个购物篮平均表示加权的更新:
∂vi,fI,L∂(x^u,t,i−x^u,t,j)=∣Bt−1u∣1l∈Bt−1u∑vl,fL,I, ∂vj,fI,L∂(x^u,t,i−x^u,t,j)=−∣Bt−1u∣1l∈Bt−1u∑vl,fL,I.这些更新方向通过用户因子、候选物品因子和前一个购物篮物品因子传播信息。实际优化循环每次采样一个正样本物品、一个负样本物品、一个用户和一个购物篮时间步,计算带 sigmoid 权重的梯度,并应用带正则化的梯度上升步骤。每次迭代的复杂度为
O(kU,I+kI,L∣B∣),其中 kU,I 和 kI,L 是潜在维度大小,∣B∣ 是平均购物篮大小。这使得自举采样过程可用于具有顺序集合行为的大规模物品推荐问题。
实验
实验在药店购买数据上评估分解马尔可夫链推荐器,使用最后一个购物篮划分和 HLU、top-5 F 测度、AUC 等排序指标,并与稠密 MC、MF 和最热门基线比较。分解模型始终优于基线,尤其是在数据变得更稀疏时,因为低秩转移估计会使稀疏计数更稠密,并减少过拟合。MF 在更稠密数据上表现相对较好,而 MC 和 FMC 在更稀疏设置中从顺序购买信号中受益,同时结合两者的 FPMC 得到最强的整体表现。
实验使用匿名在线药店购买数据,包括稀疏 10-core 数据集以及由最活跃用户和购买次数最多的物品构建的稠密子集。稠密子集拥有更少的用户和物品,但每个用户的购买量更多,因此比完整数据集更不稀疏。这些数据集上的评估结果表明,分解模型优于基线,并在稀疏设置中尤其有用。稠密数据集聚焦活跃用户和热门物品,以研究稀疏性影响。稀疏转移数据使分解转移估计相比直接计数更具优势。

在稀疏数据集上,基于计数的转移矩阵非常稀疏;稠密数据集则包含比例高得多的非空条目。这种稀疏性解释了为什么分解转移估计能够优于标准计数,尤其是在稀疏数据上,因为分解可以将矩阵更稠密化并减少过拟合。即使在稠密设置中,由于使用更少参数,分解模型仍然优于基于计数的模型。标准计数在稀疏数据集上生成稀疏转移矩阵,在稠密数据集上生成稠密得多的转移矩阵。当基于计数的矩阵稀疏时,分解转移估计带来更明显的优势。在稠密情形下,由于低秩估计避免过拟合,分解模型仍优于直接计数。

实验在匿名在线药店购买数据上评估分解转移模型,使用稀疏 10-core 数据集以及聚焦活跃用户和热门物品的更稠密子集。结果表明,分解模型始终优于基于计数的基线方法,并且在转移矩阵过于稀疏、无法可靠直接估计的稀疏设置中收益最大。通过使转移估计更稠密并利用低秩建模减少过拟合,分解方法即使在更稠密数据集中仍具优势。