Command Palette
Search for a command to run...
Topic-Sensitive PageRank
Topic-Sensitive PageRank
Taher H. Haveliwala
摘要
In the original PageRank algorithm for improving the ranking of search-query results, a single PageRank vector is computed, using the link structure of the Web, to capture the relative "importance" of Web pages, independent of any particular search query. To yield more accurate search results, we propose computing a set of PageRank vectors, biased using a set of representative topics, to capture more accurately the notion of importance with respect to a particular topic. By using these (precomputed) biased PageRank vectors to generate query-specific importance scores for pages at query time, we show that we can generate more accurate rankings than with a single, generic PageRank vector. For ordinary keyword search queries, we compute the topic-sensitive PageRank scores for pages satisfying the query using the topic of the query keywords. For searches done in context (e.g., when the search query is performed by highlighting words in a Web page), we compute the topic-sensitive Page-Rank scores using the topic of the context in which the query appeared.
一句话总结
斯坦福大学的研究者提出了主题敏感 PageRank,它计算一组带有主题偏置的 PageRank 向量,而不是单个通用向量,从而得到与查询相关的重要性分数。该方法利用查询关键词或周围上下文来选择合适的偏置向量,从而获得更准确的搜索排名。
核心贡献
-
通过对 PageRank 施加代表性主题偏置,引入主题敏感 PageRank 向量,用与特定主题相关的方式建模页面重要性,而不是使用单个与查询无关的全局向量。
-
从开放目录项目类别离线生成 16 个主题敏感 PageRank 向量,然后在查询时根据查询关键词、可用用户上下文与各个主题之间的相似度,将其加权线性组合作用于查询。
-
该方法通过查询关键词或周围上下文获取主题分数,支持普通关键词搜索和基于上下文的搜索,在保持查询时开销接近普通 PageRank 的同时,比单个通用 PageRank 向量产生更准确的排名,并依靠离线预计算降低在线开销。
引言
基于链接的排名利用 Web 超链接估计页面重要性并提升搜索相关性,但页面的权威性往往取决于主题和上下文。先前方法存在成本与质量之间的权衡:HITS 能适配查询,但需要在有限的链接邻域中进行昂贵的查询时计算;全局 PageRank 高效,却忽略查询特定的权威性;更具适应性的 PageRank 变体计算和存储成本较高。作者通过预先从代表性的开放目录类别计算少量主题偏置 PageRank 向量来应对这一问题,然后在查询时将查询、用户历史或浏览上下文匹配到这些主题,并组合这些向量,以较低查询时开销获得上下文敏感的重要性分数。
方法
作者将 PageRank 作为核心链接分析框架,并通过主题条件化的个性化对其进行扩展,使页面重要性分数取决于查询的主题意图。在标准 PageRank 中,页面重要性通过链接图传播。如果页面 u 链接到页面 v,那么 u 会将其部分重要性转移给 v。若 Nu 表示页面 u 的出度,Rank(u) 表示页面 u 的 PageRank 值,则算法的一次迭代将页面 v 的分数更新为
Ranki+1(v)=u∈Bv∑NuRanki(u),其中 Bv 是指向 v 的页面集合。这个迭代过程可以表示为对 Web 图的随机转移矩阵 M 的特征向量计算:
Rank=M×Rank.实践中会引入阻尼向量 p,以保证收敛并降低 rank sink 的影响。带阻尼的公式为
Rank=(1−α)M×Rank+αp,其中 α 控制个性化向量 p 的强度。若 p 是均匀分布,则退化为普通 PageRank。所提方法的主要设计选择是用非均匀的、主题特定的个性化向量替换均匀 p。
整体流程将计算划分为离线预处理阶段和在线查询时阶段。在离线预处理阶段,作者定义一组基础主题,这里取自开放目录分类法的顶层类别。每个基础主题对应一组人工组织的 URL。对于主题 cj,令 Tj 表示该主题下列出的 URL 集合。作者通过将概率质量均匀分配给 Tj 中的页面并将其他页面的概率设为零,构造主题特定的个性化向量 vj:
vji={∣Tj∣10if i∈Tj,if i∈/Tj.将这个向量代入带阻尼的 PageRank 方程,得到一个主题偏置 PageRank 向量,记作
PR(α,vj).因此,离线模块为每个基础主题计算一个偏置 PageRank 向量。这些向量不是通过对单个全局 PageRank 向量进行后处理得到的。相反,主题信息被直接注入迭代式排名传播过程中,因此与某个主题关联文档强连接的页面会在该主题特定排名下获得放大后的重要性。
作者并行计算基础主题的主题语言模型统计量。对于每个主题 cj,他们构造词项向量 Dj,其中 Djt 记录词项 t 在该主题关联文档中的总出现次数。该统计量稍后用于估计查询或查询上下文的主题亲和度。
在查询时,系统将预计算的主题敏感 PageRank 向量组合成单个查询敏感重要性分数。输入为查询 q,可选地附加上下文信息 q′。例如,如果用户在 Web 页面中高亮某个词项后发起查询,则上下文 q′ 可以包含该页面中的词项。如果没有额外上下文,则 q′=q。
在线模块首先估计查询上下文属于每个基础主题的概率。使用带最大似然估计的一元语言模型,主题后验概率计算为
P(cj∣q′)∝P(cj)i∏P(qi′∣cj).词项概率 P(qi′∣cj) 由对应的主题词项向量 Dj 推导得到。在先验 P(cj) 上,通用检索中可采用均匀先验,但作者指出也可以使用反映用户 k 兴趣的用户特定先验 Pk(cj) 对其进行个性化。
在估计这些主题权重后,系统使用文本索引检索与原始查询词项匹配的候选文档。对于每个检索到的文档 d,系统查找其在每个预计算主题敏感 PageRank 向量中的分数。令 rankjd 表示文档 d 在主题 cj 下的 PageRank 分数。文档 d 的最终查询敏感重要性分数为加权和
sqd=j∑P(cj∣q′)⋅rankjd.然后结果列表按 sqd 排序。这个综合分数偏好既与查询文本相关、又与根据查询上下文推断出的主题结构上重要的页面。
主题特定 PageRank 向量的线性组合具有有用的等价解释。如果权重 wj 满足 ∑jwj=1,则
j∑[wjPR(α,vj)]=PR(α,j∑[wjvj]).因此,在查询时对已经计算好的主题敏感 PageRank 向量进行混合,等价于计算一个 PageRank 向量,其个性化向量是主题特定个性化向量的相应混合。这使该方法拥有高效架构:昂贵的 PageRank 计算针对固定一组基础主题离线完成,在线阶段只需要估计主题权重并组合已保存的分数。
所得计算也可以通过随机漫游者模型理解。以概率 1−α,漫游者均匀选择一条出站链接。以概率 α,漫游者跳转到根据混合个性化向量选择的页面。如果主题权重设为 wj=P(cj∣q′),那么漫游者以概率 αP(cj∣q′) 跳转到主题 cj,并在该主题内从 Tj 中均匀选择一个页面。在该修改后的随机游走下,页面的长期访问概率正是查询敏感排名公式生成的综合分数。
该框架还支持多种上下文来源。上下文可以来自包含高亮查询词项的页面,来自用户最近的查询历史,来自正在浏览的目录类别,或来自更长期的用户信号,如书签或浏览模式。系统不直接根据这些信号构造原始个性化向量,而是将每个上下文转换为对基础主题的权重。这种中介式表征带来若干设计优势:系统能够统一处理不同种类的上下文,主题权重保持可解释,并且涉及隐私的上下文可以在发送到服务器之前先在本地汇总为主题权重。
离线组件的一种可能改进是,在定义主题个性化时避免只依赖人工选择的页面。相反,可以在基础主题数据上训练分类器,为 Web 中的页面分配主题权重。若 wij 表示页面 i 对主题 cj 的权重,则主题特定个性化向量可以定义为
vji=∑kwkjwij.这使主题敏感 PageRank 计算不太依赖于每个主题所分配 URL 的精确集合,并且可能对原始主题数据中特有的判断具有更强的稳健性。
实验
使用大规模 Web 抓取和测试查询的实验通过排名相似性度量和用户研究来评估主题敏感 PageRank。结果表明,不同主题偏置排名向量产生的排名差异显著,而只要偏置因子选择合理,其影响有限。基于最相关主题的查询敏感打分比普通 PageRank 获得更好的用户偏好和精确率,而使用页面上下文可以进一步消歧查询词并选择合适的主题向量。
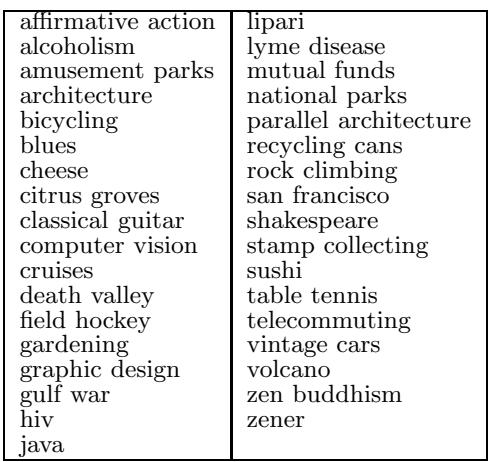
表格列出用于评估主题敏感 PageRank 的示例查询,覆盖艺术、健康、体育、旅行和技术等多样主题。周围结果表明,对于这些查询,主题敏感排名比普通 PageRank 产生更相关的搜索结果。查询集合涵盖许多不同学科领域,支持在多样搜索需求下测试主题敏感排名。与无偏 PageRank 相比,主题敏感 PageRank 表现出更好的检索效果和更强的用户偏好。
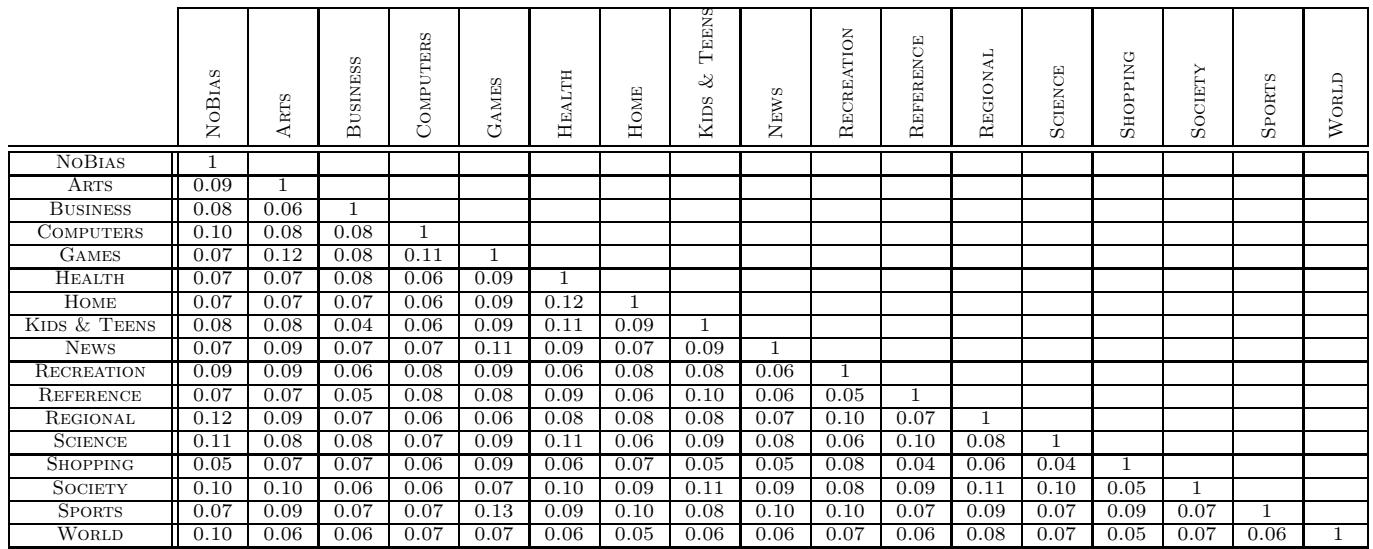
比较表明,由主题偏置 PageRank 向量诱导出的排名彼此差异很大。使用不同主题偏置构建的排名之间的成对相似度很低且接近零。这表明所选主题向量强烈影响哪些 URL 排名靠前以及结果列表如何排序。不同主题偏置排名之间的重叠很少。无偏 PageRank 排名与主题偏置排名之间也呈现低一致性。主题偏置导致显著不同的相对排序,而不仅仅是微小的排名变化。
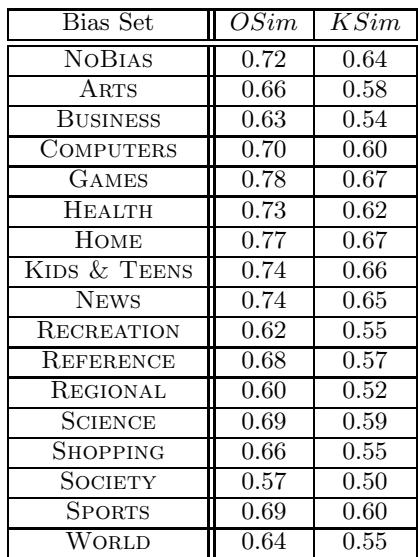
该表比较了将 PageRank 偏置因子从小值改为中等值时的排名相似性。在各偏置集合上,头部结果重叠度和排名一致性都保持较高,表明排名对该参数选择相对不敏感。因此,偏置因子造成的差异远小于使用不同主题偏置向量造成的差异。两种偏置因子设置诱导出的排名在各偏置集合间表现出高度重叠。KSim 值显示,头部结果的相对排序总体一致性较好。Games、Home 和 Health 在偏置因子变化时表现出最强稳定性。Arts 和 Business 表现出略低于其他偏置集合的一致性。
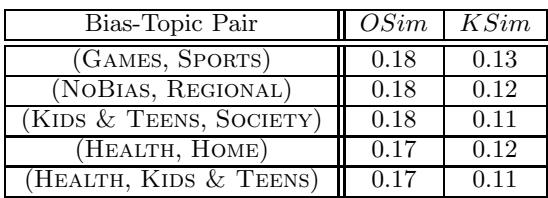
若干主题对表现出明显相似的排名行为,表明相关领域可能诱导相似的结果排序。Games 和 Sports,以及 Health 与 Home 或 Kids and Teens 等主题对,出现在最相似的主题对中,而无偏排名也与某个区域主题高度一致。两种相似度度量给出了大体一致的结论,但它们的分数在幅度上并不总是匹配。Games 和 Sports 在两种度量下都构成最相似的主题对之一。Health 相关排名与 Home 和 Kids and Teens 排名均表现出相似性。无偏排名与区域主题排名高度一致。两种相似度度量识别出了一组相似的紧密相关主题对。
对于查询 bicycling,示例排名显示,所选主题敏感 PageRank 向量强烈改变了头部结果。Sports 偏置向量被描述为产生高质量排名,而 Shopping 偏置向量强调与自行车相关的配件网站。这表明主题偏置可以将搜索结果导向同一查询的不同解释。对于查询 bicycling,主题偏置 PageRank 向量产生不同头部结果。Sports 偏置排名针对该查询被评价为高质量。Shopping 偏置排名推广与自行车相关的配件网站。
实验使用覆盖艺术、健康、体育、旅行和技术等主题的多样查询集来评估主题敏感 PageRank。结果表明,所选主题偏置强烈重塑排名,产生比普通 PageRank 更相关、更受偏好的结果。额外比较表明,相关主题产生更相似的排名,而改变 PageRank 偏置因子仅产生轻微影响。