Command Palette
Search for a command to run...
缓存驱逐中懒惰晋升机制的解析与改进
缓存驱逐中懒惰晋升机制的解析与改进
Qinghan Chen Zhuofan Chen Muhammad Haekal Muhyidin Rashmi Vinayak Ziyue Qiu Juncheng Yang
摘要
缓存驱逐算法在现代数据系统的性能中起着关键作用,但对象晋升带来的高计算开销往往限制了其可扩展性。懒惰晋升技术作为传统最近最少使用(LRU)方法的放松形式应运而生,旨在缓解锁竞争并提高吞吐量。本文利用真实系统的生产环境负载对五种懒惰晋升策略进行基准测试:Probabilistic-LRU、Batch-LRU、Delay-LRU、FIFO 重插入和 Random-LRU。我们从缺失率、可扩展性、晋升次数以及一个称为晋升效率的新指标(衡量每次晋升带来的命中次数)等方面对这些技术进行评估。实验结果表明,Delay-LRU 和 FIFO 重插入能显著提升晋升效率,而 Batch-LRU 和 Probabilistic-LRU 难以在不显著增加缺失率的前提下减少晋升。我们进一步探索了懒惰晋升在 ARC 和 2Q 等高级算法中的影响,并得出了类似结论。此外,我们发现存在可观的优化空间:在具备预言机知识的情况下,大多数缓存晋升是不必要的。为进一步减少 LRU 中的晋升,我们提出两种新型增强方案——延迟 FIFO 重插入(D-FR)和年龄引导驱逐(AGE),可将晋升次数减少 20%—60%,同时实现相近或更低的缺失率。
一句话总结
卡内基梅隆大学、Al-Araby Sepuluh Nopember Institute of Technology 与哈佛大学在生产 trace 上基准测试了五种 Lazy Promotion 策略,引入衡量每次晋升命中数的晋升效率指标,并提出两项新增强方法:Delayed FIFO-reinsertion 和 Age-Guided Eviction,可在维持可比未命中率的同时将缓存晋升减少 20–60%。
核心贡献
-
在 6,357 条生产 trace 上基准测试 Probabilistic-LRU、Batch-LRU、Delay-LRU、FIFO-reinsertion 和 Random-LRU,指标包括未命中率、可扩展性、晋升次数和晋升效率。Delay-LRU 和 FIFO-reinsertion 对晋升效率的提升超过 Batch-LRU 和 Probabilistic-LRU,类似观察也适用于 ARC 和 2Q。
-
基于 oracle 知识的分析发现,大多数缓存晋升是不必要的,这揭示了在保持未命中率的同时减少晋升操作的机会。
-
为 LRU 引入 Delayed FIFO-reinsertion 和 Age-Guided Eviction,将晋升次数减少 20-60%,同时实现相似或更低的未命中率。
引言
缓存是数据库、操作系统和内容分发网络的核心,因为将热门数据放置在离用户更近的位置可以降低延迟和后端负载。然而,最常见的最高效淘汰算法 LRU 依赖需要加锁的晋升,这会在多核服务器上造成可扩展性瓶颈。生产系统已经采用 lazy promotion 变体来减少锁竞争,但这些技术一直缺乏系统化评估,以判断它们是否保持未命中率以及哪些技术真正有用。作者利用数千条生产 trace 基准测试五种真实世界 lazy promotion 策略,引入晋升效率指标,并表明 Delay-LRU 和 FIFO-reinsertion 可以保持接近 LRU 的未命中率,同时大幅减少晋升。此外,大多数 LRU 晋升是不必要的,作者提出两种轻量级方法 D-FR 和 AGE,可去除许多低价值晋升,且不损害缓存效率。
数据集
-
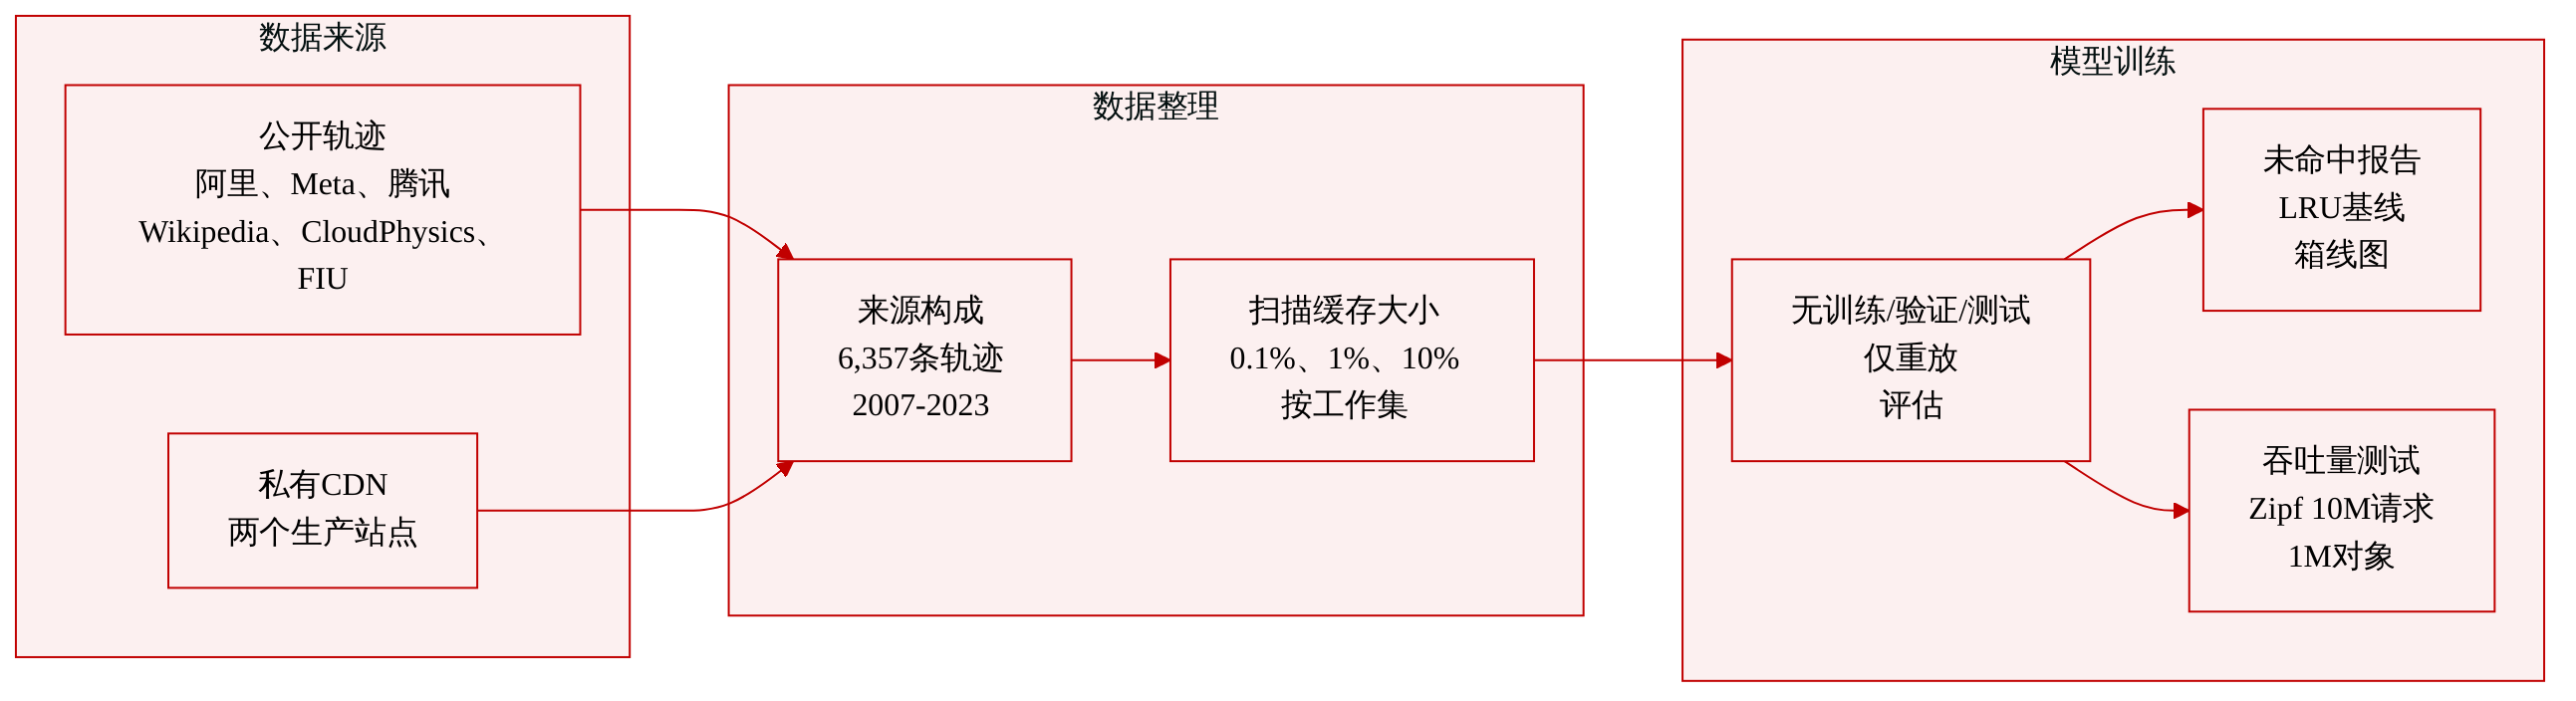
作者使用大规模真实世界缓存 trace 数据集来评估 lazy promotion 技术。trace 数据和源代码通过论文 artifact 发布在 https://github.com/cacheMon/Lazy-Promotions。
-
该数据集由 2007 年至 2023 年间在多个公开和私有生产环境中收集的 trace 汇总而成,包括 Alibaba、CloudPhysics、FIU、Meta、Tencent、Wikipedia 和两家私有 CDN 服务公司的数据。
-
trace 覆盖多种缓存负载,包括 key-value 缓存、block 缓存和 object 缓存。总计数据集包含 6,357 条 trace、3460 亿请求、250 亿唯一对象、16,625 TB 流量和 2,818 TB 数据。
-
给定文本未提供逐来源细节,例如每个子集的 trace 数量、请求量、流量大小或时间范围。这些详细的子集级统计汇总于论文表 2。
-
作者不将这些 trace 用作监督训练数据,也不划分为训练集和测试集。相反,trace 通过 libCacheSim 作为评估负载回放,以测量不同 lazy promotion 策略的未命中率行为。
-
对于未命中率评估,作者回放真实世界 trace,并缓存大小设置为 trace 工作集大小的 0.1%、1% 和 10%,其中工作集大小是 trace 中唯一对象总数。
-
由于真实世界 trace 的访问模式差异很大,相同缓存大小百分比下的未命中率也会广泛变化,从低于 1% 到高于 80% 不等。作者使用 LRU 作为基线,并将被评估技术的相对未命中率报告为 miss_A / miss_LRU。
-
在未命中率报告中,作者使用箱线图跨 trace 集合汇总结果。箱体显示第 25 和第 75 百分位,触须显示第 10 和第 90 百分位。
-
对于吞吐量和可扩展性分析,作者不回放全部 6,357 条真实世界 trace,因为这会需要超过一年,而并行测量可能引入干扰。相反,作者构造一条合成 Zipfian trace,包含 1000 万请求、100 万唯一对象和偏度参数 1.0。
-
合成 Zipfian 子集用作受控性能基准,用于近似真实缓存负载中观察到的访问偏斜。作者在不同技术间调整缓存大小,使所有评估方法在比较吞吐量前达到可比的未命中率。
-
论文未描述 trace 裁剪、去重、基于对象元数据的过滤,或构建超出 trace 已有负载属性的新元数据字段。展示的处理细节仅包括 trace 回放、相对于工作集大小的缓存大小归一化、基于基线的相对未命中率计算,以及使用合成 trace 替代完整真实世界回放以进行可扩展性测量。
方法
作者设计了一种晋升感知的缓存架构,将对象访问记账与昂贵的排名更新分离。其解决的核心问题是:传统 LRU 式晋升在每次缓存命中时修改共享元数据,这会造成锁开销,并限制并发负载下的可扩展性。为缓解这一问题,该系统用延迟晋升、淘汰时重新插入或过滤式重新插入替代即时逐次命中晋升,同时保留足够的最近性和频率信息以维持较低未命中率。
从高层视角看,该方法可以视为一组可互换模块,它们控制被访问对象何时以及是否会在缓存替换顺序中获得提升。Batch-LRU 缓冲被请求对象标识符,并周期性地执行晋升。如果请求对象标识符为 8 字节,128 个标识符的批次仅使用约 1 KB 额外内存。批量晋升的频率由批次比控制,批次比相对于缓存大小定义。批次比为 0.1 意味着大约经过 0.1 倍缓存大小的插入后发生一次批量晋升。该机制将针对热门对象的多次访问合并为更少晋升操作,因此在许多访问集中在少量热门对象上的偏斜负载中,能更有效地减少竞争。
Delay-LRU 采取不同路径,抑制在先前晋升后过快发生的晋升。每个对象存储一个小时间戳,只有当自对象上次晋升以来已经过足够多次插入时,缓存命中才会触发晋升。延迟以延迟比参数化,定义为延迟间隔除以缓存大小。由于许多晋升发生在对同一对象先前请求后不久,延迟这些晋升可以去除冗余晋升流量,同时只增加很少的未命中惩罚。当晋升对于已经热门的对象仅提供较小排序收益时,这种方法尤其有效。
FIFO-reinsertion 将晋升决策从缓存命中时间转移到缓存淘汰时间。对象保持在一个 FIFO 队列中,命中时不改变顺序。每个对象维护一个受限频率计数器。在命中时,计数器加一,最多达到由计数器位数确定的上限。在淘汰时,如果计数器大于零,则将对象重新插入缓存,并将计数器减一。如果计数器为零,则淘汰对象。该设计将重新插入计为晋升,并且当频率上限较小时,通常会最大程度减少晋升开销。该方法在许多情况下也相对 LRU 改善缓存效率,因为它避免立即丢弃已表现出一定流行度的对象,同时仍保持队列简单,并避免每次命中时执行昂贵的晋升。
Random-LRU 被视为一种与可扩展性相关的替代方案,而非 lazy promotion 技术。它在淘汰期间采样对象,并淘汰最近最少使用的样本。由于它不维护全局链表,也不需要在缓存命中时加锁,因此改善了并发性能。然而,如果样本大小太小,它可能损害缓存效率。使用一个样本会退化为随机淘汰,而增加样本大小会降低吞吐量。中等数量样本可在可扩展性和未命中率之间提供权衡。
作者随后将未来信息作为分析工具,以确定从根本上需要多少晋升。它们将对象 o 的 reuse distance 定义为 R(o),即距离其下一次访问的请求数。平均淘汰年龄近似为
S≈miss ratiocache size.在具备 oracle 知识时,如果满足下列条件,对象可以被提前淘汰:
R(o)>α⋅S,其中 α 是容差因子。关键洞见是:为淘汰而对缓存对象排序通常是不必要的。如果一个二进制信号可以确定对象是否会在自然被淘汰前被请求,系统就可以主动移除冷对象,而无需维护精确的 LRU 顺序。这表明强未来预测可以支持更激进的 lazy promotion 策略。
基于这一 oracle 分析,作者设计 FIFO-reinsertion 的离线版本。该版本在 trace 上运行多次迭代。在第一次迭代中,其行为像标准 FIFO-reinsertion,并标记不会带来未来缓存命中的重新插入。在后续迭代中,这些被标记的晋升会被省略。这种 oracle 引导的过滤去除不会促成缓存命中的晋升,表明许多晋升可以被消除,而不会损害缓存效率,有时甚至能改善缓存效率。
从这些洞见派生出的实际方法是 Delayed FIFO-reinsertion,即 D-FR。D-FR 将延迟过滤与淘汰时重新插入相结合。它使用小时间戳跟踪每个对象的最近访问时间和插入时间,通常每个对象 4 字节。在缓存命中时,如果当前访问落在延迟时间阈值内,则频率计数器不递增。延迟比控制该阈值。通过抑制聚簇命中的频率递增,D-FR 防止缓存过度奖励在短时间窗口内被反复访问的对象。在淘汰时,D-FR 仍使用频率计数器决定是重新插入还是淘汰对象。由于决策发生在淘汰时,此时可获得更多信息,并且由于避免了许多元数据更新,D-FR 相对 FIFO-reinsertion 可以减少晋升次数并提高吞吐量。
Age-Guided Eviction,即 AGE,是一种构建在 FIFO-reinsertion 上的互补过滤机制。AGE 不仅依赖频率,还考虑对象年龄。如果自对象最近访问以来的时间超过阈值,则将该对象视为不太可能收到未来请求,并且在淘汰时不对其进行晋升。该阈值来自相同的近似淘汰年龄估计器:
S≈mC,其中 C 是缓存大小,m 是未命中率。在给定容差因子 α 的情况下,当对象年龄 t(o) 满足下列条件时,AGE 可以跳过晋升:
t(o)>α⋅S.该模块通过过滤掉不频繁或已陈旧对象的重新插入来减少晋升,但取决于负载,它相比 D-FR 可能增加未命中率。
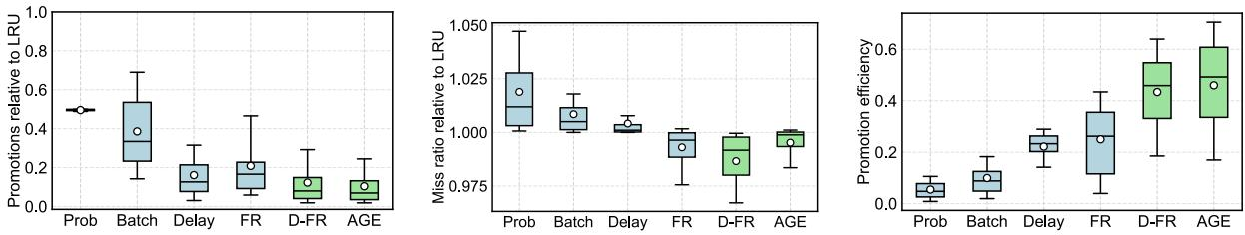
当 D-FR 和 AGE 与较早的减少晋升设计比较时,二者都能在保持有竞争力未命中率的同时显著减少晋升量。各技术的相对有效性取决于晋升被过滤的力度,以及负载如何在热门对象和冷对象之间分配访问。如下图所示:
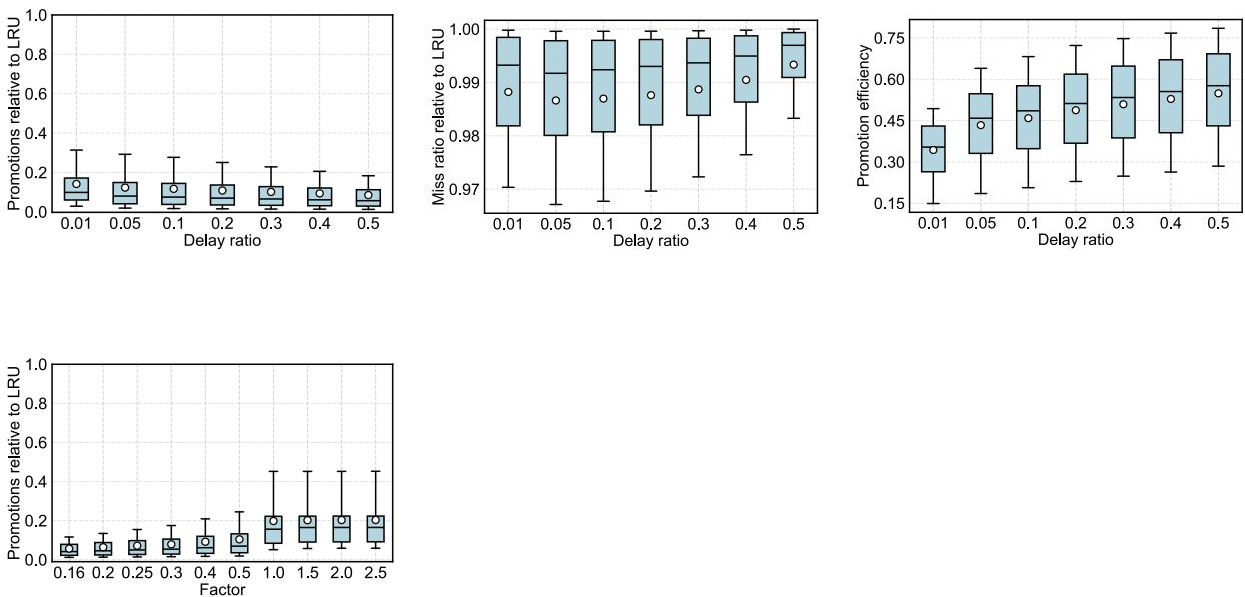
D-FR 的参数敏感性对设计也很重要。D-FR 在实际范围内相对能够稳健应对延迟比变化。增加延迟比往往进一步减少晋升,同时对未命中率影响温和。这种行为与更简单的延迟晋升方案形成对比,在后者中较大延迟可能更明显地损害效率。D-FR 在不同延迟比下的稳定性支持将其作为实际 lazy promotion 机制使用。 延迟比敏感性如下图所示:
实验
评估回放多样化真实世界缓存 trace,并使用受控合成负载比较 LRU 和若干 lazy promotion 变体,测量未命中率、可扩展性、晋升次数和晋升效率。这些实验表明,随机晋升和批量晋升要么损害未命中率,要么严重依赖负载偏斜,而基于延迟和基于重新插入的方法更能避免低价值晋升并保持缓存效率。对先进淘汰策略的额外测试显示相同晋升瓶颈,并且 oracle 引导分析表明淘汰时决策可使传统基于排序的晋升在很大程度变得不必要。
所列 lazy promotion 技术通过放宽严格 LRU 晋升来减少锁竞争并改善可扩展性,同时保持有竞争力的未命中率。它们的区别在于跳过近期或概率性晋升、批量更新、将晋升决策推迟到淘汰,或使用随机采样替代维护完全有序列表。Delay-LRU 跳过近期晋升,以避免晋升在短时间窗口内被多次命中的对象。Probabilistic-LRU 在锁不可用时绕过晋升,从而在高并发下减少竞争。Batch-LRU 在固定区间内组合晋升,以减少昂贵锁操作的数量。FIFO-reinsertion 将晋升决策推迟到淘汰时,使替换决策获得更多信息。Random-LRU 采样淘汰候选并使用权最近访问时间,避免在命中时维护列表。
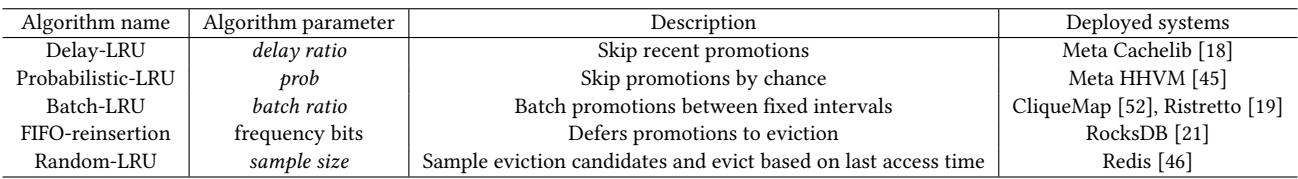
数据集集合包括来自多个年份、公开和私有来源的大量真实世界 block 和 object 缓存 trace。它覆盖数据库、CDN、照片服务和其他生产系统的负载,规模足以在差异极大的工作集上评估缓存行为。数据集描述还指出,较旧 trace 会被过滤,仅保留至少有一百万请求的负载。基准测试依赖来自许多真实世界来源的 block 和 object 缓存 trace 的多样组合。trace 集合覆盖较早和较新的生产环境,具有非常大的请求数量和 TB 级流量。
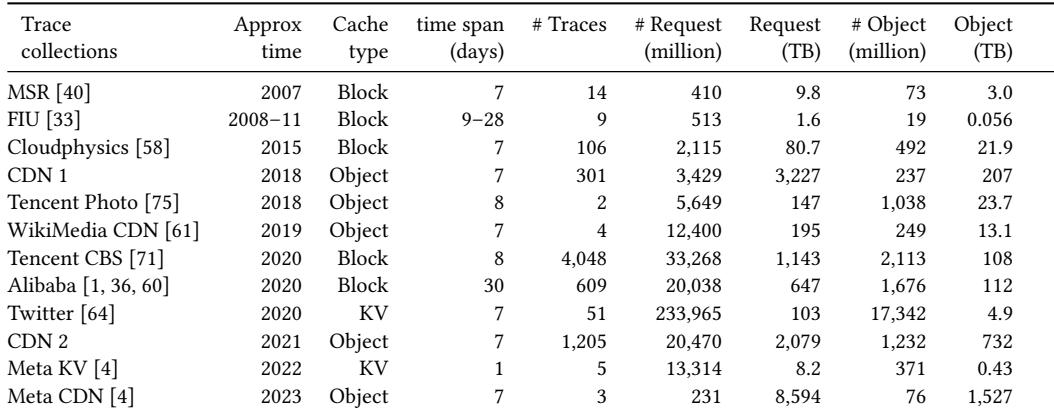
实验在来自数据库、CDN、照片服务和其他生产系统的大规模且多样化的真实世界 block 和 object 缓存 trace 集合上评估 lazy LRU 晋升技术。它们检验宽松晋升是否能在保持有竞争力未命中率的同时减少锁竞争并改善可扩展性。结果支持一个定性结论:不同 lazy promotion 策略,例如跳过近期命中、绕过不可用锁、批量更新、将决策推迟到淘汰或采样候选,可以在现实缓存负载上实现有利的性能权衡。