Command Palette
Search for a command to run...
分析数据库中标量函数的可扩展 GPU 加速:编译、基准测试与优化
分析数据库中标量函数的可扩展 GPU 加速:编译、基准测试与优化
Kaushik Rajan Sampath Rajendra Momin Al-Ghosien Nicolas Bruno Carlo Curino Matteo Interlandi Yinan Li Lukas M. Maas Craig Peeper Surajit Chaudhuri Johannes Gehrke
摘要
利用 GPU 加速 SQL 查询执行是数据库研究的核心方向之一。尽管已有系统通过将关系算子卸载至 GPU 取得了显著的性能提升,但对分析引擎所支持的大量标量函数的加速问题仍未得到解决。我们的分析表明,许多标量函数会产生大量计算开销,在 CPU 上的分析查询中往往构成主要瓶颈。这一观察促使我们系统性地探索在 GPU 上加速标量函数的机遇与挑战。与数量有限且标准化的关系算子不同,生产级数据库支持数百种标量函数。缺乏标准化规范,加之种类多样,使得人工 GPU 移植不可行。为此,我们提出了一种基于 LLVM-MLIR 的编译器工具链,能够自动将生产级数据库中基于 CPU 实现的标量函数转换为高效的 GPU 核函数,同时保持其原始语义。我们的方法将标量函数提升到高层中间表示,应用资源优化变换,并生成 GPU 汇编代码,支持所有相关的数据类型、参数和数据库上下文变量。由于现有基准测试未能充分对分析查询中的标量函数进行压力测试,我们引入了 TPC-H 的一个变体,在保持原始查询意图的同时利用标量函数。将生成的 GPU 核函数集成到最先进的 GPU 数据库系统中,我们展示了相较于使用稍昂贵硬件的领先 CPU 数据库的显著性能提升:在增强版 TPC-H 上达到 7.6×,在生产查询上达到 6.4×,进一步扩大了 GPU 数据库与 CPU 数据库之间的性能差距。生成的核函数性能可与手工优化的 GPU 实现相媲美,确立了我们的方法作为 GPU 上标量函数加速的可扩展且实用的解决方案。
一句话总结
Microsoft 展示了基于 LLVM-MLIR 的编译器工具链,自动将生产数据库中的数百个基于 CPU 的标量函数转换为高效 GPU kernel,方法是将它们提升到高层中间表示并应用资源优化变换,从而在增强型 TPC-H 和生产查询上相对领先的 CPU 数据库分别实现 7.6× 和 6.4× 加速。
核心贡献
-
对数据库标量函数的经验性 roofline 分析表明,简单算术和转换操作受内存带宽限制,而大多数其他标量函数受计算限制,因此它们非常适合通过 GPU 加速。
-
基于 LLVM-MLIR 的编译器工具链会自动将生产数据库中的 CPU 标量函数实现转换为 GPU kernel,同时保留原有语义;该工具链将代码提升到 MLIR,应用资源优化变换,并针对相关数据类型、参数和数据库上下文变量生成 GPU 汇编。
-
一种 TPC-H 变体在保留原始查询意图的同时对标量函数施压,并集成到 GPU 数据库中;在硬件成本略高的情况下,相比领先的 CPU 数据库,在增强型 TPC-H 上取得 7.6x 加速,在生产查询上取得 6.4x 加速,且生成的 kernel 可与手工优化的 GPU 实现相媲美。
引言
分析型数据库查询通常使用标量 SQL 函数进行字符串处理、日期运算、类型转换和数值计算,而论文表明这些函数在生产负载中频繁出现,并且可能占据 CPU 查询时间的很大份额。先前的 GPU 数据库工作主要加速关系算子,而标量函数仍然困难,因为它们的数量可达数百,具有厂商特定语义,并且经常迫使通过 PCIe 执行开销高昂的 GPU 到 CPU 回退。作者利用 LLVM MLIR 将 SQL Server 中现有 C++ 标量函数实现转换为优化后的 GPU kernel,并增加了 TPC-H-scalar,这是一个反映真实标量函数使用情况的基准套件。作者将这些 kernel 集成到 GPU 数据库中,并展示了相比高端 CPU 系统取得的显著端到端加速。
数据集
-
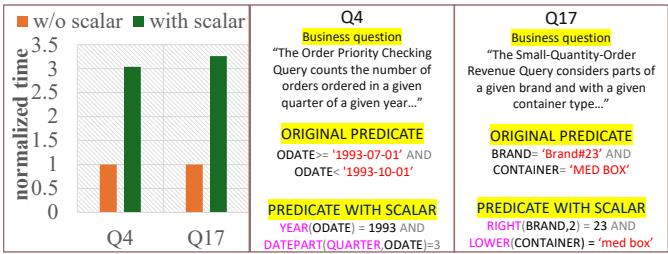
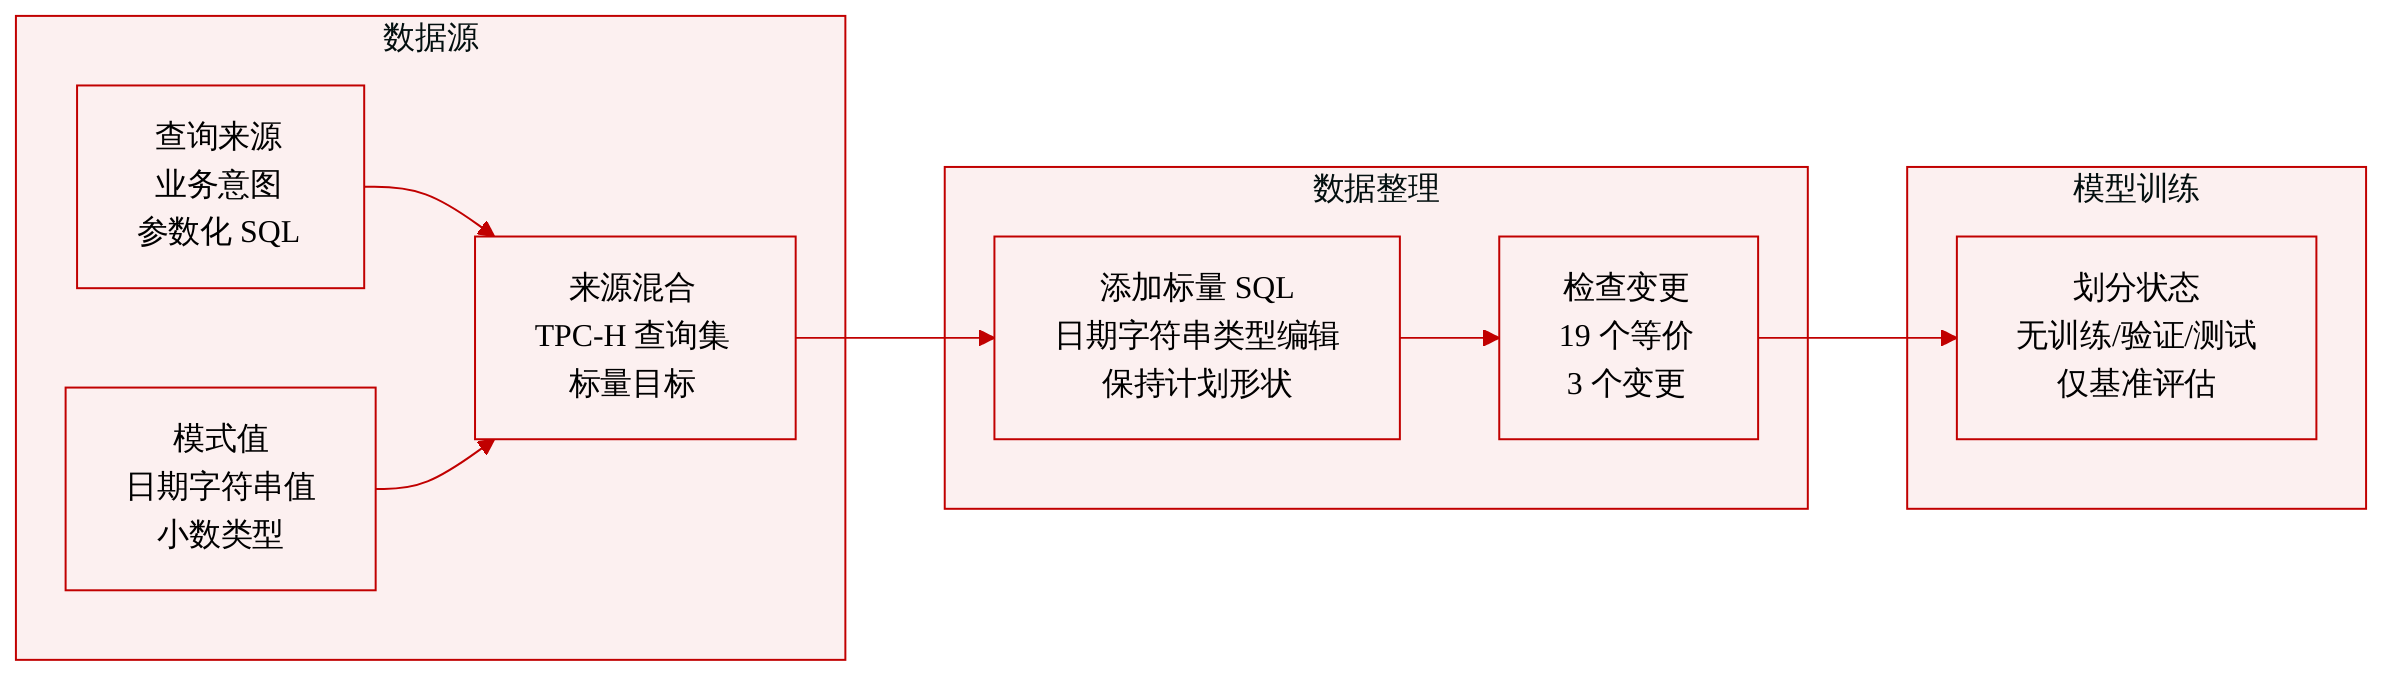
作者使用 TPC-H 作为源基准数据集。每个查询用一个业务问题、一个功能性 SQL 定义和替换参数来表示,随后通过向投影和过滤中注入标量函数构建 TPC-H-scalar。
-
所得基准负载用于评估标量函数处理,而非作为模型训练语料。提供的文本除基准查询定义和参数规则外,未定义训练划分、混合比例、裁剪或其他元数据。
-
作者应用严格的筛选和保留规则:仅通过替换投影或过滤表达式添加标量函数,同时保留高层分析意图。保留计划形态和基数,使修改后的查询保持原始关系算子的性能特征。
-
在基准中,19 条查询仍与原始 TPC-H 查询等价,且仅有 3 条查询不等价。相关 schema 包括 date 列,如 l_shipdate、o_orderdate 和 l_receiptdate;string 列,如 p_type、o_orderpriority 和 p_brand;电话字符串;以及 decimal 列,如 l_discount 和 l_tax。原始 TPC-H 数据具有固定精度 decimal 列并且没有 float 列,而修改后的查询会在算术表达式中引入 float 常量。
-
C1,日期部分提取:九条查询被修改为对 date 列应用 YEAR 和 DATEPART 等标量日期函数,并将结果与数值 year、month 或 quarter 参数进行比较,而不是使用数据库特定的日期字符串。
-
C2,比较前的字符串规范化:字符串相等谓词被重写为在比较常量前使用 LOWER 等函数规范化值,反映生产中大小写或标点可能不同的情形。
-
C3,类型转换:两个查询被修改为使用 CONVERT 格式化 date 输出。使用 l_discount 或 l_tax 的其他表达式会乘以 float 常量并转换为 decimal 或 money 类型,以模拟生产风格精确算术和货币转换。
-
C4,提取或验证字符串的部分内容:对带有内嵌数字部分的字符串进行过滤的查询,例如订单优先级、品牌标识符或电话国家代码,被重写为使用 RIGHT、LEFT 或类似 SUBSTRING 的逻辑等字符串提取函数,并将提取出的值与参数比较。
-
C5,日期运算:三个查询被重写为在比较或组合 date 列时使用 DATEADD 或 DATEDIFF。这些是唯一不等价的查询,并且调整了过滤条件以保持相近的谓词选择性。
方法
编译器架构与代码生成流水线
作者利用 MLIR 作为编译现有 C++ 标量数据库函数并生成 GPU kernel 的核心中间表示。输入并不是手写的 kernel,而是标量函数的原始实现,以及所有传递引用的函数。标准 C++ 前端首先解析模板、重载选择和多态,Polygeist 编译器将由此得到的 C++ AST 翻译为 MLIR。在这种表示中,类被变为 struct 类型,成员函数被映射到 func 操作,内存访问通过 memref 操作表达,标量计算使用 arith 操作,常见数学或内存 intrinsic 被映射到现有 MLIR 方言。生成的 IR 处于 Static Single Assignment 形式,每个值仅被赋值一次,这为分析和变换提供了稳定的类型化表示。
在高层面上,编译工作流包含四个主要阶段:前端翻译、高层简化、循环重构和 GPU 下降。作者使用由大约 50 个优化和下降 pass 组成的编译器,其中包括专门针对编译数据库标量函数时出现模式的自定义 pass。初始 MLIR 可能很大且低效,因为 C++ 类通常包含许多字段,而特定函数仅需要其中一部分,并且循环或函数的提前退出会在 IR 中生成冗余分支、load 和 store。因此,编译器在高层方言阶段应用聚合体的标量替换、store-load 转发、常量传播、公共子表达式消除、分支消除和窥孔优化。聚合体的标量替换会将 struct 和 class 分配分解为单独的标量字段,使后续分析能够判断每个字段是被写入、被读取、被常量更新,还是未被使用。这使得程序在下降到更特定于目标的表示之前,可以移除不必要字段和控制流。如下图所示:
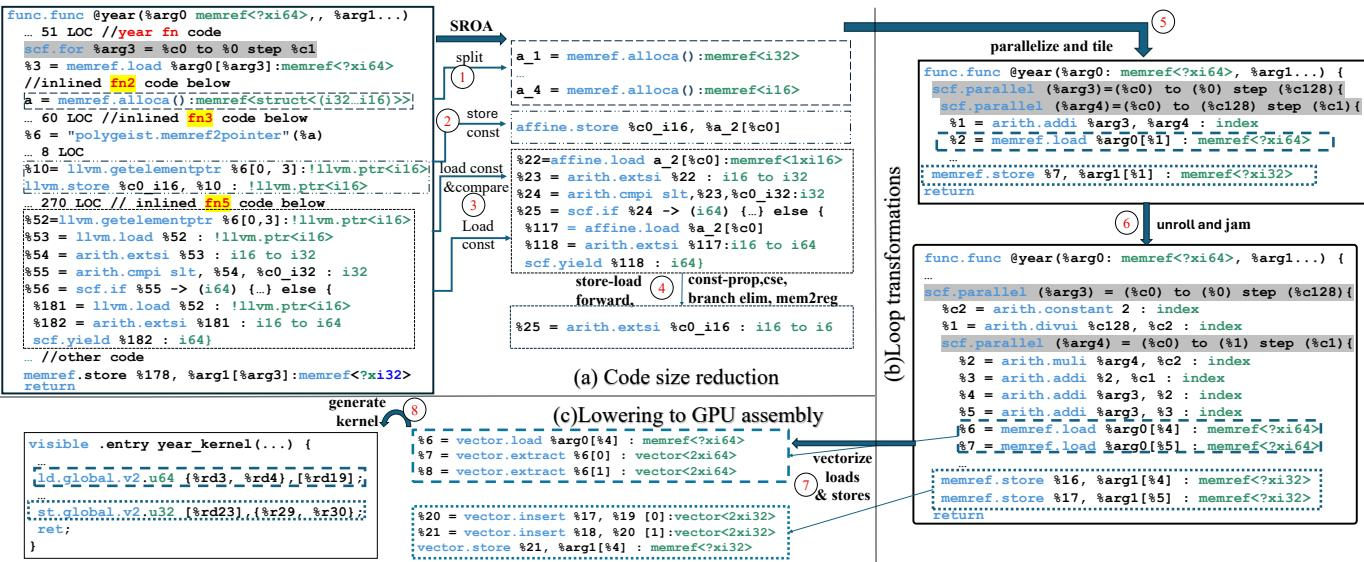
在简化之后,编译器将串行循环转换为与 GPU 线程层级结构对齐的分块并行循环。这些循环分块随后经过 unroll and jam 变换处理,从而增加每个线程在一次 kernel 调用中执行的工作量。这种线程粗化降低了线程块和 warp 调度开销,提高了已加载值的复用,并暴露连续内存访问。一旦这些访问变得可见,编译器就使用 vector 方言将它们转换为向量 load 和 store。目标是让最终 GPU kernel 发出宽硬件内存指令,例如在单条指令中获取两个 64 位值的 load。这一点尤其重要,因为目标执行模型处理列向量而不是单独的标量行,因此内存访问效率对吞吐量有强烈影响。
在 GPU 下降阶段,分块后的循环体被提取成 gpu.func kernel。循环索引被替换为从 GPU 块标识符和线程标识符推导每个线程索引的表达式。在此阶段,编译器小心地将常量下沉到 kernel 体中,而不是将其作为 kernel 参数传递。将常量保留在 kernel 本地,可使后续下降 pass 针对已知常量值特化生成代码,从而移除分支、简化地址计算并产生更高效指令序列。kernel 内剩余的方言随后下降到 LLVM IR,LLVM 的代码生成器发出 GPU 汇编。在生成的 kernel 中,向量化 load 和 store 表现为原生宽内存操作,减少指令数量并提高带宽利用率。
该流水线还包括离线自动调优和预编译。由于支持的标量函数集合可以事先确定,kernel 可以在系统构建过程中生成,并在运行时复用。编译器通过一个自动调优器增强其循环优化策略,该自动调优器会扫描两个关键参数:循环分块大小和展开因子。候选配置包括:
t∈{64,128,…,1024},u∈{1,2,4}.对于每个标量函数,自动调优器会在代表性输入上对生成的 kernel 变体进行基准测试,并选择使执行时间最短的配置:
(t∗,u∗)=argt,uminLatency(kernelt,u).选定后的预编译 kernel 随系统一起存储,并在查询执行遇到相应标量算子时动态加载。
该编译器通过查询优化器、tensor 抽象层和 runtime 的扩展集成到 tensor 查询处理引擎中。优化器识别包含标量算子的 GPU 支持子计划,从而允许将这些算子卸载到加速器。tensor 抽象层暴露了额外的算子,这些算子可基于 tensor 输入和输出调用预编译 kernel。输入表以压缩列式格式传输到 GPU 以减少数据搬运,然后在 kernel 执行前解压为一维 tensor。每个算子消费输入 tensor 并生成输出 tensor。
字符串列需要专门的 GPU 表示,因为处理字符串的标量函数通常期望不同于列式 tensor 格式的内存布局。因此 runtime 将字符串向量表示为三个 tensor:一个用于字符串数据,一个用于偏移,一个用于长度。对于每个字符串标量函数,stub 函数会迭代这组三重向量并调用底层 C++ 标量函数,从而将面向 tensor 的接口适配到原始面向行的实现。动态内存分配也受到仔细控制。字符串输出缓冲区由 runtime 提供,并在 GPU 上预分配,而标量函数中的短生命周期分配在 IR 中表示为栈分配。用于数学和内存操作的标准库调用被映射到现有 MLIR 方言,使编译器能够生成 GPU 代码,而无需为每个常见操作编写特殊的 handwritten intrinsic。
实验
实验使用增强型 TPC-H 基准、生产负载查询和微基准,评估标量函数对分析型数据库的影响,同时在热数据和冷数据条件下将 GPU 编译器系统与商用 CPU 数据库进行比较。这些研究验证了编译器生成的 GPU kernel 显著降低了标量函数开销,并提供强劲端到端查询性能,同时仍可与手工调优和更高层的 kernel 实现相竞争。额外的 roofline 和可移植性分析表明,该方法可在不同 GPU 厂商之间推广,尽管依赖于数据的字符串和日期函数可能会限制峰值效率。
实现使用 MLIR 方言表示编译为 GPU kernel 过程中的 C++ 标量函数。这些方言涵盖函数、控制流、内存操作、算术、数学库,以及标准高层操作未处理情况下的 Polygeist 专用转换。该结构支持从 C++ 构造下降到机器级内存与计算,同时保留有用的分析边界。函数方言表示函数体和函数调用。Affine 方言暴露具有静态边界的循环,以用于潜在并行化。结构化控制流方言捕获循环和条件区域。Memref 方言在硬件下降前支持复杂内存布局。算术与数学方言覆盖标量操作和标准函数。Polygeist 方言操作提供诸如 memref 到 pointer 的转换。
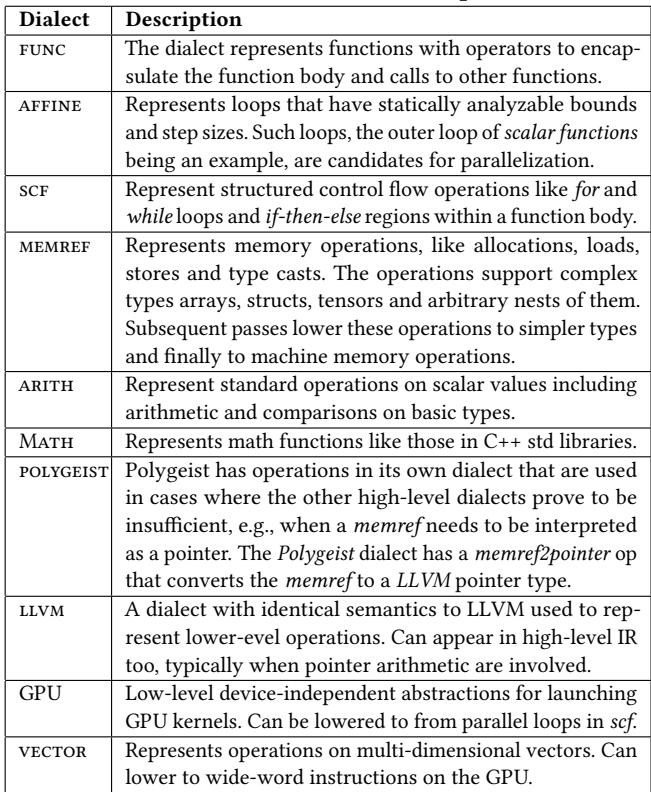
该表将标量表达式使用分为日期提取、字符串规范化、类型转换、字符串提取或验证以及日期运算。这些模式出现在分析查询的过滤、投影、分组和聚合过程中。它们可以在保留原始计划形态和基数的情况下并入基准查询。日期提取函数用于从 date 列过滤或投影 year、month 和 quarter 分量。字符串规范化函数在比较前标准化文本,处理大小写和标点差异。类型转换函数格式化日期输出,并调整数值或混合类型表达式。字符串提取与验证函数揭示内嵌数值字段,并检查值是否呈现数值或日期形式。日期运算函数表达日期范围和相对日期检查,而不是简单的常量比较。
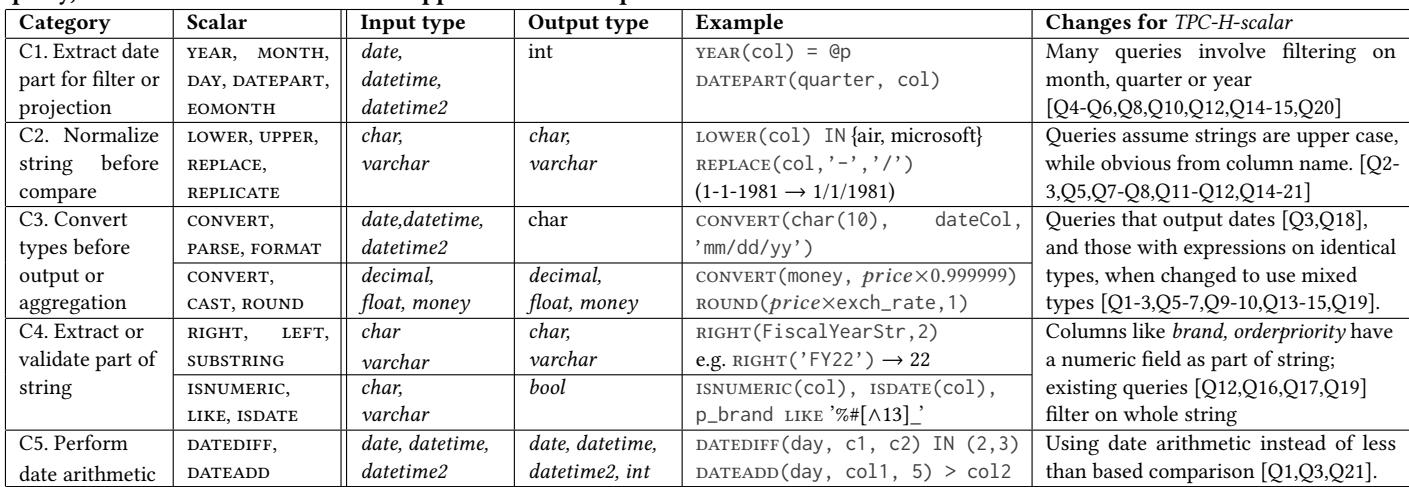
该评估围绕使用 MLIR 方言(函数、控制流、内存、算术、数学和 Polygeist 转换)将 C++ 标量函数编译为 GPU kernel 展开,每个实验都验证特定构造类的表示和下降,同时保留有用的分析边界。另一项独立的标量表达式使用分类涵盖日期提取、字符串规范化、类型转换、字符串提取或验证以及日期运算,表明这些模式自然出现在分析型过滤、投影、分组和聚合中。总体而言,结果表明方言设计支持对复杂标量逻辑进行结构化下降,并且所识别的表达式模式可以在不改变原始计划形态或基数的情况下并入基准查询。