Command Palette
Search for a command to run...
AnyBlox:一种自解码数据集框架
AnyBlox:一种自解码数据集框架
Mateusz Gienieczko Maximilian Kuschewski Viktor Leis Thomas Neumann Jana Giceva
摘要
存储格式方面的研究不断产出更高效的编码方案和更高的压缩率。然而,新格式因实现成本过高而难以被采纳,现有格式又因需维持跨系统兼容性而无法演进。引入新的抽象层能否解决这一问题?我们对此给出肯定回答,提出 AnyBlox——一种通过使用随数据捆绑的轻量级 WebAssembly 解码器来读取任意数据集的框架。AnyBlox 将解码器与系统和文件格式规范解耦,实现了透明的格式演进、面向实例的优化编码,并使研究成果能够被主流生态采纳。它能够与 DuckDB、Spark 和 Umbra 等现代系统无缝集成,同时提供可靠的性能和安全保障。
一句话总结
慕尼黑工业大学的研究人员提出了 AnyBlox。该框架将轻量级 WebAssembly 解码器直接随数据集打包,使解码过程与系统和格式规范解耦,从而支持透明的格式演进、面向实例优化的编码、以及新存储格式的主流采用,同时可无缝集成 DuckDB、Spark 和 Umbra 等系统。
核心贡献
- AnyBlox 被提出为一种自解码数据框架。它将轻量级 WebAssembly 解码器与数据集打包在一起,并暴露可移植的扫描接口,使 DuckDB、Spark 和 Umbra 等系统无需实现每一种新存储格式,也能读取任意编码。
- 该设计将解码器与宿主系统和文件格式规范解耦,支持将解码器随数据一起打包,通过密码学哈希实现安全的远程引用,并为流行编码透明使用原生解码器,从而支持格式演进和面向实例优化的编码。
- 所呈现的评估讨论了与 DuckDB、Spark 和 Umbra 的集成,并将 WebAssembly 解码器与基于 uBPF 的执行进行对比,结果表明 WebAssembly 解码器能够安全读取随数据打包或被引用的解码器,而 uBPF 则面临验证器错误、大量边界检查、有限的循环支持以及复杂的编译要求等问题。
引言
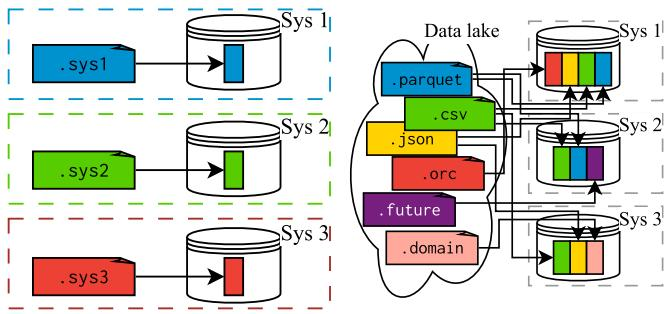
该论文针对现代数据处理系统与存储格式之间日益扩大的不匹配,因为数据越来越多地流经开放数据湖、跨平台分析工具以及领域专用格式。这一点很重要,因为当每个系统都必须分别为每种格式实现支持时,新编码往往难以被采用,这会造成难以持续的 N x M 维护问题,并导致现有格式逐渐固化。
现有方案存在显著局限:原生解码器速度快,但难以复用,而且集成到系统核心中时安全性不足;扩展模块能够提高灵活性,但仍具有系统特异性,并带来风险;隔离的 UDF 容器提供安全性,但数据传输开销很高;eBPF 或 uBPF 等静态验证方法提供更强的隔离,但面临可移植性和性能限制。
作者提出了 AnyBlox。这是一个面向自解码数据集的框架,可将轻量级 WebAssembly 解码器直接随数据打包,或通过密码学哈希进行安全引用。其自带解码器架构允许任意消费系统无需内置格式支持即可读取任意编码,同时零拷贝内存传输有助于保持性能。该工作旨在打破存储格式与系统之间的紧耦合,实现面向未来的、模块化的数据摄取。
数据集
- 作者在 PVLDB 工件仓库中公开了数据集及相关工件,地址为 https://github.com/AnyBlox/vldb-2025。
- 提供的文本仅描述了工件的可用性,没有说明数据集组成、来源、子集大小、过滤规则、模式、统计信息、训练划分、混合比例、裁剪策略、元数据构造,或数据在模型训练中的使用方式。
方法
作者将 AnyBlox 描述为一种自解码数据架构,其核心思想是解码器本身应当随数据一起交付。这针对了面向未来数据访问中的一个核心矛盾:系统必须将格式内部细节对查询引擎隐藏,同时又要允许这些引擎直接访问文件。AnyBlox 不把格式解码器放入每个宿主系统,而是将 WebAssembly 解码器随编码后的负载一起嵌入,或者引用该解码器。宿主程序只需要理解 AnyBlox 运行时和 Arrow 输出格式,而不需要理解所有可能的数据编码。
可以将该方法最好地理解为三个组件之间的一组小型契约:宿主、AnyBlox 运行时库以及沙箱化解码器。如下图所示:
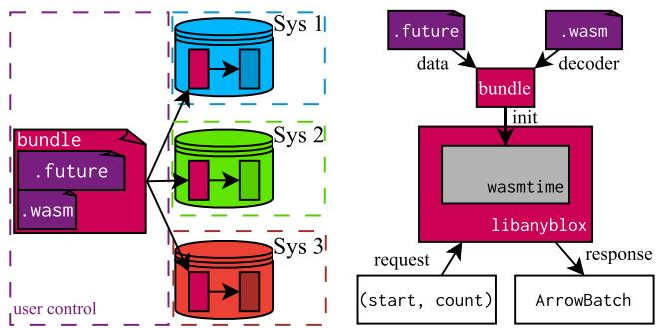
该图显示一个包含编码数据和解码器模块的包、一个将这些资源喂给 libanyblox 的 init 步骤,以及一个执行解码器的 WebAssembly 运行时。宿主发送包含起始位置和元组数量的请求,运行时返回 Apache Arrow Record Batches。在 AnyBlox 设计中,该包可以将解码器和数据一起存储在单个 .any 文件中,数据湖也可以分别存储它们并通过元数据进行连接。宿主仍然使用相同的读取路径,因为 libanyblox 会解析该包,并暴露统一的扫描接口。
解码器层基于 WebAssembly。作者选择 WebAssembly,因为它提供可移植的二进制格式、广泛的语言工具链、沙箱化执行,以及通过 JIT 编译获得接近原生的性能。该实现使用基于 Rust 的运行时栈,其中 Wasmtime 提供沙箱,Cranelift 将字节码降级为原生指令。这提供了强隔离属性,并使解码器运行时无需向宿主进程授予任意代码访问权限。AnyBlox 代码库的大多数部分是安全的 Rust,而不安全操作集中在 WebAssembly 内存映射周围,可以作为聚焦模块进行审查。
面向宿主的处理流程从宿主算子创建解码器作业开始。该作业接收数据集文件描述符、元数据和解码器字节码。libanyblox 会在需要时 JIT 编译解码器,并缓存已编译模块,因此使用同一解码器重复扫描时不会反复支付编译开销。初始化之后,宿主请求元组范围,通常以批次进行,运行时将这些请求映射到解码器唯一暴露的函数 decode_batch 的调用。解码器返回指向 Arrow 批次的指针,libanyblox 将 WebAssembly 指针转换为宿主原生地址,然后才把结果传回宿主。
解码器契约被有意设计得很小。decode_batch 函数接收描述编码数据的指针和数量、要解码的元组范围、用于可选缓存的状态页,以及用于列过滤的投影掩码。每个作业开始时,状态页都会被零初始化。这使解码器行为具有确定性和幂等性:它可以使用状态页缓存已解码位置,或在作业内复用分配,但不能依赖隐藏的外部状态、时钟、随机性或系统调用。对于可能重试、拆分或重新规划扫描的查询引擎而言,这一点很重要。
运行时层承载了 AnyBlox 设计中的很多复杂性。WebAssembly 暴露了一个从地址零开始的线性内存抽象,而客户机解码器可以通过宿主提供的 memory.grow 函数分配额外页面。AnyBlox 建立在 Wasmtime 的软件故障隔离模型之上:它预留一大片受保护的虚拟内存区域,最多覆盖 32 位指针的最大可寻址范围,然后随着解码器增长,仅将所需数量的页面设为可读和可写。这样,许多运行时边界检查就不必要了,同时解码器仍被限制在其虚拟分配范围内。
运行时的主要挑战是让解码器能够访问大型编码数据集,而不用把它复制到 WebAssembly 内存中。直接复制会造成昂贵的初始化成本,对于大文件尤其如此。惰性分页层需要自定义缺页处理,并会迫使解码器按页面大小的分块工作,而不是通过透明的线性内存视图工作。相反,AnyBlox 使用文件描述符和直接内存映射。如果数据集可以表示为文件描述符、共享内存对象或类似的操作系统抽象,libanyblox 就会将它映射到解码器的虚拟线性内存中。解码器随后使用普通内存读取透明访问编码数据。如下图所示:
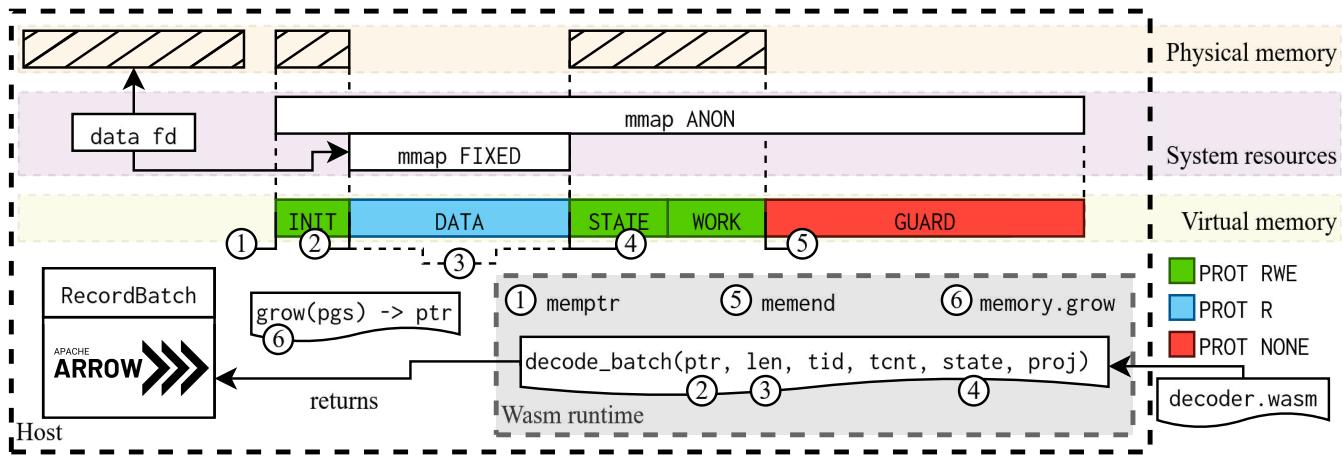
运行时示意图详细说明了每个解码器实例使用的虚拟内存布局。线性内存的低端包含初始代码、栈和静态数据区域。紧随其后,AnyBlox 将编码数据集映射到解码器的地址空间。之后是状态页,然后是工作分配区域,最后是受保护、禁止读写的守卫区域。解码器会获得线性内存起始地址的指针、指向编码数据的指针、数据长度、状态页指针、当前可访问内存的末尾,以及对 memory.grow 函数的引用。该布局使宿主和解码器能够以最少的间接层共享同一数据缓冲区。
运行时还引入了线程本地内存池,以避免重复创建大型虚拟内存区域。解码器实例绑定到线程本地作业,因为并发扫描很常见,而两个作业同时共享同一线程和同一数据集的情况不太可能。当作业结束时,如果初始区域足够大、正在扫描同一个包,并且所有动态分配页面都已清除,libanyblox 可能会为另一个作业复用现有线性内存映射。如果没有合适的映射,并且缓存尚未达到其上限,则会创建新的虚拟分配。如果缓存已满,则可以通过解除旧数据集挂钩并重新初始化该区域,来复用最近最少使用的映射。
实际解码过程可以通过一个简单列式示例理解。假设宿主正在扫描 run-end 编码列中的元组范围,例如 [400000,500000)。第一次调用会请求该范围的一个子集,例如从元组 400000 开始,元组数量为 10000。解码器会定位包含该行的 run,通常通过对 run 索引进行二分查找,然后输出值,直到进入请求范围。它提前知道输出大小,因为它必须恰好产生请求数量的值。如果解码器需要新的输出缓冲区,它会调用 memory.grow,宿主扩展线性内存映射,然后解码器写入新分配区域。返回的 Arrow 批次包含指向 WebAssembly 沙箱的指针,libanyblox 会将这些指针转换为宿主可见地址。
如果解码器将迭代状态保存在状态页中,后续批次请求可以快得多。对于 run-end 编码列,解码器可以保持当前行标识、当前 run 索引、当前 run 值、剩余 run 长度,以及指向已分配输出缓冲区的指针。当下一次调用恰好从上一次结束的位置开始时,解码器会继续扫描,而无需重复二分查找或重新分配内存。这种状态使用是可选的,而且由于状态会在每个作业时重置,如果宿主改变请求或重启作业,系统仍然能够保持正确性。
输出格式是另一个主要架构边界。AnyBlox 使用 Apache Arrow,因为它是列式的、可扩展的、被广泛支持,并且非常适合分析型数据库引擎。解码器产生 Arrow Record Batches,这给宿主提供了解码数据的标准化视图。不同宿主以不同方式消费该输出。DataFusion 这类原生 Arrow 系统可以以极小转换共享数据。具有内部存储布局的系统可以将 Arrow 数组转换为原生表示。基本类型通常可以就地转换,而字符串表示可能需要更多逻辑,因为不同引擎使用不同的字符串布局。这种转换发生在解码之后,并不会改变解码器本身。
宿主集成围绕算子或表源边界进行设计。在 C++ 系统中,libanyblox 可以通过兼容 C 的绑定暴露。在 Rust 原生系统中,集成是直接的。在基于 JVM 的系统中,原生接口层把宿主桥接到 libanyblox,并将 Arrow 负载加载到托管对象中。这个语言互操作层是系统设计的一部分,因为 AnyBlox 本身使用 Rust 实现,而目标宿主可能是 C++、Rust、Java 或 Scala。
并发扫描也被模块化。AnyBlox 组件可以知道总行数,并应用投影掩码,允许宿主在解码之前或解码期间裁剪列。使用静态分区的宿主可以在规划阶段将固定元组范围分配给工作线程。使用动态工作窃取的宿主可以从中央执行器请求工作单元,并在线程本地解码器作业中处理这些工作单元。线程可以请求更大的批次,然后以较小的引擎尺寸分块处理它,从而减少算子开销,同时保留本地解码器状态带来的好处。
AnyBlox 也可以嵌入到常规文件格式内部。在 Parquet 示例中,作者描述了一种方案,其中某列首先以解码器页开头,随后是不透明的二进制数据页。Parquet 读取器充当宿主,并把这些页面传递给 AnyBlox,从而允许任意编码方案分布在现有文件布局中。这一点很有用,因为传统文件格式已经提供元数据、统计信息和查询下推支持。当 AnyBlox 嵌入到行组或列级别时,引擎仍然可以使用来自外部格式的 min/max 统计信息、行过滤提示和优化器估计。相比之下,独立的 AnyBlox 只存储最小元数据,例如模式和行数,将更丰富的统计信息留给上层查询引擎或加速层。
实验
在预热后的 32 核机器上进行的评估将 AnyBlox 集成到多个查询引擎和数据格式中,以评估扩展性、可移植性和解码器性能。系统级实验表明,新解码器可以在宿主改动最小的情况下添加,并且在 TPC-H 和 ClickBench 负载中,沙箱化 WebAssembly 解码器能够超越原生 Parquet,或接近原生性能。微基准测试分离了 WebAssembly 开销,发现一些解码器会受到向量化和算术限制的影响,而在实际扫描中,扩展开销和初始化开销仍然可控。
AnyBlox 在可移植性和扩展性方面评价最强,同时在性能和安全方面也获得正面评价。其他方案表现出更清晰的权衡,原生和基于扩展的设计倾向于性能,但可移植性或安全性较弱,而隔离设计以性能为代价提升安全性。AnyBlox 获得最强的可移植性和扩展性评价。AnyBlox 在性能和安全方面均获得正面评价。性能评价强的方案往往在可移植性或安全性方面得分较低。
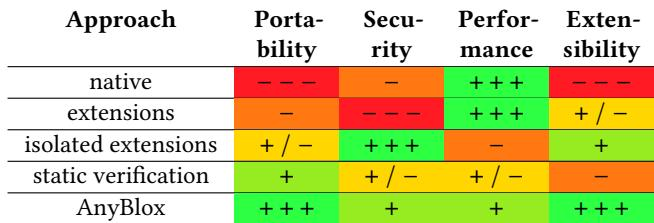
将 AnyBlox 集成到编译型、向量化和混合数据库宿主中需要适中的工程投入。每个系统均在不到两周且少于两千行代码的情况下完成集成,这表明跨不同执行模型的移植较为直接。在各宿主中,Spark 需要最多的人日,因为它需要 JNI 桥接。DataFusion 和 DuckDB 的集成投入最小,而 Umbra 需要更多代码行数。
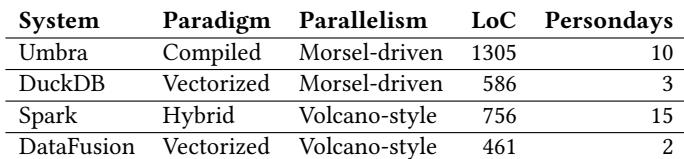
AnyBlox 通过与现有方案进行定性比较,并通过跨多种数据库宿主的移植实验进行评估。这些比较验证了其均衡优势,表明它拥有最高可移植性和扩展性,同时在性能和安全方面仍获得正面评价,而其他设计则表现出更清晰的权衡。集成实验验证了 AnyBlox 可以在相对有限的工程投入下移植到编译型、向量化和混合执行模型,尽管工作量会因宿主复杂度和所需桥接而不同。