Command Palette
Search for a command to run...
Diva:支持可变长度键与查询的动态范围过滤器
Diva:支持可变长度键与查询的动态范围过滤器
Navid Eslami Ioana O. Bercea Niv Dayan
摘要
范围过滤器是一种紧凑型概率数据结构,用于回答近似范围空性查询。它在许多领域得到应用,例如在键值存储系统中快速排除给定查询范围内键的存在性,从而避免在存储中搜索。然而,现有的所有范围过滤器至少存在以下一项不足:(1)无法提供鲁棒的误报率和性能保证;(2)不支持可变长度键和查询范围;(3)不允许插入、删除或扩展等动态操作。我们提出了 Diva,这是首个同时解决上述所有挑战的范围过滤器。Diva 通过采样键学习数据集分布,并将采样的键存储在缓存友好的前缀树中。它对采样键之间的键进行压缩,去除最长公共前缀并截断后缀,同时在中间保留足够的位(即中缀)以区分排序顺序中的键。它将中缀存储在常数时间的动态数据块中,并通过分裂数据块来处理插入和扩展操作。它通过遍历前缀树并检查中缀是否包含在目标查询范围内来处理范围查询。我们从理论和实验两方面证明,Diva 在真实数据集上的误报率与最先进方法相当,同时支持动态性和可变长度的查询与键。
一句话总结
多伦多大学与瑞典皇家理工学院提出 Diva,这是首个同时支持变长键和查询区间、动态插入、删除与扩容,并通过缓存高效的 trie、基于 infix 的键压缩以及常数时间动态数据块中学习数据集分布,从而获得稳健 false positive 率保证的范围过滤器。
核心贡献
-
该论文提出 Diva,这是首个同时支持动态插入、删除与扩容、变长键和查询区间,并具有稳健 false positive 率和性能保证的范围过滤器。
-
该设计将键采样到缓存高效的 trie 中,通过删除最长公共前缀并截断后缀,将样本之间的键压缩为 infix,并将这些 infix 存入常数时间动态数据块,这些数据块可拆分以吸收插入与扩容。
-
理论评估与真实数据集上的实验表明,Diva 的 false positive 率与最先进方法相当,同时保留动态更新、变长查询支持、更快的前驱搜索以及强构建速度。
引言
过滤器是紧凑的概率型数据结构,可避免不必要的磁盘读取和网络跳转,范围过滤器将这一思想扩展到数据过滤:通过跳过无法匹配范围谓词的数据段,在 LSM tree、SQL 表、B tree 索引以及分布式键值存储等系统中尤为重要。既有范围过滤器必须取舍关键特性:稳健设计只能对有限查询长度限制 false positive,并在内存预算紧张时难以处理变长键;基于学习的方法支持灵活查询,但往往缺少高效更新、变长键处理或快速查找与构建。该工作利用从采样键中学得的缓存高效 trie、定长 infix 离散化以及有序 infix 存储构建 Diva,这是首个同时支持低 false positive 率、任意范围查询、变长键、动态更新、快速查询与快速构建的范围过滤器。
方法
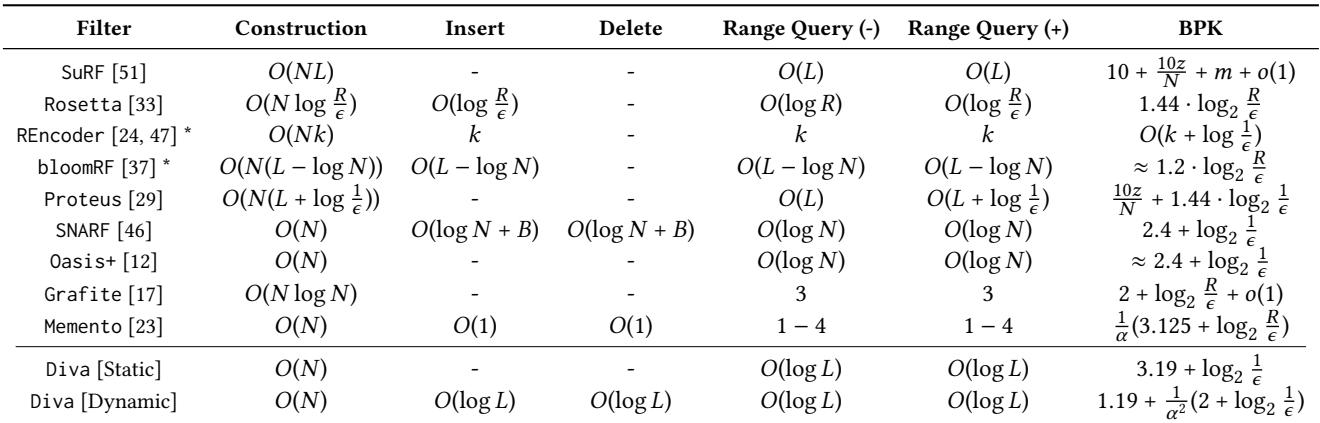
Diva 被设计为一种范围过滤器,其核心架构将针对键分布学得的粗粒度描述,与所有非采样键的紧凑区间局部存储分离开来。该工作将排序后的键集合视为分布模型:每隔 T 个键保留一个键作为样本存入 trie,而落在两个相邻样本之间的键只通过一种称为 Infix Store 的专用结构表示。框架图如下:
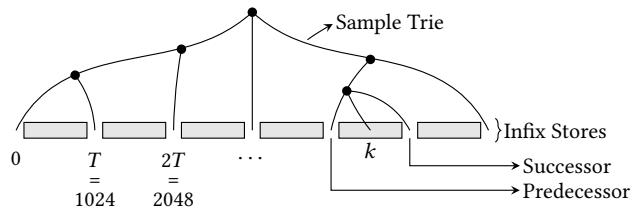
trie 为键空间的每个区域提供前驱和后继。两个连续样本之间的区间由一个 Infix Store 管理。如果两个样本相近,两者之间通常包含较多键,因此对应 Infix Store 表示密集区域。如果两个样本相距较远,两者之间通常包含较少键,因此对应 Infix Store 表示稀疏区域。通过这种方式,trie 学习分布的形状。采样间隔 T 控制分辨率与内存之间的折中。更小的 T 产生更密集的样本集和更细粒度的分布模型,更大的 T 减少内存占用。实现中使用 T=1024,以低开销获得强准确性。
查询首先由 trie 层处理。如果范围查询包含至少一个样本键,过滤器立即返回正结果,因为该样本是查询区间内的真实键。如果该范围不包含样本,其端点落入同一对相邻样本之间,因此 Diva 只查询对应的 Infix Store。点查询是端点相等的范围查询特例。
对于前驱样本与后继样本之间的每个区间,Diva 将中间的键编码为 infix。同一对样本之间的键共享可由 trie 推断的公共前导结构,因此删除最长公共前缀。变长键通过截断后缀处理,同时保留足够的中间位以区分键并达到目标 false positive 率 ϵ。截断示意图如下:
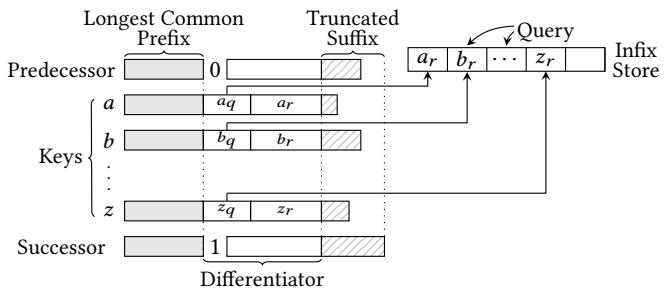
保留的中间位序列称为 infix。如果前驱与后继的最长公共前缀长度为 msharedi,Diva 会从区间内每个键中删除这些前缀位。随后选择 infix 长度
minfix=⌈log2ϵ2T⌉使离散化后的区间包含足够的 infix 值,以控制 false positive 概率。使用定长 infix 消除了键长变化,并允许使用整数算术进行范围包含检查。
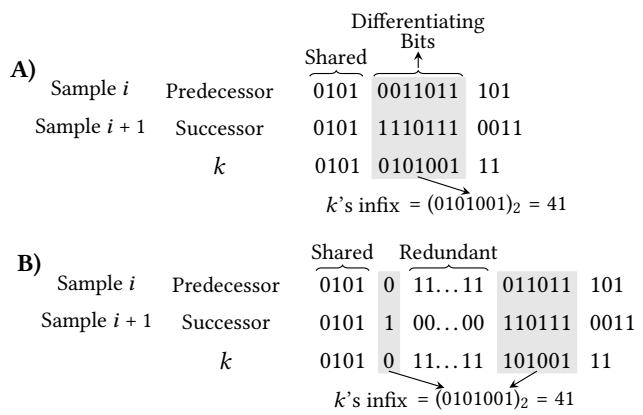
Diva 还处理一种细微情况:在删除最长公共前缀后,前驱与后继仍彼此接近。在这种情况下,前驱中连续匹配为 1 的位和后继中连续为 0 的位不会增加有用区分度。这些位称为冗余位,其长度记为 mredundanti。Diva 删除它们,并从一个区分位和随后 minfix−1 个有用位拼接得到每个 infix。这使有效 infix 域保持足够大,在该区间中产生 ϵT 到 ϵ2T 之间的可能 infix 值。随后可以这样理解 false positive 行为:将每个 Infix Store 区间划分为等宽子区间,每个子区间对应一个 infix。分布划分示意图如下:
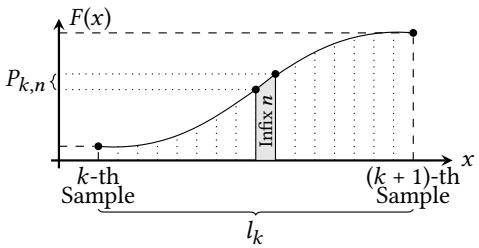
false positive 的概率,与非成员查询和已存储键被映射到同一 Infix Store 中同一 infix 的概率相关。对于表现良好的分布,累计分布函数在这些小子区间内不会过于突变,因此每个 infix 只捕获少量概率质量。这使 Diva 能够在使用紧凑的区间级表示的同时保证低 false positive 率。
每个 Infix Store 使用商化方式存储 infix。一个 infix 被拆分为由最低有效位组成的余数,以及由其余位组成的商。余数位数为
⌈log2ϵ2⌉.该存储维护一个 occupieds bitmap,用于记录哪些商存在。它还维护一个槽数组,存储属于每个商的余数。相同商的余数存储在称为 run 的连续组中,runends bitmap 标记每个 run 的最后一个槽。run 按商递增顺序存储。因为每个被占用的商恰好对应一个 run,Diva 可以借助对两个 bitmap 的 rank 和 select 操作定位某个商对应的 run。该 run 中最后一个槽的位置计算为
select(rank(q,occupieds),runends).由于表现良好区域中的 infix 近似均匀分布,run 的长度在期望上很短。这使余数扫描开销较低。
对于范围查询,Diva 推导端点 infix,并比较其商与余数。如果端点映射到同一个商,过滤器从对应 run 的末尾反向扫描,检查是否有任何余数位于端点余数之间。如果端点跨越多个商,Diva 首先检查 occupieds bitmap 中是否存在严格内部商。如果存在这样的商,查询必然包含其 run 中的所有余数,因此返回正结果。否则,Diva 仅扫描端点 run,并将余数与左右查询余数比较。
在构建方面,静态版本假设输入已排序,这在列存储、B-Tree 以及基于 LSM-Tree 的系统中很常见。在一次顺序扫描期间,Diva 将每隔 T 个键插入 trie,并按顺序构建每个 Infix Store。因为 infix 按递增顺序出现,所以依次设置 occupieds 位并将余数追加到 run。当新商出现或 Infix Store 填满时,设置对应的 runend 位。这使得构建高效并适合硬件预取。
trie 实现也影响查询性能。Diva 需要一种支持前驱与后继搜索的缓存感知结构。传统二叉 trie 可能引发许多 cache miss,因此系统可以使用高扇出 Wormhole-style trie。该结构将样本分组到平衡树中,并使用 trie 索引组边界,将前驱与后继搜索成本降低为 O(log2L) 次 cache miss,其中 L 是平均键长。
对于动态数据集,Diva 在静态设计基础上扩展插入、删除与调整大小支持。Infix Store 预留多余槽以吸收新插入。其 run 使用基于商顺序的线性映射均匀分布,插入或删除可以以类似 Robin Hood hashing 的方式将 run 左移或右移。溢出或下溢触发调整大小与重新映射。
新键也会更新分布模型。插入的键以概率 T1 成为新的 trie 样本;以概率 1−T1,其 infix 被插入当前 Infix Store。当插入新样本时,对应 Infix Store 被拆分为两个存储,一个包含较小键,另一个包含较大键。当删除一个样本时,相邻存储可以合并。因为新样本可能使前驱与后继键更接近,较旧 infix 可能变短并携带较少分辨率。Diva 通过一元填充编码较短 infix 来处理可变长度 infix 信息,并可选地随时间拓宽槽,以维持稳定的 false positive 率。查询期间,较短 infix 缺失的位被视为通配位。
实验
评估涵盖理论 false positive 保证、整数与变长键数据集上的静态和动态范围过滤器基准,以及与 B-tree 键值存储的集成。这些实验验证了 Diva 在短范围和长范围查询中均维持低 false positive 率,同时保持查询快速且内存可控,不同于查询长度、数据集规模或负载偏斜增加时准确率或延迟会退化的基线。动态测试进一步表明,Diva 支持高效插入与删除,比可扩容竞品更严格遵守内存预算,并加速 WiredTiger 中端到端空范围查询。
给定上下文定义了范围过滤的核心符号,并介绍 Diva 是一种使用 trie 中采样键以及 Infix Store 表示键范围的范围过滤器。它支持低 false positive 率、任意查询大小、变长键、动态更新、删除、可调整大小,以及强劲查询与构建性能。Diva 通过 trie 样本维持精确分布模型,相比 Memento filter 具有更低 false positive 率,相比 SNARF 具有更好更新行为。Diva 通过 Infix Store 拆分限制移动与重写,从而在受测过滤器中提供最快删除。在集成键值负载中,Diva 大幅改善端到端空范围查询延迟,并通过支持变长查询优于 Memento filter。
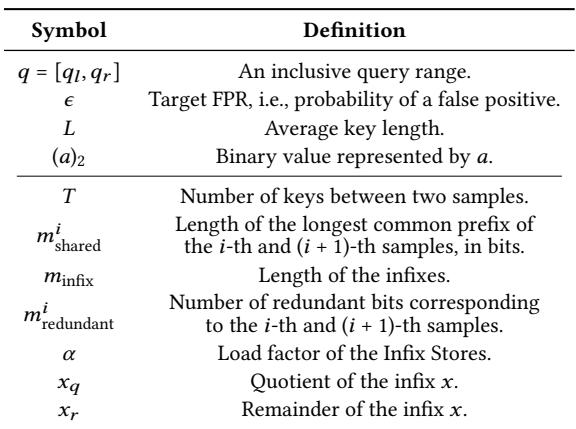
比较表明,既有范围过滤器只支持期望能力的一部分,而 Diva 被介绍为首个结合变长查询、变长键和动态更新的过滤器。实验上下文还描述 Diva 在不同查询长度和扩容期间维持低 false positive 率,同时比受比较的动态过滤器更一致地使用内存预算。当集成到存储引擎时,Diva 比基线和查询灵活性较弱过滤器提供快得多的空范围查询处理。Diva 独特地同时支持变长查询、变长键和动态操作。Diva 避免了某个受比较动态过滤器在插入期间出现的内存扩容浪费。相比受比较的动态过滤器,Diva 提供更快删除和更强端到端空范围查询性能。
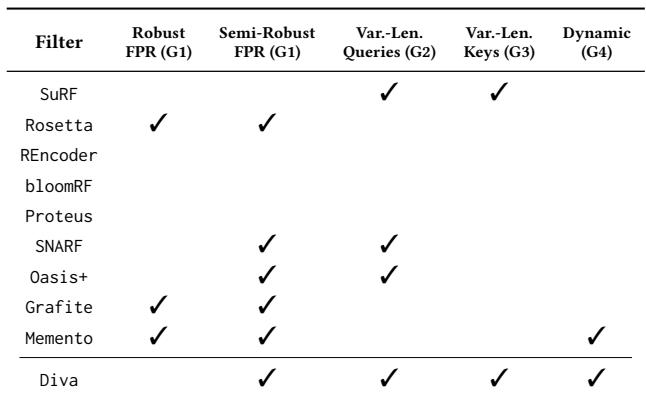
受比较的范围过滤器在构建时间、内存使用、更新成本和查询成本之间呈现不同折中。支持较长查询稳健范围过滤的过滤器通常需要更多内存,而某些设计依赖 hash 数量、键长、false positive 目标或分布建模。Diva 被介绍为使用低成本批量构建与顺序内存访问,并在空范围查询和非空范围查询中具有较佳操作成本。Diva 受益于顺序批量构建和极少 hashing,相比受比较设计具有显著构建时间优势。范围查询成本因过滤器而异,有些主要取决于键长,另一些取决于 false positive 目标或 hash 数量。更新支持仅限于部分过滤器,当分布模型或数据结构随数据集规模增长时,更新速度可能退化。
Diva 通过删除公共前缀位、与样本前驱和后继冗余的位以及后缀,推导每个键的 infix。示例表明,这仅留下区分位,为范围过滤生成紧凑标识符。附带结果将 Diva 描述为准确、内存有界、更新快速,并在长范围查询中优于 Memento filter。Diva 通过丢弃共享位、冗余位和后缀位紧凑编码键。Diva 遵守内存预算,同时在更新上优于 SNARF,在长查询上优于 Memento filter。