Command Palette
Search for a command to run...
面向通用 UDF 查询的 UDFBench 基准测试
面向通用 UDF 查询的 UDFBench 基准测试
Yannis Foufoulas Theoni Palaiologou Alkis Simitsis
摘要
用户自定义函数(UDF)通过函数能力扩展了声明式 SQL 的表达能力,但由于 UDF 与 SQL 执行环境之间的阻抗不匹配以及查询优化器难以为 UDF 查询持续生成优质执行计划,UDF 在查询处理中构成了核心瓶颈。学术研究和工业界提出了多种改善 UDF 查询执行性能的方案,从逻辑优化和启发式方法到物理优化和编译技术不一而足。然而,每项工作都采用了不同的评估路径来验证其提出的技术。尽管优化 UDF 查询具有重要的实际意义,UDF 迄今尚未成为数据库基准测试的关注焦点。本文提出 UDFBench,一个基于真实模式和数据、以 UDF 为核心的数据库基准测试。我们识别出 UDF 查询执行中的核心开销,并据此设计 UDFBench 的 UDF 和查询,以支持对这些开销单独或组合进行实验。最后,为展示 UDFBench 的可移植性和适用范围,我们对五个具有不同特性的主流数据库进行了实验分析。
一句话总结
Athena Research Center 与 University of Athens 提出 UDFBench,这是一个以 UDF 为中心的数据库基准测试,基于真实世界的模式和数据构建,隔离并结合 UDF 查询执行中的核心开销,从而在五个具有不同架构特性的流行数据库之间实现可移植实验。
核心贡献
-
对研究型和商业型 UDF 查询处理技术的瓶颈点分析识别出核心执行开销和性能缺陷,涵盖逻辑优化和物理优化、UDF 和数据类型多样性、编程语言以及执行环境。
-
UDFBench 被提出为一个模块化、开源的基准测试,基于真实世界的模式、数据和查询,旨在将 UDF 作为 SQL 查询中的一等公民进行测试,并隔离或组合核心执行开销。
-
在五个不同架构的数据引擎上进行的实验评估证明了可移植性,揭示了性能缺陷和设计局限,并为支持 SQL 中多语言 UDF 的引擎提供了标准化测试平台。
引言
作者考察关系型 SQL 引擎中的用户定义函数,其中 UDF 允许开发者在数据库查询中嵌入复杂逻辑和分析。这对数据科学和分析工作负载很重要,尤其是基于 Python 的 UDF,但性能通常较差,因为 SQL 求值和过程式执行集成不足,产生转换和优化开销。
早期基准测试主要针对连接、事务或过程式 SQL,而 SQL ProcBench 仍受限于特定方言定义、狭窄的 UDF 覆盖范围、简单查询模式以及对跨语言 UDF 执行支持的薄弱。作者以 UDFBench 回应,这是一个模块化、开源的基准测试,将 UDF 视为一等公民,使用受真实世界启发的模式、数据和查询,并评估多个数据引擎以暴露瓶颈并指导未来研究。
数据集
-
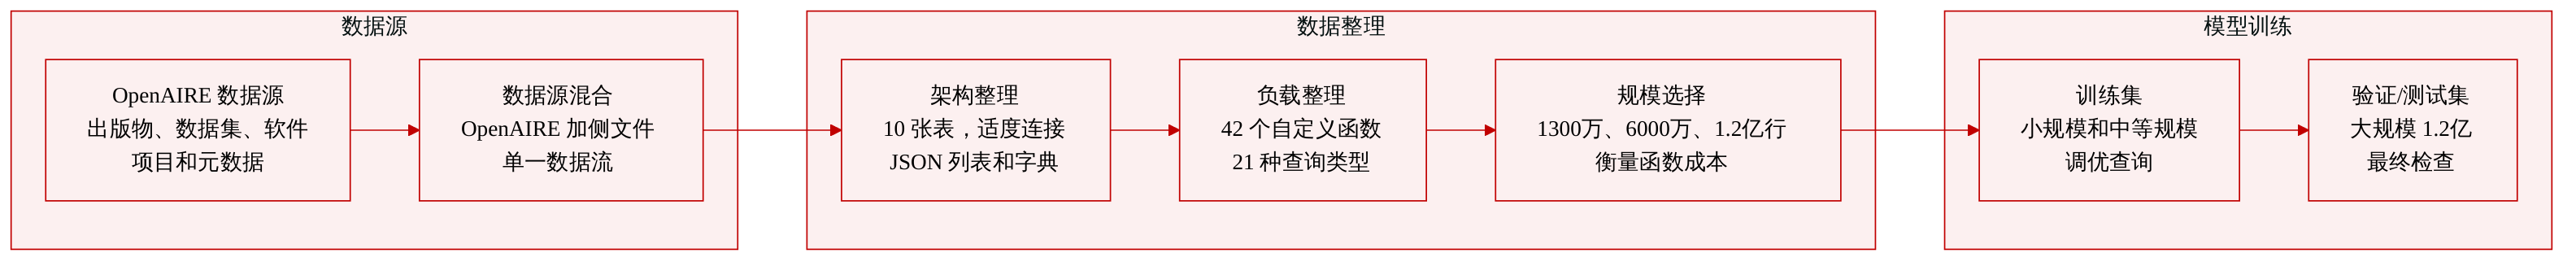
数据集来源:作者从 OpenAIRE 中派生 UDFBench,OpenAIRE 是面向开放获取出版物的真实世界信息抽取和分析系统,包括抓取的出版物、数据集、软件制品和项目。
-
核心组成:该基准测试结合了精心整理的数据库模式、三种缩放因子下的真实世界数据、用户定义函数以及混合关系算子与 UDF 的 SQL 查询。
-
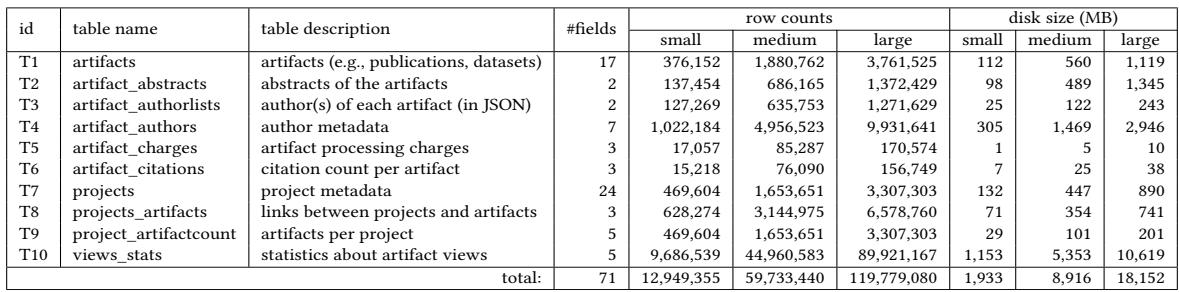
模式:该模式包含 10 张表:两张用于制品和项目的核心表,七张用于作者元数据、作者列表、摘要、访问费用、项目制品关联以及相关元数据的表,以及一张用于制品查看统计数据的表。
-
数据形态和过滤:该模式包含反规范化和半结构化字段,例如 JSON 列表和字典,以及到外部反规范化文件的连接。作者关注中等长度的连接路径、聚合、分组和混合数据类型,而非非常大且包含大量连接的基准测试。
-
数据规模子集:论文提供三个真实世界数据子集:小型子集包含 1300 万行,中型子集包含 6000 万行,大型子集包含 1.2 亿行。所选规模旨在暴露 UDF 开销,而不过度混合 I/O 或磁盘溢出效应。
-
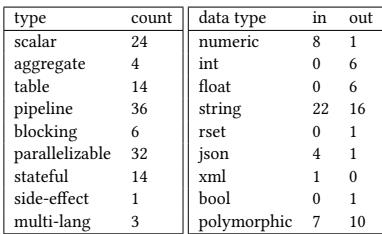
UDF 子集:该基准测试包含 42 个受生产 OpenAIRE 代码启发的 UDF,覆盖 24 个标量 UDF、4 个聚合 UDF 和 14 个表值 UDF,跨越 10 个子类型类别。这些 UDF 在输入输出模式映射、流水线与阻塞行为、可并行性、有状态性、副作用、支持语言以及简单与复杂数据类型方面有所不同。
-
查询子集:该基准测试包含 21 个受真实使用场景启发的查询。它们被组织为四类:简单的 UDF 密集型查询、混合 UDF 与昂贵关系算子的查询、具有复杂关系逻辑和深层嵌套的查询,以及涉及插入和更新等 DML 操作的查询。
-
查询元数据:每个查询以所属类别、UDF 数量和类型、输入输出数据类型、空值处理、UDF 链式和嵌套深度、潜在优化、进程内行为、动态或有状态 UDF 使用情况,以及昂贵关系算子数量进行刻画。
-
处理和元数据构建:作者使用模式和工作负载元数据对 UDF 和查询进行分类,包括 UDF 类型、子类型、数据类型、并行性、有状态性、副作用和优化机会。这些数据被构建用于测试不同引擎中的标量、聚合和表值 UDF 行为。
-
论文中的用途:作者将该数据集用作基准测试平台,而不是模型训练语料。模式、数据子集、UDF 和查询用于评估 UDF 执行开销、查询优化机会、执行模式以及引擎特定的 UDF 能力。
-
无裁剪策略:这是一个数据库基准数据集,因此不使用图像裁剪或视觉预处理。主要处理步骤包括模式整理、数据扩展、UDF 分类、查询设计以及工作负载元数据标注。
方法
作者围绕瓶颈点分析方法设计 UDFBench,该方法将 UDF 查询执行分解为可测量的子系统:语言运行时边界、UDF 类型映射、数据类型转换、执行调度、查询优化面和 UDF 特定编译器技术。该框架不是评估孤立函数,而是生成将关系算子与标量、聚合和表值函数组合起来的查询,然后衡量每个因素对端到端延迟的贡献。目标是在开销被隐藏在引擎黑盒内部之前暴露开销来源。
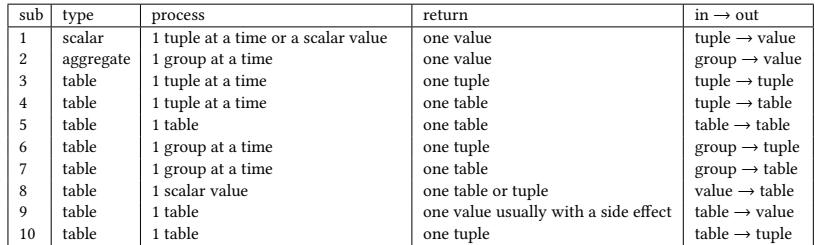
工作负载以精心整理的 UDF 目录为中心。标量函数处理一个输入元组并返回一个值。聚合函数处理一个分组并返回一个值。表值函数处理一个表、一个分组或标量参数,并可能返回一个元组或一个新表。作者将一般关系表示为 f:I→O,其中 I 和 O 可以表示元组、分组或表。基于这些输入到输出的映射,该基准测试将 UDF 组织为暴露不同执行行为的子类型。行级表值函数适合进行数据分区和并行执行,而整表级表值函数具有阻塞行为。分组级表值函数类似聚合,但会产生多个输出行,从而形成不同的优化空间。
实现层将这些 UDF 适配到引擎特定机制。作者考虑了支持语言、类型系统、持久性和并行执行方面的差异。在支持动态签名的引擎中,多态 UDF 可以只编写一次,并在查询时确定类型,而其他引擎则需要为每种类型变体提供独立实现。有状态函数取决于引擎是否能够在多次调用之间保留已编译资源。并行执行通过引擎级提示或安全并行注解暴露,该基准测试还包含基于线程和进程的调度选择,以比较可扩展性。
数据类型处理被视为主要开销来源。简单数值可以通过转换较少的运行时接口传递。字符串值可能涉及缓冲区、内存视图或直接指针,具体取决于引擎和 UDF 语言。复杂类型通常需要序列化为 JSON、转换为原生对象,随后再转换回关系表示。作者在等价的标量 UDF 变体中同时包含简单和复杂返回类型,因此测量得到的成本将计算与转换和拷贝行为分离。
如下图:
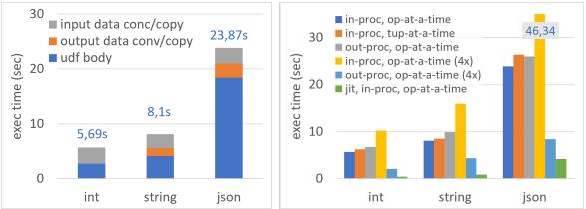
左侧比较显示,从语义相似的标量 UDF 中返回整数、字符串或 JSON 值,会改变 UDF 函数体执行与输入或输出转换之间的平衡。右侧比较对执行策略进行对比,例如进程内调用与进程外调用、一次处理一个算子与一次处理一个元组的执行、线程并行、进程并行以及 JIT 编译执行。这使得作者能够将性能差异归因于运行时交互、函数调用量、并行性限制和编译器支持。
查询设计随后将这些组件组合成优化测试用例。作者创建了带有嵌套调用、链式标量函数、过滤加映射加表值函数流水线、聚合处理、多态表源和有状态函数的查询模式。这些结构为谓词重排、UDF 下推、自适应执行、循环融合、向量化、函数内联或外联以及 JIT 编译等技术提供了逐渐递增的复杂度阶梯。通过将 UDF 嵌入 SQL 流水线,而不是将 UDF 作为孤立程序进行测试,UDFBench 测量过程逻辑与关系执行之间的交互。
实验
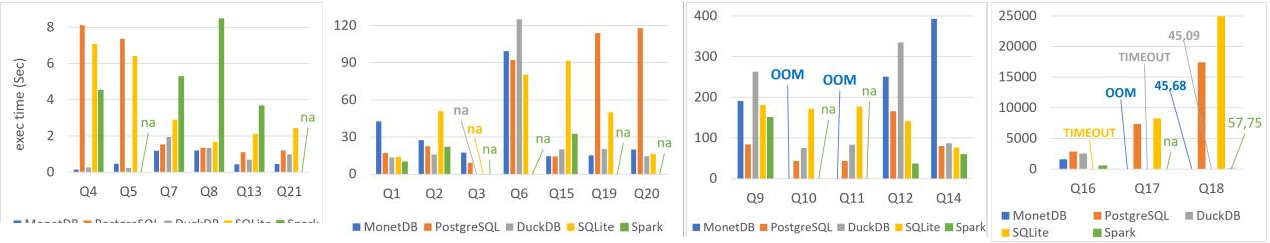
实验使用源自 OpenAIRE 的真实世界模式、多个数据集规模、42 个 UDF 和四类查询,在 PostgreSQL、MonetDB、DuckDB、SQLite 和 Spark 上评估 UDFBench,并通过微实验验证 UDF 类型、执行架构、并行性、有状态性、优化、编译、编程语言、分布式执行和实现复杂度。结果表明,向量化引擎在聚合和零拷贝 UDF 执行方面表现优异,而一次处理一个元组或进程内模型对阻塞型表值 UDF 可能更有效,并行性在很大程度上取决于引擎设计和语言约束。总体来看,有状态和融合的 UDF 实现会降低开销,当前查询优化器通常遗漏 UDF 感知的重排,自适应执行或 JIT 编译提供了有前景但尚未完全实现的改进,而对许多 UDF 子类型支持的薄弱则限制了执行兼容性。
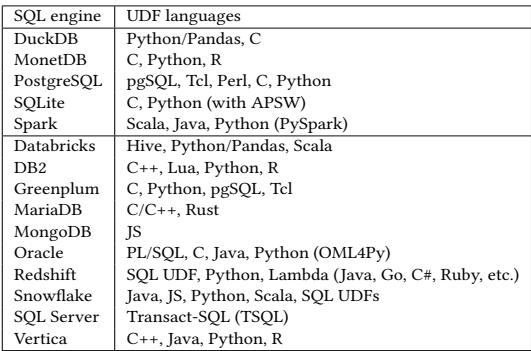
流行 SQL 引擎支持广泛的 UDF 语言,C/C++ 和 Python 在大多数引擎中都有出现,而额外支持因引擎而异。这种多样性使查询执行变得复杂,因为单个查询可能组合来自不同语言运行时的 UDF,需要数据转换和协调处理。Python 是各个 SQL 引擎中支持范围最广的 UDF 语言之一。C 和 C++ 支持也常见于各个引擎。额外的 UDF 语言支持因引擎而异,包括 R、Java、Scala、Perl、Tcl 和 Hive。
基准模式基于一个真实世界的学术元数据应用,包含以制品和项目为中心的表,并配有支持表用于摘要、作者元数据、作者列表、费用和引用。其小、中、大三个数据规模在一致地扩展行数和磁盘占用空间的同时,仍保持足以暴露 UDF 开销而不会产生过多 I/O 或磁盘溢出的规模。该模式还包含嵌套属性和多种数据类型,从而支持聚合、分组以及超出纯关系处理范围的中等长度连接路径的查询。核心制品表和项目表连接到多个支持表,用于保存元数据和相关记录。作者信息既出现在关系型元数据中,也出现在嵌套的 JSON 风格列表中,促使 UDF 处理超出标准 SQL 值的内容。数据集在不同缩放因子下按比例增长,在保持相同模式的同时增加数据量和存储占用空间。
该表根据 UDF 的输入和输出行为,将其按类型和子类型分类,覆盖标量 UDF、聚合 UDF 和表值 UDF。标量 UDF 和聚合 UDF 具有固定的输入到输出映射,而表值 UDF 包含多种映射,例如元组、分组和表作为输入或输出。这些区别塑造了执行行为和优化机会。标量 UDF 和聚合 UDF 始终以一致的方式将输入映射到输出。表值 UDF 具有若干输入到输出的映射,包括元组到元组和元组到表。一次处理一个元组的表值 UDF 可以通过数据分区进行并行化。一次处理整个表的表值 UDF 表现为阻塞操作。一次处理一个分组的表值 UDF 返回多个值,并启用类似于聚合 UDF 的优化。
UDF 集合以标量函数和表值函数为主,其中表值 UDF 跨越多种输入和输出映射。流水线执行比阻塞执行更常见,许多函数可以并行化,只有一小部分函数是有状态的。字符串类型是最常见的输入和输出模式类型,一些与数值相关的类型主要出现在输出中。在 UDF 中,流水线执行远比阻塞执行更常见。可并行化 UDF 比有状态 UDF 更频繁。字符串类型主导输入和输出模式,而面向聚合的数值类型主要出现在输出中。
该基准集合涵盖广泛混合的用户定义函数,并按函数类型、输入输出映射以及成本或复杂度进行分类。标量函数在该集合中占主导,表值函数构成数量充足且种类多样的组,而聚合函数相对较少。标量 UDF 最为常见,同时表值 UDF 也得到充分表示,并跨越多个子类型。该分类将简单的同形状标量和聚合映射与更复杂的表值映射区分开来,包括可并行化的元组或分组处理以及阻塞型整表处理。
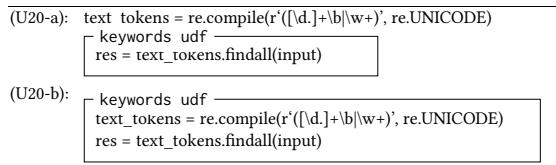
实验在贴近现实的学术元数据模式上构建基准测试,并在多个缩放因子下进行评估,以暴露 UDF 开销,同时限制 I/O 和磁盘溢出。该评估按语言支持、标量、聚合和表值类型、输入输出映射、执行模式、可并行性和复杂度对用户定义函数进行分类。定性结果表明,不同引擎的 UDF 支持情况不同,标量函数和表值函数占主导,并且流水线和可并行化 UDF 比阻塞型或有状态 UDF 更常见。这些发现表明,有效的 UDF 执行系统必须处理多样化语言、嵌套数据类型、字符串密集型工作负载以及混合算子语义。