Command Palette
Search for a command to run...
有效 UDF 优化的关键:先 Outline 再 Inline
有效 UDF 优化的关键:先 Outline 再 Inline
Samuel Arch Yuchen Liu Jignesh M. Patel Todd C. Mowry Andrew Pavlo
摘要
尽管用户自定义函数(UDF)是一种流行的为 SQL 声明式范式补充过程式代码的方式,但两种编程范式之间的不匹配带来了根本性的优化挑战。UDF 内联(inlining)通过用等价的 SQL 子查询替换所有 UDF 调用来自动消除 UDF。尽管内联使查询完全保留在 SQL 中(从而带来显著的性能提升),但我们观察到将整个 UDF 完全内联往往导致次优性能。一种更好的策略是分析 UDF,将其解构为更小的片段,并仅内联有助于查询优化的片段。为此,我们提出了 UDF outlining 技术,该技术有意将 UDF 的部分内容对优化器隐藏,从而生成更简单的 UDF 和显著更快的查询计划。我们的实现(PRISM)表明,通过更有效的嵌套展开(unnesting)、改进的数据跳过(data skipping)以及避免不必要的连接,UDF outlining 相较于传统内联方法能够提升性能(在 DuckDB 上平均加速 1.29 倍,在 SQL Server 上平均加速 298.73 倍)。
一句话总结
卡内基梅隆大学提出 PRISM,这是一种 UDF 外联技术,它会故意向 SQL 优化器隐藏用户定义函数(UDF)的部分代码,以实现选择性内联。借助更有效的解嵌套、更好的数据跳过,以及避免不必要的连接,该方法相比常规全内联可获得最高 298.73× 的加速。
核心贡献
-
论文引入 UDF 外联,即故意向优化器隐藏用户定义函数的选定片段,并且只内联那些有助于优化的片段,用更简单的 SQL 子查询和更高效的计划替代整个 UDF 的内联。
-
PRISM 实现了带有互补优化技术的 UDF 外联,这些优化可以生成不含 LATERAL 的子查询,实现更有效的解嵌套,改进数据跳过,并在 DuckDB 和 SQL Server 查询中避免不必要的连接。
-
实验显示,相对于常规 UDF 内联,性能有所提升:DuckDB 平均加速 1.29 倍,SQL Server 平均加速 298.73 倍;解嵌套可带来超过 1000 倍性能提升,数据跳过约为 10 倍,连接避免为 1.02 倍至 1.62 倍。
引言
应用开发人员经常通过用户定义函数(UDF)扩展 SQL,但这些函数对数据库查询优化器不透明,这可能导致包含大量 UDF 的查询比等价的 SQL 查询慢得多。编译、批处理和 UDF 内联等先前优化方法在某些情况下能够提升性能,但也存在局限:编译不能修复糟糕的查询计划,批处理可能需要昂贵的物化,而内联可能创建带有 LATERAL 连接的复杂子查询,这些子查询难以解嵌套、执行缓慢,并且难以利用数据跳过。论文引入 PRISM,这是一个 UDF 优化框架,它在注册时分解 UDF,选择性内联有用片段,并将其他片段外联,以降低查询复杂度。论文还使用 UDF 外联、谓词上移以及互补的重构优化,使 DuckDB 和 Microsoft SQL Server 能够看到更好的计划和数据跳过机会,在以 UDF 为中心的工作负载上取得显著加速。
数据集
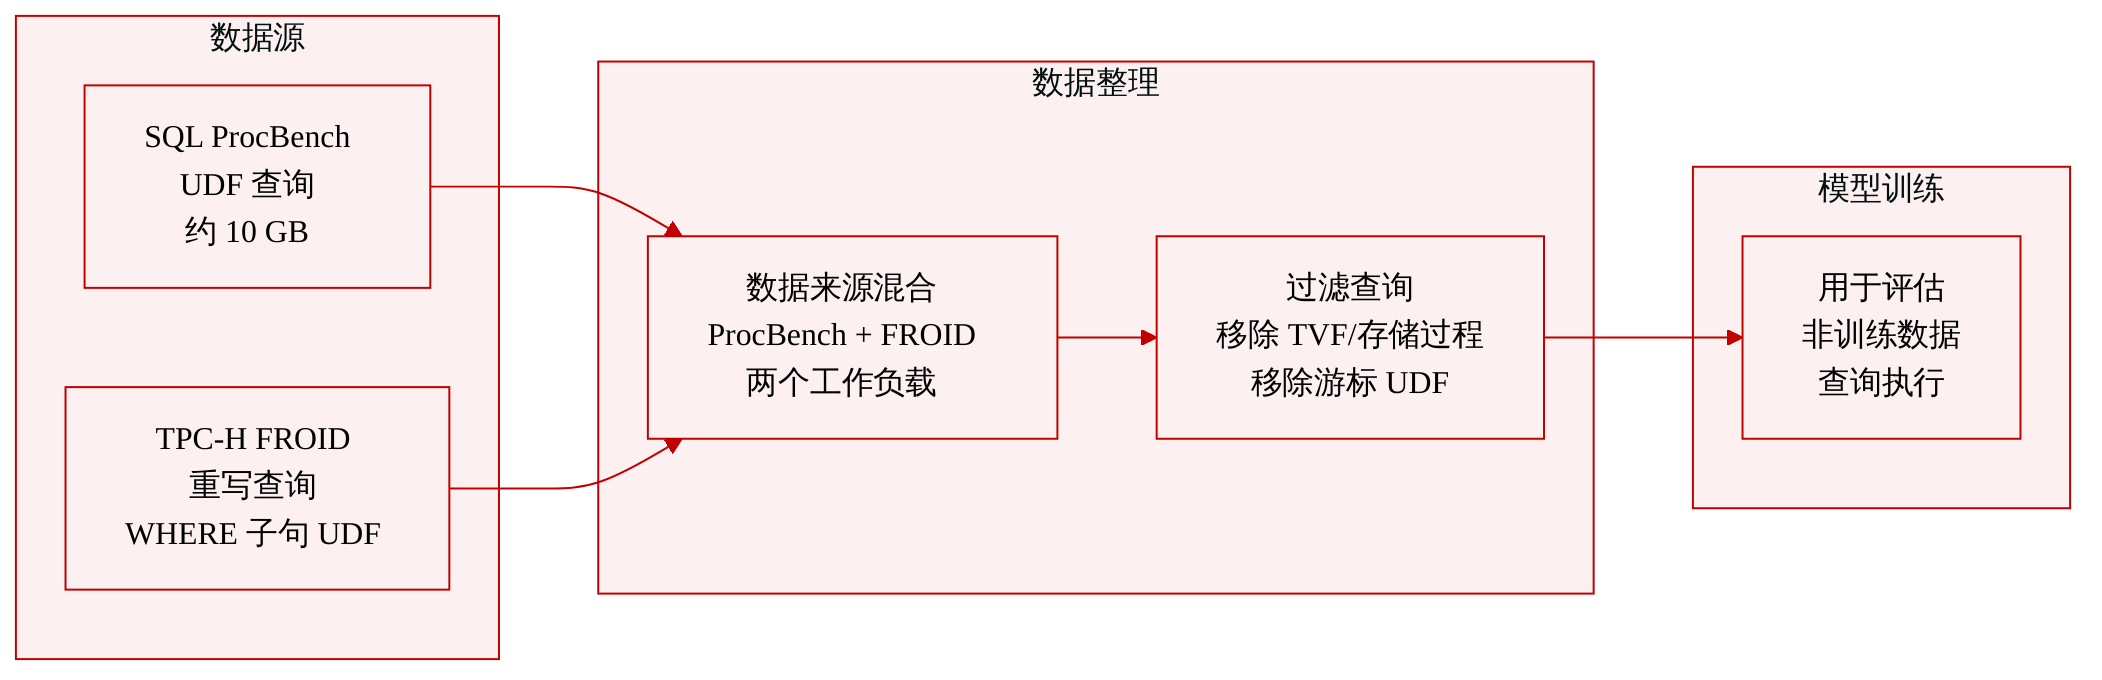
- 实验使用两类围绕 SQL 用户定义函数的评估工作负载。
- SQL ProcBench 是 Microsoft 于 2021 年发布的基准,模仿 Azure SQL Server 上的真实 UDF 工作负载,并基于 TPC-DS 构建。
- ProcBench 包含 24 个调用标量 UDF 的查询。
- ProcBench 在缩放因子 10 下运行,数据规模约为 10 GB。
- 实验使用 24 个查询中的 17 个,排除了使用表值函数或从存储过程调用 UDF 的查询。
- 在 SQL Server 上还跳过查询 Q8 和 Q14,因为这些查询使用了游标循环 UDF,而这些 UDF 无法在 Linux 版 SQL Server 2022 中编译。
- TPC-H FROID 是 TPC-H 的 FROID 变体,它手动重写了 12 个基准查询,使其使用标量 UDF。
- TPC-H FROID 中的 UDF 比 ProcBench 的 UDF 更简单,只使用纯过程式或关系式逻辑,而不是混合过程式逻辑与 SELECT 语句。
- FROID 的 UDF 将表达式拆分为可复用函数,而不是嵌入复杂业务逻辑。
- FROID 查询在 WHERE 子句中调用 UDF,除非 DBMS 执行谓词上移,否则会阻碍数据跳过优化。
- 这些数据集作为评估查询执行和优化行为的实验工作负载使用,而不是作为训练数据集使用。
方法
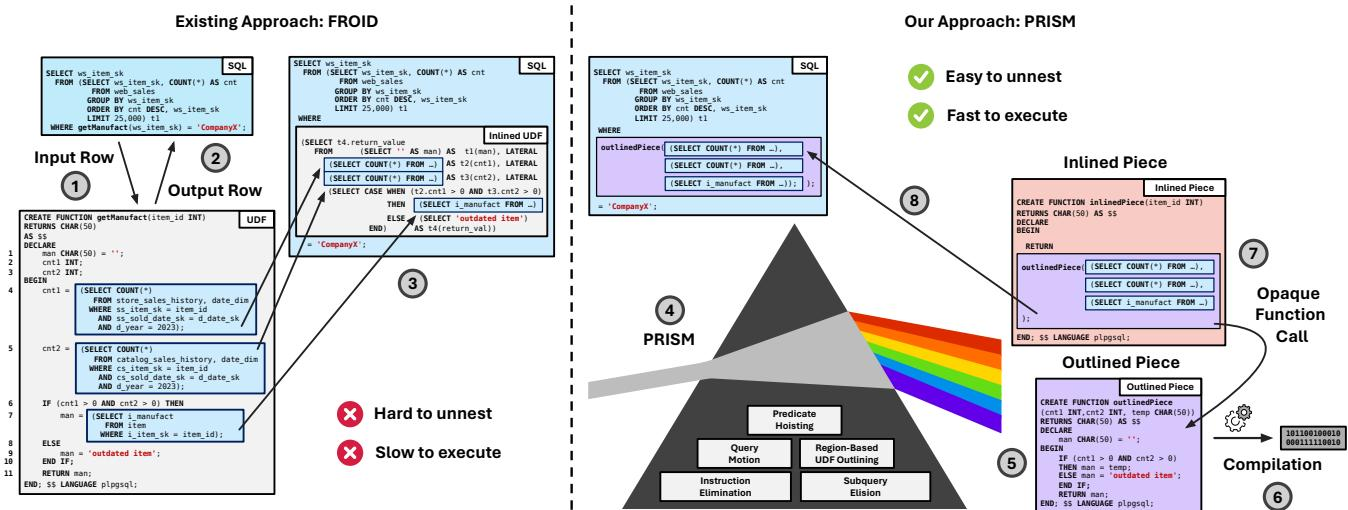
PRISM 是一个用于用户定义函数的编译时优化框架,它把 UDF 分解为适合内联的关系式部分和适合外联的过程式部分。系统不在查询时将完整函数重写为复杂 SQL 子查询,而是在通过 CREATE FUNCTION 注册 UDF 时处理该函数。该框架解析函数,将表达式和表引用与目录绑定,把代码翻译为中间表示,并应用编译器风格优化。目标是只向查询规划器暴露最有利于优化的 SQL 片段,同时把剩余过程逻辑编译为不透明的高性能函数调用。参见框架示意图。
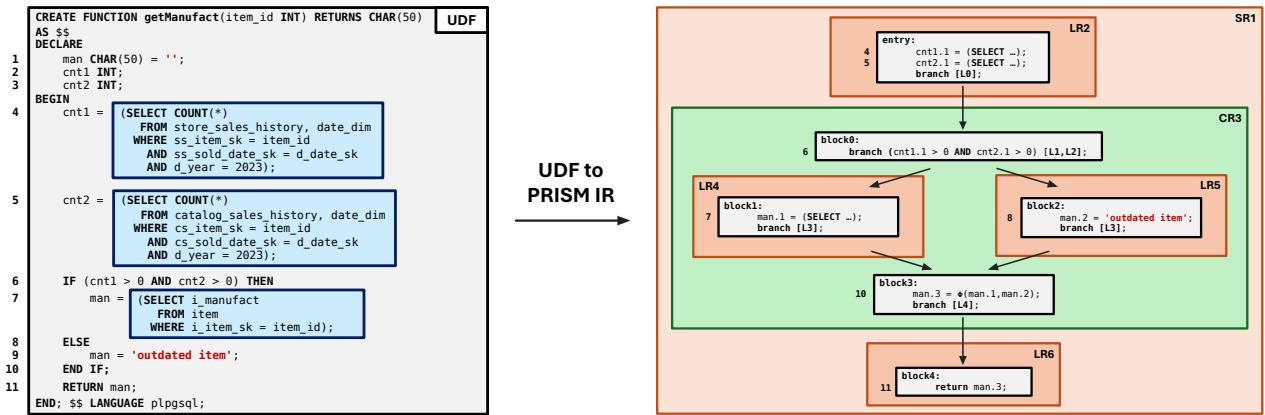
PRISM 使用的内部表示将静态单赋值(SSA)形式与分层程序区域结构结合在一起。UDF 首先表示为 SSA 形式的控制流图,其中每个变量只被赋值一次,并为不同定义创建版本,例如 x1、x2 和 x3。在控制流汇合点,ϕ 函数(例如 x3=ϕ(x1,x2))记录应从每个前驱流出的值。同一程序也组织为程序结构树,树中包含单入口单出口区域,包括叶区域、条件区域、循环区域和顺序区域。内嵌 SELECT 语句被放入专用基本块,从而在优化过程中把过程式代码与关系式代码分离。参见中间表示。
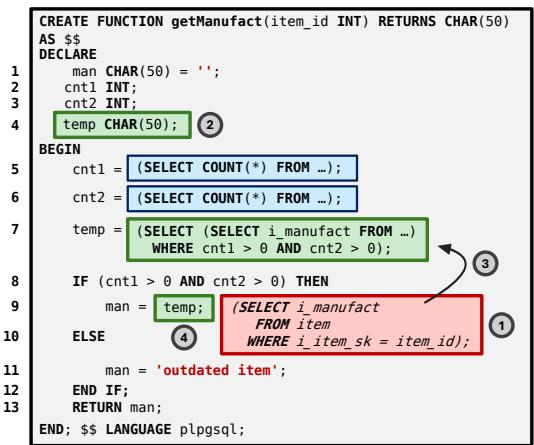
第一个主要优化是查询上移。许多 UDF 混合了过程式控制流与内嵌关系式查询,例如把 SELECT 语句放在 IF/ELSE 代码块或循环中。这种耦合使优化器无法干净地外联过程式代码。PRISM 会反复把符合条件的 SELECT 语句尽量上移到区域树的高层。如果当前区域未定义该语句引用的变量,则把语句移动到父区域。当语句跨越条件区域时,PRISM 会将保护条件附加到查询中,确保只在原来的分支条件成立时执行该语句。这一步把应当内联的关系式代码与可以外联的过程式代码分离。参见查询上移示意图。
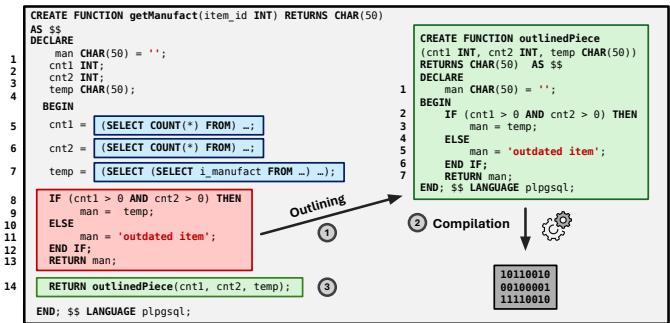
在查询上移之后,PRISM 执行基于区域的 UDF 外联。系统自顶向下递归遍历区域树,并提取不包含内嵌 SELECT 语句的最大过程式区域。包含 SELECT 语句的区域继续对数据库优化器可见,而不包含 SELECT 的区域则从 UDF 中移除,并编译为独立函数。活跃性分析确定被提取区域的输入变量和输出变量。随后将提取出的代码转译为机器代码,例如通过 C++ 代码生成和编译器工具链,并动态链接到数据库系统中。原始代码被替换为一个不透明函数调用,从而减少暴露给优化器的 UDF 逻辑。参见基于区域的外联示意图。
下一步是消除指令。即使经过外联,剩余 UDF 仍可能包含多条赋值指令。如果这些指令后来被内联到 SQL 中,每条赋值都可能变成一个 LATERAL 连接,使生成的查询难以解嵌套且执行缓慢。PRISM 利用 SSA 形式的单一定义属性来折叠函数。对于 y=f(x) 这样的指令,系统可以把 y 的每次使用替换为 f(x),并移除原始赋值。当变量只使用一次时,这种转换通常安全且有益。当变量多次使用时,PRISM 会考虑重复展开的成本以及目标数据库系统的能力。非查询表达式可以重复展开,因为优化器通常能够通过公共子表达式消除来移除冗余工作,而查询重复展开则更谨慎。结果是高度简化的 UDF,通常减少到单条 RETURN 指令。参见指令消除示意图。
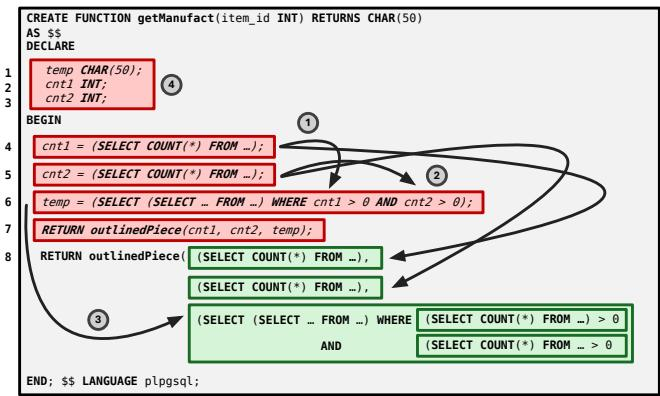
PRISM 还通过子查询省略降低 UDF 调用成本。一旦 UDF 被简化为单个返回表达式,系统就可以直接用该表达式替换调用查询中的原始 UDF 调用。这会跳过不必要的子查询生成,避免引入额外的关系式结构,而这些结构本来需要优化器处理。对于在 WHERE 子句中调用的 UDF,PRISM 还执行谓词上移。系统分析所有到达 RETURN 语句的执行路径,把每条路径转换为合取布尔条件,并通过析取合并各条路径。一条路径上的分支条件与一个生成的谓词相合取,该谓词将返回值与额外参数比较,使数据库优化器能够把谓词下推到计划更深层,并使用数据跳过机制。通常忽略包含循环的谓词,因为它们无法直接表示为简单过滤器。
实现将 UDF 注册步骤视为编译阶段。系统拦截 CREATE FUNCTION,解析过程体,使用数据库绑定器组件解析表达式和别名,并构建基于 SSA 的区域表示。外联片段会作为编译代码输出,内联片段则物化为 SQL 表达式或查询片段。这种架构将编译、内联、外联和谓词重写统一到一个流水线中,生成更简单的关系式查询和更快的函数执行。
实验
实验评估集成到 DuckDB 和 SQL Server 中的 PRISM,在 ProcBench 和 TPC-H FROID 工作负载上比较 PRISM 优化后的 UDF 与 DBMS 内联,并在单线程、多线程和消融设置下进行。结果显示,当内联会产生复杂过程式计划、递归 CTE、LATERAL 连接或不透明谓词时,PRISM 能带来显著的质量优势,因为其简化和外联能够实现更高效的连接、集合导向解嵌套、编译执行以及数据跳过优化。结果也显示权衡和 DBMS 特定约束:DuckDB 保留并行收益,SQL Server 的收益可能受到并行执行限制和列存储下推行为的影响,而查询重复展开主要在其能够解锁更高效解嵌套时才有价值。
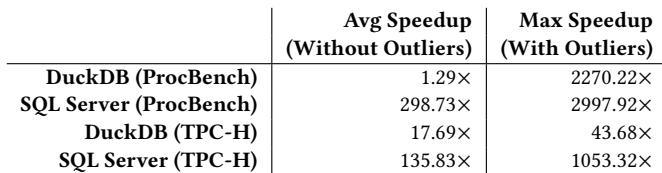
PRISM 在 ProcBench 和 TPC-H 上为 DuckDB 和 SQL Server 的 UDF 密集型查询带来显著的单线程加速,性能提升常常跨越多个数量级。SQL Server 通过基于连接的解嵌套 UDF 求值获得较大平均收益,而 DuckDB 在 ProcBench 上的平均收益较温和,但通过消除低效计划构造获得较大最大加速。在 TPC-H 上,两个系统都因更好的谓词暴露和数据跳过而受益,尽管最大值受离群查询驱动。在两个基准测试中,SQL Server 的平均加速都高于 DuckDB;DuckDB 的收益主要来自消除 LATERAL 连接、子查询和笛卡尔积计划;TPC-H 的改进来自暴露选择性谓词并启用数据跳过。
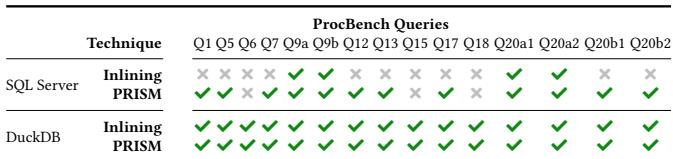
实验显示,无论基线内联还是 PRISM,DuckDB 都会对所有 ProcBench 子查询进行解嵌套,因此其性能提升不能归因于解嵌套失败。SQL Server 更依赖 PRISM,因为它无法对直接内联产生的许多子查询进行解嵌套,而 PRISM 简化后的 UDF 能让更大规模的查询解嵌套。PRISM 简化后的 UDF 使更多 SQL Server 查询适合子查询解嵌套,优于基线内联。DuckDB 在基线和 PRISM 设置下都已对列出的所有 ProcBench 查询进行解嵌套。PRISM 通过启用基于连接的执行,减少 SQL Server 需要以低效计划形式求值子查询的情况。
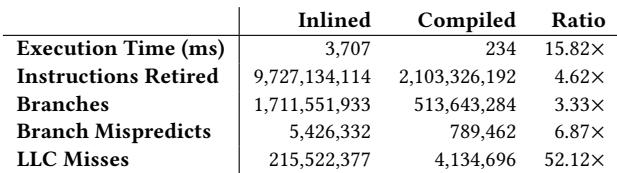
外联函数的编译使单线程查询远快于内联版本。改进与更少的指令数和分支数相关,尤其与末级缓存未命中大幅减少相关。更大的缓存收益来自避免用 SQL 结构模拟循环,因为这些结构需要额外工作表和连接工作。编译执行带来大幅执行时间减少。编译后指令和分支活动急剧下降。末级缓存未命中减少幅度大于其他计数器,从而减少由中间 SQL 结构造成的停顿。
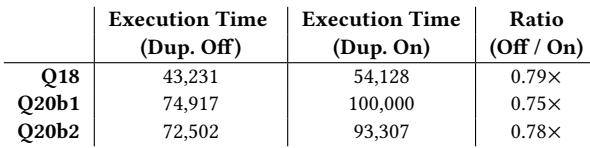
对于 SQL Server 上的三个 ProcBench 查询,启用查询重复展开会使执行比禁用它更慢。减速幅度不大,原因在于重复展开没有改变 SQL Server 是否会对这些查询进行解嵌套。由于解嵌套可能带来远大于重复展开开销的性能收益,该优化仍默认启用。查询重复展开让所有三个受测 ProcBench 查询的执行时间增加。禁用查询重复展开产生更好的归一化执行时间。与解嵌套可能带来的收益相比,重复展开开销很小。
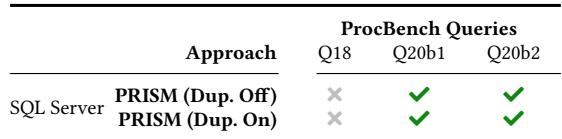
对于在 SQL Server 上测试的 ProcBench 查询,PRISM 的查询重复展开不会改变 DBMS 是否对生成的子查询进行解嵌套。启用或禁用重复展开时,Q18 都未完全解嵌套,而 Q20b1 和 Q20b2 在两种情况下都会解嵌套。由于重复展开对于这些查询可能只增加开销而不改善解嵌套,禁用它可以避免性能回归。对于受测 ProcBench 查询,查询重复展开对 SQL Server 解嵌套没有可观察影响。禁用重复展开可在这些查询上保持至少不劣于内联的性能。
实验使用 ProcBench 和 TPC-H 评估 PRISM 对 DuckDB 和 SQL Server 中 UDF 密集型查询的影响,结果显示简化的 UDF 编译和基于连接的执行带来显著的单线程加速。SQL Server 尤其受益,因为 PRISM 能实现更广的子查询解嵌套并避免低效子查询计划,而 DuckDB 的收益主要来自移除昂贵的 LATERAL、子查询和笛卡尔积构造,以及暴露选择性谓词和数据跳过。结果还显示,用于模拟循环的 SQL 结构会增加指令、分支和缓存未命中开销,而查询重复展开在无法改善解嵌套时可能导致轻微性能回归。