Command Palette
Search for a command to run...
OmniSketch:基于任意谓词的高效多维高速流式分析
OmniSketch:基于任意谓词的高效多维高速流式分析
Wieger R. Punter Odysseas Papapetrou
摘要
在不同学科领域中,一个关键需求是对高速数据流执行分析,其性质类似于关系数据库中的传统 OLAP 分析——即包含过滤和聚合操作。然而,由于高昂的存储需求以及在存储海量数据时引入的延迟,存储无界流并不是一种现实或可取的方法。因此,许多摘要/草图被提出,能够在小内存中(通常小到足以存储在 RAM 中)对流进行摘要,使得聚合查询可以被高效地近似,而无需存储完整的流。然而,过去的摘要主要针对单属性流的摘要,无法高效地处理在多个属性任意子集上的过滤和约束。在本工作中,我们提出 OmniSketch,这是第一个能够扩展到高速且复杂数据流(具有多个属性)的草图,并支持在多个属性上带有过滤条件的计数聚合,且这些过滤条件在查询时被动态选择。该草图提供概率保证、有利的空间-精度权衡,以及更新和查询执行的最坏情况对数复杂度。我们通过真实和合成数据进行实验验证,结果表明该草图优于当前最先进的方法,并且能够在配置的精度保证内近似复杂的即席查询,同时内存需求很小。
一句话总结
埃因霍温理工大学的研究人员提出了 OmniSketch,这是一种首个可扩展至高速多属性数据流的草图数据结构,支持在查询时动态选择多个属性并施加任意过滤器的计数聚合,提供概率性保证、良好的空间与精度权衡,以及更新和查询的对数最坏情况复杂度,同时在真实和合成数据上优于最先进方法。
核心贡献
-
OmniSketch 为高速多属性数据流提供了基于概要的摘要,并支持在查询时选择任意属性子集进行过滤的计数聚合。
-
该摘要基于 K-minwise hashing 构建紧凑的嵌套概要,同时提供概率性精度保证、良好的空间与精度权衡,以及更新和查询执行的最坏情况对数复杂度。
-
在真实和合成数据流上的实验表明,OmniSketch 在较小的内存占用下,能够在配置的错误保证内逼近复杂即席查询,在吞吐量上比先前最先进技术快两个数量级以上,并在使用 200 MB 概要的 11 属性数据流上达到每秒超过 89,000 次更新。
引言
高速多属性数据流,例如网络监控数据,需要紧凑摘要,以便在无需存储整个数据流的情况下回答聚合查询,因此基于概要的分析非常重要。现有概要通常只支持单属性或预定义谓词组合,覆盖任意多属性谓词需要指数级数量的概要,而 Hydra 等先前多维方案随着属性数量增加,更新时间和误差会迅速增长。作者利用一种称为 OmniSketch 的混合设计,将 Count-Min 风格概要方法与子概要内的固定大小 k-minwise 摘要结合起来,从而在多个属性上支持查询时谓词,具有线性或近线性复杂度、形式化误差保证,以及自动化的内存高效初始化流程。
数据集
-
数据集组成和来源:作者在论文链接的制品仓库中提供源代码、数据和其他制品。
-
关键子集细节:提供的文本未包含数据集子集大小、来源细分、过滤规则、模式字段或摘要统计信息。
-
数据使用方式:该材料被呈现为论文的附属制品,而不是带有明确训练划分或混合比例的训练语料。
-
处理与元数据:摘录未描述裁剪策略、元数据构建、清洗步骤或其他数据集处理细节。
方法
作者利用了一个扩展了记录标识符的 Count-Min 主干,使得可以在不物化底层数据集的情况下回答带多个谓词的基数查询。该方法围绕一种由三种变体共享的共同架构组织,各变体主要差异在于每个单元格保留多少记录信息,以及这些信息在估计过程中如何使用。
对于可搜索属性集合 A={a1,a2,…,a∣A∣},作者为每个属性维护一个属性概要。每个属性概要都是尺寸为 w×d 的二维数组 CMi,并与 d 个两两独立哈希函数 hi1(⋅),hi2(⋅),…,hid(⋅) 相关联。当一条记录到达时,它在属性 ai 上的值会被哈希到概要 CMi 中每一行 j 对应的一个桶中。不同于传统 Count-Min 概要只存储频率计数器的桶,每个桶存储一组记录标识符,即 rid 值,与所有对应属性值落入该桶的记录相关联。该设计允许查询执行将每个谓词转换为对相应属性概要的查找,然后通过集合交集组合取回的 rid 集合。
共同架构如下所示。
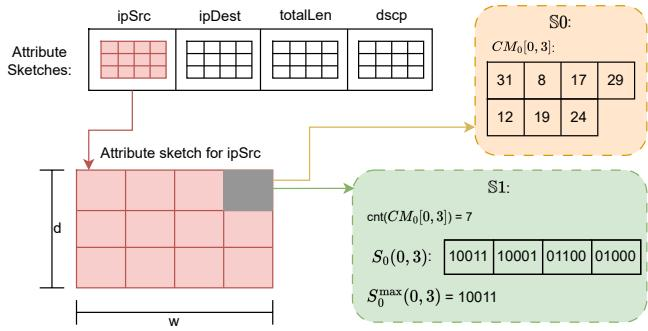
在称为 S0 的基线构造中,每条匹配记录都会被插入所有属性概要。在初始化时,作者选择 w=1+⌈e/ϵ⌉ 和 d=⌈ln(1/δ)⌉,以获得 (ϵ,δ) 保证。插入标识符为 r0 的记录时,记录 id 会被添加到每个桶 CMi[j,hij(ri)] 中存储的链表里,其中 ri 是该记录在属性 ai 上的值。
对于包含谓词 qi(例如 ai=vqi)的查询 q,作者首先考虑直观估计器 S0min。对于每一行 j,从每个相关属性概要中检索一个桶,并对存储的 rid 集合求交集。然后对各行的估计取最小值进行组合:
f^min(q)=j={1,…,d}minqi∈q⋂CMi[j,hij(vqi)].该估计器遵循标准 Count-Min 理念:所有真实匹配记录都保证被包含,因为相同值在每一行都会哈希到同一个桶中,但估计值可能因哈希碰撞导致的假阳性而被夸大。作者证明该构造满足概率界
Pr(f^(q)−f(q)≤ϵN)≥1−δ.作者随后观察到,S0 中已有的完整 rid 信息能够在不改变概要结构的情况下支持更紧的估计器。在 S0∩ 中,去除了逐行最小值。相反,算法在谓词和行之间对 rid 集合求交集:
f^(q)=i={1,…,p},j={1,…,d}⋂CMi[j,hij(vqi)].这个更强的估计器利用了一个事实:真实匹配记录必须在所有谓词的所有行中都发生碰撞,而假阳性记录发生这种情况的可能性小得多。因此,误差界改进为
Pr(f^(q)−f(q)≤ϵd(N−f(q))≤ϵdN)≥1−δ.最终的 OmniSketch 变体记为 S1,它保留相同的整体架构,但用有界 minwise 样本替换完整 rid 集合,使空间相对于数据流长度变为亚线性。每个单元格 CMi[j,k] 存储三项信息:哈希到该单元格的记录总数,由辅助哈希函数 g(r0) 产生的最多 B 个哈希 rid 值样本,以及该单元格中的最大样本哈希值。哈希函数 g 将记录标识符映射为 b 位值,其中 b 的选择用于支持 minwise 采样保证。
在插入期间,算法首先递增新记录在各属性概要中映射到的每个单元格的计数器。随后,它决定是否将记录的 g(r0) 值插入该单元格的样本。如果样本未满,则直接添加该值。如果样本已满,则仅当新哈希值小于当前最大值时,才用新值替换当前最大值。这样,每个单元格会产生一个大小为 B 的 minwise 样本。
S1 中的查询估计沿用了改进的 S0∩ 逻辑,但作用在样本上而不是完整 rid 集合上。查询会识别所有属性概要和所有行中的相关单元格,将 nmax 计算为这些单元格中的最大单元格计数,并对这些单元格中存储的样本求交集:
S∩=i={1,…,p},j={1,…,d}⋂Si(j,hij(vqi)).OmniSketch 估计器为
f^(q)=Bnmax×∣S∩∣.该缩放纠正了每个单元格只保留有限数量记录这一事实。作者还提供了合理性界,用于样本交集太小而无法支持可靠缩放估计的情况。该方法相对于样本大小保持对数插入时间,并在每个单元格的样本存储在有序数据结构中时,高效支持跨样本的多路连接。
该框架还可以通过为每个数值属性概要添加二分范围版本来扩展到范围谓词。对于数值属性,多个内部概要存储随 2 的幂递增范围的统计信息。一条记录会被插入到包含其值的所有二分范围对应的概要中,而范围查询会被分解为其规范二分覆盖,并在查询执行期间合并相应的基于样本或基于 rid 的单元格集合。
实验
实验在真实网络监控数据流和合成数据上评估所提出的概要,使用多种查询工作负载来评估摄入效率、内存使用、精度和查询执行。比较表明,S1 提供了最佳的整体权衡,相比 S0 变体更高效地扩展,并在属性数量较多的数据流上优于 Hydra。附加结果表明,S1 在不同数据分布、大数据流规模和范围查询设置下仍保持高效和准确。
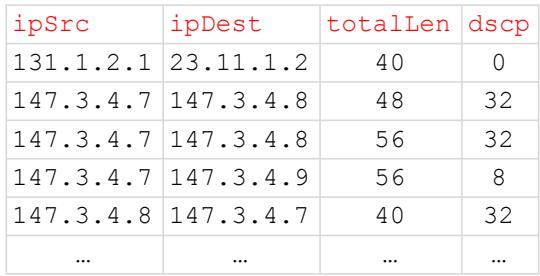
示例数据流展示了查询如何对源地址、目的地址、长度和 DSCP 等网络属性施加谓词。在报告的实验中,支持范围的 S1 以内存和摄入时间的线性增长来摘要多个属性。支持范围查询会增加开销,但观察到的影响仍然较小,同时精度保持较高。内存和摄入时间随被摘要属性数量线性增长。范围支持会增加二分范围状态,但由于许多大范围是稀疏的,开销比预期更小。范围查询的平均误差保持较低,并在预期界内。
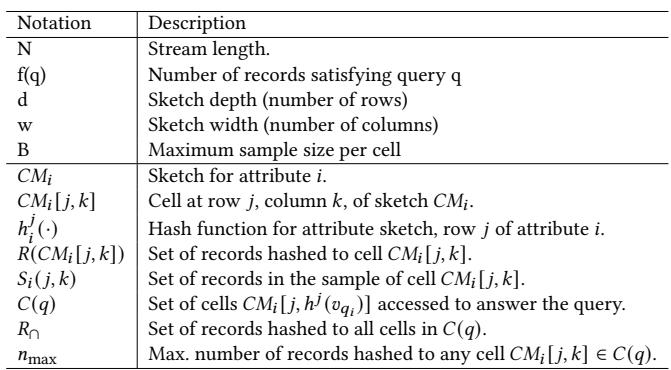
记号定义了数据流大小、查询基数、概要维度、每单元格样本容量,以及用于频率估计的属性概要。实验结果表明,支持范围的概要保持时间和内存增长随属性数量线性变化,而在相同样本预算下相比标准概要有额外开销。它们的范围查询估计保持准确,平均误差低且在所报告的理论界内。存储和摄入随可搜索属性数量线性扩展。添加范围支持会使用更多内存和时间,因为更多内部属性概要存储二分范围。范围查询估计表现出低平均误差,并保持在所报告的理论保证内。
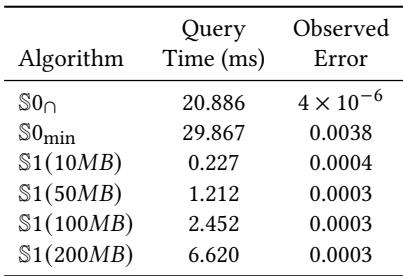
S1 变体执行查询比 S0 估计器快得多,更大的内存配额往往会增加查询时间。S0∩ 估计器观察到最低平均误差,而在 S0 方法中 S0min 查询执行较慢且误差较大。S1 在不同内存设置下保持低误差,尽管允许更多内存时执行变慢。S1 查询执行明显快于 S0 执行。S0∩ 提供最准确的估计,而更大的 S1 内存设置能保持低误差但增加查询时间。
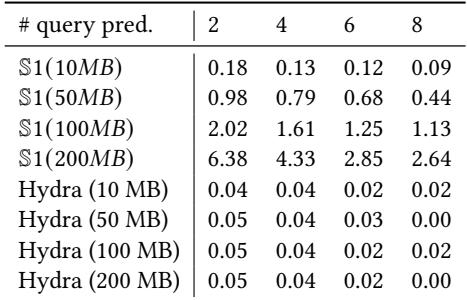
表格比较了在相等内存预算下 S1 和 Hydra 在谓词数量递增查询上的查询执行时间。Hydra 总体上仍然更快,执行时间保持很低,随着谓词增加变化不大。S1 较慢,尤其在更大内存配额下,尽管当查询包含更多谓词时其查询时间通常会下降。在所有比较的内存预算中,Hydra 的查询执行时间都低于 S1。S1 查询时间随内存分配增大明显增长,但随谓词数量增加往往缩减。
实验评估了支持范围的 S1 概要用于网络流查询,衡量内存、摄入、范围查询精度、相对于 S0 估计器的查询执行,以及相对于 Hydra 的性能。实验发现,支持多个属性和范围谓词在内存和摄入时间上线性扩展,开销适中,估计仍在理论界内保持准确。查询比较表明,S1 明显快于 S0 估计器并保持低误差,而 S0 提供更高精度,Hydra 在各种设置下都取得了低于 S1 的执行时间,尽管 S1 的查询时间往往随谓词数量增加而减少。