Command Palette
Search for a command to run...
查询优化器究竟有多好?
查询优化器究竟有多好?
Viktor Leis Peter Boncz Andrey Gubichev Alfons Kemper Atanas Mirchev Thomas Neumann
摘要
找到良好的连接顺序对查询性能至关重要。本文提出了 Join Order Benchmark(JOB),并利用一个复杂的真实世界数据集和现实的多连接查询,通过实验重新审视了经典查询优化器架构中的主要组件。我们调查了工业级基数估计器的质量,发现所有估计器都会频繁产生较大误差。我们进一步表明,虽然基数估计对于寻找良好的连接顺序至关重要,但如果查询引擎过度依赖这些估计,则查询性能并不理想。通过另一组实验来衡量成本模型的影响,我们发现成本模型对查询性能的影响远小于基数估计。最后,我们研究了查询计划枚举技术,将穷尽动态规划与启发式算法进行比较,发现即使在基数估计次优的情况下,穷尽枚举仍然能够提升性能。
一句话总结
TUM 与 CWI 的研究者提出 Join Order Benchmark (JOB),以实验方式重新审视经典查询优化器架构的主要组件在真实多连接查询上的表现,发现基数估计器通常会产生较大误差,成本模型在测试环境中对性能的影响远小于基数估计,并且尽管估计结果并非最优,穷举式计划枚举仍能改善性能。
核心贡献
-
论文提出 Join Order Benchmark (JOB),基于高度相关的 IMDB 真实世界数据集和真实的多连接查询,并提供衡量基数估计准确性的方法,用于评估查询优化器质量。
-
重新审视经典查询优化器架构的实验表明,工业级基数估计器通常会产生随连接数量增加而增大的大误差,而在所测试的主内存环境中,成本模型对性能的影响远小于基数估计。
-
对计划枚举技术的比较发现,穷举式动态规划比启发式算法产生更好的计划,即使基数估计并非最优,也能提升查询性能。
引言
在数据库系统中,选择高效的连接顺序是查询优化的核心,因为糟糕的计划可能使分析查询慢几个数量级。传统基于成本的优化器依赖基数估计以及均匀性和独立性等简化假设,这些假设在真实、高度相关的数据上常常失效,尤其是在多连接查询和索引丰富的主内存数据库中。先前工作通常孤立地研究基数估计或计划枚举,或使用合成查询和简化设置,因此每个优化器组件如何影响端到端性能仍存在不确定性。作者利用 IMDB 数据集构建公开的 Join Order Benchmark,并对主流 PostgreSQL 风格优化器组件进行新颖的端到端评估。他们的主要贡献是提供一个现实框架,用于衡量基数估计、成本模型和计划枚举之间的相互作用,表明基数误差是主要问题,在主内存中简单成本模型可能已经足够,穷举式枚举可以避免许多灾难性计划。
数据集
-
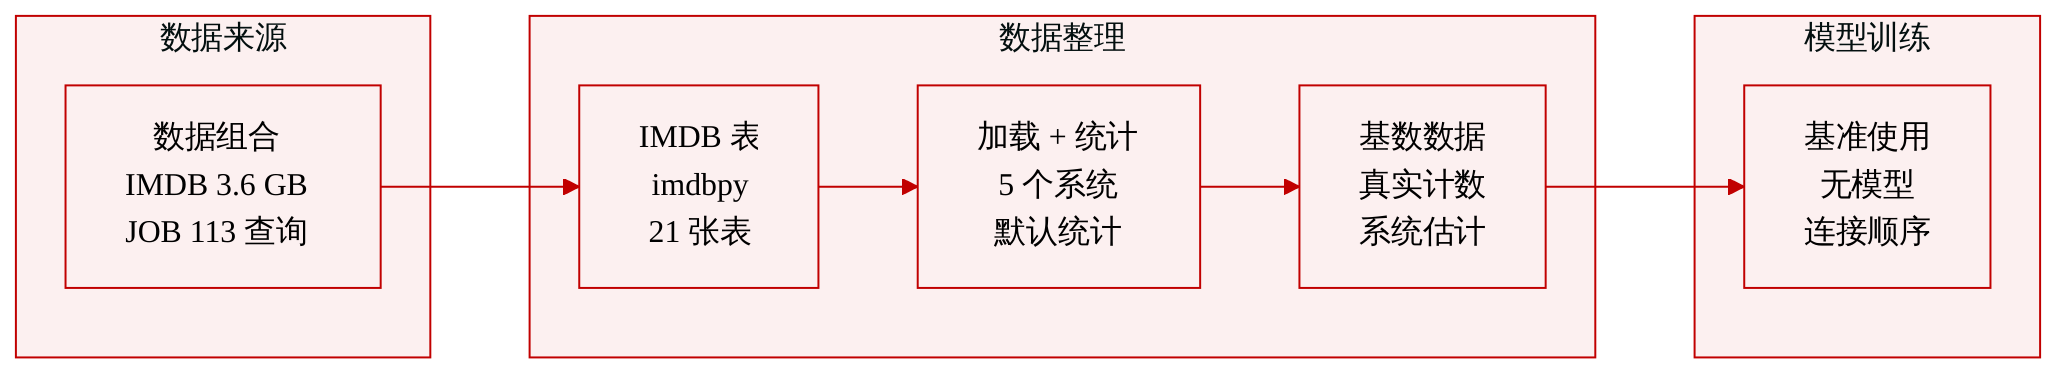
作者从 Internet Movie Database (IMDB) 构建数据集,这是一个真实世界的关系数据集,以文本文件形式发布,用于非商业目的。
-
他们使用开源 imdbpy 包将 IMDB 文本文件转换为包含 21 张表的关系数据库。
-
IMDB 快照来自 2013 年 5 月,导出为 CSV 文件时占用 3.6 GB。
-
最大的两张表是 cast_info,有 3600 万行,以及 movie_info,有 1500 万行。
-
作者选择 IMDB,是因为它包含真实的相关性和非均匀分布,不同于 TPC-H、TPC-DS 和 SSB 等合成基准。
-
在 IMDB 数据库之上,他们构建 Join Order Benchmark (JOB) 查询负载。
-
JOB 查询集包含 33 种查询结构,每种结构有 2 到 6 个仅在选择谓词上不同的变体,总计 113 个查询。
-
这些查询是分析型选择-投影-连接查询,包含 3 到 16 个连接,平均每个查询 8 个连接。
-
查询连接图同时包含键到外键边,以及由传递连接谓词引起的外键到外键边。
-
一些查询变体包含更复杂的选择谓词,例如析取和 LIKE 子串搜索。
-
作者有意避免过于对抗性的谓词,例如极端相关性、不等值连接谓词和非代理键谓词。
-
他们使用这些数据评估基数估计和连接排序,而不是训练模型。
-
对于基数提取,作者将 IMDB 载入多个关系数据库系统,并运行每个系统的默认统计信息收集过程。
-
随后,他们使用每个系统的原生计划或估计命令,提取 JOB 查询所有中间结果的基数估计。
-
他们还通过执行 SELECT COUNT 查询计算每个中间结果的真实基数。
-
当外键索引可能影响中间结果大小时,他们还会额外收集选择谓词应用前后的基数估计。
方法
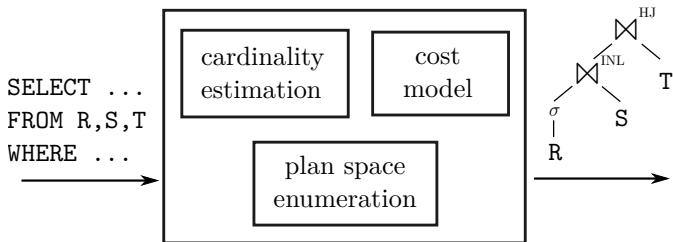
作者构建了一个可控的查询优化器分析框架,将基数估计、成本建模和计划枚举视为彼此分离但相互作用的模块。PostgreSQL 被用作代表性基线优化器,因为它实现了常规优化器架构:通过动态规划进行连接顺序枚举、针对物理计划的成本模型,以及基于统计的基数估计器。优化器枚举连接顺序,包括灌木树但不包含带有笛卡尔积的树,然后通过估计成本比较替代物理计划。在执行时,引擎对选定的物理算子计划采用 Volcano 风格解释执行,访问路径包括全表扫描和非聚簇 B+Tree 索引查找,连接实现包括嵌套循环、索引嵌套循环、内存哈希连接和排序合并连接。物理连接算法的选择由优化器固定,而不是在执行期间动态决定。
基数估计器是该框架的核心模块。PostgreSQL 从按属性采样的统计信息估计基表基数,包括分位数直方图、最常见值及其频率,以及域基数,后者表示不同值的数量。对于直方图无法处理的谓词,系统会退回到没有形式化依据的临时假设。当同一表上的多个谓词需要合并时,PostgreSQL 假设独立性,并相乘各个选择率估计。连接基数使用标准的基于大小的公式进行估计
∣T1⋈x=yT2∣=max(dom(x),dom(y))∣T1∣∣T2∣,其中 T1 和 T2 为任意表达式,dom(x) 为属性 x 的域基数。该公式嵌入了基线估计器使用的假设,即非频繁值上的均匀性、跨谓词和连接属性的独立性,以及包含原则,其中假设较小的连接域被较大的连接域覆盖。
该框架还包括用于基数估计的专用提取与注入流程。作者首先将数据集载入多个数据库系统,并使用默认设置运行每个系统的统计信息收集命令。然后,他们发出实验中使用的查询,并检索原始查询产生的每个中间结果的优化器估计。对于形式如下的链式查询
σx=5(A)⋈A.bid=B.idB⋈B.cid=C.idC,中间结果包括选择结果、第一次连接结果、第二次连接结果和最终连接结果。该流程还认识到,物理访问方法会引入额外的中间结果,这些结果并不总是出现在逻辑计划中。当索引嵌套循环连接使用外键上的非唯一索引时,系统可能先生成索引查找结果,然后再应用来自另一侧的选择。因此,必须捕获选择前和选择后的中间结果基数。为了建立评估基准,框架还执行基于计数的查询,以获取每个中间结果的真实基数。
为在单个执行引擎内评估不同基数估计的影响,作者修改 PostgreSQL,使优化器能够为任意连接表达式接收注入的基数。该模块允许 PostgreSQL 使用其他数据库系统产生的估计,或直接根据数据测量的真实基数,而不是生成自身估计。这一设计比仅指定谓词选择率更通用,因为基数注入能够表示跨关系的相关性和任意表达式树,而不仅是单个谓词的选择率。
成本模型模块独立于枚举模块处理。PostgreSQL 默认面向磁盘的模型将算子成本计算为顺序磁盘页、随机磁盘页和内存内数据处理等项的加权组合,计划总成本为算子成本之和。由于默认成本变量难以精确校准,该框架还引入用于可控评估的简化内存成本模型。该模型不显式建模磁盘 I/O,而是统计各算子处理的元组数量,并为表扫描、哈希连接和索引嵌套循环连接分配相对权重:
Cmm(T)=⎩⎨⎧τ⋅∣R∣∣T∣+Cmm(T1)+Cmm(T2)Cmm(T1)+λ⋅∣T1∣⋅max(∣T1∣∣T1⋈R∣,1)if T=R∨T=σ(R),if T=T1⋈HJT2,if T=T1⋈INLT2, (T2=R∨T2=σ(R)).其中,R 是基关系,τ 相对于连接折扣基表扫描成本,λ 近似索引查找相对于哈希表查找的相对开销。实现使用 λ=2 且 τ=0.2,并在内关系不是通过索引查找访问时禁用嵌套循环连接。
对于计划空间探索,作者使用一个独立查询优化器,该优化器能够从任何来源接收注入的基数估计,并使用动态规划和启发式算法枚举计划。框架不直接执行大量生成的计划,而是使用简化内存成本模型和真实基数重新计算每个计划的成本,从而评估每个计划。这会产生一种代理执行成本,近似运行时间,同时不需要系统运行每个候选计划。因此,该设计将枚举算法的影响、基数估计的准确性以及成本模型的影响分离,使框架能够隔离每个优化器组件对最终查询性能的贡献。
实验
实验使用主内存 PostgreSQL 设置和真实 IMDB 负载,评估基数估计、计划性能、成本模型和连接顺序枚举,并与 TPC-H 进行额外比较。对于基于采样的系统,基表估计通常良好,但连接估计会急剧退化,并经常低估真实基数,尤其是在相关查询和复杂物理设计中。这项工作表明,基数准确性的影响超过成本模型的复杂程度,并且高风险连接选择会导致严重减速,而稳健计划选择和运行时参数调整可以缓解估计不佳。穷举式枚举提供有用的收益,但改进基数估计仍然是获得更好查询优化最重要的路径。
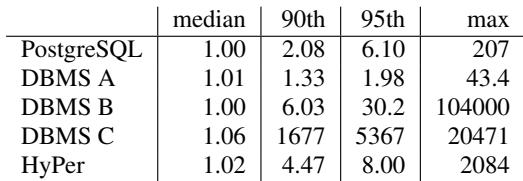
大多数系统能很好地估计大多数基表选择,q-误差中位数接近最优值。尾部误差在不同系统间差异很大,基于采样的系统在复杂谓词上通常优于基于直方图的系统。大误差通常来自非常低的选择率场景,或来自无法捕获属性相关性的估计。中位数接近 1,因此典型选择能够被正确估计。DBMS A 和 HyPer 在复杂谓词上表现最强,可能因为它们使用表采样。基于直方图的系统表现出明显更差的尾部误差,尤其是在相关或复杂谓词上。
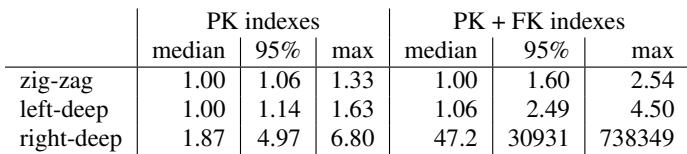
将连接顺序搜索限制为特定树形会相对于允许灌木树的最优计划增加查询成本。之字形树通常仍接近最优,仅显示中等程度的最坏情况减速,而左深树稍差但仍合理。右深树表现差得多,尤其是在有更多索引可用时,因为它们会创建大型中间哈希表,并限制索引查找机会。之字形树保留了大部分最优计划质量,仅在困难情况下轻微退化。左深树与之字形树相比损失一些性能,但仍给出可接受的计划。右深树会导致严重减速,不适合作为通用且唯一的搜索空间。
穷举式动态规划在不同索引配置下产生的计划最接近归一化最优成本,而 Quickpick-1000 和 Greedy Operator Ordering 给出略高的成本。当可用索引较少时,这些启发式方法更具竞争力,而在索引更丰富的设置中可靠性更低,尤其是在根据估计基数选择计划时。结果表明,估计质量可能成为穷举搜索与受限启发式方法之间实际差异的主要因素。在仅主键索引和更丰富索引设置下,动态规划仍是最可靠的算法。Quickpick-1000 和 Greedy Operator Ordering 在索引丰富设置和较差基数估计下表现出更大的成本损失。
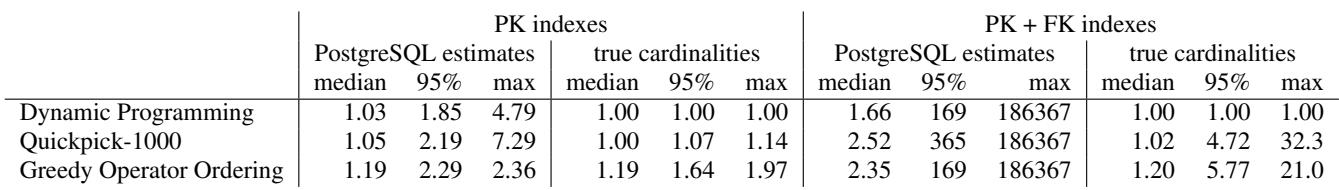
实验评估不同索引设置下的基数估计、连接顺序搜索空间限制和连接顺序算法质量。典型基表选择被准确估计,但尾部误差差异很大,基于采样的方法通常比基于直方图的方法更好地处理复杂或相关谓词。连接顺序实验表明,之字形树和左深树仍合理接近最优,而右深树可能导致成本大幅增加。穷举式动态规划产生最可靠的计划,而启发式搜索方法在索引较多或基数估计较差时退化更明显。