Command Palette
Search for a command to run...
Dataflow 模型:一种在大规模、无界、乱序数据处理中平衡正确性、延迟与成本的实用方法
Dataflow 模型:一种在大规模、无界、乱序数据处理中平衡正确性、延迟与成本的实用方法
摘要
无界、无序、全球规模的数据集在日常业务中日益普遍(如 Web 日志、移动端使用统计和传感器网络)。与此同时,这些数据的使用者已形成复杂的需求,例如基于事件时间的排序、按数据自身特征进行窗口划分,以及对更快响应的迫切需求。然而,从实际角度来看,对于这类输入,人们无法在所有维度——正确性、延迟和成本——上同时实现完全优化。因此,数据处理从业者面临着一个两难困境:如何调和这些看似相互矛盾的命题,这往往导致实现方案和系统的碎片化。我们提出,面对现代数据处理中不断演进的需求,必须从根本上转变思路。作为整个领域,我们必须停止试图将无界数据集规整为最终完备的有限信息池,转而接受一个基本假设:我们永远无法确定是否已经或何时会看到所有数据,只能确认新数据会到来、旧数据可能被撤回,而使这一问题变得可处理的唯一途径,是通过有原则的抽象,使从业者能够根据其在正确性、延迟和成本这些关注维度上的需要,自行做出适当的权衡。本文提出了这样一种方案——Dataflow 模型,并详细考察了该模型所支持的语义、指导其设计的核心原则概述,以及通过推动其发展的实际工程经验对该模型本身进行的验证。
一句话总结
Google 提出了 Dataflow Model,这是一套用于处理无界、无序、乱序数据流的原则性抽象;它使实践者能够显式选择正确性、延迟和成本之间的权衡,而不是被迫将数据纳入有限且完整的数据池。该模型已通过真实世界生产经验得到验证。
核心贡献
- 论文引入了 Dataflow Model,这是一个面向无界数据集的统一模型。它通过事件时间排序、非对齐窗口、灵活触发、集成累积和撤回等原则性抽象,让实践者能够在正确性、延迟和成本之间进行显式权衡。
- 论文通过分离以下要素来定义模型的核心语义和设计原则:计算哪些结果、在事件时间中的何处进行计算、在处理时间中的何时物化,以及较早结果如何与后续精化结果相关联;同时抽象掉批处理、微批处理和流式引擎之间的差异。
- 论文通过分析和 Google 规模无界数据处理的真实体验来支持该模型,包括 MillWheel 和大型日志连接管线,展示该模型如何应对事件时间倾斜、弱一致流式结果以及流式与批处理的统一实现。
引言
现代数据处理系统必须处理大规模、无界且经常乱序的数据流,同时为广告分析、运维监控和准实时决策等用例产生及时且正确的结果。作者说明,现有批处理系统可能过于缓慢,因为它们处理已经收集完成的输入;而许多流式系统在全局规模上会面临容错、精确一次正确性、富有表现力的事件时间窗口、会话窗口或简洁性方面的困难。为解决这些差距,作者利用一个统一编程模型,该模型将逻辑管线与底层批处理、微批处理或流式引擎解耦。该模型支持非对齐事件时间窗口、灵活触发、增量更新和撤回,以及对正确性、延迟和成本之间权衡的显式控制。
方法
作者利用一个统一的 Dataflow 模型,用同一套语义描述批处理、微批处理和流式管线。在该模型中,管线数据在概念上被视为形如 (key,value,eventtime,window) 的元组。事件时间戳可以在输入阶段分配,也可以在处理过程中修改;窗口字段决定一条数据在事件时间中的分组位置。这种表示允许同一管线定义表达纯批处理计算、低延迟流式处理以及类似 Lambda 架构管线的混合模式。
框架核心是两个并行原语。第一个是 ParDo,它对每个输入元素应用用户定义的 DoFn。对于每个输入元素,DoFn 可以发出零个或多个输出元素,因此 ParDo 支持映射、过滤、展开以及其他元素级变换。第二个原语是 GroupByKey,它收集与同一键关联的所有值。GroupByKey 很强大,但在无界流上会成为问题,因为系统无法知道某个键的最后一个值是否已经到达。因此,该模型将分组与时间界限窗口相结合,使聚合在键和窗口上执行,而不是仅在键上执行。
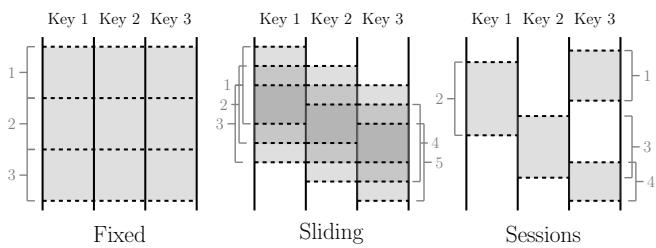
作者通过将其拆分为两个操作,使窗口成为模型的一等公民。AssignWindows 根据每个输入元素的时间戳,将其放入零个或多个窗口。例如,被分配到滑动窗口的元素可能被复制到每个包含其时间戳的窗口。MergeWindows 在分组期间应用,允许重叠或相邻的窗口被组合。这种拆分对于会话等数据驱动窗口方案至关重要。在会话窗口中,每个元素最初会创建一个延伸至其事件时间之外的临时窗口,随后的分组可以将重叠的会话窗口合并为单个会话。
为具体说明,作者考虑一个求和管线,其中 GroupByKey 变成复合操作 GroupByKeyAndWindow。该操作在概念上由 DropTimestamps、GroupByKey、MergeWindows、GroupAlsoByWindow 和 ExpandToElements 组成。DropTimestamps 步骤很有用,因为在分配之后,窗口归属成为主要分组信号。MergeWindows 实现特定于策略的合并,例如合并重叠的会话。GroupAlsoByWindow 生成按键和按窗口的值分组,ExpandToElements 将分组后的结果物化回带时间戳的元素。作者设计该模型,使所有窗口从模型视角都被视为非对齐窗口,而执行引擎在检测到对齐窗口模式时仍可进行优化。
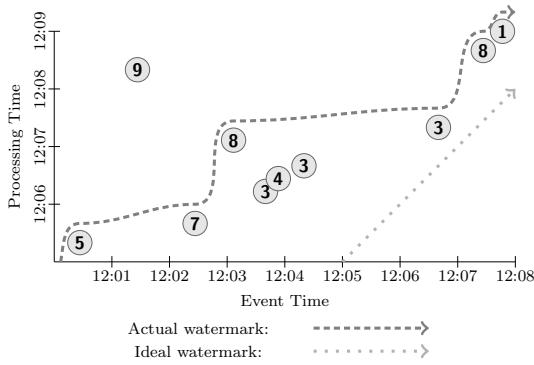
示例输入数据有助于理解该模型如何随时间变化而表现。数据包含某个键的十个整数观测值。横轴表示事件时间,即事件实际发生的时间;纵轴表示处理时间,即管线观测到事件的时间。可视化还显示两条水位线路径:一条理想水位线以与事件时间完全同步的方式推进,另一条现实水位线可能由于分布式系统倾斜而延迟或不准确。有一条值为 9 的观测值在水位线之后到达,因此是迟到数据。这促使系统需要具备不假设完全完备性的机制。
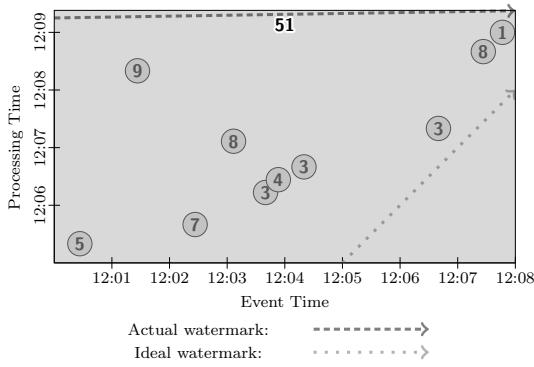
当该管线以经典批处理模式运行时,行为很直接。系统会等待有界输入完成,将该键的所有值归入一个分组,并输出单一求和结果。由于经典批处理通常不感知事件时间,默认窗口是覆盖所有事件时间的全局窗口,结果覆盖作业的全部处理时间。下一个可视化中的阴影区域表示总和 51,它在所有输入处理完成后物化。
对于无界流式数据源,同一全局窗口不能只依赖默认水位线触发器,因为全局窗口永远不会变为完成。作者通过引入触发器来解决这个问题,触发器决定在处理时间的何时将窗口的当前结果作为 pane 输出。pane 不一定是窗口的最终答案;它可以是估计值、部分结果或精化结果。这种触发机制与窗口化互补。窗口化选择数据在事件时间中的分组位置,触发选择分组结果在处理时间中的何时被观测。
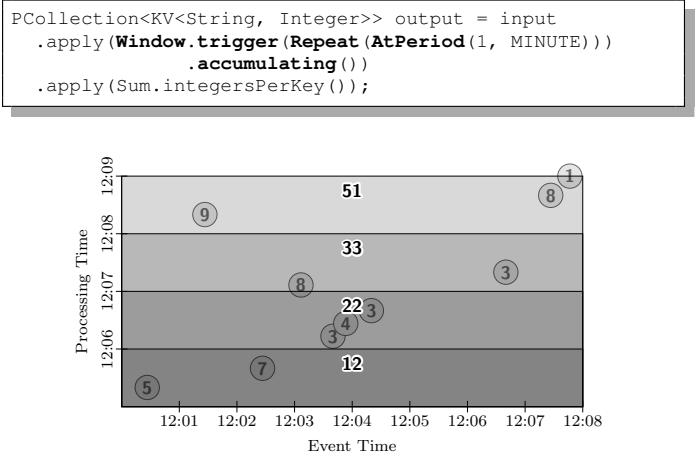
如果目标是维护全局按键求和并接收周期性更新,作者可以应用重复周期性触发器并使用累积模式。在累积模式下,每个新 pane 都是对前一个 pane 的精化,因为窗口内容仍然可用,较新的结果会在下游覆盖或更新较旧的结果。该执行可视化显示在每隔一分钟的处理时间边界处的全局求和更新。重叠的输出区域表明,每次输出都包含从此前处理时间间隔累积的数据。
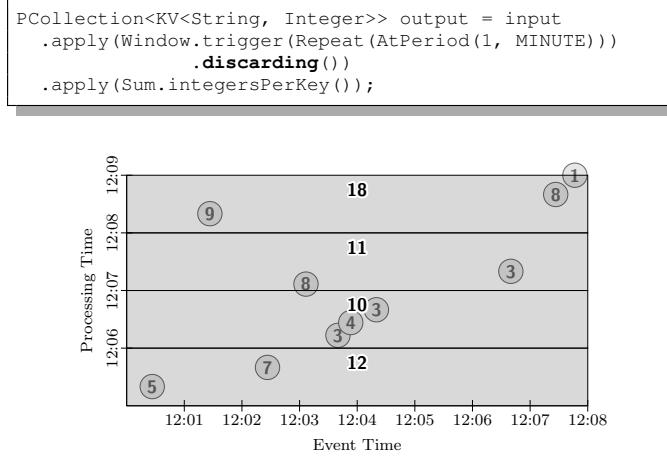
将累积模式改为丢弃模式会改变输出语义,同时保留触发器结构。在丢弃模式下,每次触发都会输出当前 pane 的结果,然后清除窗口状态。因此,后续 pane 与较早 pane 相互独立,输出表示增量而不是累计总和。这种模式非常接近许多流式系统中发现的处理时间窗口行为,尽管它是通过统一的触发器与窗口模型实现的。可视化显示不重叠的输出区域,这些区域的求和对应于两次触发之间观测到的数据。
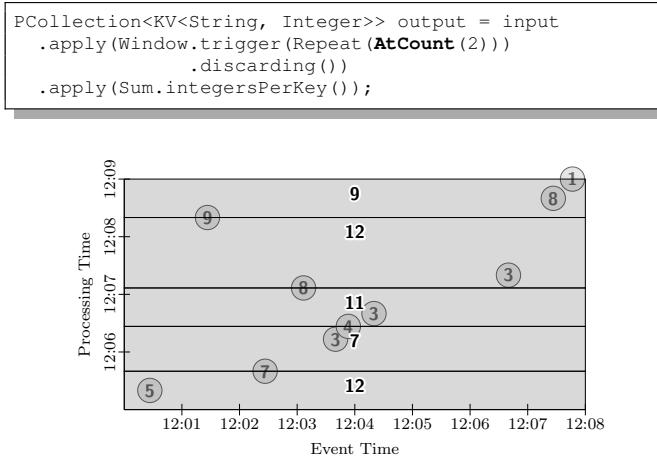
模型也可以使用数据驱动触发器来表达基于元组的窗口。触发器可以不基于时间触发,而是在观测到一定数量的元素时触发。当作者将触发器设置为每两条记录后触发并使用丢弃模式时,每个 pane 都包含按处理时间相邻两条观测值的和。这在无需引入独立窗口抽象的情况下产生了元组窗口语义。最后的可视化说明了这种执行,其中输出 pane 是根据数据到达计数生成的,而不是根据周期性时钟或事件时间边界生成的。
除了基于时间和基于数量的触发器之外,作者还支持水位线触发器、百分位水位线触发器、处理时间触发器以及自定义外部信号。触发器也可以使用逻辑运算、循环和序列进行组合。这种可组合性使管线能够在数据到达时输出早期部分结果,然后在水位线推进时输出更完整的结果,并在迟到数据到达时可选地输出更新结果。多个 pane 之间的精化关系由丢弃、累积以及带撤回的累积模式控制。在累积和撤回模式下,每次更新都会伴随对先前值的撤回,当窗口产生多个结果并且这些结果稍后在下游再次分组时,这一点很重要。该设计使管线能够同时适配早期近似结果和延迟修正,而无需依赖单独的批处理恢复路径。