Command Palette
Search for a command to run...
Hadoop-GIS:基于 MapReduce 的高性能空间数据仓库系统
Hadoop-GIS:基于 MapReduce 的高性能空间数据仓库系统
Ablimit Aji Fusheng Wang Hoang Vo Rubao Lee Qiaoling Liu Xiaodong Zhang Joel Saltz
摘要
对大规模空间数据执行高性能查询在许多应用领域中变得日益重要,包括众多领域的地理空间问题、基于位置的服务,以及日益数据密集和计算密集的新兴科学应用。大规模空间数据的涌现得益于低成本且 ubiquitous 的定位技术的普及、高分辨率成像技术的发展,以及大量社区用户的贡献。管理和查询大规模空间数据以支持空间查询面临两大主要挑战:空间数据的爆炸式增长,以及空间查询的高计算复杂度。本文提出 Hadoop-GIS——一个可扩展的高性能空间数据仓库系统,用于在 Hadoop 上运行大规模空间查询。Hadoop-GIS 通过空间分区、可定制的空间查询引擎 RESQUE、在 MapReduce 上的隐式并行空间查询执行,以及通过处理边界对象来修正查询结果的有效方法,支持多种类型的空间查询。Hadoop-GIS 利用全局分区索引和可定制的按需局部空间索引来实现高效的查询处理。Hadoop-GIS 与 Hive 集成,通过一体化架构支持声明式空间查询。实验表明,Hadoop-GIS 在查询响应方面具有高效率,在普通集群上运行时具有良好的可扩展性。对比实验表明,Hadoop-GIS 的性能与并行空间数据库管理系统(SDBMS)相当,且在计算密集型查询上优于 SDBMS。Hadoop-GIS 以一组用于处理空间查询的库以及 Hive 中的集成软件包形式提供。
一句话总结
来自 Emory University 和 The Ohio State University 的研究人员提出 Hadoop-GIS,这是一个基于 Hadoop/MapReduce 的可扩展空间数据仓库系统。该系统结合全局分区索引、可定制的按需局部空间索引,以及带边界对象处理的 RESQUE 查询引擎,能够高效执行大规模空间查询。其性能与并行空间数据库管理系统相当,并在计算密集型工作负载上表现更优,同时将声明式空间查询集成到 Hive 中。
核心贡献
- Hadoop-GIS 是基于 Hadoop 的空间数据仓库系统,通过空间分区、隐式并行 MapReduce 执行和边界对象处理,支持多种类型的大规模空间查询并生成正确结果。该系统面向普通集群上的海量空间数据。
- 通过将全局分区索引、可定制的按需局部空间索引以及 MapReduce 内的 RESQUE 空间查询引擎协同设计,系统实现高效查询处理。这种多级索引与引擎设计支持多种空间查询类型。
- Hadoop-GIS 被集成到 Hive 中,以一体化架构支持声明式空间查询。两个真实应用场景的实验表明,该系统查询响应高效、可扩展性强,性能与并行 SDBMS 相当,并在计算密集型查询上表现更优。
引言
无处不在的定位传感器、社区地图平台和科学成像工具现在会生成海量空间数据,这些数据很重要,因为空间分析能够推动位置感知服务、社会科学研究和数字病理工作流。现有系统在这一规模下存在不足:传统并行空间数据库成本高、调优困难,并且加载数百万个复杂对象的速度很慢,而通用 MapReduce 平台的空间查询支持较弱,还会因数据分区倾斜和跨边界对象导致错误结果。作者利用 MapReduce 和 Hive 提出一种空间数据仓库系统,该系统融合空间分区、索引驱动查询执行、边界对象处理和扩展的声明式查询接口。主要贡献是提供了一个可扩展且成本效益高的架构,用于表达丰富的分析型空间查询,包括点查询、包含查询、连接查询、交叉匹配、最近邻查询和基于特征的查询。
数据集
-
论文使用两个真实数据集评估性能:一个病理成像数据集和一个 OpenStreetMap 数据集。
-
Pathology Imaging dataset:
- Source:Emory University Hospital 提供的病理图像。
- Data type:用于分析和分割细胞核、肿瘤区域等微观解剖对象的组织病理图像。
- Spatial annotations:对象边界经过验证和归一化,并以 Well-Known Text 格式存储。
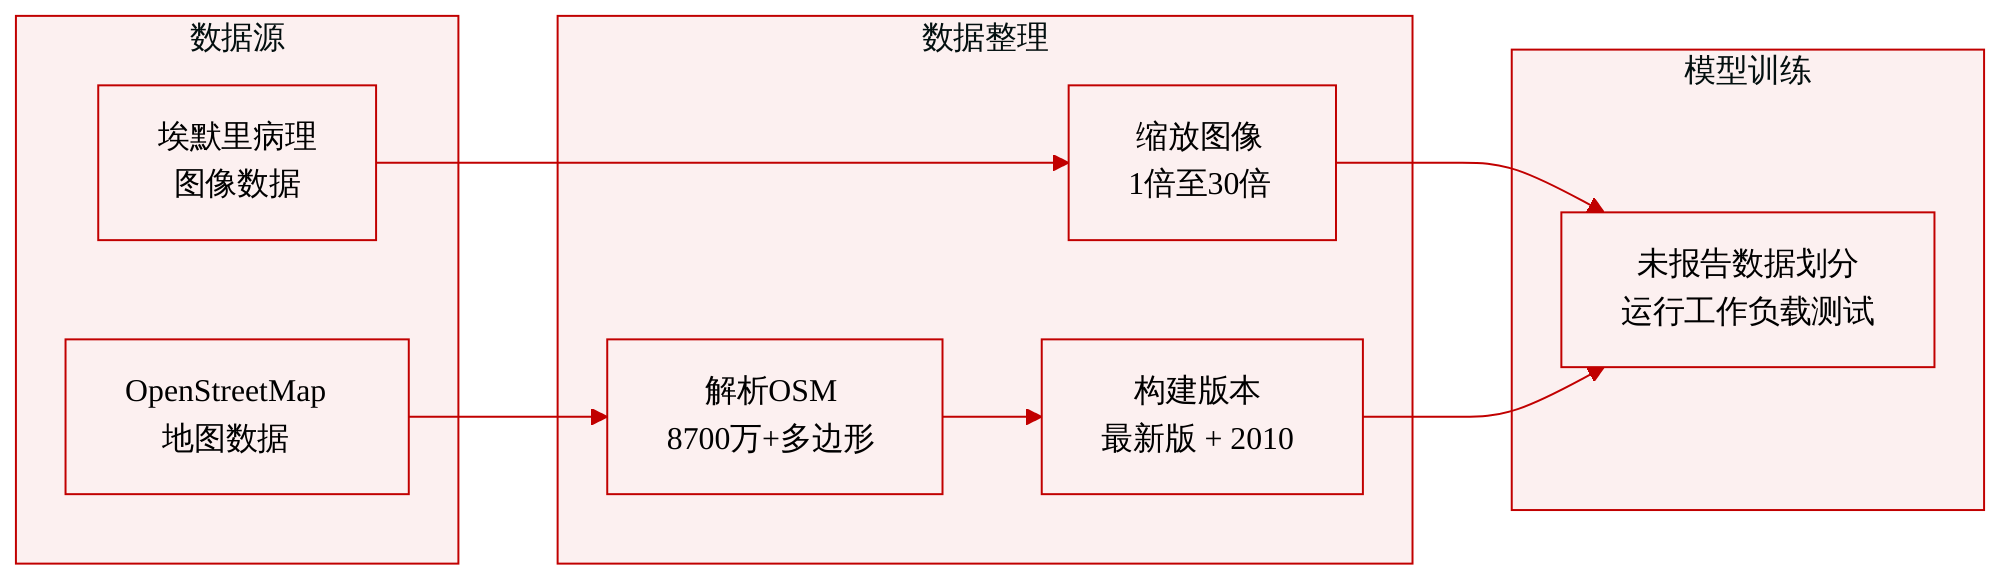
- Scale variants:作者准备 1X、3X、5X、10X 和 30X 规模的数据集,用于不同测试场景。
- Size details:1X 包含 18 张图像,总大小 44 GB;3X 包含 54 张图像,总大小 132 GB;5X 包含 90 张图像,总大小 220 GB;10X 包含 180 张图像,总大小 440 GB;30X 包含 540 张图像,总大小 1,320 GB。
- Feature schema:每张图像平均包含 50 万个细胞核,每个细胞核派生出 74 个特征。
- Usage:该数据集用于测试不同数据集规模下的病理空间分析和查询工作负载。
-
OpenStreetMap dataset:
- Source:官方 OpenStreetMap 网站,这是一个大型协作地图项目。
- Data type:湖泊、森林、建筑和道路等地理要素的空间表示。
- Geometry types:空间对象以点、线和多边形表示。
- Processing:作者下载数据并将其解析到空间数据库中。
- Schema:表结构较简单,包含约 70 列。
- Main table:实验使用多边形表示表,包含超过 8700 万条记录。
- Dataset versions:为查询测试构建两个版本,一个基于最新可用版本,另一个是 2010 年较早发布的较小版本。
- Format for processing:数据集也被导出为文本,供 Hadoop-GIS 使用。
-
Dataset construction and filtering:
- 对于病理成像,数据集大小通过预定义的规模变体调整,而不是通过过滤过程描述。
- 对于 OpenStreetMap,主要过滤步骤是选择多边形要素表用于实验。
- 创建最新数据集和较小的 2010 数据集,以支持不同查询工作负载。
- 未报告任一数据集的显式裁剪策略。
方法
作者利用一种空间分区、以瓦片为中心的执行框架,使大规模且计算成本高昂的空间工作负载能够在运行 Hadoop 和 HDFS 的普通集群上实用。系统围绕一个简单原则设计:将不规则空间数据转换为称为瓦片的有界处理单元,在这些瓦片上独立执行查询逻辑,然后仅修复并行瓦片执行产生重复或边界敏感结果的那些有限情况。这种方式避免了将完整空间关系数据库引擎移植到分布式批处理环境中,同时仍支持空间连接、包含查询、范围过滤和基于几何的测量等丰富的空间操作。
参见框架图。
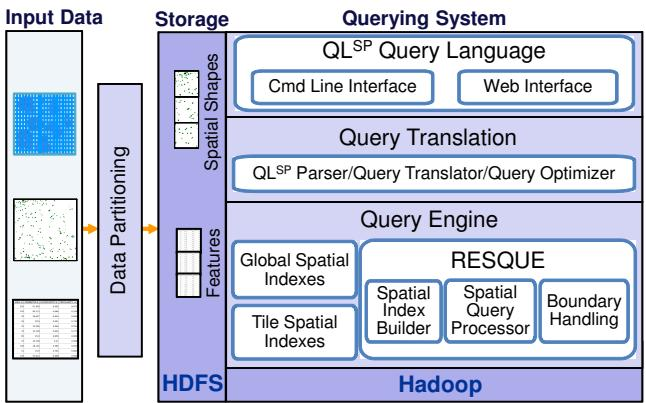
框架图所示架构分为三个主要层:输入数据准备与分区、HDFS 存储和查询子系统。查询子系统包括空间查询语言层、查询转换与优化和查询引擎。查询引擎内的关键组件是实时空间查询引擎(RESQUE),用于提供空间索引构建、空间查询处理和边界处理。系统提供扩展 SQL 语言,可表示为 QLSP,以及以 Hive 集成的空间查询层,可表示为 HiveSP。空间数据首先被划分为瓦片,然后分配瓦片标识符,合并为大型 HDFS 文件,并进行多级索引,使查询能够高效地按瓦片执行。
总体查询流水线按若干阶段执行。首先,系统执行空间分区以创建瓦片。接着,为空间对象分配瓦片 UID,并合并为 HDFS 兼容文件。执行前,系统可进行查询预处理,例如基于全局索引的过滤,以减少需要扫描的瓦片数量。随后,主要空间查询处理通过 MapReduce 在各瓦片上并行且独立地运行。如有必要,系统再将边界处理作为另一个 MapReduce 阶段。后处理可将空间结果与非空间特征表进行连接或聚合属性,最终结果写回 HDFS。
一个核心设计决策是如何划分空间域。作者重点关注递归划分,而不是简单固定网格。当空间数据高度倾斜时,固定网格会造成严重负载不均。例如,一个瓦片可能包含数千甚至数百万个对象,而相邻瓦片只有少量对象。在 MapReduce 中,这种倾斜会导致落后任务主导运行时间。为缓解该问题,每个瓦片都按照阈值 Cmax 评估,该阈值表示一个瓦片中期望容纳的最大对象数。令 n(t) 表示分配到瓦片 t 的对象数量。如果某个瓦片超过阈值,则沿 x 或 y 方向将其划分为两个半大小瓦片。划分方向的选择目标是产生一个对象数量低于阈值的瓦片,或产生两个更平衡的子瓦片。
n(t)>Cmax⇒t→{t1,t2},n(t1)≤Cmax, n(t2)≤Cmax.该过程递归重复,直到所有瓦片满足目标大小上限。分区完成后,每个空间对象都会获得所属瓦片的 UID,不过边界对象可能会被分配到多个瓦片,后续会进一步讨论。瓦片的最小外接矩形存储在全局空间索引中,使系统能够快速判断哪些瓦片可能与查询范围相关。
在存储方面,作者将多个瓦片合并到较大的 HDFS 文件中,而不是将每个瓦片存储为单独文件。这一选择很重要,因为 HDFS 针对大块数据和批处理进行了优化。大量小文件会增加元数据开销,并在执行期间生成过多小型 map 任务,从而损害性能。因此,系统将瓦片集视为逻辑分区结构,同时将多个瓦片物理打包为适合 HDFS 的较大文件。
查询引擎架构依赖两种互补索引策略。在高层,系统维护基于瓦片 MBR 的全局区域索引。这些索引较小,因为它们描述的是大粒度区域,而不是单个空间对象。它们可以以紧凑二进制格式存储在 HDFS 上,并通过 Hadoop 分布式缓存在节点之间共享。对于窗口查询、点查询或包含查询,全局瓦片索引能够快速识别空间范围与查询范围相交的候选瓦片,使系统能够在更昂贵计算开始之前跳过无关瓦片。
在瓦片层面,系统使用按需空间索引。RESQUE 不为每个瓦片存储大型永久空间索引,而是在查询执行期间按需构建瓦片本地索引。瓦片大小有意保持适中,因此为单个瓦片构建索引速度很快。索引保存在主存中,在内存有限的少数情况下可使用二级存储。该设计解决了面向 HDFS 的存储与传统空间索引引擎之间的实际不匹配:HDFS 偏好大型顺序块,而空间索引通常需要在更小粒度上进行高效随机访问。通过为每个瓦片在内存中构建索引,系统避免了这种不匹配并保持查询执行效率。
RESQUE 支持多种访问方法和几何操作。它使用批量加载的 R*-Tree 进行通用空间索引,当对象形状规则且分布相对均匀时,可使用 Hilbert R-Tree。引擎还支持空间关系谓词和测量函数。对于空间连接,系统可以检测多边形是否相交、计算相交面积、计算并集面积、推导重叠比率,例如 area(A∪B)area(A∩B),并计算质心距离。
如下图所示:
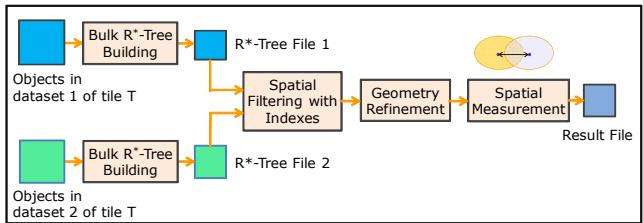
RESQUE 中的空间连接工作流体现了过滤与精化模式。考虑存储在同一个瓦片 T 内的两个对象数据集。引擎首先对每个数据集进行批量 R*-Tree 构建。R*-Tree 内部节点存储 MBR,叶节点存储多边形对象或其压缩表示。随后,引擎执行基于 MBR 的空间连接过滤,快速生成边界框相交的候选对。候选对随后经过几何精化,在其中执行精确的多边形相交检查。最后,空间测量计算所需的查询输出,例如重叠比率、质心距离或其他派生几何指标。这种分层工作流很重要,因为边界框过滤可以在更昂贵的精确几何计算之前排除许多误报。
应用索引优化,是因为被查询数据大多是只读的。系统使用批量加载技术,并将页利用率设置为 100%,以减少页数。系统还压缩叶节点中的几何负载。系统不必以完整形式存储每个 x,y 坐标,而可以使用相对于邻近点的偏移编码坐标,这是一种紧凑的链码表示。这降低了叶节点存储的内存和 I/O 成本,对密集形状数据集尤其有价值。
MapReduce 集成有意保持简单且隐式。作者并不尝试实现带显式空间任务调度的完全分布式空间查询规划器。相反,他们将空间查询映射到普通 MapReduce 阶段。由于数据已经按瓦片分区,瓦片 UID 成为分组的自然键。在 map 阶段,系统扫描输入记录、评估本地过滤器并输出中间键值对。中间键是瓦片 UID,值包含所需列以及一个标识记录来自哪个输入表的数据源标签。对于自连接查询,共享扫描可以在同一次 map 遍历中处理连接的两侧,根据过滤条件生成零个、一个或两个中间记录。
在 shuffle 阶段,Hadoop 将具有相同瓦片 UID 的记录分组。在 reduce 阶段,系统接收属于同一个瓦片的所有记录。随后,reduce 函数按数据源表分离记录,并调用 RESQUE 构建必要的瓦片本地索引并执行空间查询。输出被序列化并写入 HDFS。该结构通过将每个瓦片视为一个小型本地连接问题来支持空间连接:昂贵的几何计算在每个 reducer 内独立执行。
包含查询和选择查询可以采用更轻量的模式。对于这些查询,系统可以使用全局瓦片索引识别与查询区域相交的瓦片。map-only 的 MapReduce 程序可以只扫描相关文件分片,引擎可以在执行精确几何包含检查之前过滤候选对象。对于完全位于单个瓦片内的小型查询区域,工作流退化为该瓦片内的本地索引查询。对于点查询,系统识别相关瓦片,并返回几何上包含该点的对象。
边界处理是架构中最重要正确性机制之一。跨越瓦片边界的空间对象如果采用纯瓦片本地模型,除非特别处理,否则无法正确执行。例如,一个对象可能跨越两个相邻瓦片。如果每个瓦片独立处理,该对象可能丢失、重复或导致连接结果不一致。作者对边界对象采用多重分配。在预处理期间,跨越瓦片边界的对象会被复制,并分配到每个与之相交的瓦片。复制出的副本随后在各自瓦片中按普通对象处理。
如下所示:
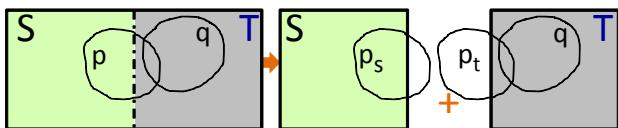
在边界处理机制中,跨越瓦片 S 和 T 的边界对象 p 表示为两个副本 ps 和 pt。随后,每个瓦片可以独立执行其查询逻辑。如果查询是空间连接,瓦片本地处理可能会产生涉及复制对象的重复结果对。为纠正这一点,系统运行一个后处理阶段,对结果集进行规范化。由于每个原始对象都具有全局唯一内部 UID,系统可以通过比较对象 UID 或结果对标识符消除重复记录。该后处理本身可以以较低开销实现为一个 MapReduce 作业。作者指出,边界对象通常只占数据集的一小部分,因此额外的复制和去重成本仍然可控。
该系统还集成 Hive,以提供声明式空间查询接口。这很重要,因为分析师和应用程序开发者可以用类 SQL 的语法表达空间工作负载,而不是直接编写 MapReduce 程序。基于 Hive 的系统通过空间运算符、空间函数和空间数据类型扩展 HiveQL。用户可以定义表模式、指定空间列并指示空间分区列。数据通过正常 Hive 数据加载路径加载,同时空间分区元数据指导放置和剪枝。
如下图所示:
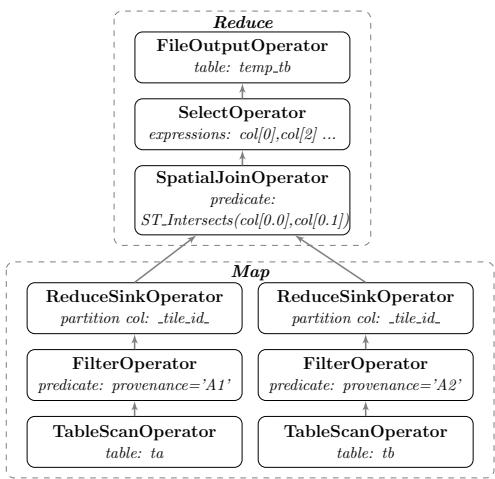
查询处理路径遵循先规划、后执行模型。SQL 查询被解析为抽象语法树,翻译为逻辑算子树,然后优化为由 MapReduce 任务组成的物理计划。当查询包含空间运算符时,逻辑计划会被重写,使空间操作映射到内部空间引擎算子。系统还会在空间运算符周围插入序列化和反序列化步骤,使 Hive 执行层能够与 C++ 空间查询引擎传递数据。对于双向空间连接,生成的计划使用输入关系上的表扫描、识别记录所属输入侧的过滤器、按瓦片标识符对记录分区的 reduce-sink 算子,以及 reduce 端空间连接算子。随后,选择算子和输出算子投影并写入最终结果。
在物理计划中,空间数据按瓦片分区。这使 reduce 阶段能够并行且本地评估空间关系。相交、重叠、包含和距离等空间谓词在 RESQUE 内部执行,而 Hive 继续处理周围的关系操作。优化器可以应用基于规则的策略,例如谓词下推、列剪枝和索引感知过滤。例如,在启动昂贵的瓦片级几何计算之前,系统可以使用全局瓦片索引移除不可能包含匹配对象的瓦片。
软件设计还强调可部署性。空间查询引擎被编译为共享库并部署在集群节点上。这使得引擎可由 MapReduce 任务调用,而不要求每个任务依赖重量级关系数据库进程。基于库的设计支持索引构建、双向和多路空间连接、最近邻处理以及空间测量操作。由于引擎与分布式执行层分离,空间计算可以独立于 Hadoop 作业协调进行开发、优化和测试,而 MapReduce 运行时通过调度器、shuffle 机制和分布式文件系统提供可扩展性。
实验
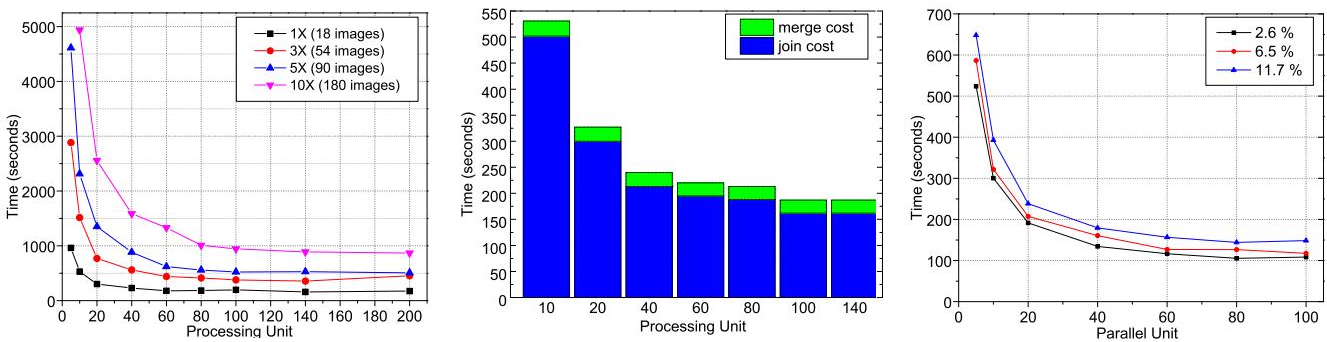
实验在 Hadoop、一个调优后的并行空间数据库和 PostGIS 上评估 Hadoop-GIS,使用真实病理成像和 OpenStreetMap 数据集,涵盖空间连接、包含和聚合基准测试,以及可扩展性和边界处理测试。结果表明,RESQUE 引擎在空间连接上效率较高,并且加载开销较低,而 Hadoop-GIS 随着更多处理单元和更大数据集能够接近线性扩展,并在计算密集型连接上表现强劲。对于面向 I/O 的包含和聚合任务,并行数据库可能更强,而边界处理随着边界对象比例增加只会带来较小的实际开销。