Command Palette
Search for a command to run...
千层网络用于自监督强化学习:扩展深度可解锁新的目标达成能力
千层网络用于自监督强化学习:扩展深度可解锁新的目标达成能力
Kevin Wang Ishaan Javali Michał Bortkiewicz Tomasz Trzciński Benjamin Eysenbach
摘要
自监督学习的规模化已在语言和视觉领域推动了突破性进展,然而强化学习(RL)领域的可比较进展仍然难以实现。本文研究了自监督强化学习的基础构件,以解锁规模化方面的实质性提升,其中网络深度是关键因素。近年来大多数强化学习论文依赖于浅层架构(约 2–5 层),我们证明将深度增加至 1024 层可以显著提升性能。我们的实验在无监督目标条件设定下进行,该设定不提供任何示范或奖励,因此智能体必须从零开始探索并学习如何最大化达成指定目标的似然。在模拟的移动和操作任务上评估时,我们的方法将自监督对比式强化学习算法的性能提升了 2×–50×,优于其他目标条件基线方法。增加模型深度不仅提高了成功率,还定性地改变了智能体学到的行为模式。项目主页和代码可在以下地址获取:https://wang-kevin3290.github.io/scaling-crl/。
一句话总结
普林斯顿大学、华沙理工大学等机构证明,在自监督对比强化学习中,将网络深度扩展到 1024 层,远超通常的 2 到 5 层,能在无监督运动和操纵任务中将目标达成性能提升至 2×−50×,并定性改变 agent 学到的行为。
核心贡献
- 该论文介绍了在一种无监督目标条件设定下用于自监督强化学习的构建模块,在该设定中,agent 从零开始探索,并在没有示教或奖励的情况下学习最大化到达指定目标的可能性。
- 该方法结合了一个由 InfoNCE 训练的对比式 critic,其输出为状态 action 与目标 embedding 之间的 l2 范数、一个以最大化该 critic 为训练目标的策略,以及有助于稳定多达 1024 层网络训练的残差连接。
- 仿真中的运动和操纵实验表明,与自监督对比强化学习及其他目标条件基线相比,增加深度可将成功率提升 2x 到 50x,同时产生在定性上更丰富的目标达成行为。
引言
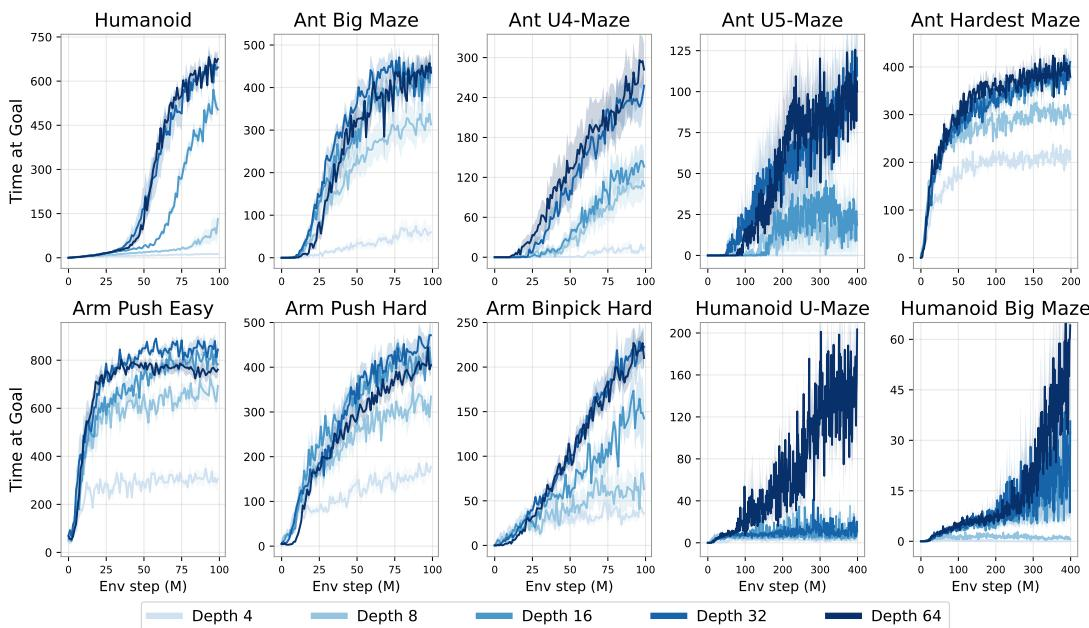
大规模模型扩展已在视觉和语言中带来涌现能力,但在强化学习中,规模化带来的收益仍不确定,因为 agent 接收到稀疏奖励信号,并且通常使用 2 到 5 层的小型 MLP 策略。先前研究难以复现这些收益,在增加深度时常常只看到微弱改进、训练不稳定,或者有限甚至为负的回报,同时通常将自监督预训练视为规模化的主要路径。作者利用对比式强化学习作为一种自监督 actor critic 方法,通过 GPU 加速强化学习训练提高在线数据可用性,并使用残差连接、层归一化和 Swish 激活函数构建深度约为原来 100 倍的网络。他们表明,这种组合实现了强大的强化学习可扩展性:在半数环境中带来超过 20 倍的性能提升,相比目标条件基线取得更好结果,并且随着深度和规模增加,涌现出在定性上不同的策略。
实验
实验在 JaxGCRL 的运动、导航和操纵任务上评估目标条件对比式强化学习,这些任务使用稀疏奖励,并将深度不断增加的残差 actor 和 critic 网络与标准浅层基线进行比较。结果表明,深度扩展能够带来显著收益,尤其是在长时程和人形任务中,并在达到关键深度后促使导航和运动技能涌现。消融实验和机制分析表明,深度比宽度更有用,actor 和 critic 联合扩展能够带来帮助,更大的深度能够支持更大的 batch,并改善表征质量、探索能力和有限的泛化能力,但离线结果没有表现出同样的收益。