Command Palette
Search for a command to run...
叠加带来鲁棒的神经缩放
叠加带来鲁棒的神经缩放
Yizhou Liu Ziming Liu Jeff Gore
摘要
当今大型语言模型(LLM)的成功依赖于一个观察:更大的模型性能更好。然而,这一神经缩放定律的起源——即损失随模型规模呈幂律下降——仍不清楚。我们提出,表示叠加(即 LLM 所表示的特征数量超过其维度数量)可能是损失的关键成因,并驱动神经缩放。基于 Anthropic 的玩具模型,我们使用权重衰减来控制叠加的程度,从而系统地研究损失如何随模型规模缩放。当叠加较弱时,损失仅在数据特征频率呈幂律分布时才遵循幂律。相比之下,在强叠加下,由于表示向量之间的几何重叠,损失在广泛的频率分布类别中普遍地与模型维度成反比缩放。我们验证了开源 LLM 处于强叠加区间,其损失与模型维度成反比,且 Chinchilla 缩放定律也与这一行为一致。我们的结果将表示叠加识别为神经缩放定律的核心驱动力,为神经缩放定律何时可被改善、何时将失效等问题提供了洞见。
一句话总结
MIT 研究者提出,表征叠加,即 LLM 表征的特征数量超过其维度数量,是神经缩放定律的关键驱动因素;通过权重衰减控制叠加程度,结果表明,在强叠加下损失通常与模型维度成反比,这与 Chinchilla 缩放定律一致。
核心贡献
-
表征叠加被提出作为神经缩放定律的核心驱动因素;引入一个受权重衰减控制的 Anthropic 玩具模型,用于调节叠加程度并研究损失如何随模型维度缩放。该框架使叠加成为可实验控制的变量,便于进行系统的缩放分析。
-
只有当数据特征频率服从幂律分布时,弱叠加才会产生幂律损失;而由于表征向量之间的几何重叠,强叠加在广泛的频率分布下通常产生与模型维度成反比的损失。这解释了为什么大语言模型无需对数据频率分布作特殊假设,也能表现出稳健的神经缩放。
-
开源大语言模型被证明运行在强叠加状态,并表现出损失与模型维度成反比的缩放,同时 Chinchilla 缩放定律也与这种行为一致。该分析还将模型规模损失分解为表征与解析成分,并认为更强的叠加可能提升训练效率,而基于宽度的缩放可能最终在接近词表规模限制时失效。
引言
该研究考察大语言模型中的神经缩放定律,其中随着模型宽度、训练数据和计算量增加,损失以可预测方式改善,从而指导设计能力更强的模型。先前工作通常通过函数逼近、流形拟合或特征学习来解释这种缩放,但很少探索表征学习和叠加,即模型将许多特征压缩到宽度受限的隐空间中。该研究利用一个玩具数据恢复模型,研究叠加程度如何改变损失缩放。结果表明,只有当特征频率服从幂律时,弱叠加才表现出幂律行为;而由于重叠表征之间的干扰,强叠加能够产生稳健的缩放,接近损失与模型宽度成反比。进一步发现,实际 LLM 与强叠加状态相符,为基于宽度的缩放定律提供了机制层面的解释。
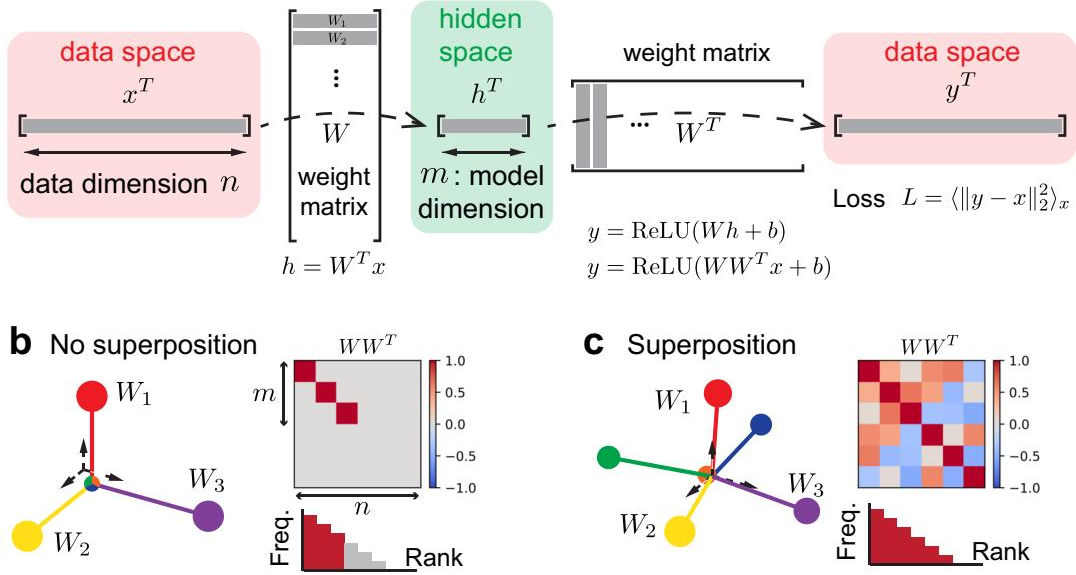
方法
该研究利用一个表征学习玩具模型,分离叠加对缩放行为的影响。在该框架中,数据被表示为高维向量 x∈Rn,其中每个坐标对应一个原子潜在特征。特征 i 的激活生成方式为
xi=uivi,ui∼Bernoulli(pi),vi∼U(0,2).其中,ui 决定特征是否激活,而 vi 决定特征激活后的激活幅度。概率 pi 控制特征频率或重要性,模型按频率降序排列特征,并且 pi 随 i 增大而减小。因此激活密度为
E=i=1∑npi.模型本身不是 Transformer,而是一个欠完备重建系统。它使用权重矩阵 W∈Rn×m 和偏置向量 b∈Rn,其中模型维度 m 远小于特征维度 n。隐表征通过
h=WTx,而重建结果为
y=ReLU(Wh+b).训练目标衡量平方重建误差,
L=⟨∥y−x∥22⟩x,其中平均在数据分布上计算。在该表述中,特征 i 的表征是嵌入矩阵的第 i 行 Wi。当 ∥Wi∥2 非零时,认为该特征被表征。没有叠加时,只有最重要的前 m 个特征被近乎正交的行所表征,其余特征被忽略。存在叠加时,超过 m 行变为非零,允许许多特征被编码到共享的低维空间中,但会在它们之间引入干扰。
读出层的非线性是该方法的核心。在纯线性重建系统中,叠加会增加干扰,通常使损失变差。然而,在使用 ReLU 激活和负偏置时,干扰可以部分抵消,从而实现一种误差纠正。这使得叠加在特征足够稀疏且特征频率不太不均衡时有用,因为许多特征可以在可接受的损失下被表征,而不是被丢弃。
为了在训练期间控制叠加程度,引入一种解耦的权重修正,按行应用于 W。在训练步 t,更新规则为
Wi,t+1={Wi,t−ηtγWi,t,Wi,t−ηtγWi,t(∥Wi,t∥21−1),γ≥0,γ<0,其中 ηt 是学习率。正的 γ 会收缩嵌入行并促进弱叠加,而负的 γ 会促使各行接近单位范数并促进强叠加。该机制在 AdamW 风格优化器中实现,并使用 warm-up 和 cosine-decay 学习率调度。
用于测量有效叠加量的诊断量是被表征特征的比例,
ϕ1/2=n∣{i:∥Wi∥2>1/2}∣.经验上,行范数呈现双峰分布,聚集在接近零或一的位置。较小的权重衰减产生 ϕ1/2≈1 的强叠加,而较大的权重衰减产生 ϕ1/2∼m/n 的弱叠加。这提供了在不同表征状态下比较缩放行为的受控方式。
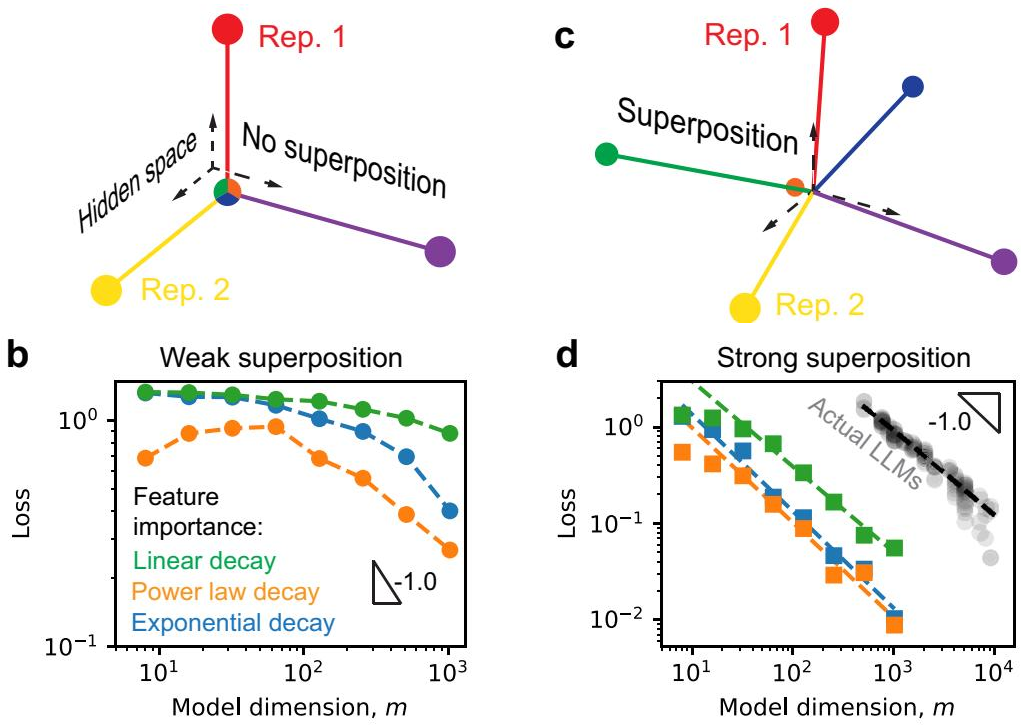
所得到的损失行为取决于叠加如何与特征频率结构交互。在弱叠加状态下,模型主要保留最高频特征,因此损失缩放对 pi 随秩的衰减非常敏感。只有当特征频率本身服从幂律分布且模型维度足够大时,才会出现损失与模型维度的清晰幂律依赖。在强叠加状态下,模型同时编码多得多的特征。尽管表征发生重叠,损失对底层频率分布敏感度大大降低,并倾向于随模型维度成反比缩放。下图比较了弱叠加与强叠加的几何表征状态及其对应的缩放行为。
实验
使用具有幂律特征频率和不同模型维度的受控玩具模型,实验表明弱叠加损失由被忽略特征的总频率主导,并遵循可预测的幂律;而强叠加损失来自表征向量之间的干扰,当向量是各向同性或类似 ETF 时,倾向于稳健的与宽度成反比缩放。对 LLM 输出层的分析发现 tokens 以强叠加方式表征,token 频率接近平坦,且平方重叠近似与模型维度成反比,支持了如下结论:叠加表征中的几何干扰是神经缩放定律背后的关键机制。