Command Palette
Search for a command to run...
激励大型语言模型自我验证其答案
激励大型语言模型自我验证其答案
Fuxiang Zhang Jiacheng Xu Chaojie Wang Ce Cui Yang Liu Bo An
摘要
大型语言模型(LLM)通过后训练和测试时扩展定律,在复杂推理任务中已展现出显著进展。虽然常见的测试时扩展方法通常利用外部奖励模型来指导模型生成过程,但我们发现,当模型在特定推理任务上后训练后,扩展此类方法仅能获得微小的性能提升。我们识别出,这种有限的改进源于特定后训练生成器与通用奖励模型之间的分布差异。为解决这一问题,我们提出了一种激励LLM自我验证其答案的框架。通过在单一的强化学习(RL)过程中统一答案生成与验证,我们训练出的模型能够有效评估自身解决方案的正确性。训练后的模型在推理时还可通过验证自身生成结果来进一步提升性能,而无需外部验证器。我们基于Qwen2.5-Math 7B和DeepSeek-R1-Distill-Qwen-1.5B训练自我验证模型,展示了其在不同推理上下文长度下的能力。在多个数学推理基准上的实验表明,我们的模型不仅能提升后训练性能,还能实现有效的测试时扩展。我们的代码可在https://github.com/mansicer/self-verification获取。
一句话总结
南洋理工大学和天工AI的研究人员发现,后训练生成器与通用奖励模型结合时性能不佳,原因在于分布不匹配。他们提出了一种统一的强化学习自验证框架,使大语言模型能够评估自身答案,从而提升后训练性能,并在不依赖外部验证器的情况下实现测试时扩展。该框架已在 Qwen2.5-Math 7B 和 DeepSeek-R1-Distill-Qwen-1.5B 上通过多个数学推理基准得到验证。
核心贡献
-
论文提出了一种自验证框架,在单一强化学习过程中统一了答案生成与验证,这是首个联合训练大语言模型同时进行问题求解和验证的统一强化学习方法。
-
该框架通过训练模型以生成方式评估自身解决方案的正确性,消除了对外部奖励模型的依赖,直接解决了后训练生成器与通用奖励模型之间的分布偏移问题,这一偏移限制了测试时扩展的收益。
-
在多个数学推理基准上使用 Qwen2.5-Math 7B 和 DeepSeek-R1-Distill-Qwen-1.5B 进行的实验表明,自验证模型提升了后训练性能,并通过自验证实现了有效的测试时扩展。
引言
大语言模型在数学和逻辑谜题等可验证推理任务上表现出色,这类任务通常具有标准答案。研究人员探索了两种互补的扩展策略:通过强化学习进行后训练,对正确答案给予奖励;以及测试时扩展,利用额外计算、集成方法或奖励模型作为验证器,在推理阶段提高准确率。然而,作者观察到这两种方法结合时协同效应有限。后训练模型由于针对特定训练数据调优,倾向于产生较窄的生成分布,而基于常规数据训练的外部验证器无法识别这种偏移。因此,常见的测试时扩展方法(如 best-of-N 和使用外部奖励模型的 beam search)相比通过多数投票实现的简单 self-consistency 只能带来微小的收益。
为了解决这一问题,作者提出了一种自验证框架,在单一模型中统一了问题求解和验证。他们训练大语言模型不仅生成答案,还验证自身解决方案的正确性,使用基于标准答案正确性的奖励信号进行强化学习。为了稳定生成和验证的联合训练,他们引入了在线策略对齐缓冲区,使验证器输入分布与最新模型输出保持一致,以及动态验证奖励,利用多次 GRPO 采样自动调整奖励信号。在推理时,同一个后训练模型同时处理生成和验证,作者基于验证分数应用加权答案聚合。这种设计避免了对外部奖励模型的依赖,并且易于集成到现有推理引擎中。在数学推理基准上的实验表明,在后训练中加入自验证可提升模型性能,并随着生成预算增加实现有效的测试时扩展。
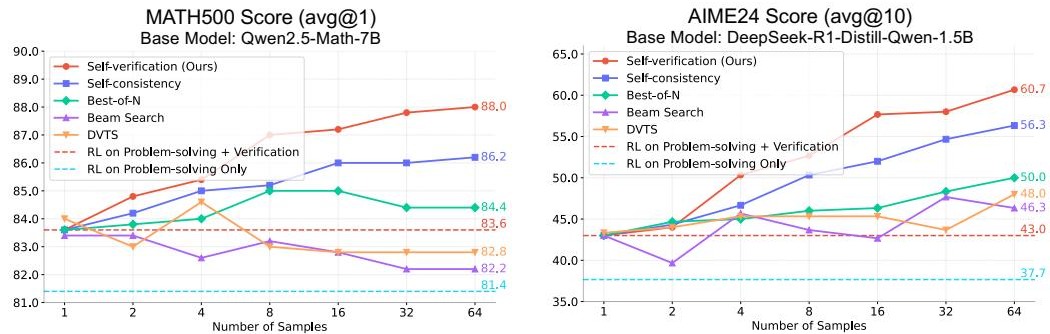
方法
方法:自验证框架
为了解决传统测试时扩展方法对后训练模型泛化能力有限的问题,作者提出了一种自验证框架,在单一强化学习过程中统一了答案生成和验证。该框架在训练期间支持高效的多任务强化学习,在推理时支持稳健的测试时扩展,同时仅需部署一个 LLM。
带自验证的强化学习
作者采用 GRPO 算法在大语言模型上针对数学推理任务进行训练,使用基于规则的正确性奖励 rc(x,y),该奖励反映生成的解决方案 y 对于问题 x 是否正确。为了扩展模型的验证能力,引入了额外的验证奖励。由于每个生成的解决方案都有标准答案正确性可用,模型的预测验证结果可以直接与标准答案进行比较:
rv(x,y)={1,0,if I(yv=Yes)=rc(x,y),otherwise.其中,token yv 从 Yes 或 No 中选择,代表模型对验证任务的判断。因此,rv 作为验证器的直接训练信号。值得注意的是,验证任务不仅依赖于原始数学问题,还依赖于模型生成的响应,因此作者使用在线数据缓冲区在训练期间存储实时模型响应。
策略对齐缓冲区。 作者利用数学推理训练期间生成的解决方案作为训练验证器的数据。然而,保留所有历史生成的解决方案会迫使验证器从训练早期阶段可能无意义或未精炼的解决方案中学习。为了解决这个问题,验证器被设计为主要关注代表当前模型能力的解决方案。因此,作者实现了策略对齐缓冲区 B,仅存储最近的解决方案,以降低离策略数据的风险。具体而言,仅保留最近 Tb 个训练步内生成的解决方案,确保验证数据集与不断演化的策略保持一致。
动态验证奖励。 通过强化学习训练验证器时,上式中定义的简单二元奖励被证明效果不佳。随着模型改进,正确解决方案迅速主导验证数据集,造成输入不平衡。为了让验证器专注于困难的验证问题,作者引入了动态验证奖励,识别具有挑战性的案例并根据难度调整奖励。利用 GRPO,对每个问题 x 获得一组生成的响应 y1,…,yG。将 Gc 和 Gi 分别表示为组内正确和不正确生成的数量,动态验证奖励 r^v 定义为:
r^v(x,y)=⎩⎨⎧G2Gi,G2Gc,0,if yv=Yes and rc(x,y)=1,if yv=No and rc(x,y)=0,otherwise.这种奖励设计在验证器成功识别出困难问题的正确解决方案或容易问题的错误解决方案时提供更高的激励。正确验证的期望奖励保持为 1,确保其与问题求解奖励 rc 在量级上保持可比。
该算法通过维护最近模型生成结果的在线缓冲区,将自验证整合到 GRPO 训练中。每个训练步骤将原始数据集和缓冲区结合以采样问题。处理数据集中的问题时,模型生成多个解决方案,计算其正确性奖励,并将其添加到缓冲区。对于缓冲区中的问题,根据验证难度计算动态验证奖励。最终奖励结合了正确性和验证两个组成部分,确保模型在生成正确解决方案的同时发展验证能力。
用于测试时扩展的自验证
在推理时,后训练模型具备强大的内置验证器,可以通过验证自身解决方案来扩展性能。给定生成预算 N,模型首先采样 N 个候选响应 y1,…,yN。对每个响应,验证分数 s(x,yi) 计算为在给定问题、解决方案和验证提示模板条件下 Yes token 的似然。然后作者提取唯一答案集合 A={E(y1),…,E(yN)},其中 E 从响应中提取最终答案。验证分数按每个候选答案聚合,以确定最终预测 a^:
a^=argmaxa∈Ai=1∑NI[E(yi)=a](1+αs(x,yi)),其中 α 是控制验证分数规模的超参数。当 α=0 时,退化为标准多数投票;当 α→∞ 时,验证分数最高的答案占主导。通过为 α 选择适中的值,作者在共识和置信度之间取得平衡,从而获得更稳健可靠的预测。该方法的一个关键优势在于其高效性:推理时仅需部署一个 LLM,无需外部验证器模型。这使得该框架非常实用,且易于与 vLLM 和 SGLang 等现代 LLM 推理引擎兼容。
实验
自验证框架的实验使用了两个模型,Qwen2.5-Math-7B 和 DeepSeek-R1-Distill-Qwen-1.5B,在数学推理数据上通过强化学习训练,并在 MATH500、AIME、AMC 和 OlympiadBench 等基准上进行评估。在后训练期间,自验证模型在贪心解码准确率上优于标准 GRPO 基线,其验证能力超过了相同规模的开源模型,并且在自身响应上的验证能力达到或超越了 GPT-4o,尽管参数更少。在测试时扩展方面,自验证在 self-consistency、best-of-N、beam search 和 DVTS 中取得了最佳性能,外部验证器方法由于分布偏移而表现不佳。该框架具有高效性,验证比求解少用 24-35% 的 token,并且推理时间扩展速度快于 best-of-N 和基于过程的方法,但略慢于多数投票。
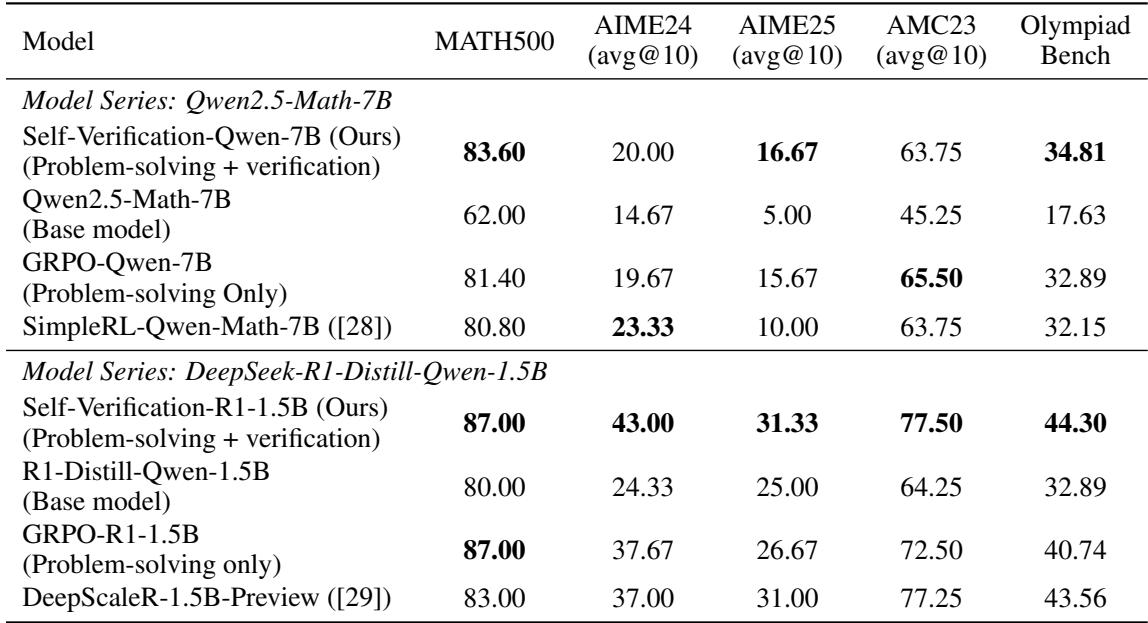
自验证后训练在多个基准上提升了数学推理性能。所提出的模型优于其基础版本和标准 GRPO 模型,表明集成验证增强了问题求解能力。自验证模型显著优于其基础模型。7B 和 1.5B 自验证模型在 AIME 和 AMC 基准上均取得了优异结果。将自验证融入强化学习得到的分数高于标准 GRPO,表明存在协同效应。
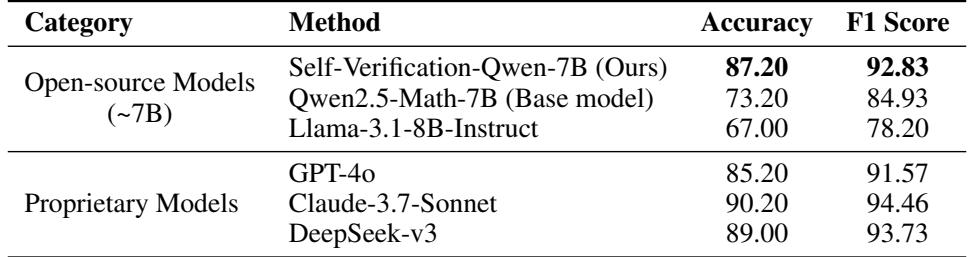
自验证模型在解决方案验证上优于所有开源基线,相比其基础模型和 Llama 有较大提升。它还在准确率和 F1 上超越了 GPT-4o,但落后于 Claude-3.7-Sonnet 和 DeepSeek-v3。Self-Verification-Qwen-7B 相比其基础模型准确率提升了 14 个百分点。该模型在准确率和 F1 上均超越 GPT-4o,但仍落后于 Claude-3.7-Sonnet 和 DeepSeek-v3。
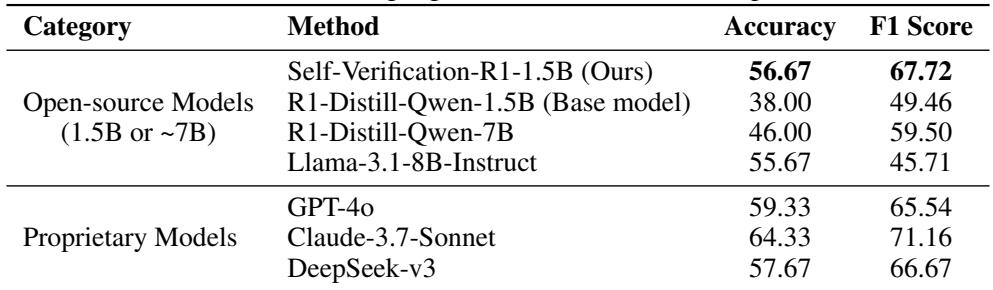
自验证模型在验证 AIME24 解决方案方面大幅优于同规模开源基线,F1 分数高于 GPT-4o,同时保持具有竞争力的准确率。其性能与领先的专有系统相当,表明自验证同时增强了问题求解和验证能力。Self-Verification-R1-1.5B 在开源模型中取得最佳 F1 分数,并超过 GPT-4o 的 F1。该模型相比其基础模型有显著的准确率提升,展示了自验证在后训练中的价值。其验证性能与 Claude-3.7-Sonnet 和 DeepSeek-v3 等专有模型相当。
与 self-consistency、best-of-N、beam search 和 DVTS 等其他测试时扩展方法相比,所提出的自验证方法在大多数数学推理基准上取得了最高平均分。有趣的是,基于多数投票的简单 self-consistency 也具有竞争力,而依赖外部验证器的方法表现不佳,可能是由于分布偏移和逐步生成问题。自验证在大多数基准上始终优于所有其他测试时扩展方法。基于多数投票的简单 self-consistency 出人意料地具有竞争力,经常击败基于外部验证器的方法。best-of-N、beam search 和 DVTS 等外部验证器方法表现较差,其中基于过程的方法加剧了分布偏移。
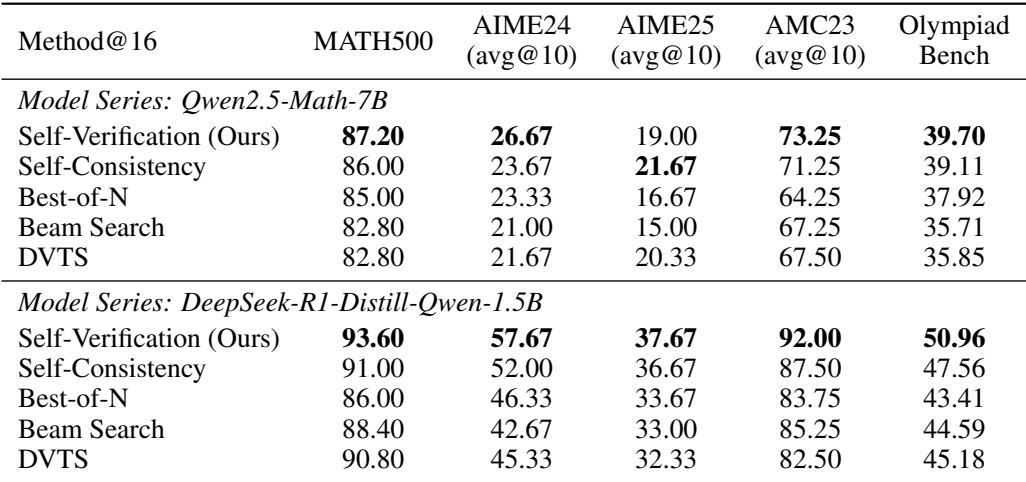
自验证后训练同时提升了数学推理和解决方案验证能力,模型在基准上始终优于其基础版本和标准 GRPO。在验证任务中,该方法在准确率和 F1 上超越了开源基线和 GPT-4o,但仍落后于 Claude-3.7-Sonnet 和 DeepSeek-v3。与其他测试时扩展策略相比,自验证在大多数数学基准上取得了最高平均分,而基于多数投票的简单 self-consistency 仍具有竞争力,基于外部验证器的方法由于分布偏移而表现不佳。