Command Palette
Search for a command to run...
扩散模型为何不会记忆:训练中隐式动力学正则化的作用
扩散模型为何不会记忆:训练中隐式动力学正则化的作用
Tony Bonnaire Giulio Biroli Raphaël Urfin Marc Mézard
摘要
扩散模型在广泛的生成任务中取得了显著成功。理解防止其记忆训练数据并允许泛化的机制是一个关键挑战。本工作研究训练动力学在从泛化到记忆的过渡中所扮演的角色。通过大量实验和理论分析,我们识别出两个不同的时间尺度:模型开始生成高质量样本的早期时间 τ_gen,以及记忆开始出现的较晚时间 τ_mem。至关重要的是,我们发现 τ_mem 随训练集大小 n 线性增长,而 τ_gen 保持恒定。这产生了一个随 n 不断扩大的训练时间窗口,在该窗口内模型能够有效泛化,尽管若训练超过该窗口则会表现出强烈的记忆现象。只有当 n 超过一个模型相关的阈值时,过拟合才会在无限训练时间下消失。这些发现揭示了训练动力学中一种隐式动力学正则化形式,使其即使在高度过参数化的设置下也能避免记忆。我们的结果由标准 U-Net 架构在真实和合成数据集上的数值实验支持,并由在可处理的高维极限下研究的随机特征模型的理论分析加以验证。
一句话总结
来自 LPENS、Université PSL 和 Bocconi University 的研究者证明,扩散模型表现出通过两个不同时间尺度实现的隐式动力学正则化:早期时间尺度 τgen 上高质量样本开始出现,后期时间尺度 τmem 随数据集规模 n 线性增长,超过该时间尺度后出现记忆化,由此形成不断扩大的泛化窗口,即使在高度过参数化设置中也能防止过拟合。
核心贡献
- 该研究识别出扩散模型中的两个训练时间尺度:τ_gen,即高质量生成首次出现的时刻;τ_mem,即开始记忆训练数据的时刻。
- τ_mem 随训练集规模 n 线性增长,而 τ_gen 保持恒定,随着 n 增大,为早停创造了更宽的窗口;只有当 n 超过依赖于模型的阈值时,长时间训练中的记忆化才会消失。
- 在真实和合成数据集上的标准 U-Net 架构数值实验,以及高维极限下的可处理随机特征分析,都支持一种隐式动力学正则化的存在;这种机制可以在高度过参数化的扩散模型中防止记忆化。
引言
扩散模型和基于分数的生成方法如今在图像、音频、视频和科学数据生成中占据核心地位。这些模型学习一个分数函数来引导从噪声中采样,但训练到零损失的模型可以恢复经验分数,并记忆训练样本。已有研究在大模型中识别出记忆化,并研究了架构、学习率和早停等正则化手段,但高度表达能力的模型为何往往先泛化、随后过拟合,仍然不清楚。
作者表明,分数学习的训练动态会形成一种隐式正则化,使解趋向平滑且泛化的形式。他们识别出两个训练时间尺度:早期出现高质量新样本的时间,以及随后模型开始记忆数据集的更晚时间。第二个时间尺度随训练集规模增长,从而为可靠生成创造了一个宽广的早停窗口。
方法
作者利用一个紧凑的分数学习模型,隔离出扩散模型中泛化和记忆化背后的架构与训练动态。核心对象是一个参数化为两层随机特征神经网络的分数网络,其中第一层随机且固定,输出层被学习。对于 Rd 中的数据,分数估计为
sA(x)=pAσ(dWx),其中 W∈Rp×d 从高斯分布中抽取并保持固定,A∈Rd×p 在训练期间更新,σ 逐元素作用。分析在高维区域 d,p,n→∞ 中展开,同时保持
ψp=dp,ψn=dn固定。这种参数化提供了一个可处理的分数模块:非线性随机特征 σ(Wx/d) 定义了一个固定的非线性基,学习得到的矩阵 A 控制这些特征如何组合成数据空间上的向量场。
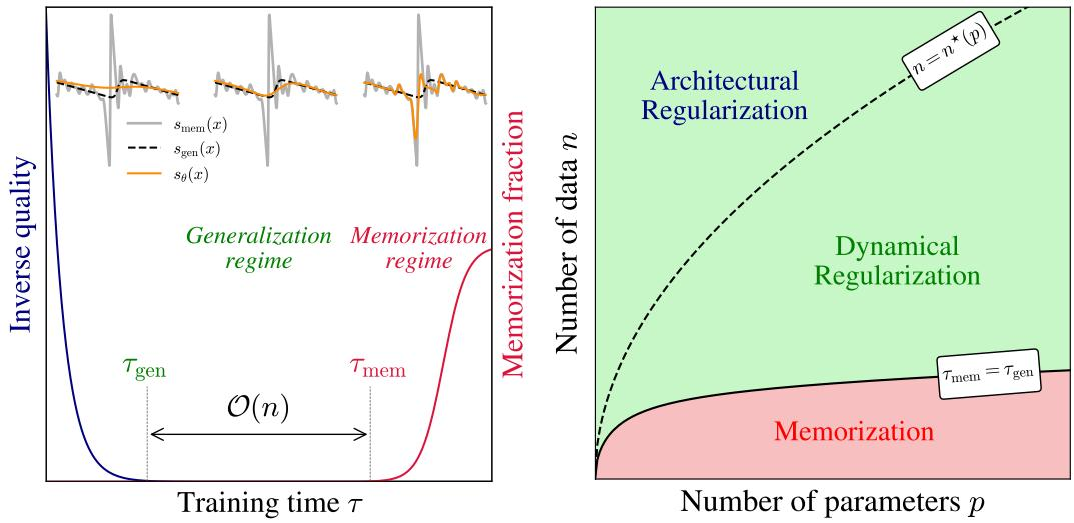
整体学习轨迹,即模型先到达泛化阶段并随后漂移向记忆化,定性地总结于下方的框架示意图中。
相图强调两个控制旋钮:训练点数 n,以及分数模型的表达能力,通常用参数数量 p 衡量。当 n 较小时,训练可能导致对经验分数的记忆化。随着 n 增长超过依赖于模型的阈值,架构本身会阻止精确记忆化,从而形成可理解为架构正则化的现象。此外,在中间时间窗口停止训练会产生动力学正则化:此时学习到的分数足够有表达能力以泛化,但尚未完全适应单个训练样本。
训练流程围绕在固定扩散时间 t 上的分数匹配构建。对于干净样本 x 和噪声 ξ∼N(0,Id),加噪状态的形式为
xt(x,ξ)=e−tx+Δtξ.经验训练目标是分数匹配损失,并按 1/d 重新缩放,以便在 d 增大时保持有限。概念上,当分数网络的输出不能正确撤销注入的噪声时,损失会对其进行惩罚。相应的测试损失以及到总体分数的距离分别为
Ltest=d1Ex,ξ[ΔtsA(xt(ξ))+ξ2],和
Escore=d1Ex[∥sA(x)−∇logPx∥2].第一个量衡量样本内和样本外的学习行为,第二个量衡量学习到的场与真实总体分数之间的接近程度。间隙
Lgen=Ltest−Ltrain被用作过拟合指标。
可训练输出层 A 通过梯度下降更新,
A(k+1)=A(k)−η∇ALtrain(A(k)),其中 η 是学习率。在小学习率极限下,并且经过使用
τ=d2kη,对离散更新进行重新缩放后,离散动态收敛到连续梯度流,
A˙(τ)=−2ΔtpdAU−p2dΔtVT.矩阵 U 是控制学习速度的核心对象。它是随机特征在加噪输入分布下的经验二阶矩矩阵,
U=n1ν=1∑nEξ[σ(dWxtν(ξ))σ(dWxtν(ξ))T],而 V 包含随机特征与注入噪声之间的相关性,
V=n1ν=1∑nEξ[σ(dWxtν(ξ))ξT].由于该流关于 A 是线性的,一旦知道 U 的谱,就可以精确求解动态。训练的主要时间尺度由 ΔtU/ψp 的特征值倒数决定。因此,架构设计将分数学习的训练时间行为归约为谱分析问题。
为了分析谱,方法引入由激活 σ 的高斯期望构造的依赖于扩散时间的量 at、bt、vt2 和 st2。这些量捕捉非线性如何混合数据尺度、扩散尺度和固定的随机投影。借助这些对象,U 特征值密度的 Stieltjes 变换满足一个耦合方程组。一旦求解该方程组,就可以从 Stieltjes 变换的虚部恢复密度。
在强过参数化区域中,谱分离成不同成分。当 ψp>ψn≫1 时,谱密度可以非正式地写为
ρ(λ)=(1−ψp1+ψn)δ(λ−st2)+ψpψnρ1(λ)+ψp1ρ2(λ).与 δ(λ−st2) 成正比的原子不影响训练损失或测试损失,并可在动态分析中忽略。剩余的两个部分 ρ2 和 ρ1 产生不同的时间尺度。体分布 ρ2 位于尺度 ψp 上,而当模型强过参数化时,ρ1 位于尺度 ψp/ψn 上。在欠参数化区域 ψn>ψp≫1 中,谱的形式为
ρ(λ)=(1−ψp1)ρ1(λ)+ψp1ρ2(λ),其中 ρ1 和 ρ2 同样对应不同的学习方向。
体分布 ρ2 与早期泛化阶段相关。它的特征值产生一个量级为 1/Δt 的时间尺度 τgen。在这个时间尺度上,训练损失和测试损失都会下降,泛化间隙实际上为零,并且模型对总体分数的近似持续改善。成分 ρ1 控制后期的记忆化阶段。它的较小特征值产生更长的时间尺度,
τmem∼Δtλminψp,其中 λmin 是 ρ1 体分布的下边缘。在过参数化区域中,该时间尺度变得很大,并随数据集规模增长。在这个更长时间尺度上,训练损失继续下降,但测试损失开始上升,反映出对有限样本分数的过拟合。
这种谱分析预测的动态可以直接在随机特征训练曲线中看到。参见下方的损失演化图。
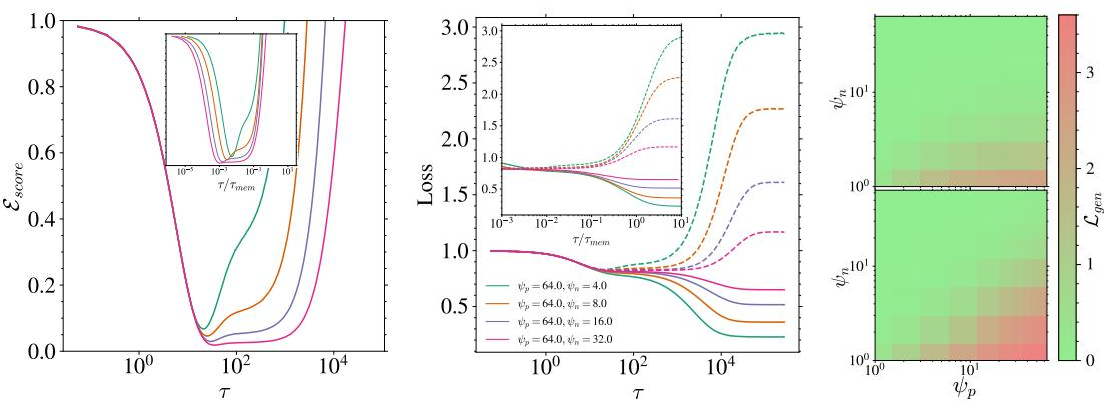
这些轨迹显示到真实分数的距离快速衰减,随后出现后期退化。测试损失最初随训练损失一起下降,在越过记忆化时间尺度后开始上升。使用 τmem 对时间进行重新缩放会使不同数据集规模的曲线重合,证实了谱预测:第二个时间尺度由特征协方差的相关最小特征值支配。关于 (ψn,ψp) 的热力图进一步显示泛化间隙如何依赖于停止时间以及参数与数据比率。
对于实际扩散模型,使用条件 U-Net 分数架构研究相同的训练逻辑。该流程接收图像,应用前向噪声过程,并将加噪输入与扩散时间嵌入一起馈入网络。分数网络使用三个分辨率层级,基础通道宽度为 W,乘子为 1、2 和 3,并在每个分辨率的特征上添加正弦时间嵌入。训练使用带动量的随机梯度下降进行,通过生成样本并通过最近邻比较测量样本质量和记忆化来评估学习到的分数。
架构层面的行为如下所示。
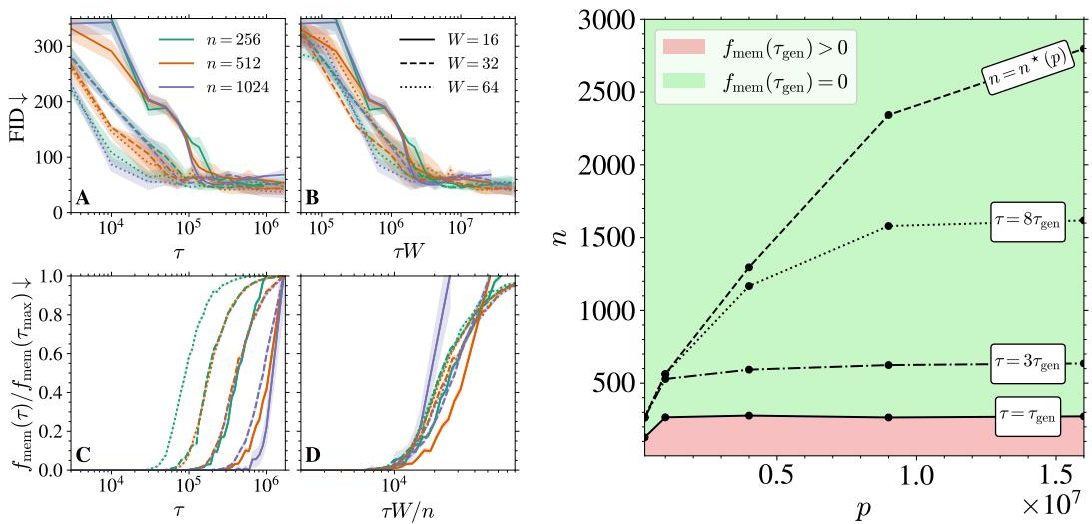
这些曲线说明了改变参数数量和数据集规模如何移动泛化与记忆化之间的转变。当使用时间适当的训练时间尺度因子进行重新缩放时,具有不同宽度或数据集规模的曲线会重合,表明 U-Net 动态遵循在随机特征分析中识别出的相同从泛化到记忆化的总体结构。相图还显示泛化与记忆化之间的边界如何随训练时间移动,从而强化了动力学正则化机制。
实验
实验在灰度 CelebA 图像上训练扩散模型,同时改变数据集规模和网络容量,跟踪训练损失和测试损失、样本质量,以及模型与训练样本的接近程度,以识别从泛化到记忆化的转变。结果揭示了一致的两阶段训练过程:模型首先学习可复用的生成分布,随后在延迟的过拟合阶段之后记忆训练集;更大的数据集会扩大有用的早期训练窗口,而更大的模型会压缩该窗口。该研究还表明,这种行为并非仅由重复样本造成,而是由模型表达能力、优化时间和可用数据之间的相互作用造成。