Command Palette
Search for a command to run...
Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction
Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction
Keyu Tian Yi Jiang Zehuan Yuan Bingyue Peng Liwei Wang
摘要
We present Visual AutoRegressive modeling (VAR), a new generation paradigm that redefines the autoregressive learning on images as coarse-to-fine "next-scale prediction" or "next-resolution prediction", diverging from the standard raster-scan "next-token prediction". This simple, intuitive methodology allows autoregressive (AR) transformers to learn visual distributions fast and can generalize well: VAR, for the first time, makes GPT-style AR models surpass diffusion transformers in image generation. On ImageNet 256×256 benchmark, VAR significantly improve AR baseline by improving Fréchet inception distance (FID) from 18.65 to 1.73, inception score (IS) from 80.4 to 350.2, with 20× faster inference speed. It is also empirically verified that VAR outperforms the Diffusion Transformer (DiT) in multiple dimensions including image quality, inference speed, data efficiency, and scalability. Scaling up VAR models exhibits clear power-law scaling laws similar to those observed in LLMs, with linear correlation coefficients near −0.998 as solid evidence. VAR further showcases zero-shot generalization ability in downstream tasks including image in-painting, out-painting, and editing. These results suggest VAR has initially emulated the two important properties of LLMs: Scaling Laws and zero-shot generalization. We have released all models and codes to promote the exploration of AR/VAR models for visual generation and unified learning.
一句话总结
北京大学与字节跳动提出视觉自回归建模(VAR),将自回归图像生成重新定义为由粗到细的 next-scale prediction,而不是光栅扫描式 next-token prediction,使 GPT 风格 AR 模型在 ImageNet 256×256 上超越 diffusion transformers,FID 从 18.65 提升至 1.73,推理速度提升 20×,同时呈现类似 LLM 的 scaling laws 和 zero-shot 泛化能力。
核心贡献
-
该论文提出视觉自回归建模,一种 GPT 风格图像生成框架,将光栅扫描式 next-token prediction 替换为由粗到细的 next-scale prediction 或 next-resolution prediction。这一变化使自回归 transformer 更高效地学习视觉分布,同时保持强泛化能力。
-
结果显示,VAR 使自回归 transformer 在图像合成上超越 Diffusion Transformer 基线,将 ImageNet 256x256 FID 从 18.65 提升至 1.73,IS 从 80.4 提升至 350.2,同时提供约 20x 更快的推理速度。该工作报告了相较于 DiT 的图像质量、推理速度、数据效率和可扩展性优势。
-
研究展示了视觉建模中的类 LLM 特性,包括相关系数接近 -0.998 的清晰幂律 scaling laws,以及面向图像 in-painting、out-painting 和 editing 的 zero-shot 泛化。该工作还发布模型和代码,以支持视觉自回归学习研究。
引言
自回归大语言模型通过对序列中的下一个 token 进行预测,展现出强可扩展性和泛化能力,使其适用于许多 AI 应用。计算机视觉社区尝试用自回归视觉模型复现这一成功,尤其面向图像和视频生成。这些模型重要,因为可为视觉创作、理解和多模态系统提供类似语言模型的灵活性和可扩展性。
早期视觉自回归模型,如 VQGAN 和 DALL-E,将图像转换为离散 tokens,然后将 2D token grids 展平为 1D sequences。这模仿了文本建模,但给图像施加了人为的光栅扫描顺序,并忽略人类常以由粗到细方式感知视觉结构。因此,这些模型尚未展现与语言模型相当的清晰 scaling laws,其视觉生成质量也常落后于强 diffusion 模型。
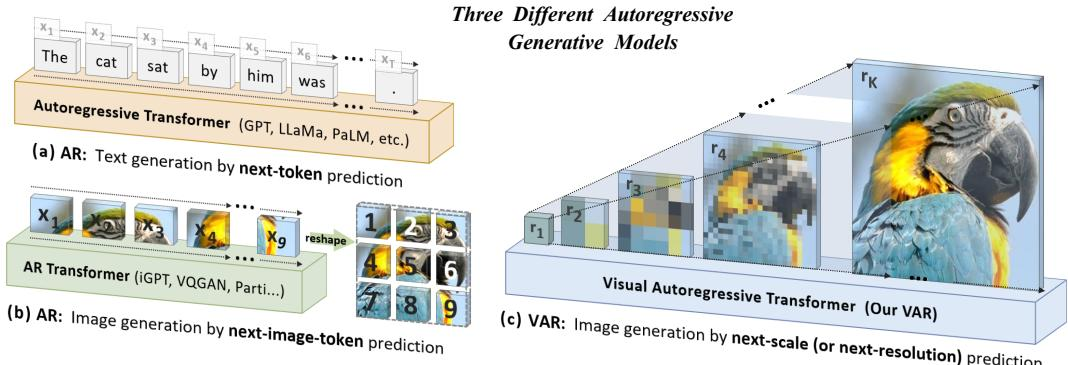
作者提出视觉自回归建模(VAR),以重新思考视觉数据的顺序。VAR 不使用 next-token prediction,而是进行 next-scale prediction,将图像编码为多尺度 token maps,并从低分辨率 map 逐步生成更高分辨率 map。这种由粗到细的设计在保留更自然图像结构的同时仍使用 GPT 风格 transformer。VAR 取得较强 ImageNet 结果、更快推理,并比先前自回归视觉模型具备更好的扩展性;据报道,它在图像质量、数据效率和速度上超越 Diffusion Transformer 基线。该工作还提供了视觉自回归模型中 scaling laws 和 zero-shot 泛化的证据,并提供开源工具包。
方法
作者将方法组织为两阶段自回归图像生成 pipeline。框架不把每个离散 token 视为展平后一维序列中的下一项,而是把整个 resolution scale 视为一个自回归步骤。整体框架因此包含 multi-scale visual tokenizer 和 visual autoregressive transformer。参考框架图。
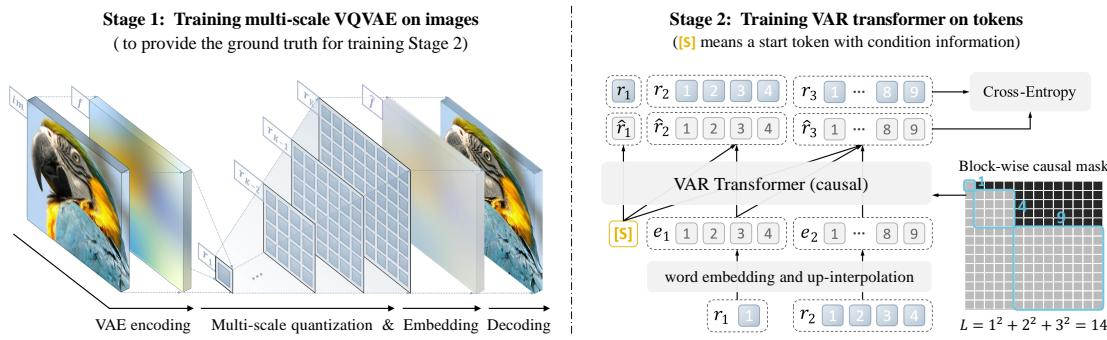
在 tokenizer 阶段,作者将连续图像转换为 K 个离散 token maps。encoder 将图像映射为 feature map f,multi-scale quantizer 将 f 转换为 R = (r_1, r_2, ..., r_K),其中每个 r_k 是分辨率 h_k x w_k 处的离散 map,最终尺度 r_K 与原始 feature map 分辨率匹配。在每个空间位置,quantizer 选择最近的 codebook vector:
q(i,j)=argv∈[V]min∥lookup(Z,v)−f(i,j)∥2.所有尺度共享一个 codebook,因此每个尺度从同一 vocabulary 中抽取 tokens。量化路径是残差且前缀一致的,这意味着尺度 k 的表示与来自先前尺度累积的信息绑定。tokenizer 使用复合目标训练,结合图像重建误差、feature 重建误差、perceptual loss 和 discriminative loss。该阶段的结果是一组 ground-truth 多尺度 token maps,用于监督后续自回归 transformer。
在自回归阶段,预测单元变为整个 token map,而不是单个 token。作者将 K 个尺度上的 likelihood 分解为:
p(r1,…,rK)=k=1∏Kp(rk∣r1,…,rk−1).在第 k 个自回归步骤中,transformer 以之前尺度的 token maps r_1 到 r_{k-1} 为条件,并行预测 r_k 中的所有 tokens。每个尺度关联一个 positional embedding map,因此模型可以维持空间结构,而不必将 token grid 展平为一维序列。训练期间,start token embedding 携带生成条件,例如 class embedding。transformer 输入为 ([s], r_1, ..., r_{K-1}),目标为 (r_1, ..., r_K)。预测的 token distributions 通过 cross-entropy loss 优化。
在 transformer 训练中使用 blockwise causal attention mask。该 mask 限制尺度 k 的 tokens 只能 attend 到 start token 和尺度 1 到 k 的 tokens,防止未来尺度信息泄漏,并保持自回归分解。推理期间,模型生成尺度 r_1,然后 r_2,然后 r_3,依此类推。由于同一尺度内所有 tokens 并行生成,自回归迭代次数为 K,而不是 tokens 总数。可在尺度间使用 KV caching,推理期间不需要 causal mask。
transformer 主干采用简单的 decoder-only 设计和 adaptive normalization。类别条件通过 start token 引入,并用作 adaptive normalization conditioning。在 attention 前,queries 和 keys 被归一化为单位向量,以提升训练稳定性。作者刻意避免更复杂的语言模型组件,如 rotary position embeddings、SwiGLU MLPs 或 RMSNorm,使架构接近标准视觉自回归 transformer 设计,同时聚焦 next-scale prediction 机制。
模型大小遵循与深度相关的 scaling rule:
w=64d,h=d,dr=0.1d/24.在该规则下,近似参数量为:
N(d)=18dw2=73728d3.训练时,作者使用 AdamW,基础学习率为 10−4(batch size 256),β1=0.9,β2=0.95,weight decay 为 0.05。batch size 通常设置在 768 到 1024 范围。tokenizer 使用大小为 4096 的共享 codebook 和 16 倍空间下采样比例。
实验
实验在多个分辨率下评估视觉自回归框架的 ImageNet 条件生成,并与 GAN、diffusion、masked prediction 和自回归基线比较。这些比较显示,所提出公式优于传统自回归建模,并在图像质量、多样性、语义一致性、速度、数据效率上可与 diffusion transformers 竞争力。补充的 scaling laws 和 ablation studies 覆盖模型大小、训练计算量和关键组件,确认 VAR 随规模呈现可预测的性能提升,其主要优势来自由粗到细自回归生成,而不是来自偶然的架构细节。
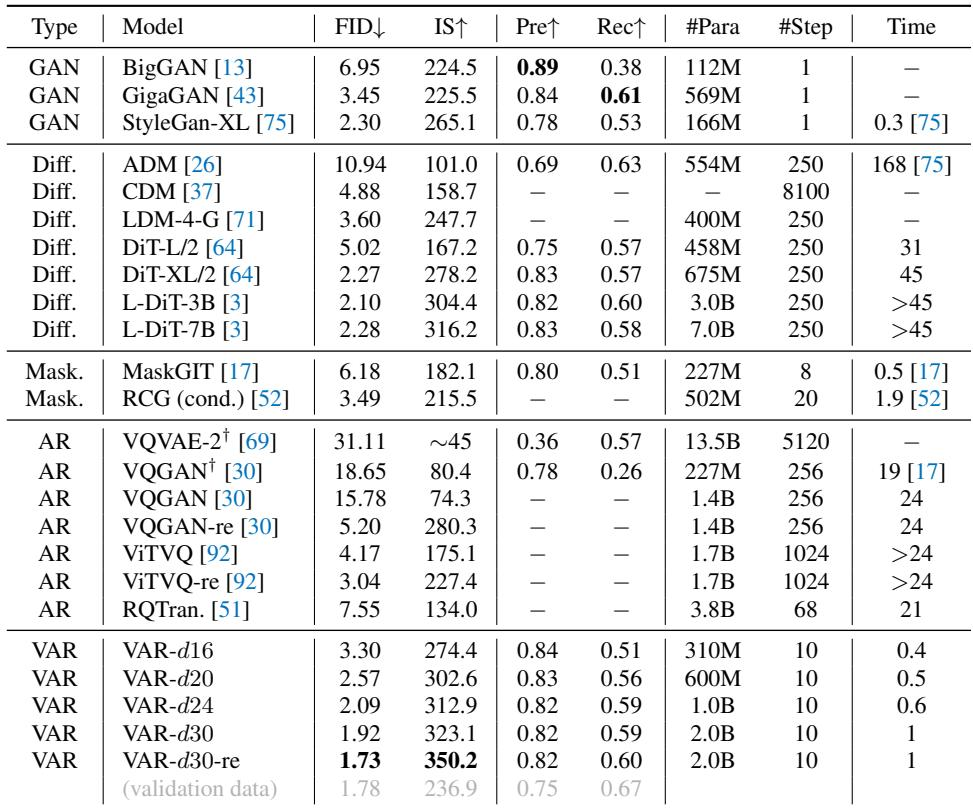
在类别条件 ImageNet 256x256 上,VAR 在比较的 GAN、diffusion 模型、masked prediction 模型和自回归模型中展现最强整体生成质量,FID 和 IS 更优,同时 precision 和 recall 保持有竞争力。它也以更少的模型运行次数和更低 wall clock time 生成图像,尽管某些设置下参数更多。比较表明 VAR 在质量、速度和可扩展性上超越强 diffusion transformers,推动自回归模型家族发展。VAR 在比较模型家族中取得最佳 FID 和 IS,同时保持足够好的 precision 和 recall。VAR 使用的生成步骤远少于 diffusion 和自回归基线,wall clock time 也少得多,接近高效 GAN 速度。VAR 在 FID、IS 和可扩展性上优于 DiT 变体,DiT 在更大参数规模后仅呈现边际或负收益。
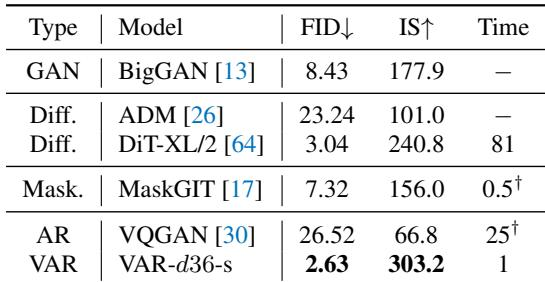
在 512x512 条件 ImageNet 基准上,所报告 VAR 变体在比较模型家族中给出最佳 FID 和 IS。相较传统自回归和 diffusion 基线,它产生明显更好的质量,同时明显快于 diffusion transformer entry。该结果显著,因为受资源限制,这个 VAR 模型使用共享 AdaLN 层。VAR 在列出的 512x512 模型中取得最低 FID 和最高 IS。VAR 比 DiT-XL/2 快得多,同时报告更好的 FID 和 IS。
将 baseline 自回归 transformer 替换为 VAR 会大幅降低 FID,且仅使用一小部分推理成本。更多 VAR 组件逐步改善 FID,扩大模型达到最佳结果,同时仍远快于 baseline。VAR 在极低推理成本下相比 AR baseline 带来很大 FID 改善。AdaLN、top-k sampling、CFG 和 attention normalization 分别可在成本变化有限的情况下进一步降低 FID。扩展 VAR 可产生最强 FID,同时仍比 baseline 使用低得多的成本。
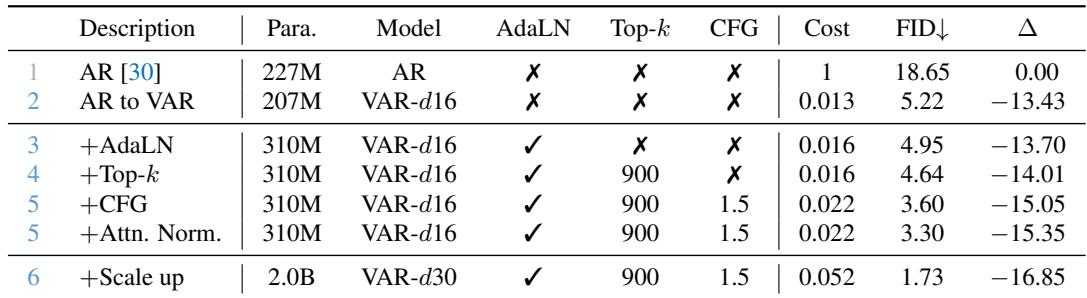
在 256x256 和 512x512 类别条件 ImageNet 上的实验将 VAR 与 GAN、diffusion 模型、masked prediction 模型和自回归模型比较,显示 VAR 提供更强的整体图像质量,超越领先的 diffusion 和自回归基线,同时保持生成效率。Ablation 研究确认,核心 VAR 公式相比传统自回归 transformer 可在低得多的推理成本下大幅改善,额外组件如 AdaLN、top k sampling、classifier-free guidance 和 attention normalization 以有限开销进一步增强质量。扩展 VAR 能产生最强定性性能,同时仍明显快于 diffusion transformer 基线,支持其在质量、效率和可扩展性方面的优势。